خطای ChatGPT، Gemini و Perplexity در پاسخ به سؤالات انتخاباتی؛ پژوهش جدید دلایل این اشتباهات را آشکار کرد
پژوهش جدید شرکت Searchable نشان میدهد چتباتهای هوش مصنوعی حتی هنگام دسترسی به منابع رسمی دولتی، در پاسخ به پرسشهای سیاسی دچار خطاهای جدی میشوند. در این میان ابزار Perplexity بیشترین نرخ خطا را ثبت کرده است و نحوه طرح سؤال از سوی کاربران نیز میتواند احتمال دریافت پاسخ نادرست را بهشدت افزایش دهد.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- بررسی بیش از ۷ هزار پاسخ چتباتهای هوش مصنوعی نشان میدهد حدود ۸ درصد از پاسخهای مربوط به موضوعات سیاسی با آمارهای رسمی دولتی مغایرت دارند.
- ابزار Perplexity با بیش از ۲۲ درصد خطا ضعیفترین عملکرد را ثبت کرده است در حالی که نرخ خطای Gemini حدود ۶ درصد و ChatGPT حدود ۴ درصد بوده است.
- خطای ابزارهای هوش مصنوعی اغلب ناشی از تحلیل نادرست دادهها و سوگیری براساس فرضیات غلط مطرحشده در پرسش کاربر است حتی اگر به پایگاههای معتبر دولتی متصل باشند.
در آستانه برگزاری انتخابات، شاید برای بررسی کارنامه و سوابق نامزدها مراجعه به چتباتهایی نظیر ChatGPT، Gemini یا Perplexity گزینهای سریع و وسوسهانگیز به نظر برسد. با این حال، نتایج یک مطالعه جدید نشان میدهد حتی زمانی که این چتباتها برای ادعاهای خود به منابع مشخصی ارجاع میدهند، نمیتوان بهراحتی به پاسخهای آنها اعتماد کرد.
بر اساس گزارش شرکت تحلیلی Searchable که در زمینه ارزیابی موتورهای جستجوی مبتنی بر هوش مصنوعی فعالیت میکند، تقریباً از هر ۱۲ پاسخ ارائهشده پیرامون مسائل سیاسی محلی، یک پاسخ با آمارهای رسمی دولتی تناقض دارد. محققان با بررسی ۷٬۴۴۹ پاسخ دریافتند که ۶۱۰ مورد از آنها کاملاً نادرست بودهاند که نشاندهنده نرخ خطای ۸٫۲ درصدی است.
این پژوهش عملکرد چهار ابزار پرکاربرد شامل ChatGPT، Gemini، ابزار Google AI Mode و Perplexity را زیر ذرهبین قرار داده است. پرسشهای مطرحشده موضوعاتی را در بر میگرفت که رأیدهندگان معمولاً برای ارزیابی سیاستمداران به آنها توجه میکنند؛ مسائلی مانند میزان جرم و جنایت، هزینههای مسکن، وضعیت اشتغال، آموزش و خدمات درمانی.
شگفتانگیزترین یافته این بررسی صرفاً تعداد دفعات اشتباه چتباتها نبود؛ بلکه موضوع نگرانکنندهتر این بود که مدلهای هوش مصنوعی حتی پس از بررسی و استناد به منابع معتبر دولتی، باز هم پاسخهای نادرستی تولید میکردند.
ثبت بالاترین نرخ خطا توسط Perplexity
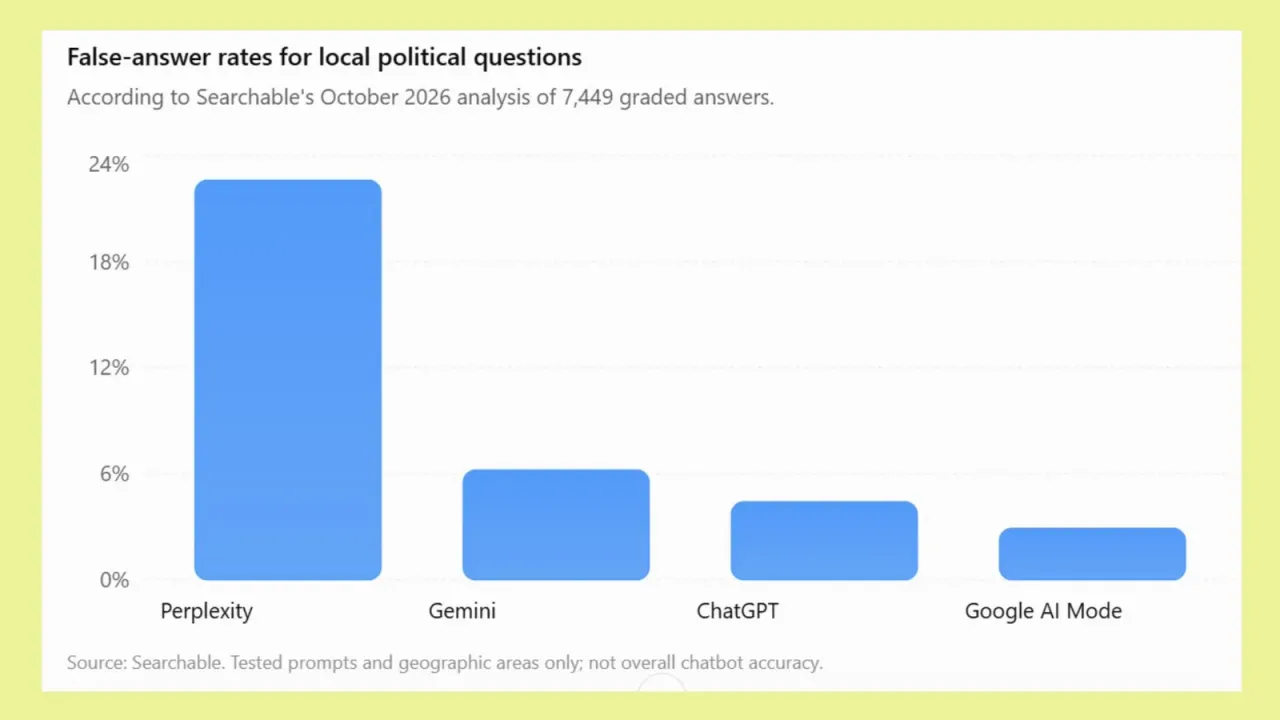
پژوهشگران در جریان این آزمایشها به تفاوتهای معناداری در کیفیت عملکرد این چهار ابزار هوش مصنوعی دست یافتند.
ابزار Perplexity در ۲۲٫۶ درصد از پاسخهای آزمایششده اطلاعات نادرست ارائه داد، در حالی که این رقم برای Gemini حدود ۶٫۲ درصد و برای ChatGPT معادل ۴٫۴ درصد بود. در این میان، ابزار Google AI Mode با نرخ خطای ۲٫۹ درصدی دقیقترین عملکرد را به ثبت رساند.
به بیان دیگر، بیش از یک مورد از هر پنج پاسخ ارزیابیشده در Perplexity با آمارهای رسمی مراجع دولتی مغایرت آشکار داشت.
میزان خطاها بسته به موضوع مورد بحث نیز تفاوتهای چشمگیری داشت. پرسشهای مرتبط با مسکن و هزینههای زندگی با ۱۱٫۹ درصد، بیشترین پاسخ نادرست را به خود اختصاص دادند و پس از آن مسائل حوزه انرژی و محیط زیست با ۱۰٫۹ درصد و موضوعات مربوط به مدارس با ۱۰٫۱ درصد در رتبههای بعدی قرار گرفتند.
در نقطه مقابل، پرسشهای مربوط به امنیت عمومی و آمار جرم و جنایت با ۴٫۷ درصد، کمترین نرخ خطای تجمیعی را ثبت کردند.
البته این آمارها لزوماً بازتابدهنده دقت قطعی هر چتبات در پاسخ به تمامی سؤالات سیاسی نیست. تمرکز این تحقیق بر ۱۰۶ پرسش کلیدی در پنج منطقه کلانشهری و ایالتهای مربوط به آنها بود و مواردی را نیز در بر میگرفت که عمداً بر اساس ادعاهای گمراهکننده یا شایعات قبلاً ردشده طراحی شده بودند.
دسترسی به اطلاعات درست همیشه مانع خطا نمیشود
یکی از نگرانکنندهترین یافتههای پژوهش اخیر این است که پاسخهای غلط لزوماً بهدلیل مراجعه چتباتها به سایتهای نامعتبر شکل نگرفتهاند.
از مجموع ۴۳٬۰۷۹ صفحه وبی که سیستمهای هوش مصنوعی در طول این آزمایشها بررسی کردند، حدود ۶۲ درصد متعلق به پایگاههای اینترنتی رسمی دولت در سطوح فدرال، ایالتی یا محلی بوده است.
مدل ChatGPT در مرحله جمعآوری اطلاعات وسواس بسیار زیادی به خرج میداد؛ بهگونهای که پژوهشگران متوجه شدند این مدل پیش از پاسخ دادن به هر پرسش، بهطور میانگین ۳۱ صفحه وب را از ۱۰ وبسایت مختلف مورد بررسی قرار داده است.
یک نمونه برجسته در گزارش به وضعیت تأمین برق ایالت جورجیا مربوط میشود که طی آن ChatGPT برای تدوین پاسخ، ۱۹ جستجوی مجزا انجام داد و به ۱۵۴ صفحه در ۵۲ وبسایت گوناگون سر زد.
این نمونه بهخوبی چالش اصلی تکیه بر هوش مصنوعی برای تحلیل اطلاعات را نمایان میکند؛ یک چتبات میتواند جستجوهای فوقالعاده گستردهای انجام دهد و منابع معتبر را بیابد، اما همچنان هنگام ترکیب و نتیجهگیری از آن دادهها دچار خطای فاحش شود.
همانطور که کریس دانلی، مدیرعامل و همبنیانگذار شرکت Searchable توضیح میدهد: «در بسیاری از مواقع، پاسخ درست دقیقاً درون همان پیوندهایی قرار داشت که چتبات به آنها ارجاع میداد؛ اما در نهایت این داده صحیح به دست مخاطب نرسید.»
این مسئله زمانی بحرانیتر میشود که پای اعداد و ارقامی در میان باشد که مستقیماً دیدگاه شهروندان را در سنجش عملکرد یک نماینده یا مسئول منتخب تحت تأثیر قرار میدهند.
نحوه طرح پرسش از هوش مصنوعی خطا را تشدید میکند
این پژوهش همچنین سناریوهایی را بررسی کرد که در آنها پرسش اولیه کاربر حاوی یک پیشفرض غلط یا گمراهکننده بود.
بهعنوان مثال، وقتی از چتبات پرسیده میشود «چرا آمار جرم در فلان منطقه افزایش یافته است؟»، این سؤال خودبهخود فرضیه رشد جرم را قطعی در نظر میگیرد، حتی اگر آمارهای رسمی دقیقاً روندی کاهشی را نشان دهند.
بر اساس یافتههای منتشرشده توسط Searchable، پرسشهایی که حاوی پیشفرضهای نادرست بودند، با احتمالی بیش از چهار برابر پاسخهای اشتباه تولید کردند.
سامانههای هوش مصنوعی همیشه فرضیههای سؤال را به چالش نمیکشند، بلکه در موارد متعددی فرض مطرحشده را دربست میپذیرند و تلاش میکنند دلایلی برای توجیه آن بتراشند.
این رفتار میتواند بهویژه برای کاربرانی که بهدنبال راستیآزمایی ادعاهای مطرحشده در شبکههای اجتماعی، تبلیغات انتخاباتی یا مناظرهها هستند، مشکلات جدی ایجاد کند.
در حال حاضر بخش زیادی از شهروندان از هوش مصنوعی برای مقاصد سیاسی استفاده میکنند. نظرسنجی دانشکده مدیریت سیاسی دانشگاه جرج واشنگتن نشان داد که از هر پنج شرکتکننده در انتخابات، یک نفر برای کسب اطلاعات سیاسی یا انتخاباتی به هوش مصنوعی مراجعه کرده است و یکچهارم پاسخدهندگان نیز روزانه از ابزارهای هوش مصنوعی استفاده میکنند.
نکته جالب اینجاست که در همان نظرسنجی، تنها ۱ درصد از افراد اعلام کردند که هوش مصنوعی را قابل اعتمادترین منبع خود برای کسب اطلاعات درباره نامزدها و انتخابات میدانند.
راهکارهای راستیآزمایی پاسخهای هوش مصنوعی
بدیهی است که این یافتهها به معنای ضرورت کنار گذاشتن ابزارهایی مانند ChatGPT یا Gemini در پژوهشهای سیاسی نیست. این سیستمها همچنان برای تشریح سیاستهای پیچیده، خلاصهسازی گزارشها یا پیدا کردن منابع مرتبط بسیار کارآمد هستند.
با این حال، پیش از پذیرفتن هر ادعایی بهعنوان یک فکت قطعی، رعایت چند نکته اساسی ضروری است:
- درخواست معرفی منبع: چنانچه چتبات آماری درباره بیکاری، جرم و جنایت یا قیمت مسکن ارائه داد، از آن بخواهید نهاد دولتی متولی انتشار آمار را مشخص کند؛ سپس خودتان شخصاً لینک منبع را باز و بررسی کنید.
- طرح سؤالات بیطرفانه: بهجای اینکه بپرسید «چرا جرم در شهر افزایش یافته است؟»، بپرسید «آیا آمار جرم در بازه زمانی مشخص افزایش داشته یا کاهش؟». طرح پرسشهای خنثی به مدل اجازه میدهد بدون پذیرش سوگیری، واقعیت را گزارش کند.
- بررسی دقیق تاریخها: شاخصهای اقتصادی، آمارهای جنایی و قیمتهای بازار مسکن پیوسته بهروزرسانی میشوند. حتماً مطمئن شوید دادههای ارائهشده مربوط به بازه زمانی مدنظر شما است و آمار منقضیشده ملاک قرار نگرفته است.
- اطمینان نداشتن به صحت صرف استنادها: ارجاع به وبسایت معتبر دولتی ضمانتکننده درستی تحلیل چتبات نیست. حتماً تطابق عدد ادعاشده با متن اصلی و همخوانی بستر موضوعی را بهصورت دستی ارزیابی کنید.
- پیگیری جزییات اجرایی از مراجع رسمی: برای اطلاع از مواردی نظیر مکانهای رأیگیری، شرایط ثبتنام، ساعات کاری حوزهها و نمونه برگههای رأی، مستقیماً به پایگاه رسمی ستاد انتخابات مراجعه کنید و به خلاصههای هوش مصنوعی اتکا نکنید.
نتیجه نهایی
چتباتهای هوش مصنوعی دسترسی به اطلاعات را سادهتر کردهاند، اما این تحقیق نشان داد که پیدا کردن دادهها با درک و تفسیر صحیح آنها دو مقوله کاملاً متفاوت هستند.
شرکت Searchable این ارزیابی را در ماههای سپتامبر و اکتبر ۲۰۲۶ از طریق حسابهای کاربری ناشناس و تکرار پرسشها در نشستهای تازه به انجام رساند. پژوهشگران دادهها را با آمارهای رسمی دولتی تطبیق دادند و ثبت هر پاسخ بهعنوان «نادرست» مستلزم تأیید همزمان دو ناظر مستقل بود.
گرچه این مطالعه مقیاسی همگانی برای سنجش بیعیب بودن چتباتها نیست، اما نقطه ضعف مهمی را پیش از موعد برگزاری انتخابات ۳ نوامبر آشکار میسازد که آگاهی از آن اهمیت بالایی دارد.
به تعبیر دانلی: «باید به پاسخ یک چتبات هوش مصنوعی صرفاً بهعنوان نقطهای برای شروع نگریست، نه یک حکم نهایی و ردناپذیر.»
در دورانی که حجم عظیمی از اطلاعات در عرض چند ثانیه تولید میشود، اختصاص دادن حتی یک دقیقه برای ارزیابی اصالت منبع، مطمئنترین گام در هر پژوهشی خواهد بود.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
مدل تبدیل گفتار به متن Parakeet v3 انویدیا بدون نیاز به پایتون و کارت گرافیک اجرا میشود
تیم توسعهدهنده handy-computer نسخه کمحجم و بهینهسازیشده GGUF را برای مدل تبدیل گفتار به متن Parakeet v3 انویدیا منتشر کرد. این نسخه امکان اجرای روان و محلی مدل را بدون وابستگی به پایتون یا کارتهای گرافیک مجزا روی پردازندههای معمولی فراهم میکند.
رونمایی از مدل Mistral Large 4؛ ایجنت کدنویسی ۱ تریلیون پارامتری با دسترسی آزاد
شرکت Mistral وزنهای عمومی مدل جدید Mistral Large 4 را با ۱ تریلیون پارامتر و تمرکز ویژه بر ایجنتهای کدنویسی و امنیت سایبری منتشر کرد. این مدل بر پایه معماری ترکیبی از متخصصان توسعه یافته است و با مصرف بهینه توکن، گزینهای قدرتمند برای استقرار روی زیرساختهای خصوصی به شمار میرود.
مدل جدید Qwen3.5-4B-3D-Coder متن را به صحنههای سهبعدی تعاملی در مرورگر تبدیل میکند
یک توسعهدهنده مستقل نسخهای اختصاصی از مدل Qwen با نام Qwen3.5-4B-3D-Coder را معرفی کرده است که توصیفات متنی را به صحنههای سهبعدی تعاملی در کتابخانه Three.js تبدیل میکند. این مدل سبک با ۴ میلیارد پارامتر، تمام کدهای جاوااسکریپت و صحنه گرافیکی را در قالب یک فایل تکی HTML به کاربر تحویل میدهد و روی سیستمعامل محلی نیز قابل اجرا است.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.