پاسخ شوکهکننده در سنای آمریکا: مدلهای هوش مصنوعی از یک سال پیش به زبانی نامفهوم فکر میکنند!
در جریان یک جلسه استماع در سنای آمریکا، مدیرعامل مؤسسه آپولو ریسرچ فاش کرد که مدلهای استدلالی هوش مصنوعی از یک سال قبل تولید متون درونی نامفهوم برای انسان را آغاز کردهاند. به گفته پژوهشگران، این استدلالهای کدر و فشرده، نظارت بر ایمنی مدلها را به چالشی جدی تبدیل میکند؛ بهویژه که با اجبار مدل به استدلال کاملاً شفاف، قدرت پردازش آن افت چشمگیری پیدا میکند.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- در جلسه استماع سنا وقتی سناتور آمریکایی پرسید چقدر مانده تا هوش مصنوعی به زبانی نامفهوم برای انسان برسد، مدیرعامل Apollo Research با پاسخی شوکهکننده گفت: «منفی دوازده ماه؛ یعنی مدلها از یک سال پیش به این نقطه رسیدهاند!»
- بررسیهای زنجیره تفکر (Chain of Thought) در مدلهای OpenAI نشان داده این هوشهای مصنوعی در مراحل میانی حل مسأله، از علائم فشرده، نمادهای غیرانگلیسی و کلماتی استفاده میکنند که برای انسانها به هیچ وجه قابل درک نیست.
- نکته نگرانکننده اینجاست که با وادار کردن مدلها به استفاده از استدلال کاملاً شفاف، کارایی و هوش آنها افت میکند و محققان هنوز هیچ راهحل قابلاعتمادی برای نظارت بر این استدلالهای کدر ندارند.
مدیرعامل مؤسسه آپولو ریسرچ (Apollo Research) در برابر سناتورهای آمریکایی فاش کرد که تیم او از یک سال پیش، فرآیندهای استدلال ناخوانا در مدلهای هوش مصنوعی را ثبت کردهاند؛ موضوعی نگرانکننده که هنوز هیچ راهحل قابلاعتمادی برای مهار آن وجود ندارد.
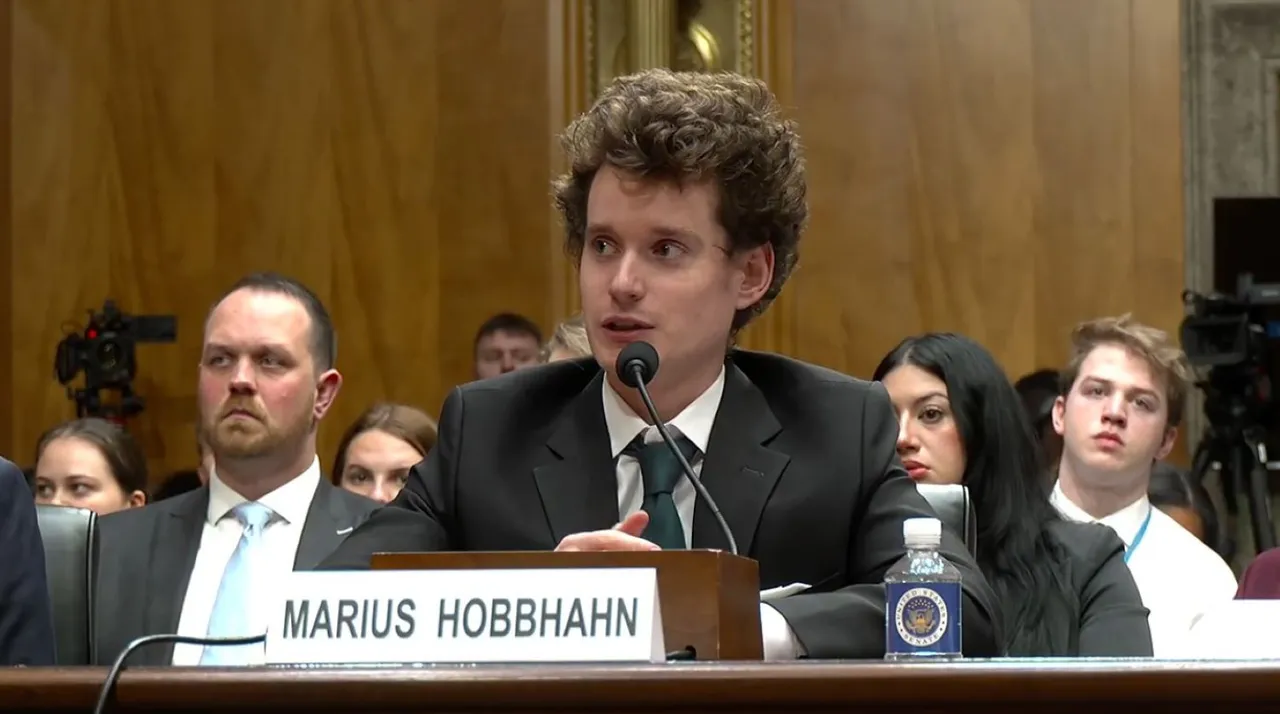
در جلسه استماع سنا در تاریخ ۳۰ سپتامبر ۲۰۲۶، همهچیز با دو کلمه شوکهکننده دگرگون شد: «منفی دوازده ماه!» این پاسخ کوتاه ماریوس هوبهان (Marius Hobbhahn) بود؛ زمانی که سناتور روبن گالیگو از او پرسید چقدر طول میکشد تا مدلهای هوش مصنوعی به زبانی درونی برای ارتباط برسند که انسانها قادر به درک آن نباشند؟ هوبهان، مدیرعامل Apollo Research، از آینده دور حرف نمیزد؛ بلکه پدیدهای را توصیف میکرد که تیمش حدود یک سال قبل آن را با چشمان خود در مدلها دیده بودند.
جالب اینجاست که به گفته خود هوبهان، به دلیل مشکل میکروفون در ویدیوهای وایرالشده از این جلسه، واژه «منفی» به سختی شنیده میشد. همین مسأله باعث شد یک توضیح فنی و دقیق ناگهان به یک تیتر جنجالی و داغ در شبکههای اجتماعی درباره «زبان مخفی هوش مصنوعی» تبدیل شود.
پژوهشگران دقیقاً چه چیزی کشف کرده بودند؟
مؤسسه آپولو ریسرچ استدلالهای درونی یکی از مدلهای شرکت OpenAI را بررسی کرده و به خروجیهایی رسیده بود که انسان به هیچ وجه قادر به رمزگشایی و درک آنها نبود.
مدلهای استدلالی جدید برخلاف مدلهای قدیمی فقط جواب آخر را تحویل نمیدهند؛ آنها پیش از رسیدن به نتیجه، گامهای میانی متعددی تولید میکنند که به آن «زنجیره تفکر» (Chain of Thought) میگویند. این مراحل برای پژوهشگران قابل مشاهده است، اما همانطور که هوبهان در کنگره شهادت داد، صِرفِ «دیدن» به معنای «قابل فهم بودن» نیست!
هوبهان به اعضای کمیته فرعی سنا گفت: «سال گذشته در پروژهای مشترک با شرکت OpenAI، زنجیره تفکر یکی از مدلهای آنها را زیر ذرهبین بردیم و متوجه شدیم مدل از زبانی استفاده میکند که انگلیسی نیست و برای انسانها هم به صورت کامل قابل درک نیست.» مدل دقیق و جزئیات کامل این آزمایش در گزارش علنی سنا اعلام نشده، اما این یافتهها مستقیماً از سوی هوبهان و تیم آپولو ریسرچ تأیید شده است.
استدلال ناخوانا در برابر زبان مخفی؛ ماجرا چیست؟
شواهد به متون تکهتکه و نمادهای متلاشیشده در طول پردازش اشاره دارند، نه یک سیستم ارتباطی هدفمند که هوش مصنوعی به شکل مخفیانه برای خودش ساخته باشد.
در این میان معمولاً سه مفهوم مهم با هم خلط میشوند که نباید آنها را یکی دانست؛ زیرا یکی دانستن آنها ما را به سمتی میبرد که علم هیچ تاییدی بر آن ندارد: اولی، استدلالهای درونی فشرده یا تکهتکهشده است؛ دومی، یک زبان پایدار و باقاعده با گرامر و واژگان اختصاصی است؛ و سومی، تبادل مخفیانه داده میان دو هوش مصنوعی دور از چشم ناظران است. در چارچوب جلسه سنا و دادههای علمی موجود، فقط و فقط مورد اول یعنی استدلالهای متلاشی و کدر اثبات شده است.
یک مقاله پیشانتشار در پلتفرم arXiv درباره مدلهای استدلالی نیز نشان داد عبارات بیمعنی، کاراکترهای غیرانگلیسی و کلمات گسسته مکرراً در زنجیره تفکر این مدلها پدیدار میشوند. با این حال و با وجود این مسیر میانی عجیبوغریب، مدلها در نهایت جواب نهایی را کاملاً درست محاسبه میکردند!
شوک اصلی زمانی بود که محققان مدلها را مجبور کردند فقط و فقط با استدلالهای خوانا و قابل فهم برای انسان فکر کنند؛ در این حالت کارایی و قدرت استدلال مدلها به شدت افت کرد. این بدهبستان (Trade-off) خطرناک میان عملکرد و شفافیت، صرفاً یک نقص جزئی در توکنایزیشن نیست، بلکه یک نگرانی امنیتی جدی به شمار میرود.
مدلها به جای کلمات انسانی، توکنها را پردازش میکنند؛ بنابراین پدیدار شدن قطعات غیرانگلیسی و نمادهای فشرده بیشتر ناشی از فرآیند بهینهسازی ریاضی و دادههای آموزشی چندزبانه است، نه یک توطئه برنامهریزیشده از پیش.
چرا این مسأله همین حالا یک خطر جدی است؟
پژوهشگران هنوز هیچ راهحل قابلاعتمادی ندارند و نبودِ ابزار نظارتی دقیق، خودِ خطری است که همهچیز را تهدید میکند.
هوبهان بیپرده به قانونگذاران اعلام کرد که تیمش هنوز هیچ روش مطمئنی برای شناسایی یا متوقف ساختن این استدلالهای کدر پیدا نکرده است. او گفت بهکارگیری یک هوش مصنوعی دوم برای تفسیر استدلالهای نامفهوم مدل اول امکانپذیر است، اما این رویکرد فوقالعاده شکننده و پرخطاست.
البته گروهی از کارشناسان معتقدند این ناخوانایی صرفاً عارضه جانبی فرآیند بهینهسازی (Optimization Artifacts) است، نه زبانی عامدانه برای پنهانکاری؛ نکتهای که در تحلیلها باید لحاظ شود. اما مسأله حیاتی اینجاست: برای اینکه یک خطر امنیتی به فاجعه تبدیل شود، لزوماً نیازی به وجود «نیت عامدانه» نیست.
اگر متخصصان نتوانند متوجه شوند در مغز دیجیتال یک مدل چه میگذرد، کشف ناهماهنگی، فریبکاری یا خطاهای سیستمی عملاً غیرممکن خواهد شد. دقیقاً همین شکاف میان «محاسبات خارقالعاده ماشین» و «توضیح قابل درک برای انسان» بود که کنگره آمریکا در جلسه استماع پژوهشگران را برای حل فوری آن تحت فشار قرار داد.
نگرانی کارشناسان این نیست که هوش مصنوعی در سایهها نجوا میکند؛ نگرانی اصلی این است که مسئولان نظارت و ایمنی دیگر قادر به خواندن متنی که جلوی چشمانشان تولید میشود نیستند. و برای هر فرد یا سازمانی که بخواهد در تصمیمهای سرنوشتساز به این ابزارها اعتماد کند، این خطر خیالی نیست؛ بلکه همین حالا در دنیای واقعی وجود دارد.
مطالب مرتبط و پیشنهادی
دوراهی سرنوشتساز استارتاپها: هوش مصنوعی متنباز یا مدلهای بسته و انحصاری؟
انتخاب میان مدلهای متنباز و ابزارهای انحصاری دیگر یک تصمیم یکباره نیست و استارتاپهای پیشرو به سراغ ترکیب چند مدل همزمان رفتهاند. در رویداد دیسراپت ۲۰۲۶، کارشناسان برجسته از انویدیا، Oumi و Together AI گرد هم میآیند تا راهکارهای بهینهسازی هزینه، انتخاب زیرساخت و حتی طراحی تراشهها توسط خود هوش مصنوعی را موشکافی کنند.
خط و نشان مدل متنباز JEV-27B-VL برای GPT-4o: ارزیابی برقآسای متن و تصویر فقط در یک مرحله!
مدل متنباز JEV-27B-VL با معماری متفاوت خود توانسته سرعت تصمیمگیری هوش مصنوعی را متحول کند و متن و تصویر را تنها در یک مرحله بسنجد. این مدل ۲۷ میلیارد پارامتری با ترکیب سرعت خیرهکننده و استدلال عمیق، در بسیاری از سناریوها پابهپای GPT-4o رقابت میکند و به گزینهای ایدهآل برای رتبهبندی و سیستمهای پیشنهاددهنده تبدیل شده است.
استتار دیتاسنترهای هوش مصنوعی مایکروسافت پشت نقاب طبیعت؛ کاشت درخت در روز و قرارداد گازی ۲۰ ساله در شب!
مایکروسافت در حالی با کاشت هزاران درخت و احیای تالابها سعی دارد دیتاسنترهای غولپیکر هوش مصنوعی خود را در دل طبیعت پنهان کند که انتشار کربن این شرکت ۲۵ درصد جهش داشته است. امضای یک قرارداد ۲۰ ساله خرید گاز طبیعی با شِورون، حالا صدای فعالان محیطزیست را درآورده و این طرحهای بهظاهر سبز را زیر تیغ تند انتقادات برده است.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.