بررسی مک استودیو M5 اولترا اپل؛ غول فوقالعاده گرانقیمتی که مرا شیفته وایب کدینگ کرد!
مک استودیو جدید اپل با پردازنده M5 Ultra و پهنای باند حافظه سرسامآور ۱.۲ ترابایت بر ثانیه، به یک ماشین رؤیایی برای اجرای محلی مدلهای زبانی تبدیل شده است. این غول پردازشی اگرچه قیمتی نجومی دارد، اما لذت توسعه نرمافزار با وایب کدینگ بدون نیاز به سرورهای ابری را به اوج میرساند. با این حال، باید دید آیا چنین قدرتی ارزش برچسب قیمت چند هزار دلاری اپل را دارد یا خیر.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- مک استودیو M5 اولترا با جهش دو نسلی و پهنای باند حافظه دیوانهوار ۱.۲ ترابایت بر ثانیهای، به گزینهای بینظیر برای اجرای محلی مدلهای زبانی سنگین و ایجنتهای هوشمند تبدیل شده است.
- در تستهای واقعی وایب کدینگ با مدل ۲۷ میلیاردی Qwen، این سیستم توانست سرعت خیرهکننده بیش از ۵۰ توکن بر ثانیه را ثبت کند که بیش از دو برابر نسلهای قبلی است.
- بزرگترین مانع این کامپیوتر قیمت بسیار نجومی آن است؛ مدل پایه ۵٬۴۹۹ دلار قیمت دارد و در کانفیگهای بالا به بالای ۱۲٬۰۰۰ دلار و حتی ۲۰٬۰۰۰ دلار میرسد!
بهار امسال اپل بالاخره ماجرا را رسمی کرد: دوران مک پرو (Mac Pro) رسماً به پایان رسیده است.
زمانی که اپل از پردازندههای اینتل و گرافیکهای AMD استفاده میکرد، داشتن یک کیس غولپیکر با قابلیت ارتقا و تعویض قطعات کاملاً منطقی بود. اما معماری اپل سیلیکون (Apple Silicon) پردازنده مرکزی، پردازنده گرافیکی و حافظه رم را همه زیر یک سقف گرد هم آورده است؛ ساختاری یکپارچه که ارتقای سنتی قطعات را نه تنها بیمعنی، بلکه عملاً غیرممکن میکند—حداقل بدون قربانی کردن مزیتهای حیاتی این تراشهها نمیتوان دست به چنین کاری زد.
از قضا، ترکیب یک پردازنده پرسرعت، گرافیک قدرتمند و از همه مهمتر معماری حافظه یکپارچه (Unified Memory) در تراشههای اپل سیلیکون، آنها را به انتخابی بینظیر برای یکی از سنگینترین و مدرنترین پردازشهای حرفهای این روزها تبدیل کرده است: اجرای مدلهای زبانی و ایجنتهای هوش مصنوعی به صورت کاملاً محلی (Local).
مخاطب اصلی مک استودیو M5 Ultra دقیقاً همین افراد هستند؛ بالاترین و خفنترین کانفیگ رومیزی اپل که در این بهروزرسانی با یک جهش بلند، دو نسل پردازنده را یکجا پشت سر گذاشته است (اگر یادتان باشد، اساساً خبری از نسخه M4 Ultra نبود). مدلهای اولترا در مک استودیو همیشه برای بیشتر کاربران قدرتی فراتر از نیاز و مصداق بارز زیادهروی به نظر میرسیدند؛ اما حالا نسل جدیدی از برنامهنویسان و طراحان شیفته هوش مصنوعی پدید آمدهاند که داشتن چنین غول پردازشی روی میز کارشان واقعاً برایشان کارگشا و توجیهپذیر است.
راستش را بخواهید، اپل حسابی از موج عظیم تقاضا غافلگیر شد؛ خیل عظیمی از کاربرانی که سراغ اجرای ابزارهایی مثل OpenClaw و اجرای محلی مدلهای وزنباز (Open-weight) رفتند، درست همزمان با بحران جهانی کمبود تراشههای حافظه به خاطر تبوتاب هوش مصنوعی، باعث شدند خرید بیشتر این دستگاهها طی ماههای اخیر تقریباً غیرممکن شود. مک استودیوی جدید درست در میانه چنین اتمسفر داغ و پرتقاضایی پا به میدان گذاشته است.
همان طراحی همیشگی، با باطنی کاملاً متحولشده
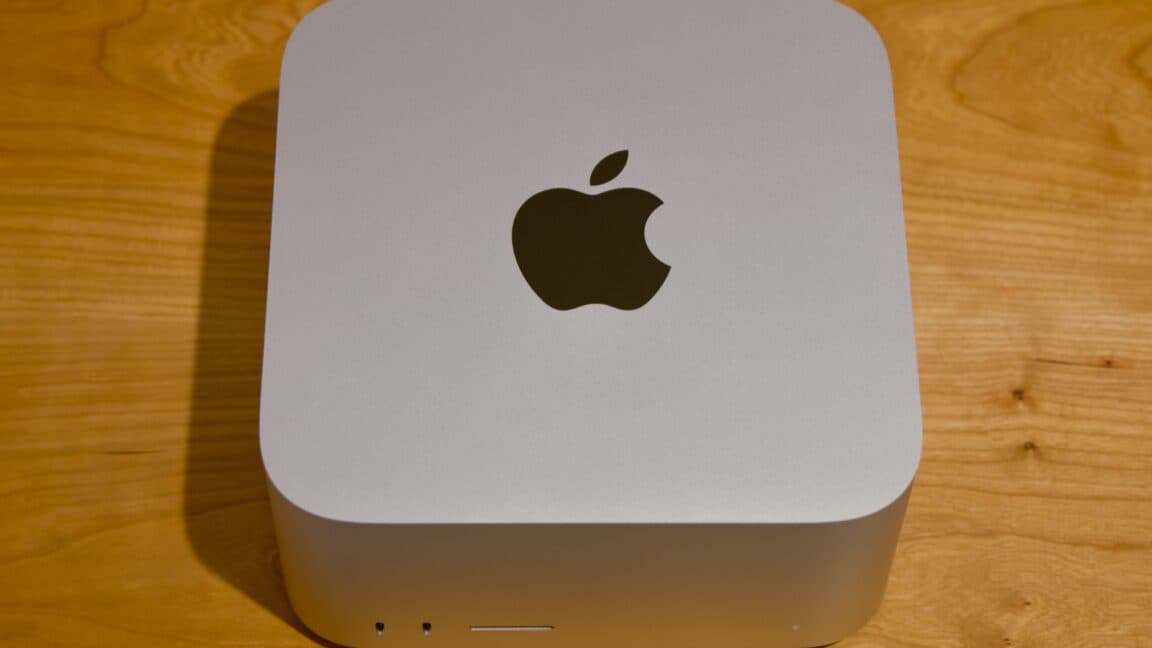
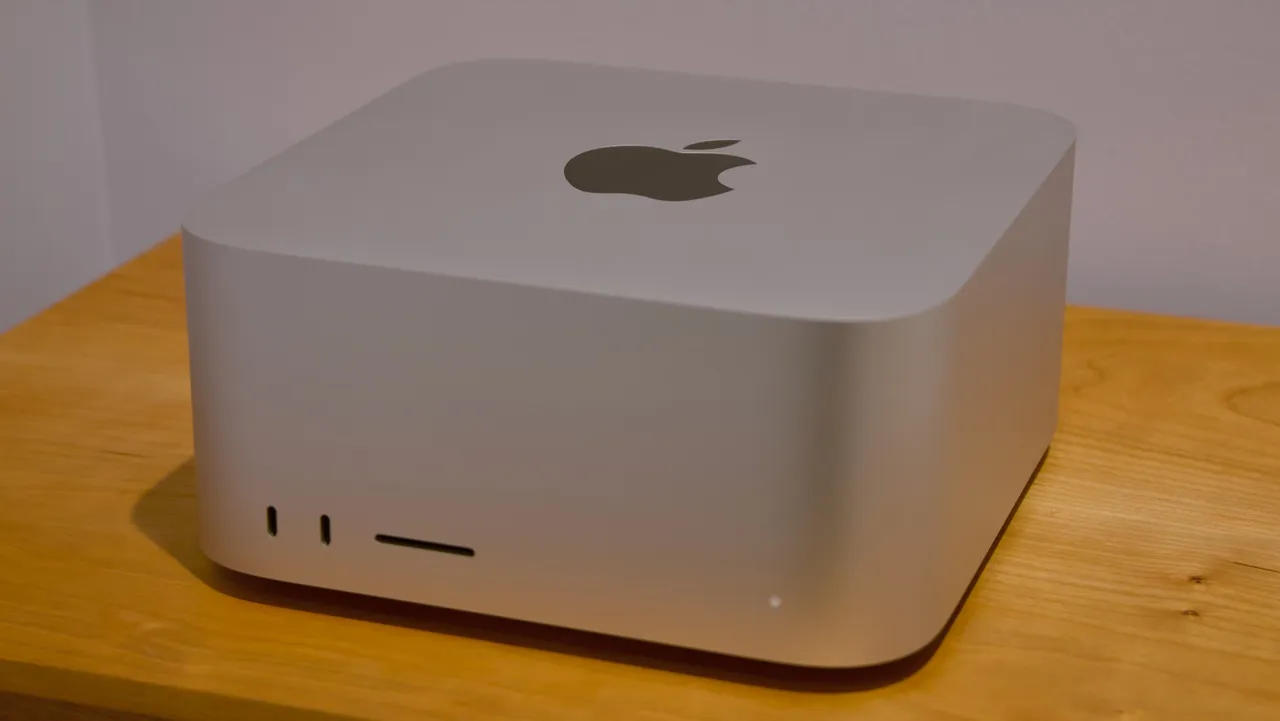
همان زبان طراحی آشنای مک مینی، اما با بدنهای ضخیمتر و جثهای تنومندتر.
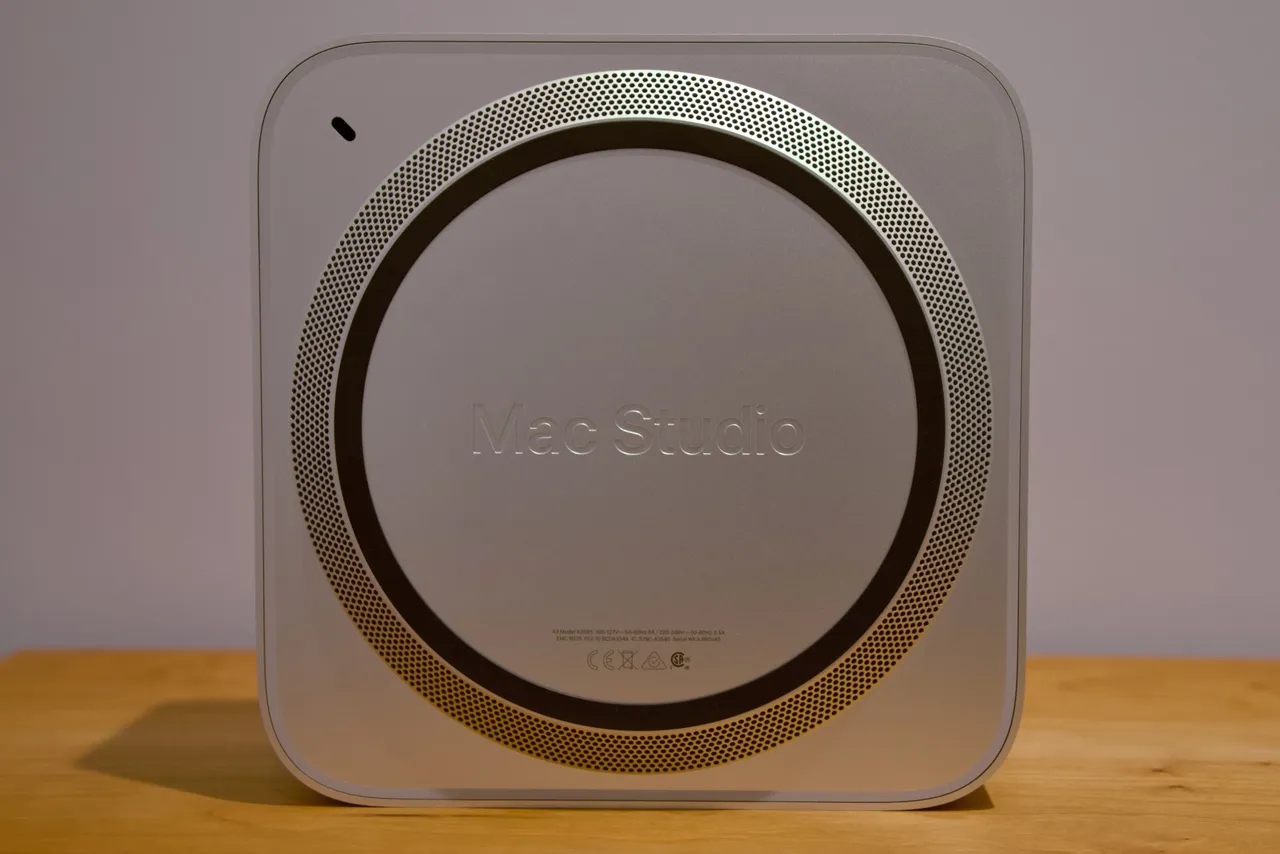
مک استودیوی جدید از نظر ظاهری دقیقاً شبیه همان مدلی است که در سال ۲۰۲۲ با تراشههای M1 Max و M1 Ultra معرفی شد. یک جعبه مکعبی و جمعوجور با ابعاد پایه ۱۹.۵ در ۱۹.۵ سانتیمتر (مشابه مک مینیهای قدیمی) اما با ارتفاعی به مراتب بیشتر. اگرچه مدلهای مکس و اولترا در نگاه اول کاملاً همشکل هستند، ولی نسخه M5 Ultra حدود یک کیلوگرم (دو پوند) سنگینتر است؛ علتش هم استفاده از مس سنگینتر با رسانایی حرارتی بالاتر در سیستم هیتسینک آن است تا خنککاری این غول پردازشی به بهترین شکل انجام شود.
از لحاظ درگاههای ارتباطی، هر دو مدل تقریباً مجهز و یکسان هستند. در پنل پشتی، چهار پورت تاندربولت ۵ فوقسریع با پهنای باند ۱۲۰ گیگابیت بر ثانیه، یک پورت شبکه ۱۰ گیگابیتی، یک پورت HDMI 2.1 و دو پورت USB-A با سرعت ۵ گیگابیت قرار گرفته است. در نمای جلو، هر دو مدل به شیار کارت حافظه SD با استاندارد UHS-II مجهزند؛ اما تفاوت اینجاست که نسخه Max دو پورت USB-C با سرعت ۱۰ گیگابیت بر ثانیه دارد، در حالی که نسخه Ultra دو درگاه پرسرعت تاندربولت ۵ دیگر با پهنای باند ۱۲۰ گیگابیت بر ثانیه را درست در جلوی بدنه به شما تحویل میدهد.
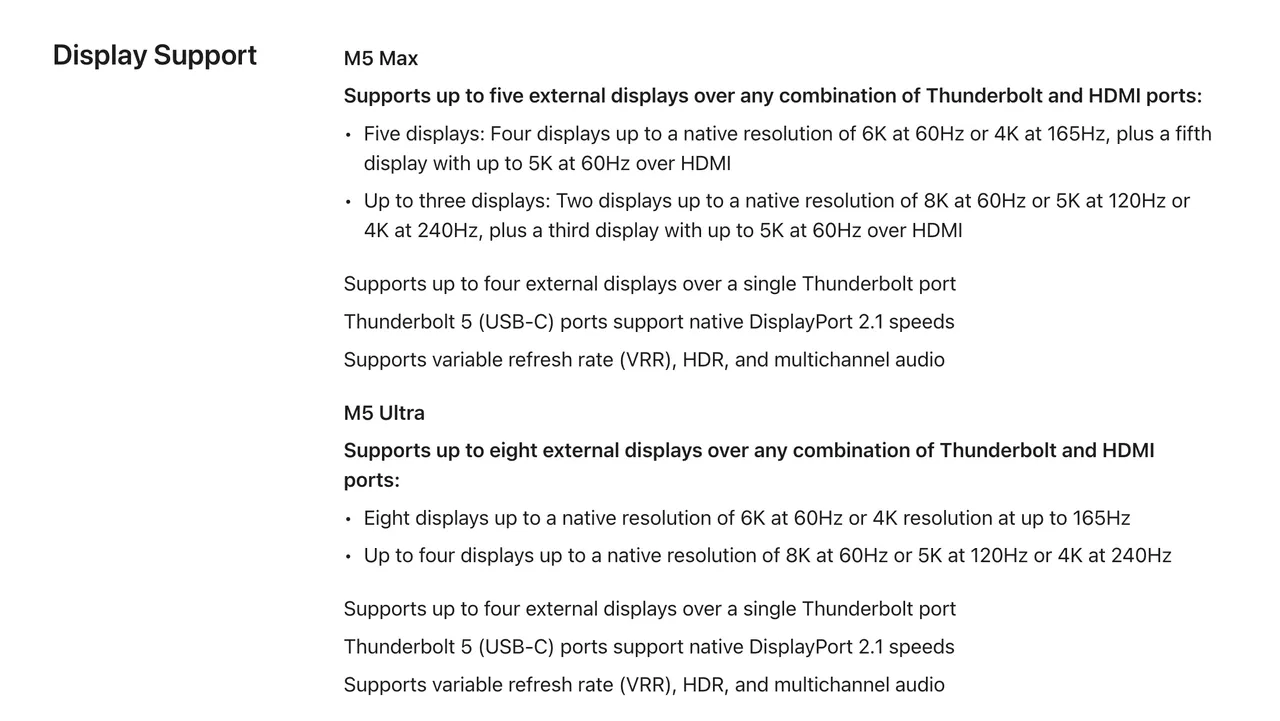
قدرت مضاعف نسخه اولترا در پشتیبانی از مانیتورهای خارجی هم خودنمایی میکند. در حالی که M5 Max از حداکثر ۵ مانیتور خارجی پشتیبانی میکند، M5 Ultra میتواند همزمان تصویر را روی ۸ مانیتور نمایش دهد؛ البته بسته به رزولوشن و نرخ نوسازی تصویر (Refresh Rate) مانیتورها، محدودیتهای فنی خاصی برای هر دو وجود دارد.
تراشه M5 Max اکنون برای اهالی فناوری چهرهای کاملاً آشناست، چرا که اپل از اسفند ماه گذشته آن را در مکبوک پروهای خود روانه بازار کرده است. این تراشه با معرفی هستههای پردازشی جدید موسوم به «Super Cores» و ارتقای پهنای باند حافظه از ۵۴۶ به ۶۱۴ گیگابایت بر ثانیه، گام روبهجلوی محترمی نسبت به نسل M4 Max به حساب میآید. تعداد هستههای گرافیکی روی همان عدد ۴۰ باقی مانده، اما شتابدهندههای عصبی تعبیهشده در دل تکتک هستههای گرافیکی، عملکرد آن را در قابلیتهای مبتنی بر هوش مصنوعی مانند فناوری آپاسکیلینگ MetalFX و تولید فریم (Frame Generation) به شکل محسوسی بهبود دادهاند.
اما تراشه M5 Ultra به چند دلیل مهم یک دگرگونی اساسی است. دلیل اول این است که اپل هرگز مدلی به نام M4 Ultra عرضه نکرد؛ بنابراین با وجود ارتقای یک نسل از خود دستگاه مک استودیو، ما عملاً با یک پرش دو نسلی در معماری پردازنده روبهرو هستیم.
مدل تراشه | هستههای CPU (سوپر/قدرتمند/کممصرف) | هستههای گرافیک (GPU) | گزینههای حافظه رم | پهنای باند حافظه |
|---|---|---|---|---|
Apple M5 Ultra (پایه) | ۱۰ سوپر / ۲۰ قدرتمند | ۶۴ | ۹۶ و ۲۵۶ گیگابایت | ۱٬۲۲۸.۸ گیگابایت بر ثانیه |
Apple M5 Ultra (کامل) | ۱۲ سوپر / ۲۴ قدرتمند | ۸۰ | ۹۶، ۲۵۶ و ۵۱۲ گیگابایت (برنامهریزیشده) | ۱٬۲۲۸.۸ گیگابایت بر ثانیه |
Apple M3 Ultra (کامل) | ۲۴ قدرتمند / ۸ کممصرف | ۸۰ | ۱۲۸، ۲۵۶ و ۵۱۲ گیگابایت | ۸۱۹.۲ گیگابایت بر ثانیه |
Apple M2 Ultra (کامل) | ۱۶ قدرتمند / ۸ کممصرف | ۷۶ | حداکثر ۱۹۲ گیگابایت | ۸۱۹.۲ گیگابایت بر ثانیه |
Apple M1 Ultra (کامل) | ۱۶ قدرتمند / ۴ کممصرف | ۳۲ | حداکثر ۱۲۸ گیگابایت | ۸۱۹.۲ گیگابایت بر ثانیه |
دلیل دوم به شیوه مهندسی و ساخت تراشه مربوط میشود. تراشههای M1 Ultra، M2 Ultra و M3 Ultra همگی اساساً از اتصال دو تراشه Max در کنار یکدیگر از طریق یک رابط ارتباطی پرسرعت ساخته میشدند؛ ترفندی هوشمندانه که مزایای یک تراشه غولپیکر یکپارچه را بدون دردسرهای پیچیده تولید سیلیکونهای بسیار بزرگ به همراه داشت.
تراشه M5 Ultra نیز روی کاغذ همچنان حاصل به هم دوختن دو تراشه M5 Max است؛ تا اینجای ماجرا تغییری نکرده است. این غول سیلیکونی تا ۱۲ هسته پردازشی سوپر، تا ۲۴ هسته قدرتمند، تا ۸۰ هسته گرافیکی، ۳۲ هسته موتور عصبی (Neural Engine)، دو موتور دیکود و چهار موتور انکود ویدیو و بیش از ۱.۲ ترابایت بر ثانیه (بله، ترابایت با حرف ت!) پهنای باند حافظه را در خود جای داده است؛ یعنی دقیقاً دو برابر شدن تمام مشخصات کلیدی M5 Max.
اما نکته کاملاً تازه این نسل اینجاست: تراشههای M5 Pro و M5 Max خودشان از دو چیپلت مجزا تشکیل شدهاند که با رابطهای سیلیکونی به هم متصلاند؛ این یعنی M5 Ultra در عمل حاصل بستهبندی چهار قطعه سیلیکونی مجزا در کنار یکدیگر است! نقطهضعف بالقوه این طراحی ماژولار این است که ارتباط بین دایها (Die-to-die) معمولاً به اندازه قطعاتی که روی یک قالب سیلیکونی یکتکه قرار دارند سریع نیست. البته معماری فیوژن (Fusion Architecture) تا به امروز مانع پرواز تراشههای اولترا نشده و جلوی سرعت سرسامآور M5 Ultra را هم نگرفته است، اما کارایی تراشههای اولترا هیچوقت به صورت کاملاً خطی با افزایش تعداد هستهها دو برابر نمیشده و M5 Ultra هم از این قاعده مستثنی نیست.
و البته: قیمتهای سرسامآور جدید :(
در حالت عادی وقتی نسل جدیدی از مکها معرفی میشود، فقط روی بهبودهای سختافزاری تمرکز میکنیم و فرض را بر این میگذاریم که از نظر قیمت همه چیز ثابت مانده است؛ در نتیجه سختافزار جدیدتر با همان قیمت، ارزش خرید بسیار بالاتری پیدا میکرد. اما امسال داستان فرق دارد؛ اپل به خاطر بحران جهانی کمبود حافظه ناشی از رونق هوش مصنوعی، قیمتها را در تمام خطوط تولید بالا برده است. مک استودیو هم به عنوان پرچمدار رومیزی با بالاترین حجم رم و حافظه ذخیرهسازی، ضربه بسیار سنگینتری از بقیه مکها خورده است.
در زمان معرفی نسل قبل، مک استودیو پایه با پردازنده M4 Max قیمتی معادل ۱٬۹۹۹ دلار داشت که نسخهای اندکی تعدیلشده از تراشه، ۳۶ گیگابایت رم و ۵۱۲ گیگابایت حافظه داخلی را در اختیارتان میگذاشت. حالا مک استودیو M5 Max از ۲٬۴۹۹ دلار شروع میشود؛ یعنی ۵۰۰ دلار افزایش قیمت! نسخه قبلی M3 Ultra با ۹۶ گیگابایت رم و ۱ ترابایت حافظه قیمتش ۳٬۹۹۹ دلار بود، اما نسخه معادل M5 Ultra برایتان ۵٬۴۹۹ دلار آب میخورد؛ یک جهش نجومی ۱٬۵۰۰ دلاری! و این تازه برای مدلهای پایه است. اگر سراغ نسخه کامل M5 Max با ۶۴ گیگابایت رم و ۱ ترابایت حافظه بروید—که به نظر من نقطه تعادل طلایی قیمت و عملکرد برای کار با هوش مصنوعی محلی است—باید ۳٬۷۹۹ دلار پیاده شوید؛ یعنی ۹۰۰ دلار گرانتر از زمان عرضه M4 Max Studio.
و اما نسخه اولترا؟ مدلی با ۲۵۶ گیگابایت رم و ۱ ترابایت حافظه که ۱۸ ماه پیش ۵٬۵۹۹ دلار قیمت داشت، حالا ۹٬۴۹۹ دلار قیمتگذاری شده است؛ دقیقاً دو برابر نشده، اما آنقدر نزدیک است که تفاوت چندانی با دو برابر شدن ندارد! قرار است نسخه ۵۱۲ گیگابایتی M5 Ultra هم عرضه شود، اما اپل هنوز قیمتش را اعلام نکرده است. با توجه به اینکه نسخه ۵۱۲ گیگابایتی قبلی ۹٬۴۹۹ دلار بود، با اطمینان میتوان گفت مدل جدید بالای ۲۰٬۰۰۰ دلار قیمت خواهد داشت! برای علاقهمندی به اجر��ی مدلهای بزرگ هوش مصنوعی به شکل محلی، باید از همان ابتدا هزینه اولیه بسیار بیشتری نسبت به اجاره دیتاسنترهای مجهز به کارتهای انویدیا بپردازید؛ با این قیمتها، خرید چند دستگاه مک استودیو حس ساختن یک دیتاسنتر شخصی از جیب خودتان را دارد!
حالا که تصویر روشنی از قیمتها پیدا کردید، وقت آن است که عملکرد واقعی دستگاه را زیر ذرهبین ببریم.
عملکرد پردازشی عمومی: قدرتنمایی غول جدید
تراشه M5 Ultra تقریباً با هر معیاری که بسنجید، سریعترین پردازنده اپل سیلیکونی است که تا به امروز ساخته شده است. تنها جایی که عقب میماند، عملکرد تکهستهای پردازنده است؛ جایی که تراشه M6 در مک مینی با اختلافی بسیار جزئی از آن سبقت میگیرد. البته این شکاف آنقدر ناچیز است (حتی کوچکتر از فاصله نسلهای M3 و M4) که مثل گذشته و زمان معرفی مک استودیوی قبلی به چشم نمیآید.
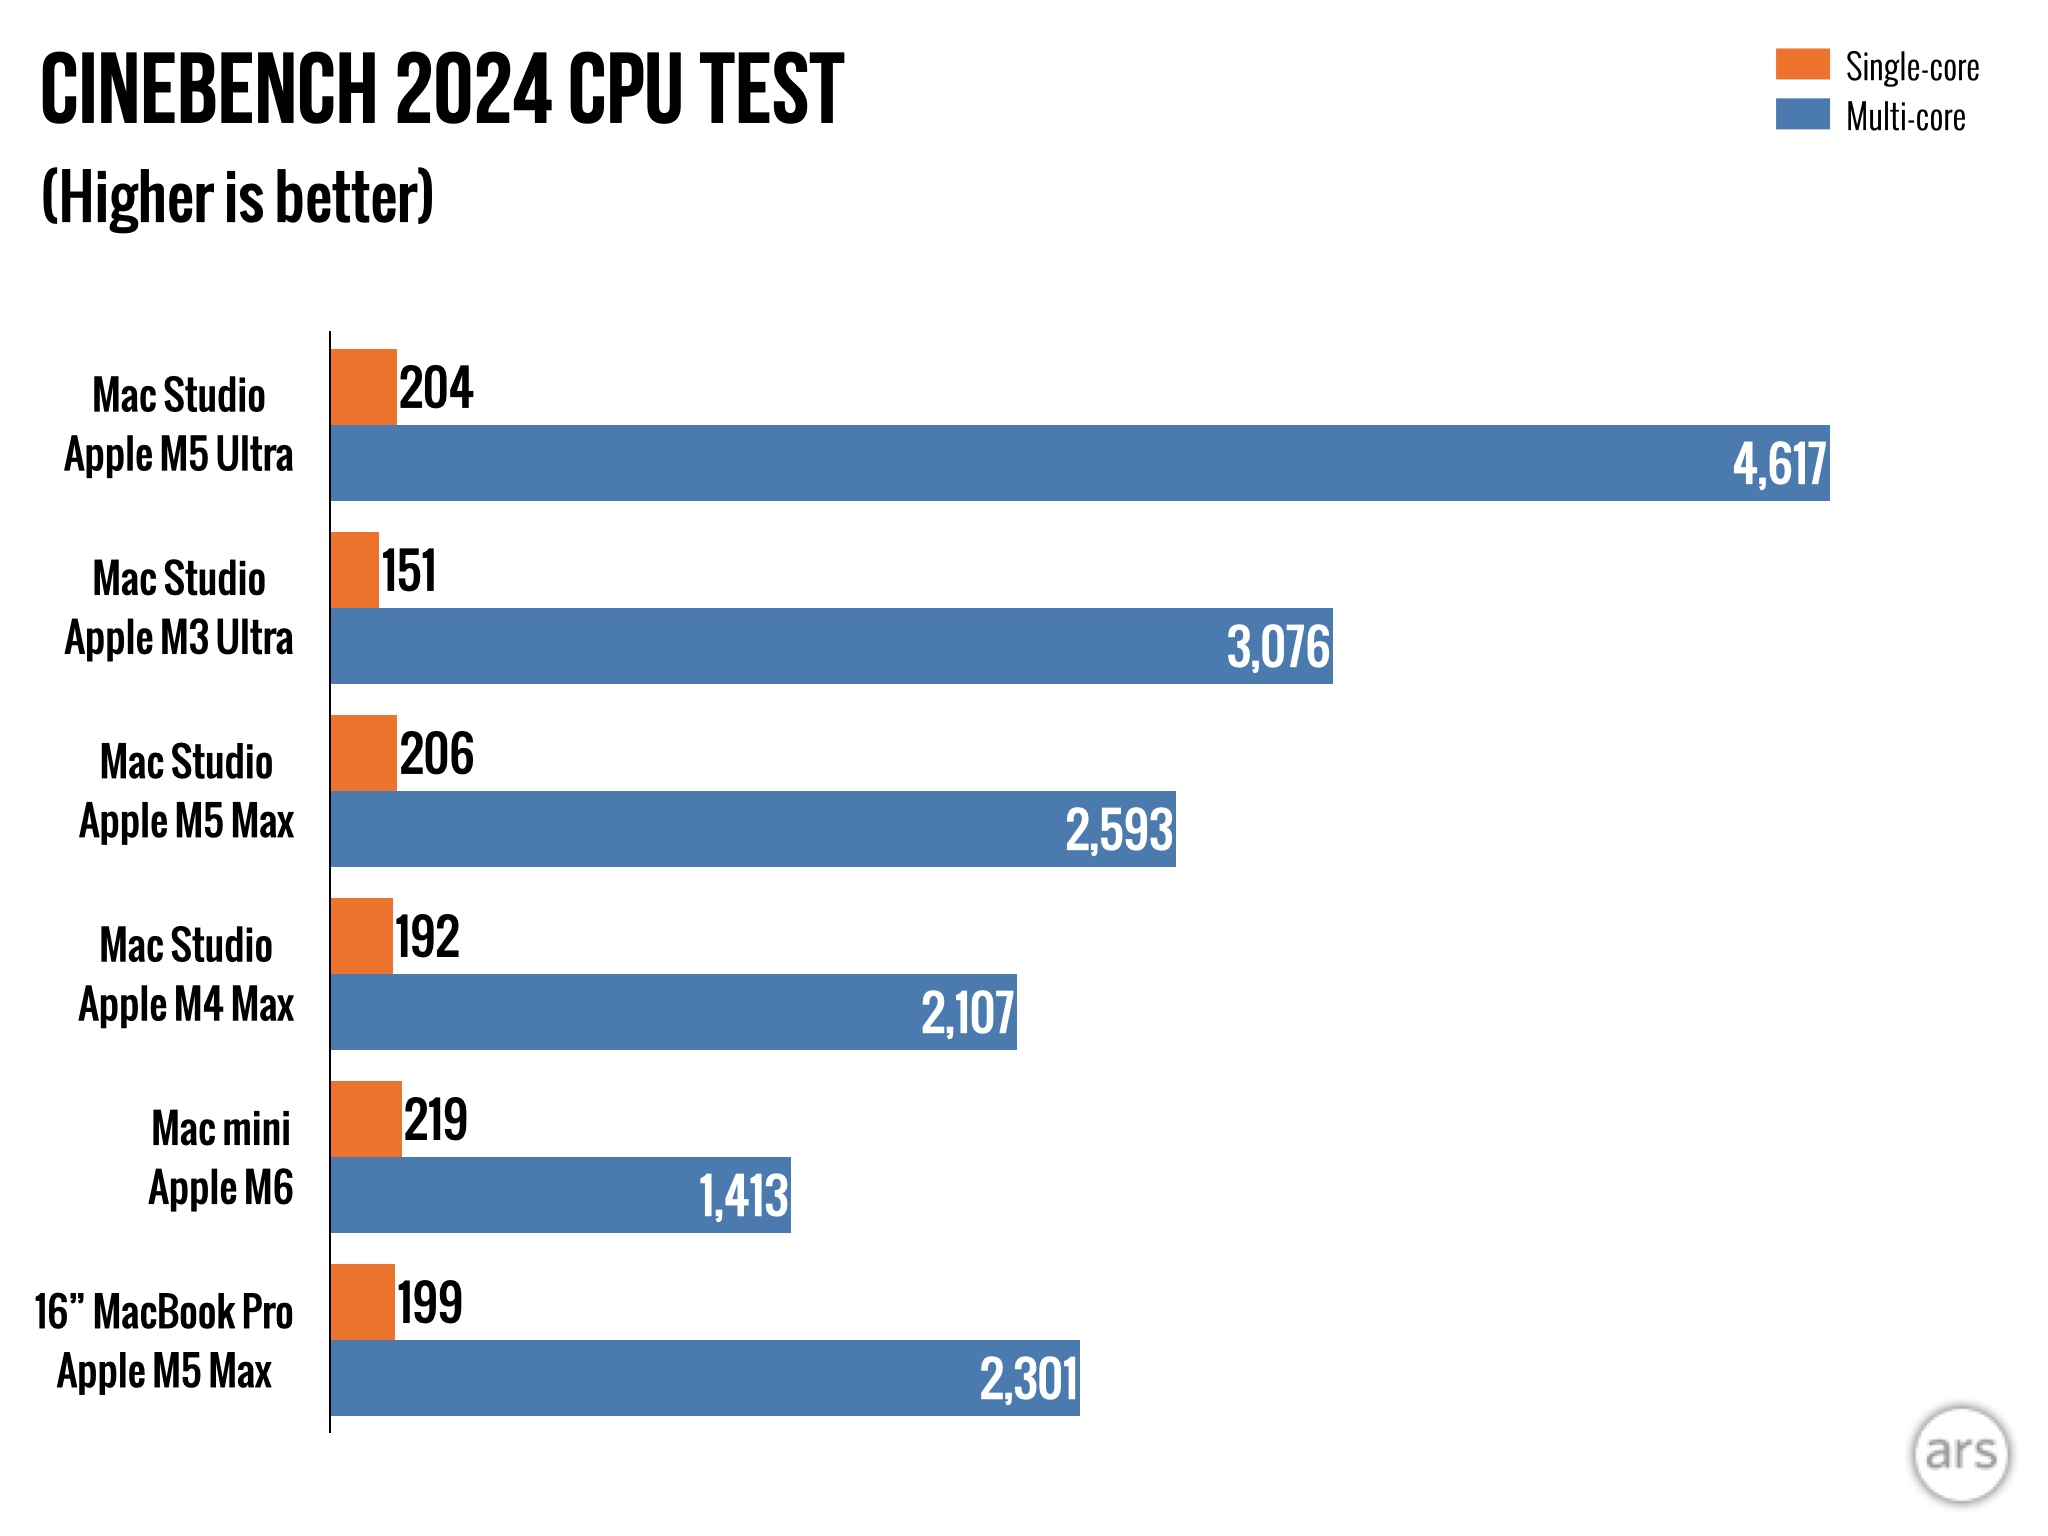
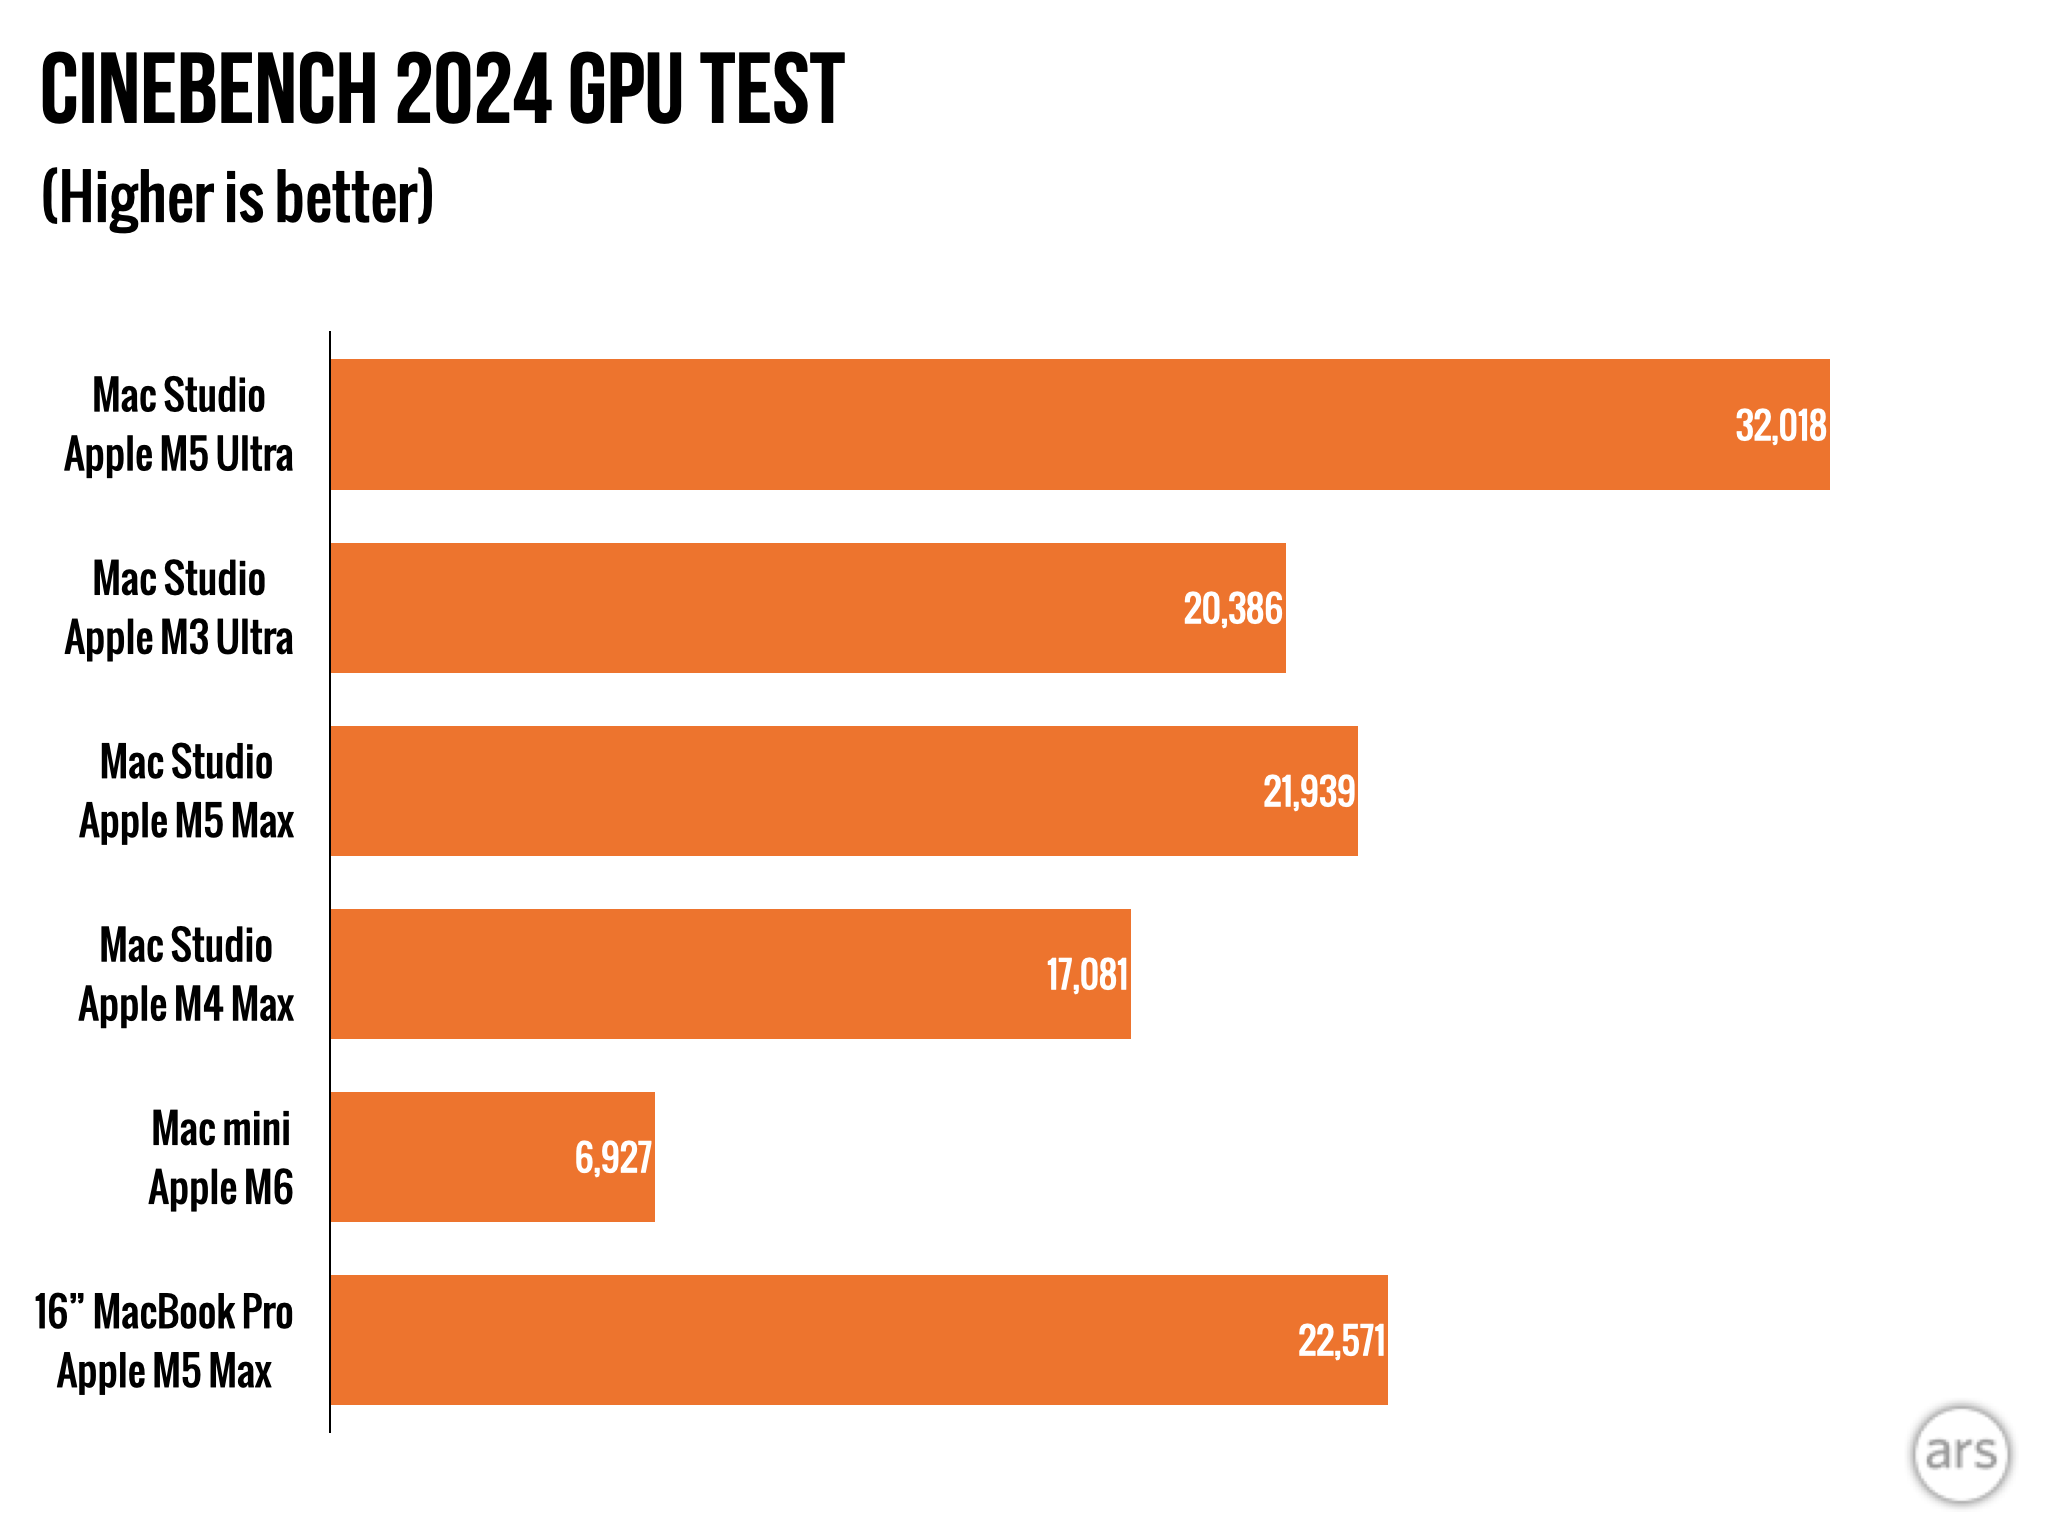
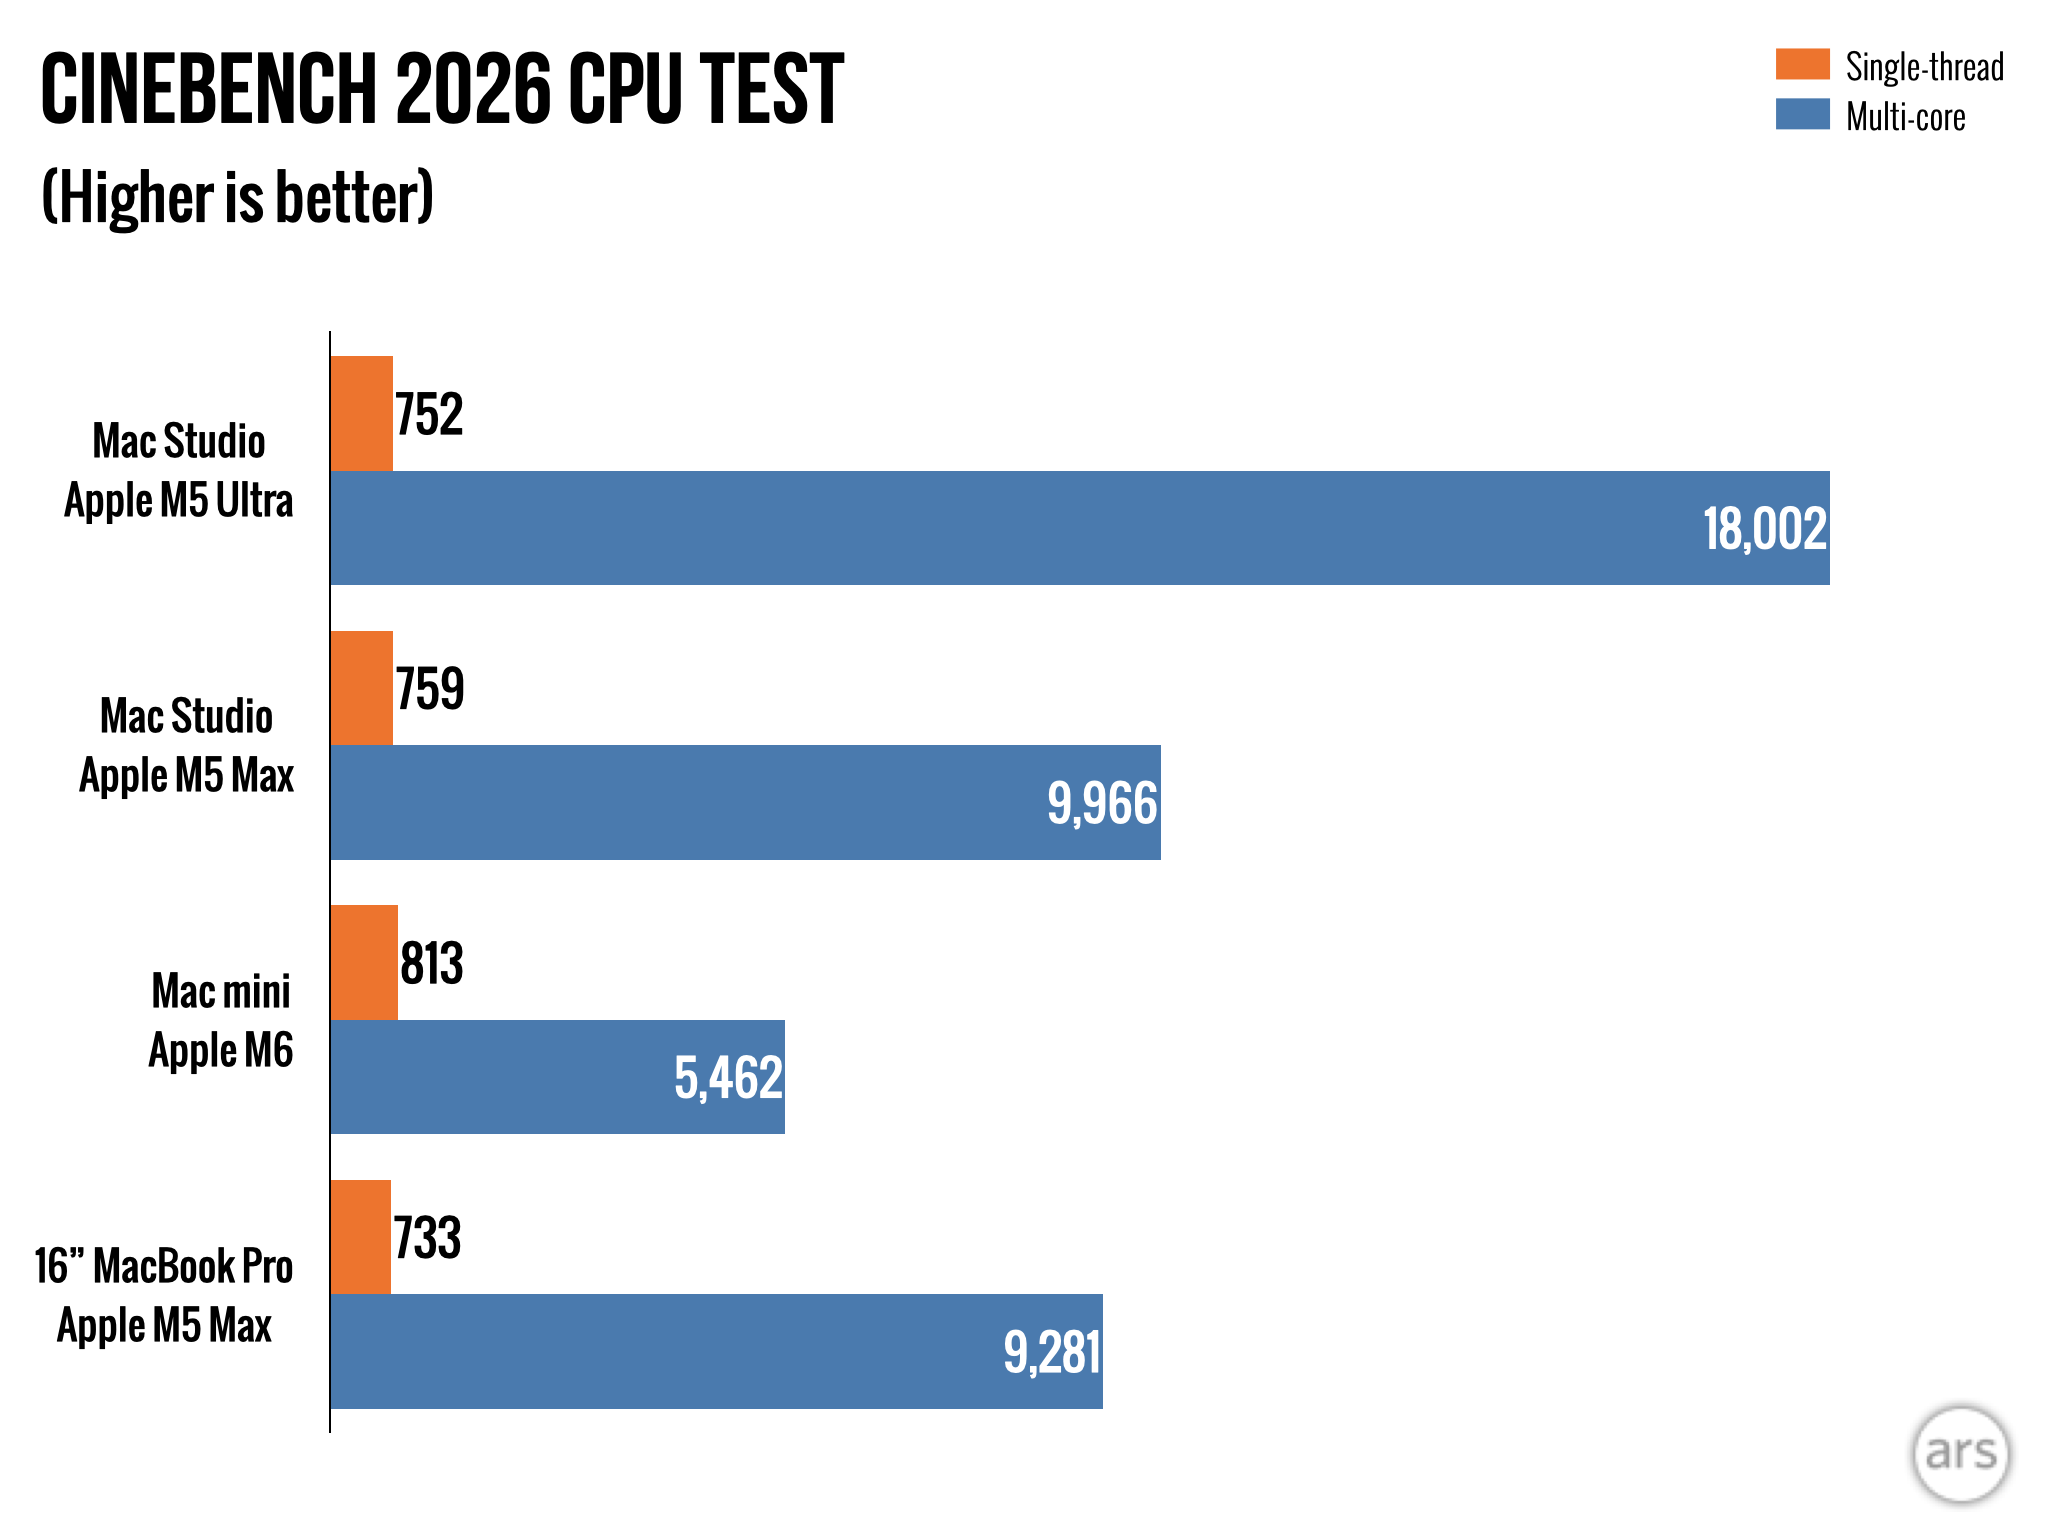
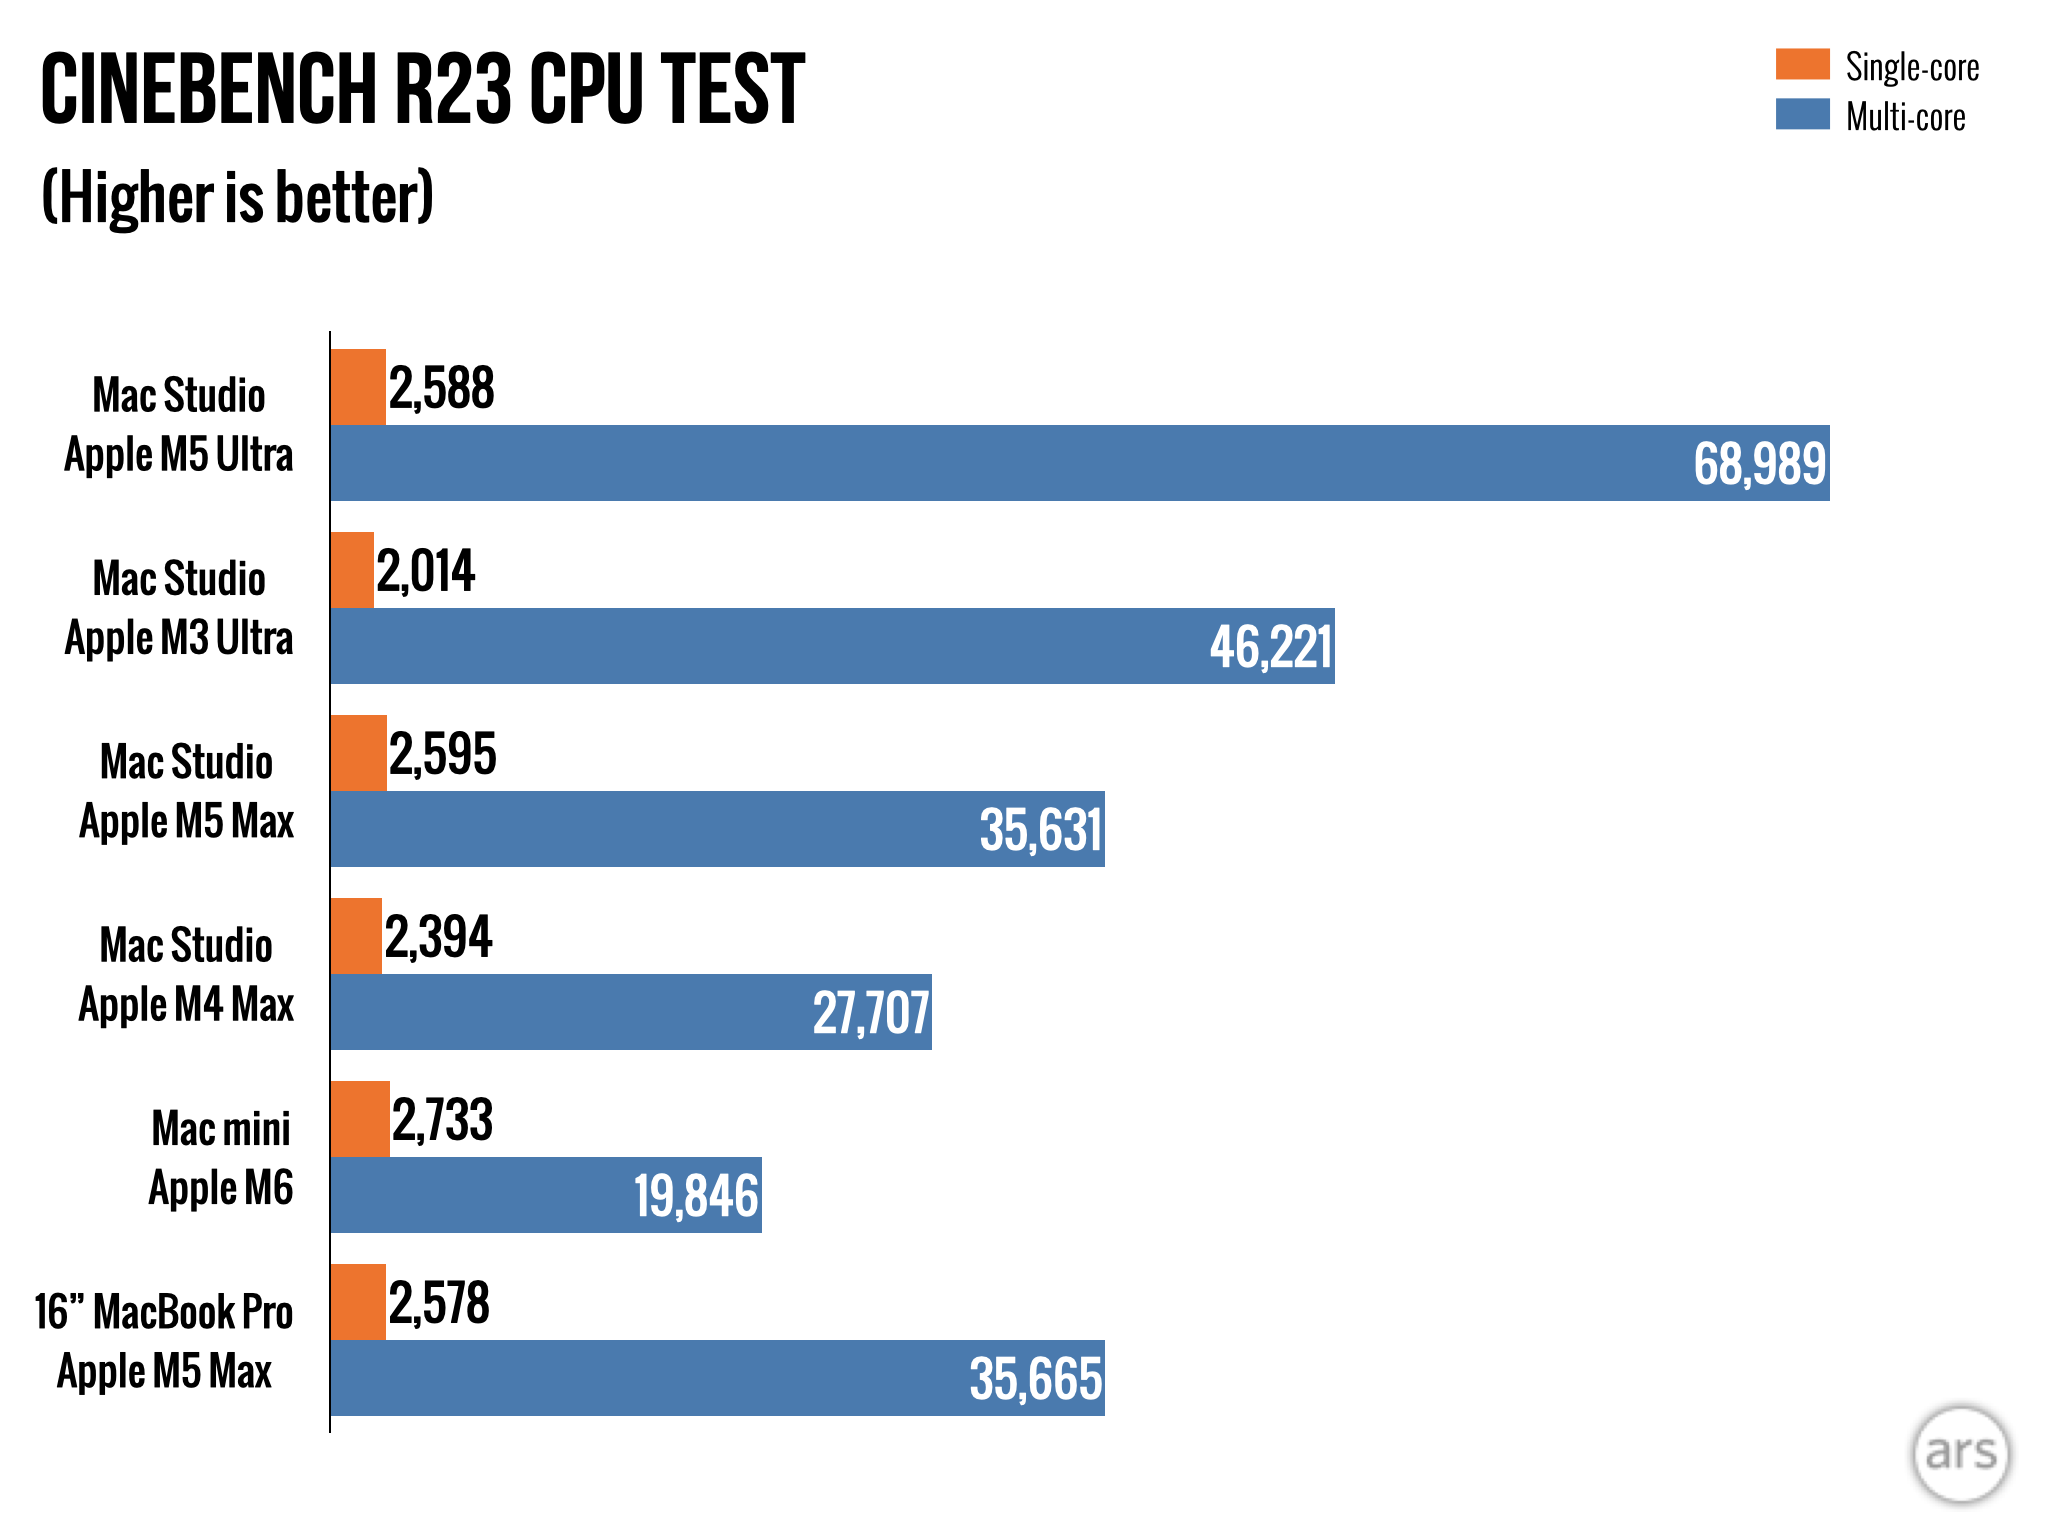
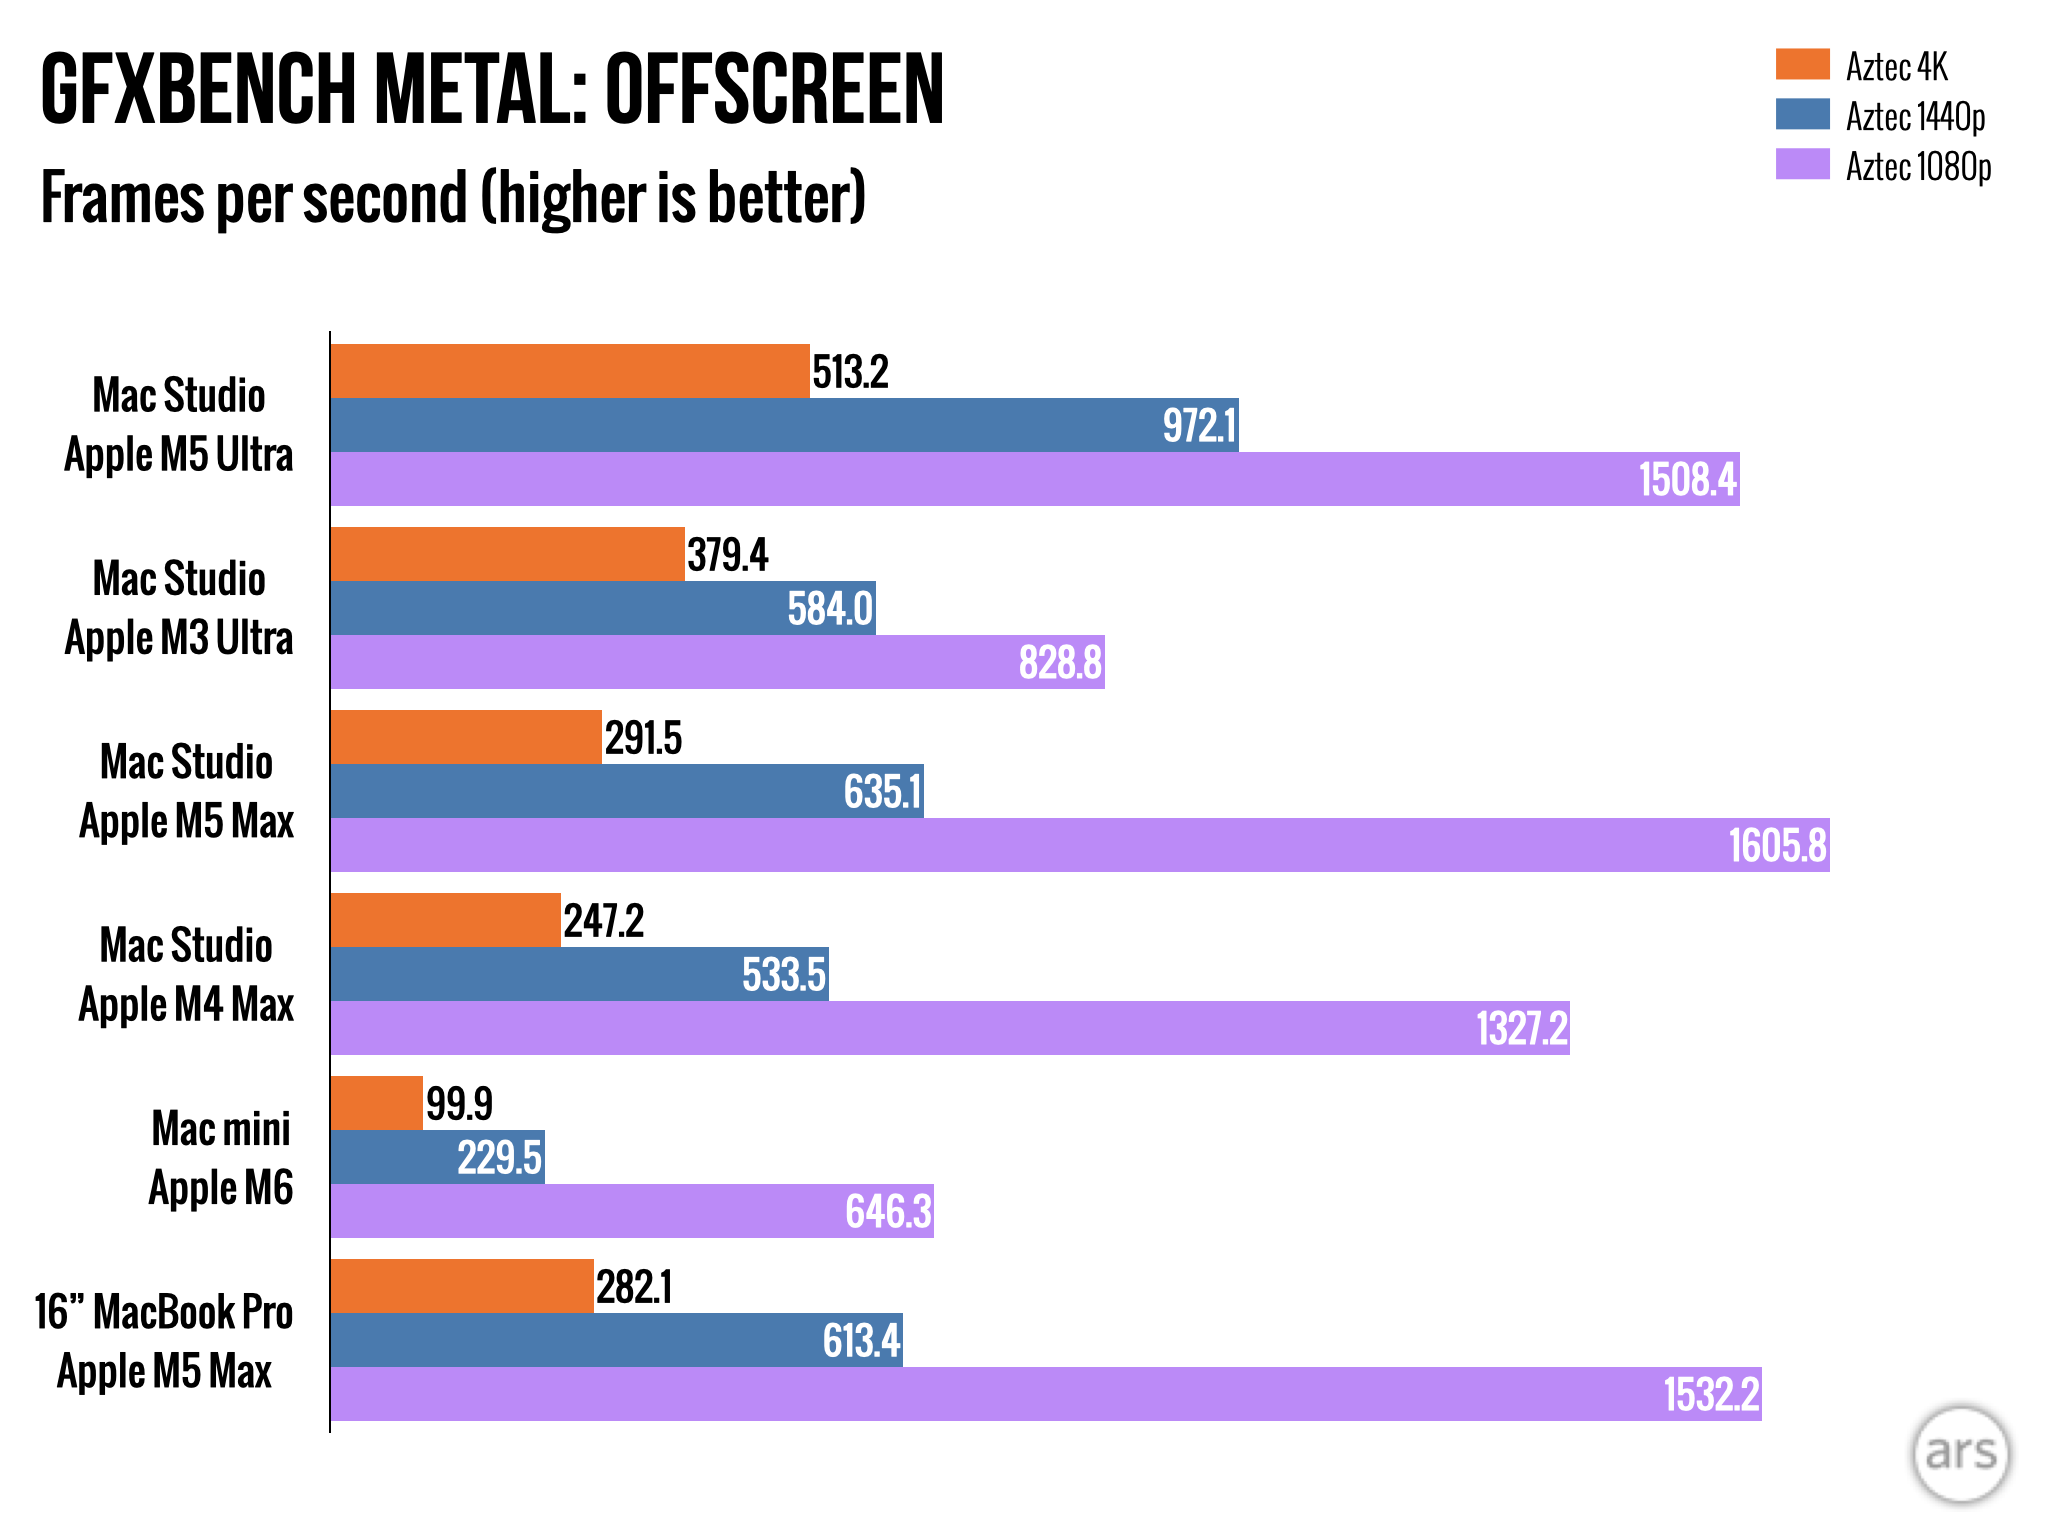
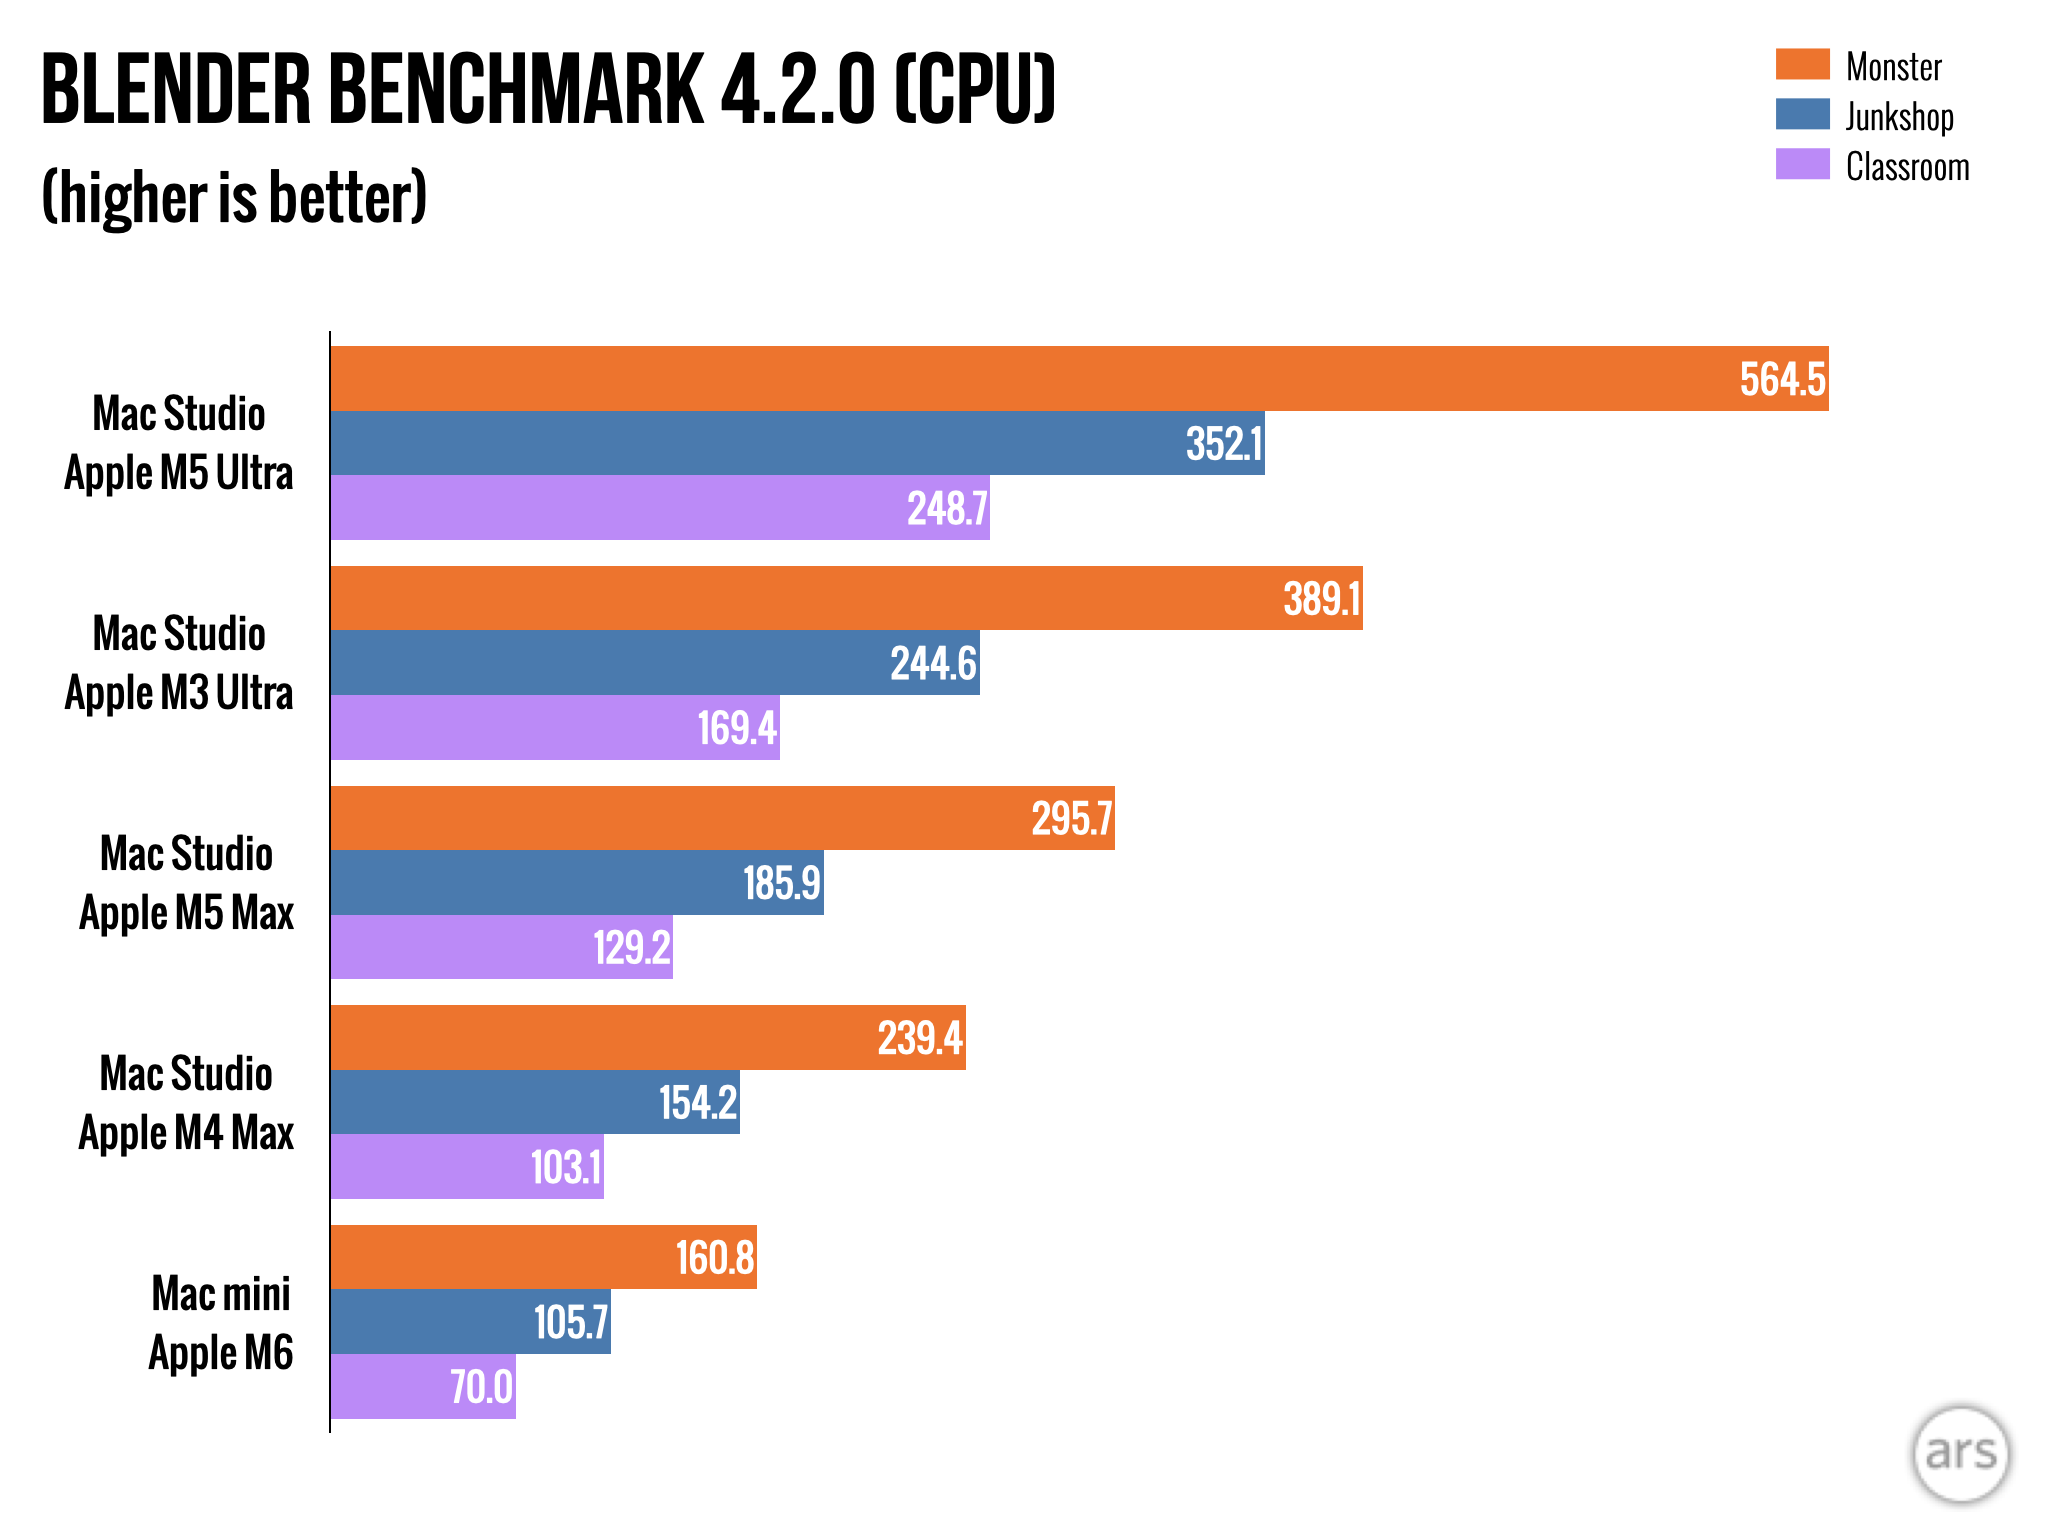
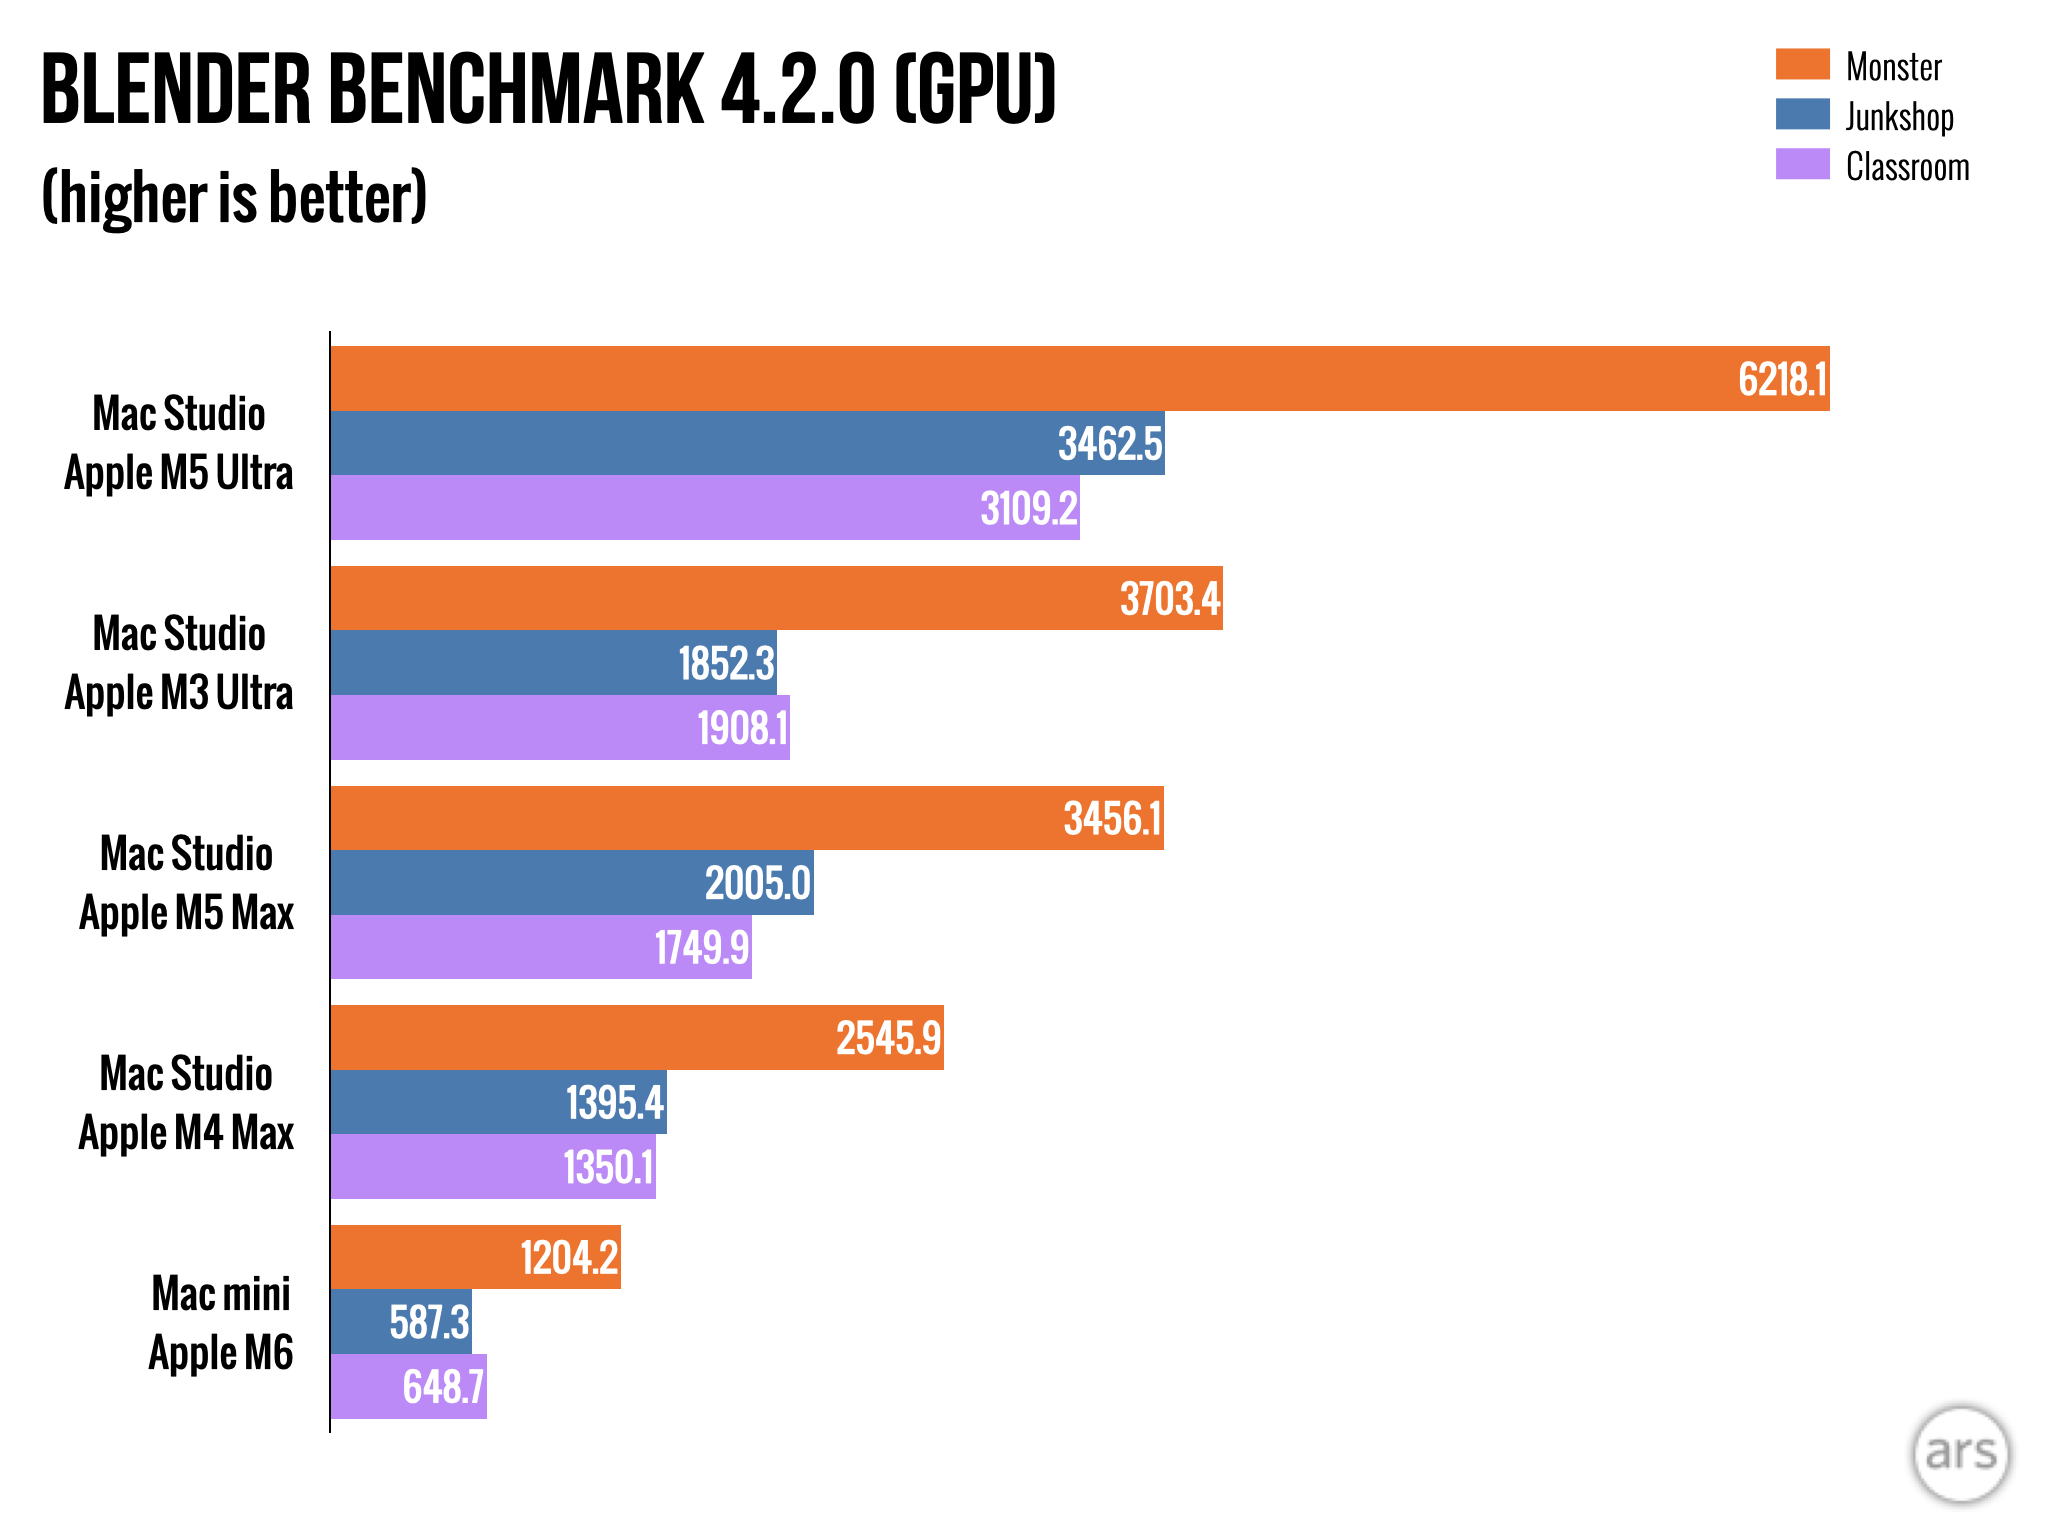
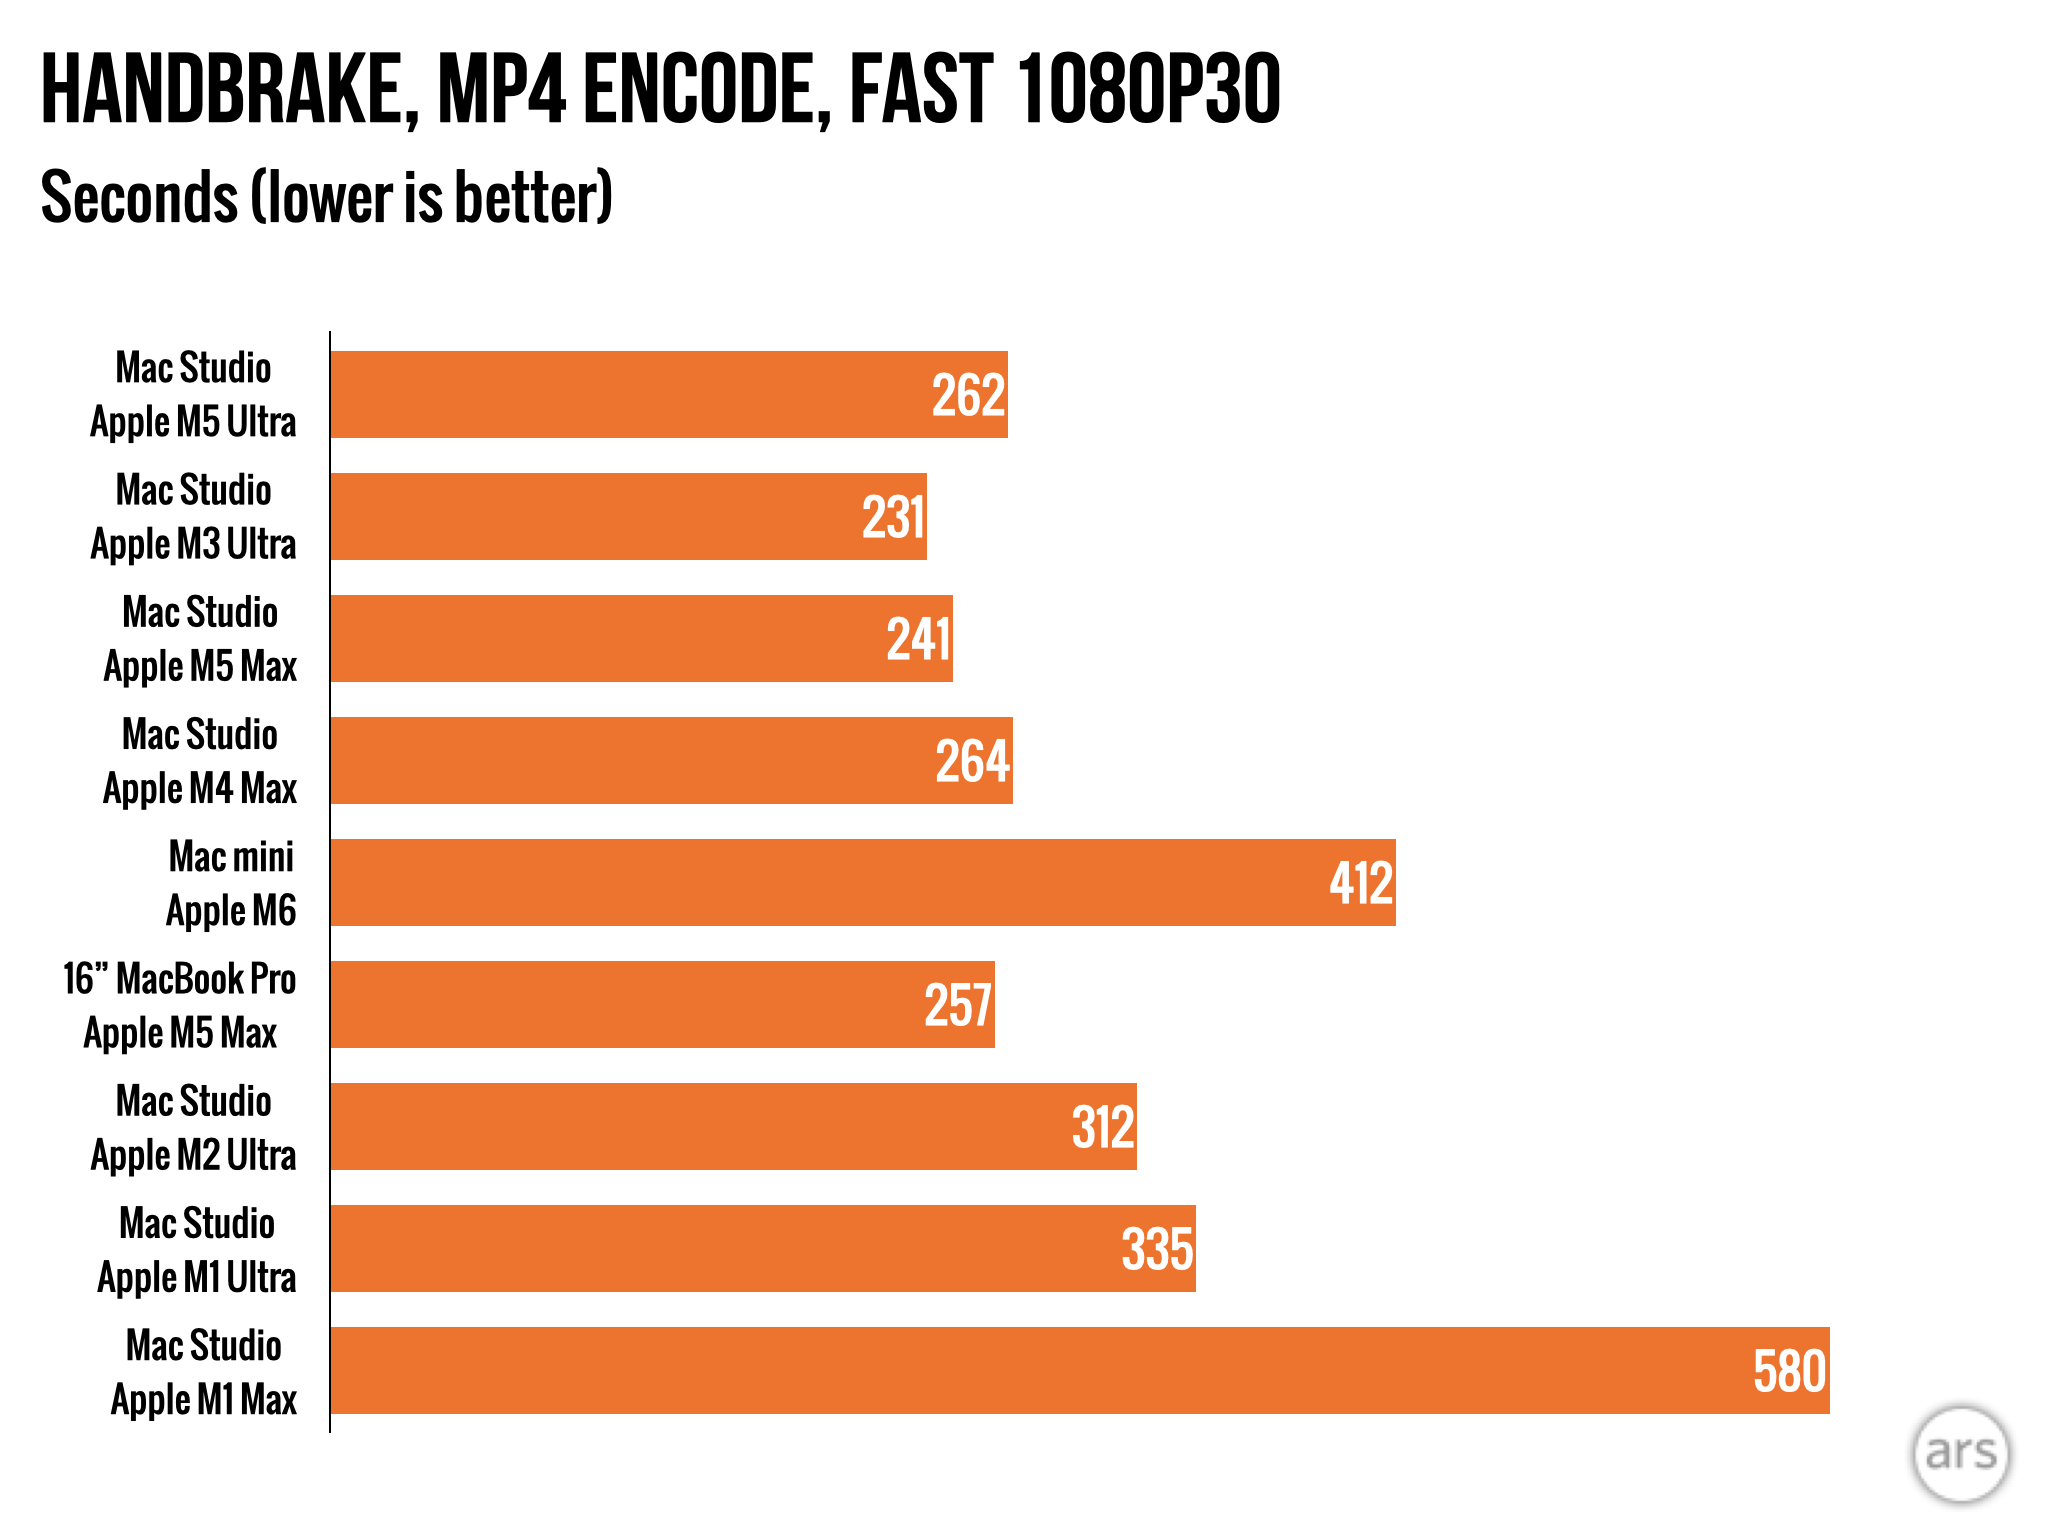
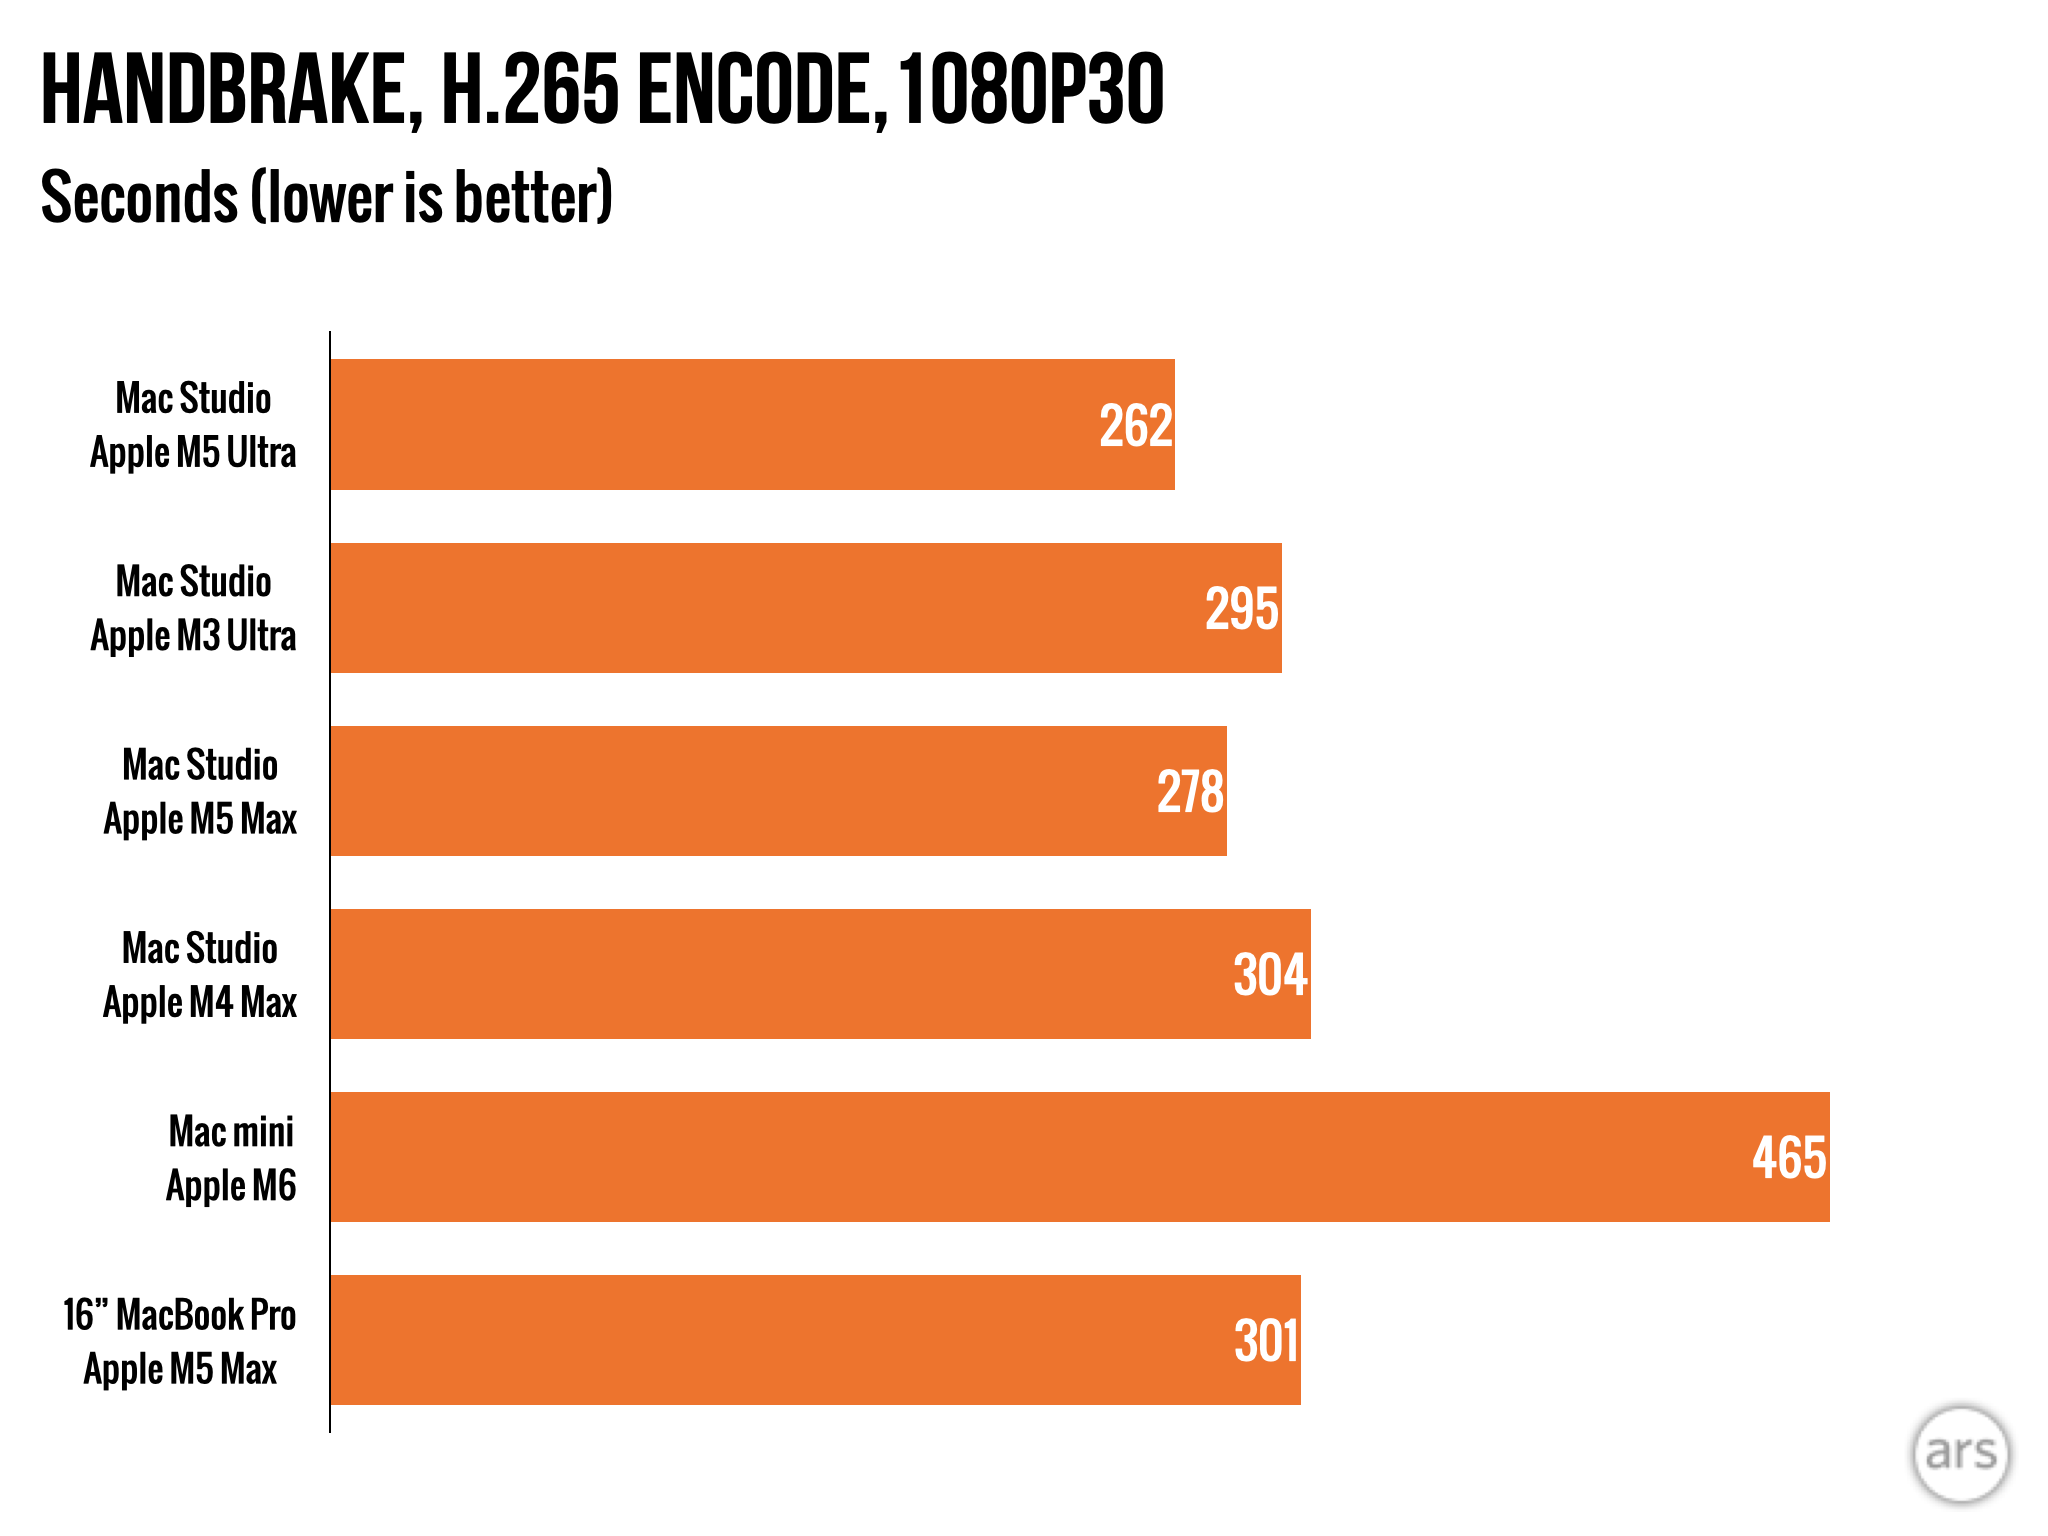
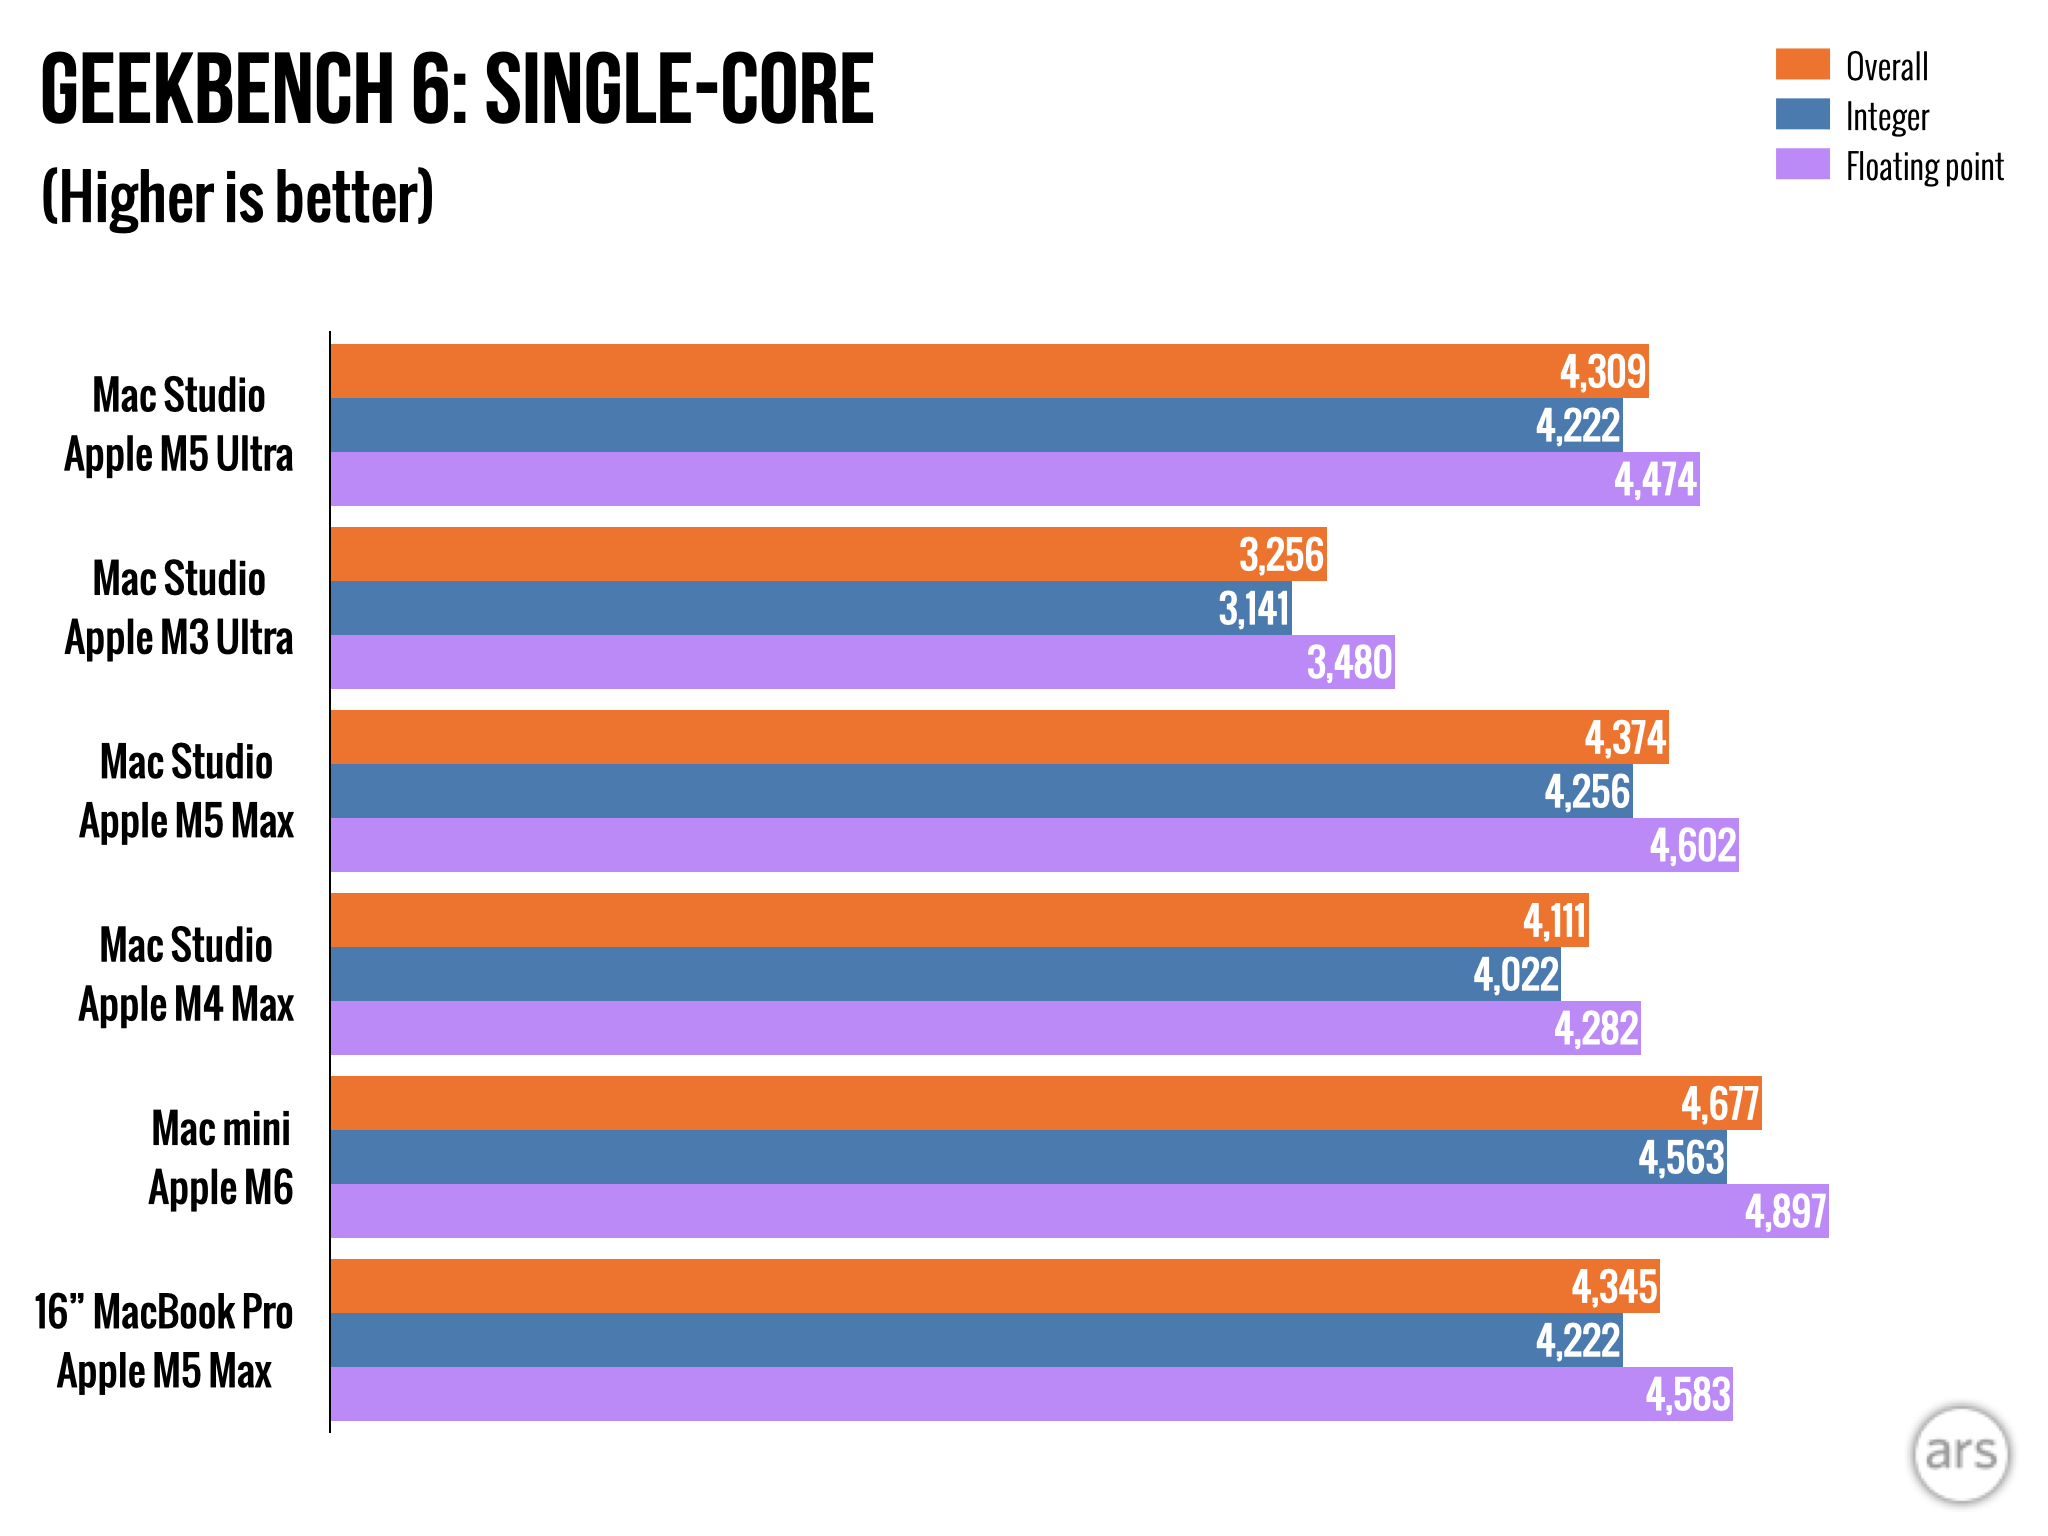
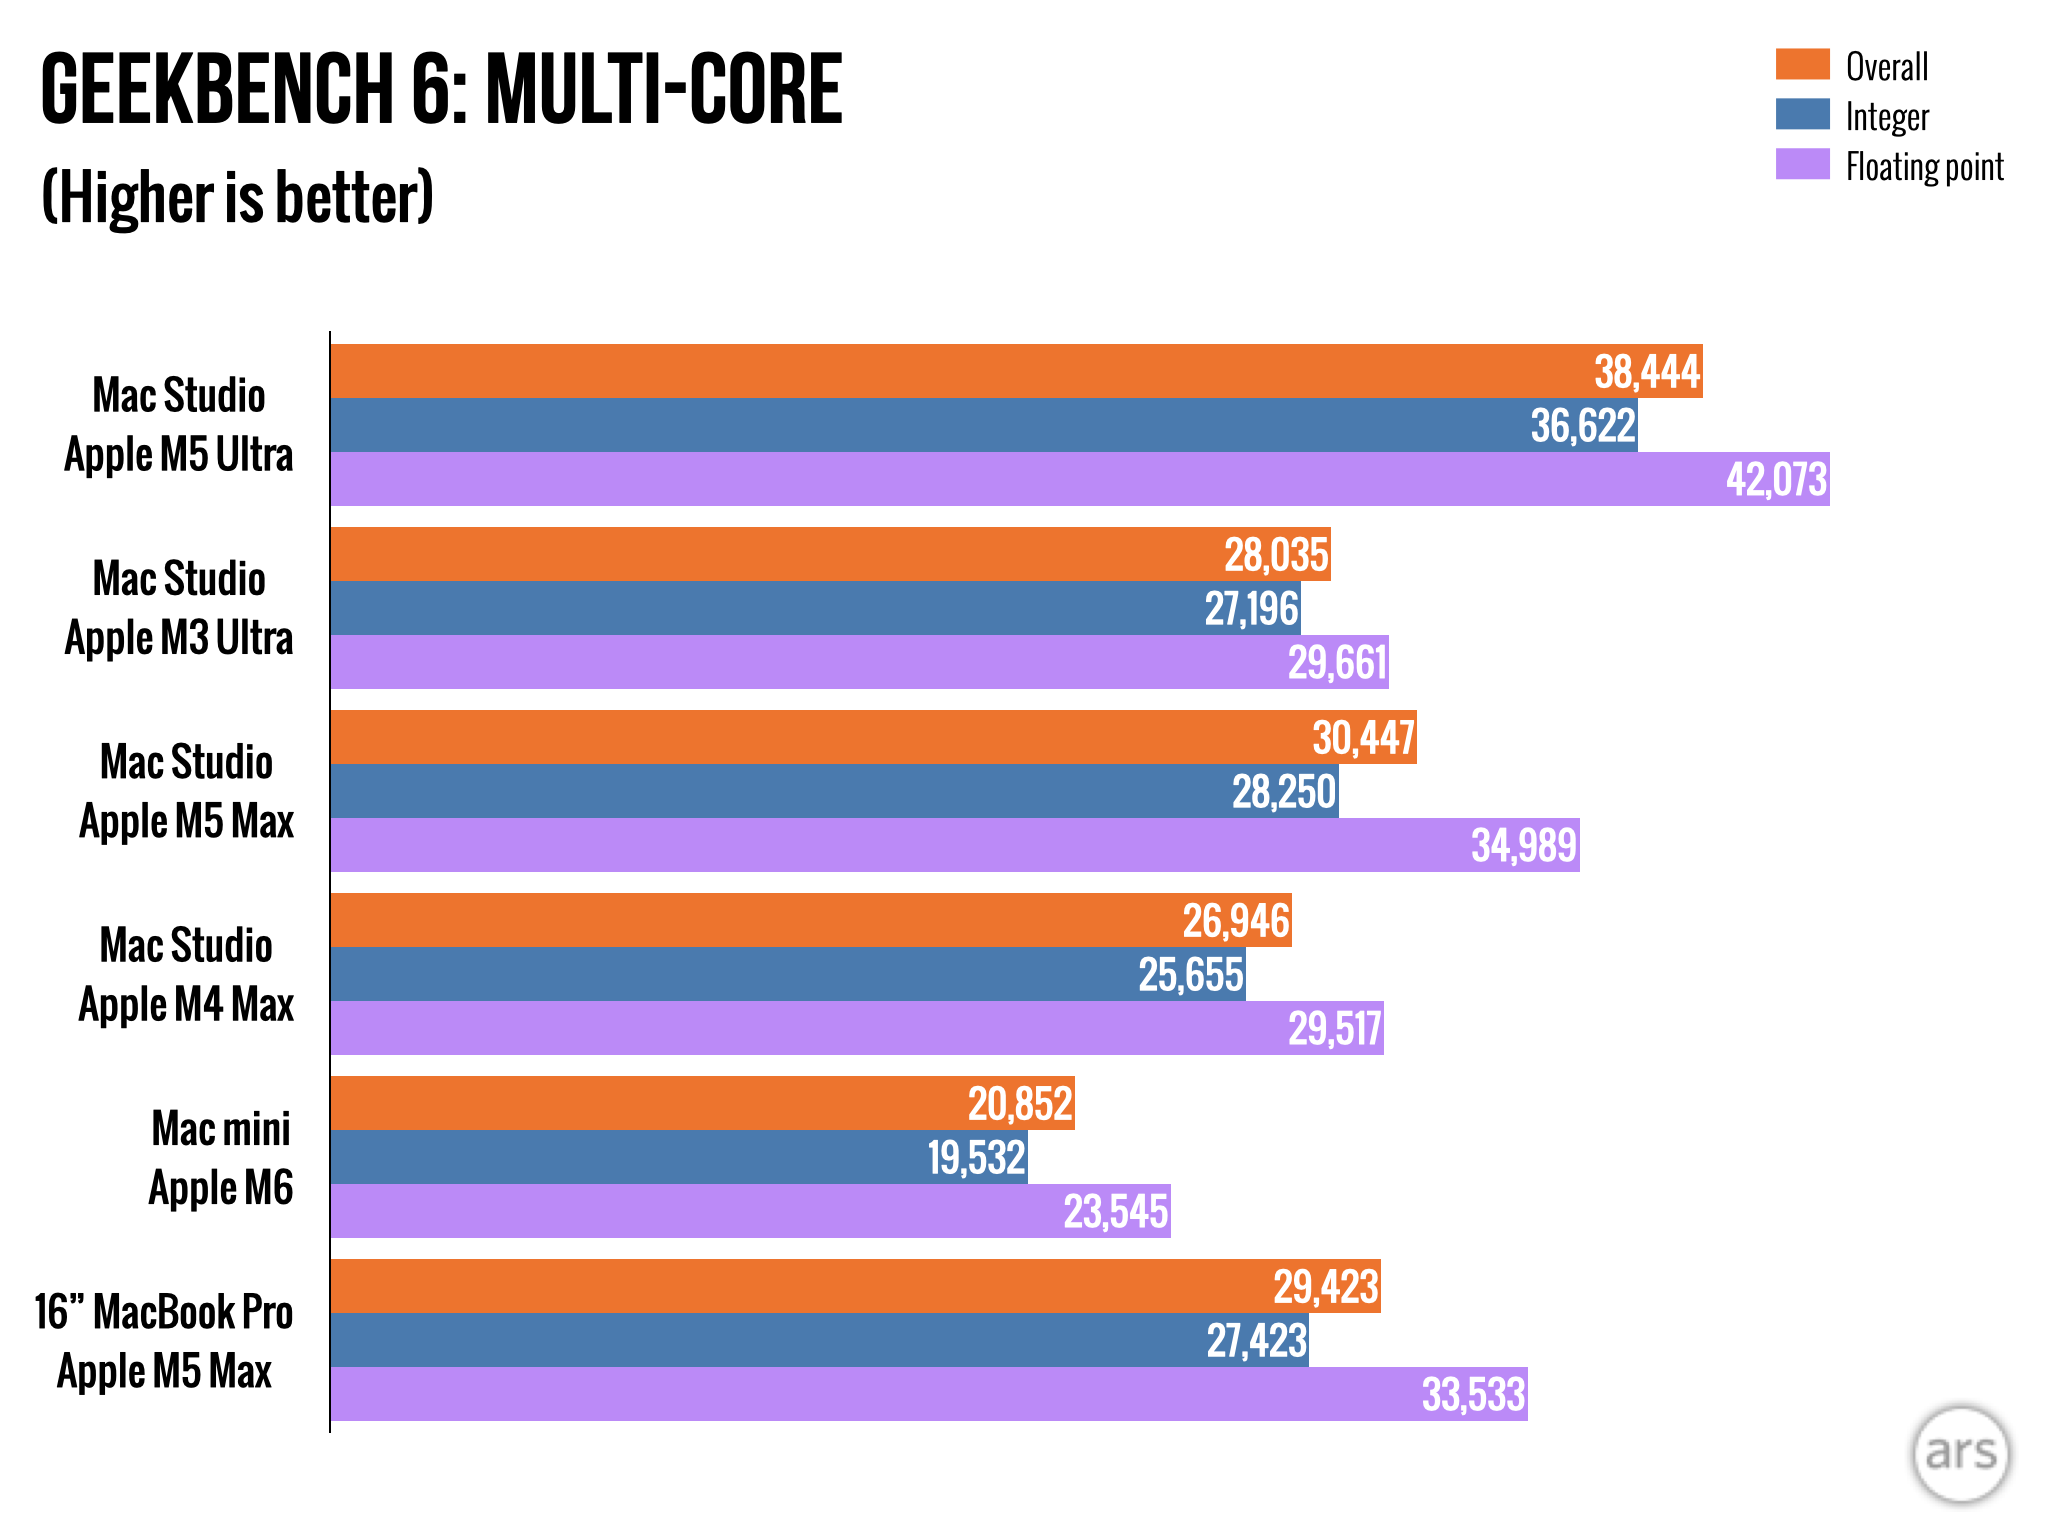
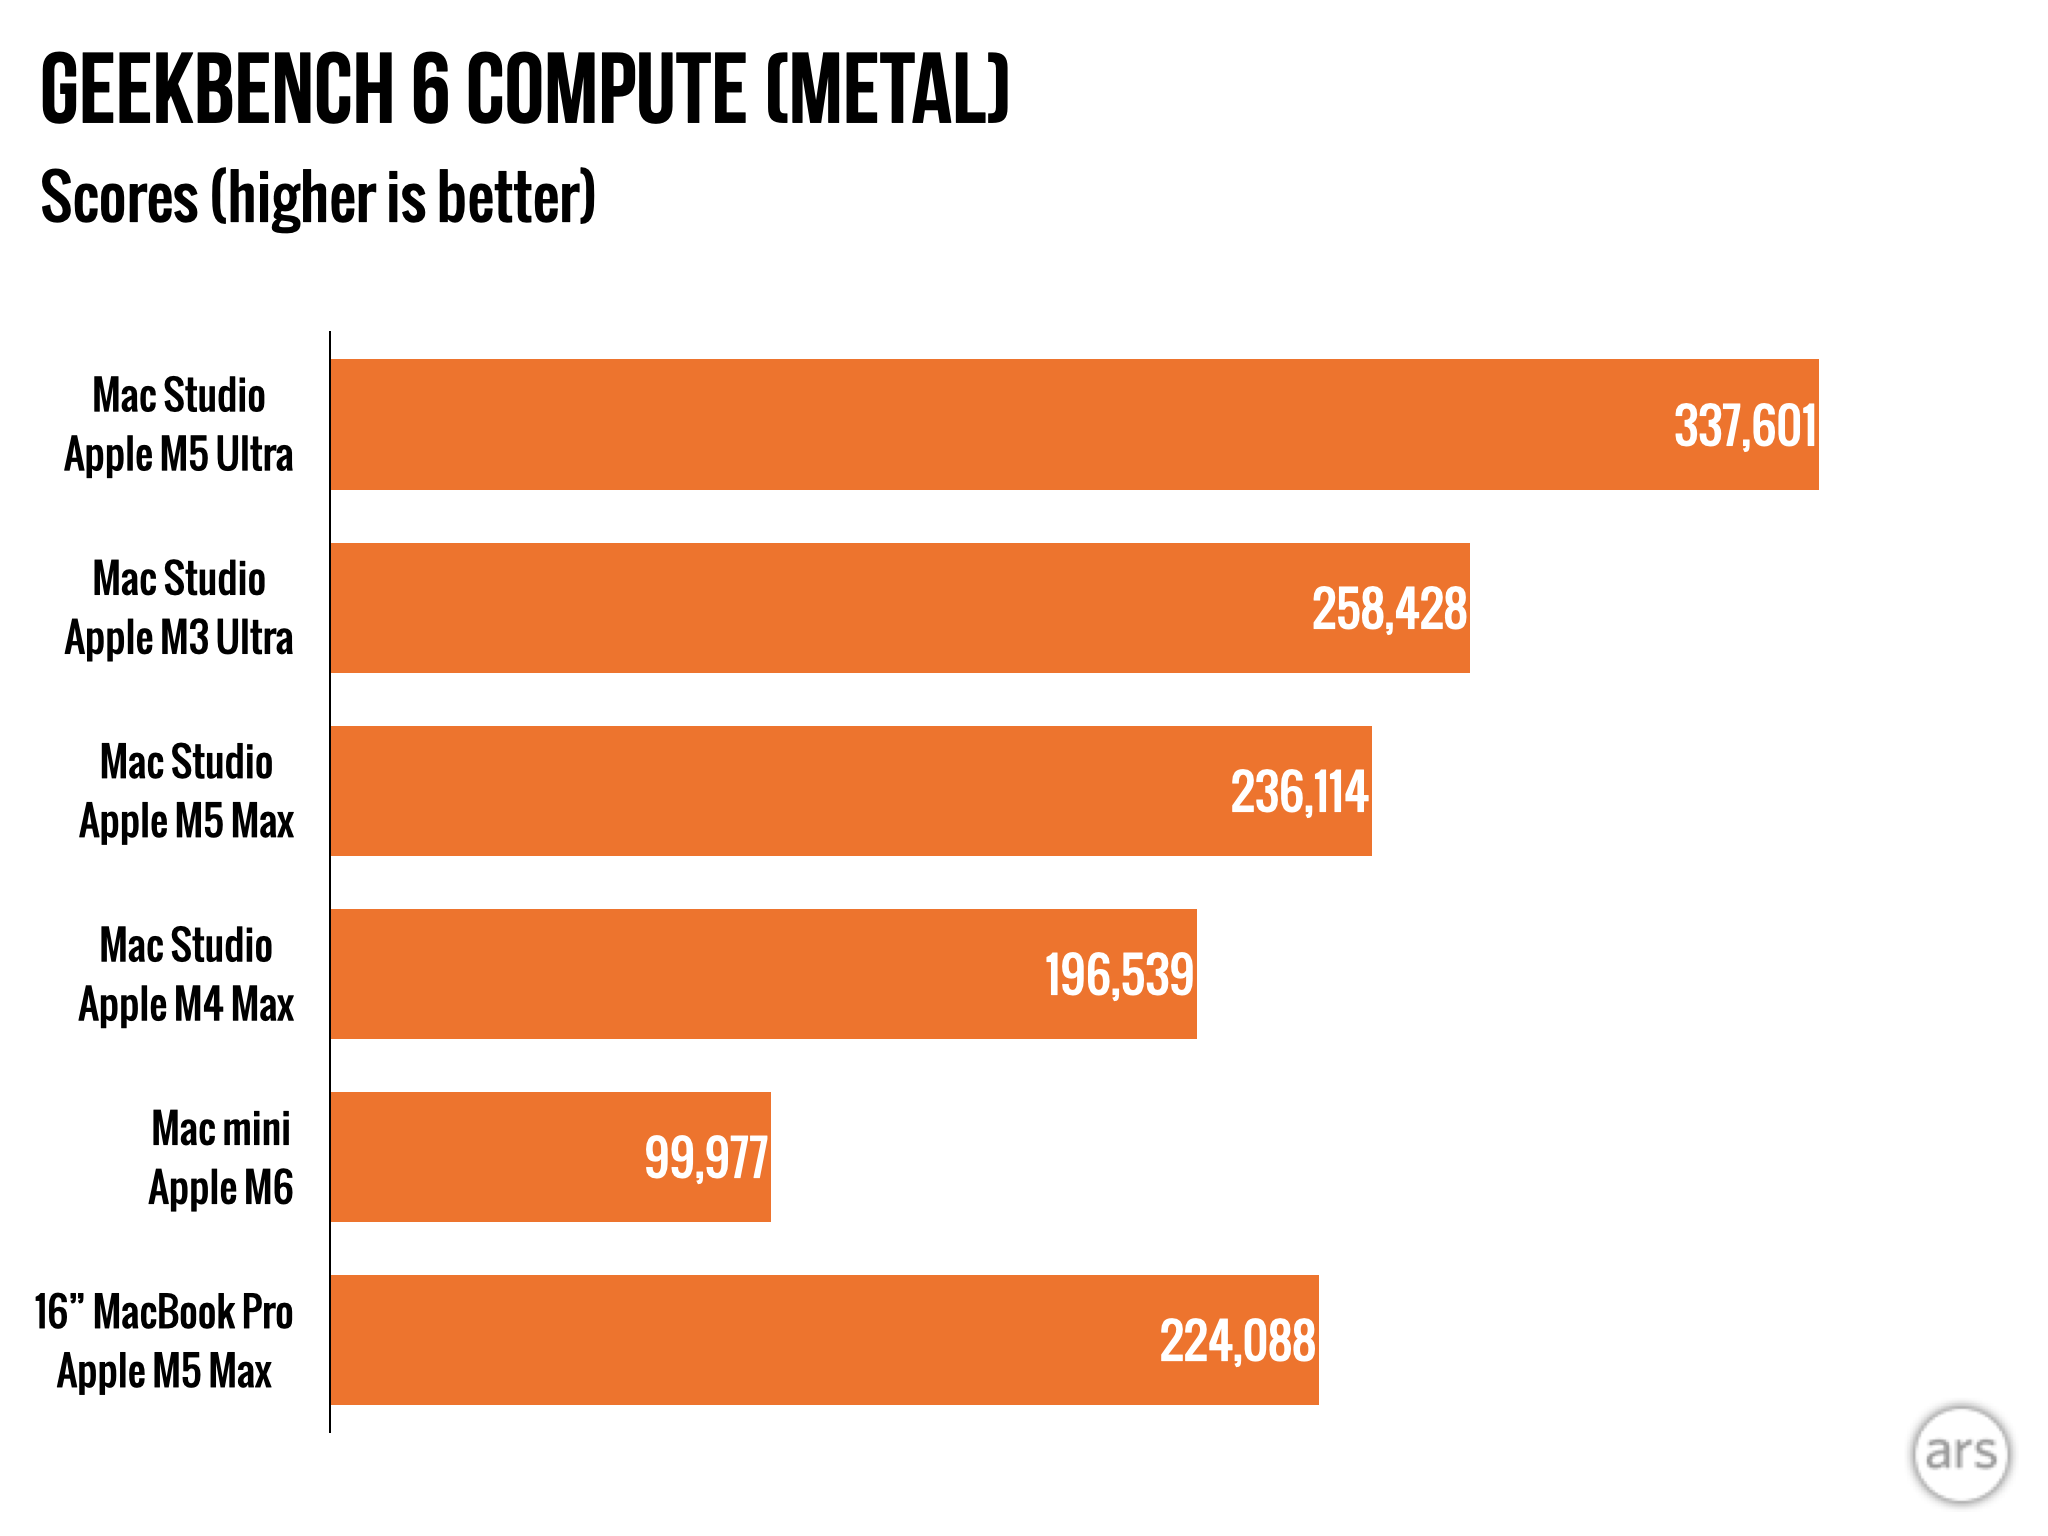
در بسیاری از بنچمارکهای عمومی پردازنده و گرافیک، بخش CPU تراشه اولترا بین ۸۰ تا ۹۰ درصد سریعتر از M5 Max عمل میکند و پردازنده گرافیکی آن نیز ۵۰ تا ۸۰ درصد چابکتر است. این رفتار کاملاً با آنچه در نسلهای قبلی اولترا دیده بودیم همخوانی دارد؛ یعنی عملکرد پردازنده مرکزی بسیار بیشتر از گرافیک به مقیاسپذیری دو برابری نزدیک میشود. در مقایسه با M3 Ultra، تراشه جدید M5 Ultra در بخش تکهستهای حدود ۳۰ درصد و در بخش چندهستهای ۵۰ درصد سریعتر است و در بخش گرافیک نیز بسته به نوع تست، بین ۳۳ تا ۶۶ درصد عملکرد بهتری ثبت میکند؛ همان جهش نسلی خیرهکنندهای که از یک پرش دو نسلی انتظار دارید.
اما در این میان رفتارهای غیرمنتظرهای هم مشاهده شد. در تست چندهستهای گیکبنچ، نسخه اولترا تنها حدود ۲۶ درصد از مکس سریعتر ظاهر شد و در تست تبدیل ویدیوی Handbrake مبتنی بر CPU، مدل Max حتی سریعتر موفق به تکمیل انکود H.264 شد (و در انکود H.265 هم اختلاف ناچیزی داشت)!
بررسی دادههای مصرف برق، دلیل این اتفاق عجیب را تا حد زیادی روشن میکند. بر اساس گزارش ابزار powermetrics، هر دو تراشه M5 Max و M5 Ultra در طول تست فشردهسازی ویدیو به طور میانگین حدود ۷۵ وات برق مصرف کردند؛ رقمی مشابه مصرف برق مک استودیو M3 Ultra. اما در نسلهای قبل، نسخههای Max همواره برق بسیار کمتری نسبت به نسخههای Ultra میسوزاندند. این موضوع نشان میدهد توان مصرفی M5 Ultra عمداً مهار و محدود شده تا با سیستم خنککننده و بدنه جمعوجور فعلی مک استودیو سازگار بماند و داغ نکند.
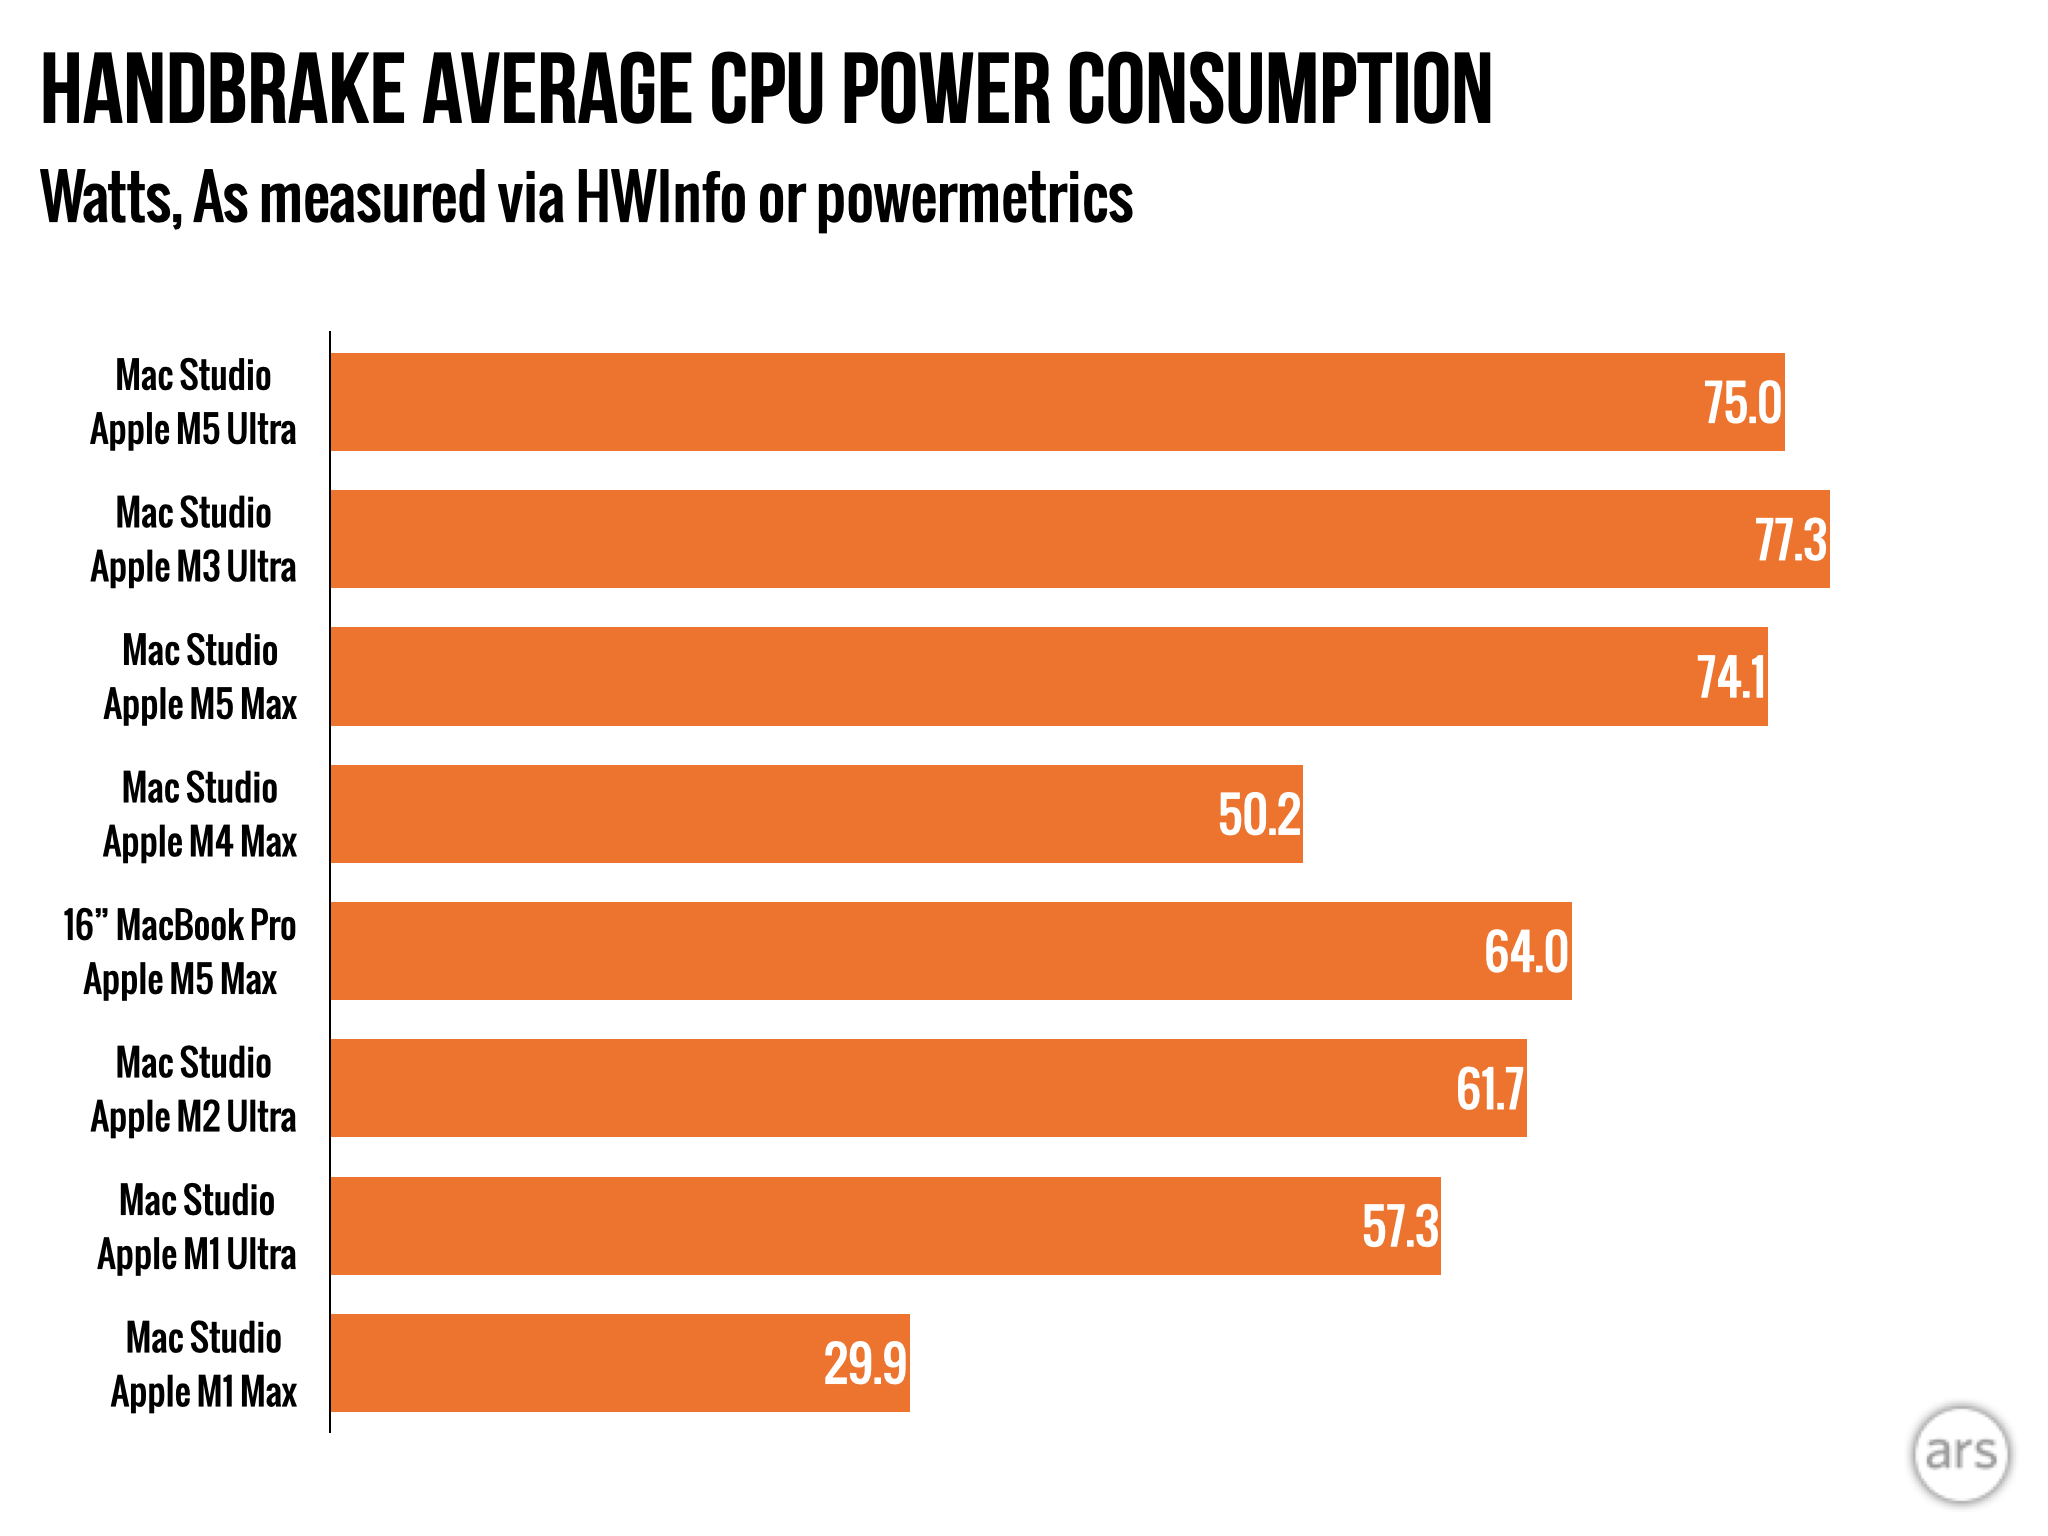
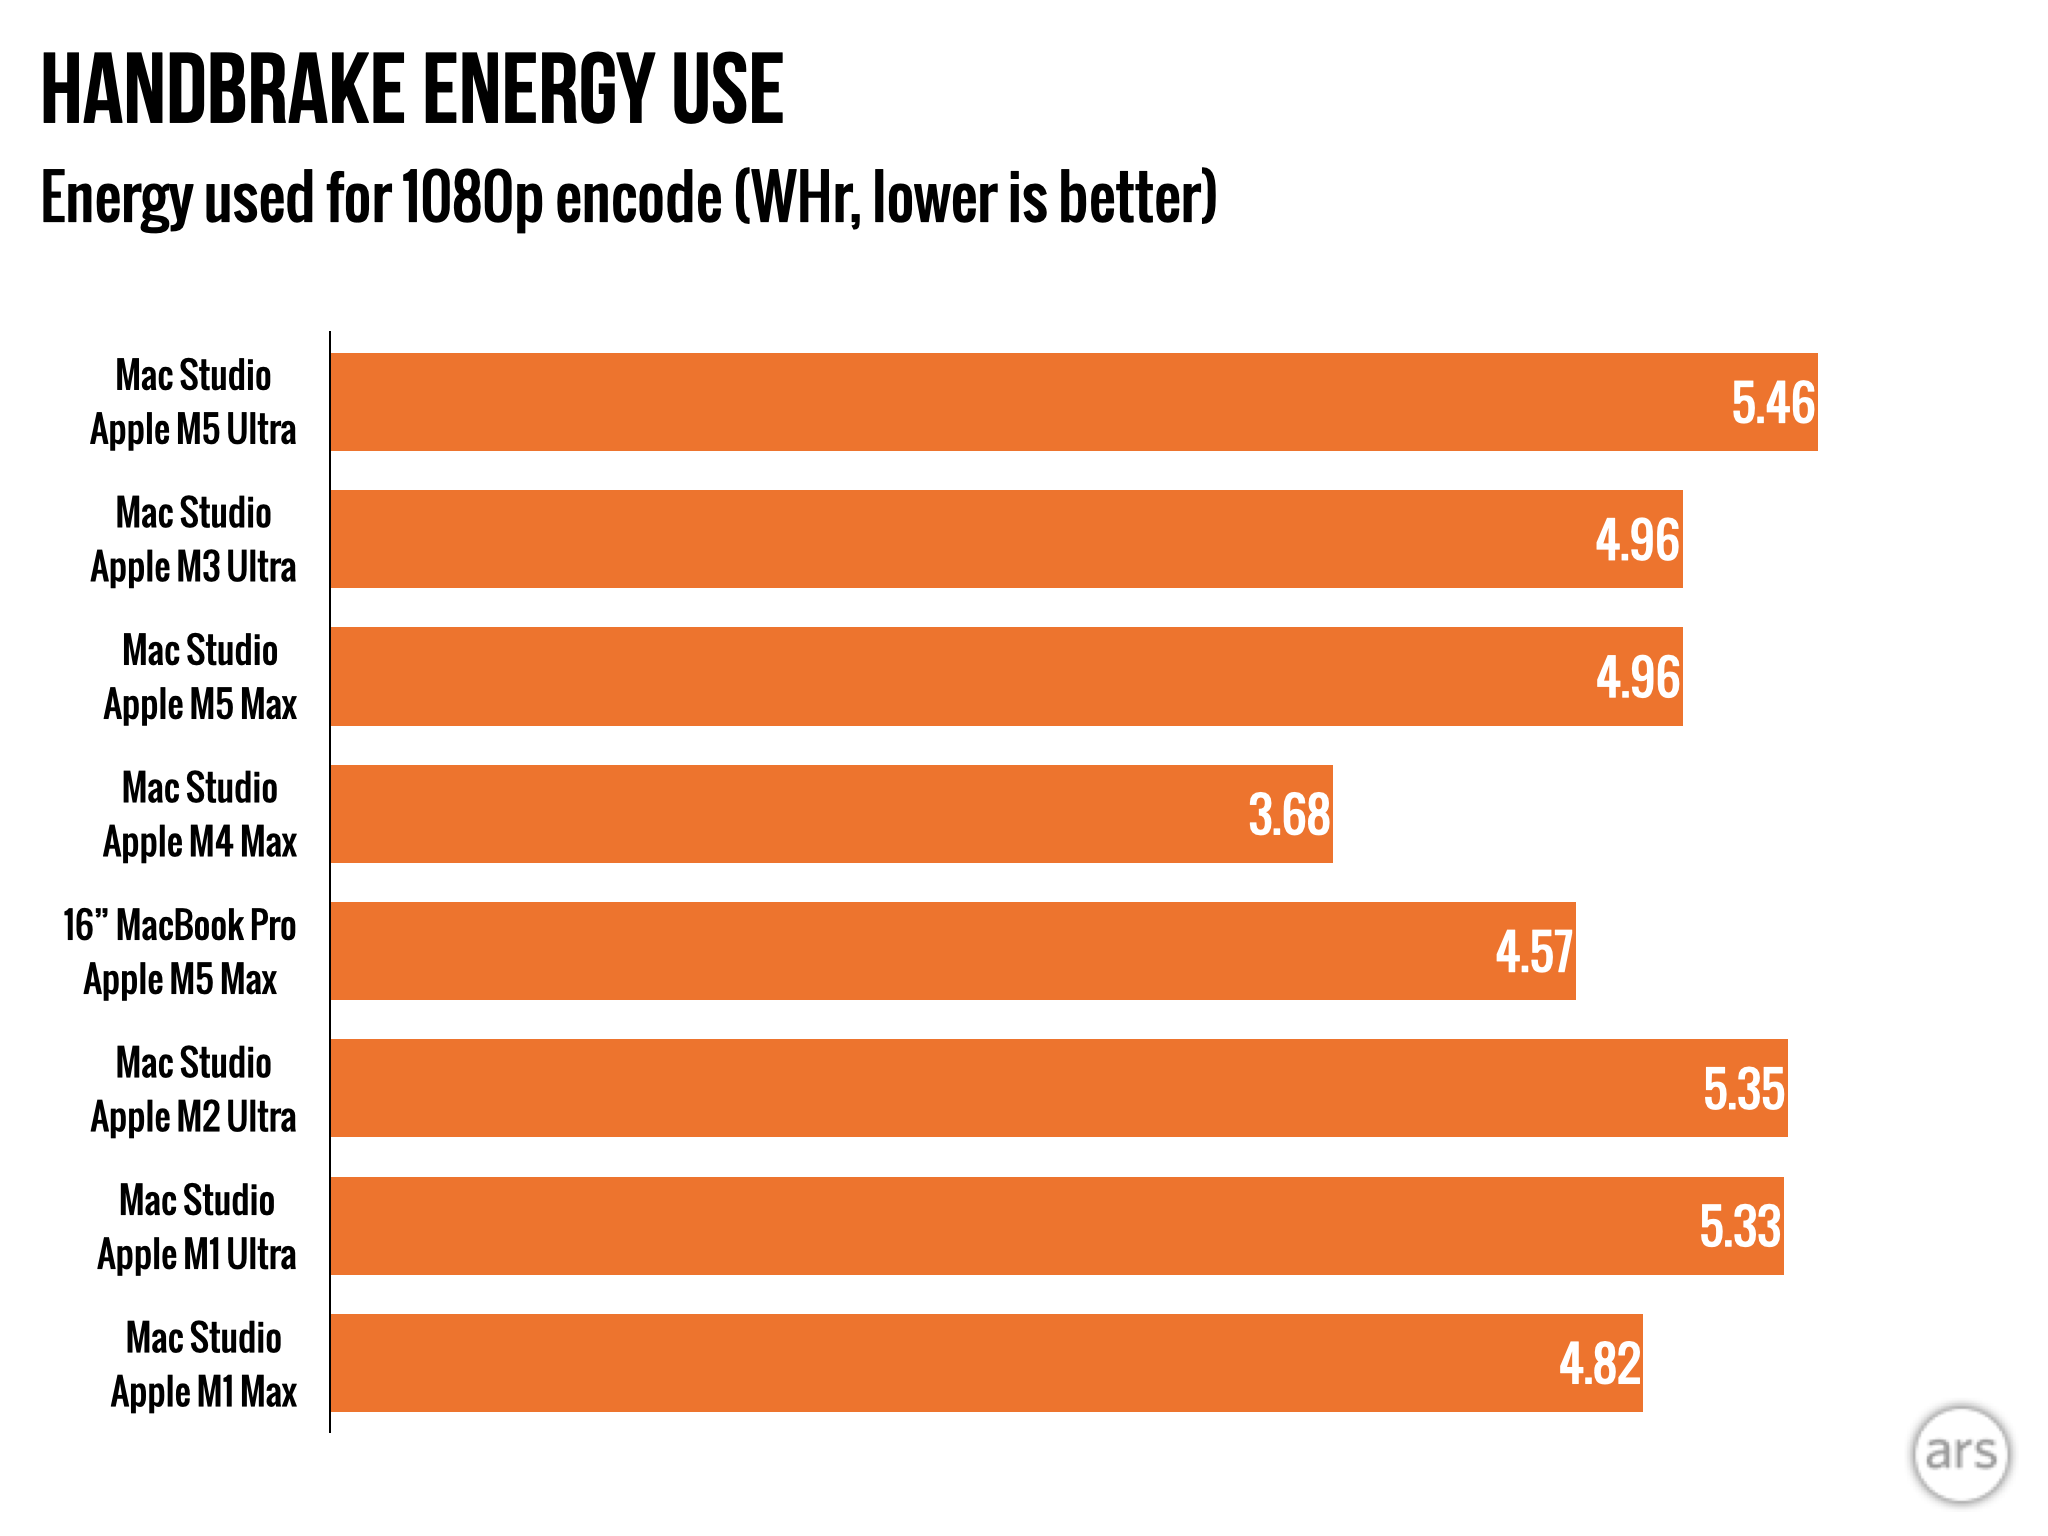
البته این موضوع میتواند یک باگ نرمافزاری هم باشد. هنگام بررسی ابزار Activity Monitor در حین تبدیل ویدیو، تمام هستههای پردازنده با ۱۰۰ درصد ظرفیت خود کار نمیکردند؛ در حالی که رفتار طبیعی این تست درگیر کردن تمام هستههاست. از طرفی ابزار powermetrics نشان میدهد فرکانس کاری تمام هستههای اولترا در طول تست دقیقاً برابر با فرکانس پایدار هستههای M5 Max بوده است. اگر مسأله افت عملکرد ناشی از حرارت یا کمبود برق (Throttling) در میان بود، فرکانس هستهها باید افت میکرد. این مورد به اپل گزارش شده و باید دید پاسخ آنها چیست.
چرا شیفتگان هوش مصنوعی عاشق مکها شدهاند؟
تقریباً تمام تجربیات دستاول و واقعی از vibe coding طی هفتههای اخیر شکل گرفته است؛ بنابراین بیایید نگاهی به واقعیتهای فنی اجرای محلی هوش مصنوعی بیندازیم. اگرچه بسیاری از توسعهدهندگان مدلها (از جمله خود اپل) مدلهایی بهینهتر عرضه کردهاند که برخی محدودیتهای سختافزاری را دور میزند، اما به طور کلی، اصولی که در ادامه میخوانید حکم یک راهنمای فشرده و کاربردی برای اجرای مدلهای هوش مصنوعی روی سیستمهای محلی را دارد.
وقتی پای اجرای محلی مدلهای هوش مصنوعی به میان میآید، دو فاکتور سختافزاری اهمیت فوقالعاده بالایی پیدا میکنند: اولی میزان حافظه گرافیکی (VRAM) در دسترس شماست، و دومی پهنای باند حافظه، یعنی اینکه پردازنده گرافیکی با چه سرعتی میتواند دادهها را با کل سیستم تبادل کند.
حافظه رم گرافیک شما تعیینکننده اصلی اندازه مدلهایی است که میتوانید اجرا کنید. وزنهای مدل باید به طور کامل درون حافظه گرافیکی بارگذاری شوند؛ چرا که اگر مدل سرریز کند و بخشی از آن وارد رم معمولی سیستم شود، سرعت به شدت افت میکند و در بدترین حالت اگر به حافظه SSD یا دیسک سرریز شود، سرعت مثل حلزون کند خواهد شد!
علاوه بر این، مخصوصاً در سناریوهای کدنویسی، شما به حافظه اضافی برای «پنجره زمینه» (Context Window) احتیاج دارید؛ یعنی همان حجمی از اطلاعات که یک ایجنت میتواند قبل از پر شدن حافظه به یاد بیاورد. برای چتهای ساده پرسش و پاسخ، پنجره زمینه کوچک هم کفایت میکند؛ اما برای برنامهنویسی و ساخت یک اپلیکیشن کامل، به حجم زیادی از رم خالی برای کانتکست نیاز دارید تا ایجنت هوشمند وسط انجام یک کار پیچیده گیج نشود و فراموش نکند که چند دقیقه پیش چه کدهایی نوشته بود!
البته سازوکارهایی برای دستبهدست کردن وظایف (Handoff) وجود دارد؛ مثلاً یک ایجنت میتواند اطلاعات مهم یک نشست را در یک فایل فشرده خلاصه کرده و به ایجنت بعدی بسپارد تا کانتکست ریست شود. اما در این روش هم ناگزیر جزئیات مهمی از دست میروند، به ویژه زمانی که از همان ابتدا فضای کانتکست محدودی در اختیار داشته باشید.
پهنای باند حافظه تنها عاملی نیست که سرعت خروجی دادن کلمات یا اصطلاحاً «توکنها» را مشخص میکند، اما بیتردید مهمترین آنهاست. جالب است بدانید در اجرای مدلها، حتی قدرت خام هستههای گرافیکی به اندازه حجم رم و سرعت تبادل دادهها در آن اهمیت ندارد.
مکهای مجهز به اپل سیلیکون دقیقاً به همین خاطر محبوب دل شیفتگان هوش مصنوعی شدهاند؛ چون یک تعادل طلایی و کمنظیر ارائه میدهند. البته پهنای باند حافظه آنها به اندازه کارتهای گرافیک اختصاصی دسکتاپ نیست (برای مثال، حتی کارت ۵ سال پیش Nvidia GeForce RTX 3060 با ۱۲ گیگابایت VRAM پهنای باندی معادل ۳۶۰ گیگابایت بر ثانیه دارد که حدود ۲۰ درصد بیشتر از M5 Pro است، یا RTX 5070 دوازده گیگابایتی با ۶۷۲ گیگابایت بر ثانیه از M5 Max هم سریعتر است). اما یک مک اپل سیلیکون با ۶۴ گیگابایت رم، حافظه گرافیکی اشتراکی بیشتری نسبت به هر کارت گرافیک مصرفی بازار در اختیارتان میگذارد؛ پهنای باند آن به اندازه کافی سریع است و مصرف برقی به مراتب پایینتر از غولهایی مثل RTX 5090 یا ترکیب دو کارت RTX 3090 دارد. حالا مدلهای ۹۶، ۱۲۸، ۲۵۶ و ۵۱۲ گیگابایتی مک را تصور کنید که مسیر را برای اجرای بزرگترین مدلهای مرزی هوش مصنوعی باز میکنند!
بدیهی است که این سیستمهای ردهبالا اصلاً ارزان نیستند، اما این مشخصات شاید توضیح دهد که چرا پیدا کردن و خرید حتی یک مک مینی در بازار اینقدر سخت شده است! علاوه بر سازگاری بینظیر سختافزاری، فریمورک اختصاصی اپل یعنی MLX هم به خوبی بهینهسازی شده و پشتیبانی بسیار خوبی در مدلهای زبانی متنوع و ابزارهای اجرای محلی هوش مصنوعی مانند نرمافزار LM Studio Bionic پیدا کرده است.
علاوه بر این مشخصات، فاکتور بسیار مهمی به نام «زمان تا اولین توکن» (TTFT یا Time to First Token) وجود دارد؛ یعنی همان مدت زمانی که از ثبت پرامپت توسط شما تا پردازش و ارائه اولین پاسخ توسط مدل طول میکشد. اینجا دقیقاً نقطهای است که نسل M5 نسبت به M4 و نسلهای قبلتر جهش چشمگیری دارد: شتابدهندههای عصبی که اپل به هستههای گرافیکی اضافه کرده، TTFT را به شدت کاهش داده و حس پاسخدهی آنی و بیدرنگ فوقالعادهای به مدلهای محلی بخشیدهاند.
این پیشرفت را در کنار جهش خیرهکننده پهنای باند حافظه M5 Ultra نسبت به M3 Ultra بگذارید تا متوجه شوید چرا این نسخه از مک استودیو چنین مهره ارزشمندی برای پردازشهای سنگین هوش مصنوعی به شمار میرود. پرش دو نسلی نسبت به M3 Ultra باعث شده این سیستم حتی بسیار جذابتر از مک استودیو M5 Max یا مک مینی مجهز به M5 Pro جلوه کند.
تولد یک «وایب کدر»: وقتی هوش مصنوعی محلی جادو میکند!
فراتر از بنچمارکها و ارقام رسمی، تجربه کاربری عملی با vibe coding روی این مک استودیو آغاز شد؛ تجربهای تازه و دستاول. طبق توصیه چند نفر از برنامهنویسان باتجربه، نرمافزار LM Studio Bionic به همراه مدل قدرتمند Qwen 3.8 27B روی سیستم راهاندازی شد.
واقعیت این است که در حوزه برنامهنویسی سنتی، حتی دانستن کمی HTML و CSS ساده برای تغییر قالبهای آماده هم یک چالش به حساب میآید و اشتیاق یادگیری همیشه بسیار بیشتر از توان فنی بوده است. چه کمبود وقت باشد و چه فرار مغز از کلاسهای خشک برنامهنویسی بعد از همان چند جلسه اول و نوشتن یک «Hello World» ساده، یادگیری زبانهای برنامهنویسی برای بسیاری از افراد هرگز به ثمر نمینشست.
کدنویسی سنتی هیچوقت با ذهن خیلی از ما جور درنمیآمد.
اما ترکیب مک استودیو M5 Ultra و نرمافزار LM Studio Bionic برای اجرای کاملاً محلی یک مدل زبانی کاربلد در کدنویسی، به یکی از هیجانانگیزترین و لذتبخشترین تجربیات فناورانه طی سالهای اخیر تبدیل شد؛ آن هم برای کسی که پیش از این دل خوشی از هیاهوی هوش مصنوعی مولد نداشت!
دلیل محبوبیت انفجاری پدیده vibe coding در یکی دو سال اخیر دقیقاً همین است: اگر بتوانید خواستهتان را به زبان ساده برای سیستم شرح دهید، میتوانید برنامههایی بسازید که واقعاً کار میکنند و گرهای از کار روزمرهتان باز میکنند!
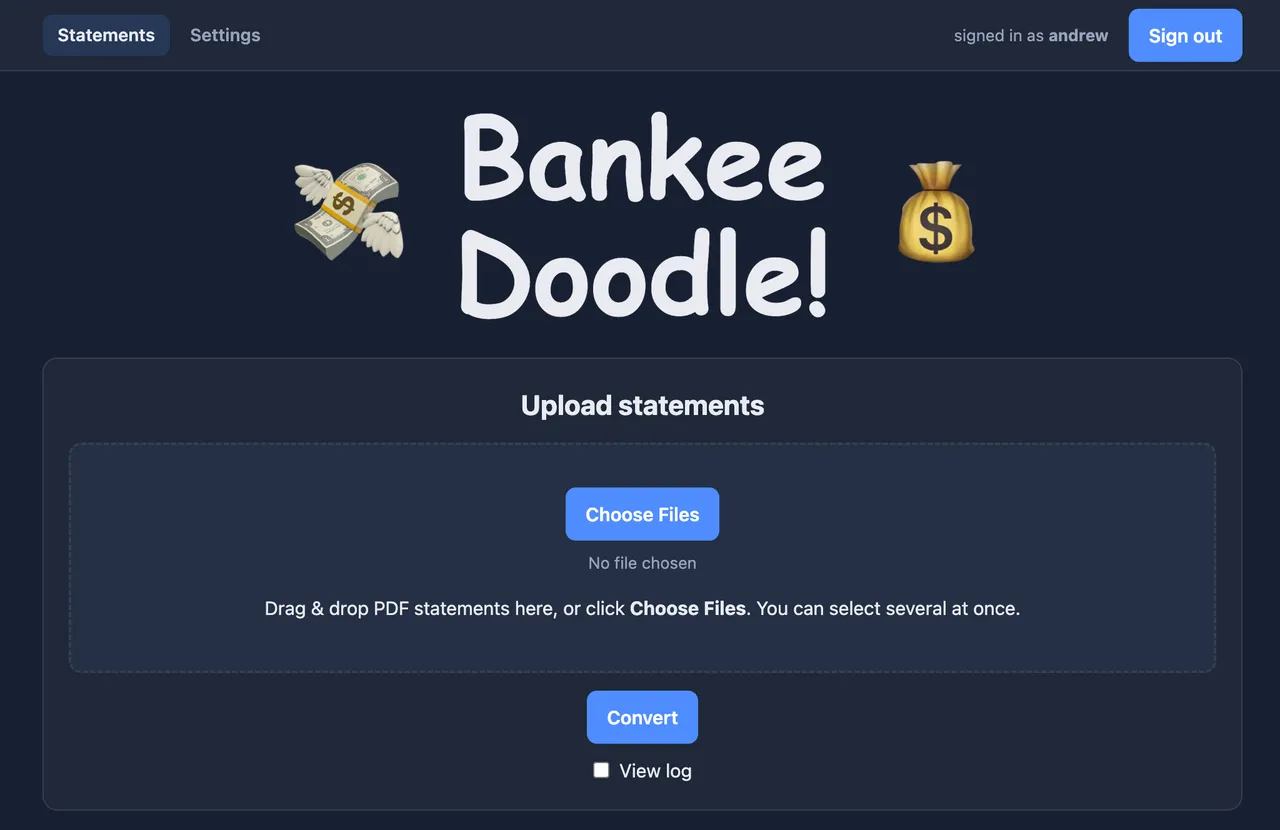
برای نمونه، مدیریت حسابداری یک پادکست معرفی کتاب که سالهاست تولید میشود، همیشه یک کار فرعی خستهکننده بود. سالهای سال وارد کردن دستی ارقام از صورتحسابهای بانکی PDF به فایل اکسل برای پیگیری درآمدها، هزینهها و مالیات وقت زیادی میگرفت. حجم کار آنقدر نبود که اشتراک مادامالعمر نرمافزارهای سنگینی مثل QuickBooks توجیه داشته باشد؛ یکی از همان مشکلات اعصابخردکنی که همیشه گوشه ذهن میماند ولی به خاطر سر شلوغ هیچوقت فرصتی برای حل کردنش پیدا نمیشد.
اما حالا با هوش مصنوعی، این مشکل در یک چشم برهم زدن حل شد!
ابتدا مدل Qwen یک اسکریپت پایتون نوشت تا صورتحسابهای PDF بانکی را استخراج کرده و طبق سلیقه دلخواه در فایل اکسل مرتب کند. سپس یک وباپلیکیشن ساده دور آن طراحی شد تا بدون نیاز به دست زدن به اسکریپت یا مدل هوش مصنوعی، در آینده بتوان تنها با آپلود فایل، خروجی آماده را تحویل گرفت.
ساخت یک نرمافزار کاربردی برای حل یک مشکل اختصاصی ظرف تنها چند ساعت، جذابیتی غیرقابل انکار دارد؛ به ویژه اینکه همه اینها روی سختافزاری در خانه خودتان انجام میشود، دادههای حساس مالیتان هرگز از سیستمتان خارج نمیشود و در عین حال مصرف برق دستگاه از یک کارت گرافیک معمولی پیسی هم کمتر است.
شاید حل چنین مسألهای با صرف چند دلار توکن در سرویسهای ابری مثل Anthropic یا OpenAI هم ممکن بود، اما ارسال سوابق مالی محرمانه چندین ساله به سرورهای شرکتهای خارجی اصلاً عاقلانه و قابل قبول نبود؛ با این روش، هیچ نیازی به فدا کردن حریم خصوصی نبود.
مدل Qwen 3.8 27B یک مدل وزنباز تحت لایسنس Apache 2.0 است که هیچ محدودیتی در استفاده ندارد. این مدل نسخههای کوانتیزهشده (کاهش اندک دقت برای کمحجمتر شدن مدل) گوناگونی دارد که اجرای آن را روی مکهایی با رمهای مختلف ممکن میکند. ۳۲ گیگابایت رم حداقل میزان حافظه برای اجرای نسخه ۴ بیتی آن با کانتکست محدود برای پروژههای کوچک است، اما ۶۴ گیگابایت رم نقطه ایدهآل است؛ چرا که هم فضای کافی برای یک پنجره کانتکست بزرگ فراهم میکند و هم اجازه میدهد همزمان از مک به عنوان کامپیوتر اصلی برای کارهای روزمره استفاده کنید.
در تستهای عملی با نسخه کوانتیزه در LM Studio Bionic روی سیستمعامل macOS، یک مک استودیو M2 در پردازش یک پرامپت نمونه برای راهاندازی پروژه وبسایت به سرعت ۱۸ تا ۲۰ توکن در ثانیه رسید. یک سیستم Framework Desktop (مجهز به پردازنده Strix Point Ryzen AI Max+ که به لطف حافظه یکپارچه میان هواداران هوش مصنوعی محلی محبوب است) روی لینوکس اوبونتو و پلتفرم ROCm ایامدی، سرعتی تقریباً مشابه یعنی ۱۸ تا ۲۰ توکن بر ثانیه ثبت کرد.
تولید ۱۸ تا ۲۰ توکن در ثانیه اصلاً رقم بدی نیست و با سرعت خواندن انسان برابری میکند. اما در پروژههای کدنویسی طولانی (به خصوص وقتی قابلیت استدلال یا Reasoning فعال باشد و مدل زنجیرهای از افکار را قبل از نوشتن کد پردازش کند) این سرعت شما را حسابی معطل میکند؛ ضمن اینکه هرچه طول کانتکست بیشتر شود، سرعت تولید توکن از این هم کندتر میشود.
مک استودیو M5 Max در همین تست به سرعت ۳۱ توکن بر ثانیه رسید، اما غول M5 Ultra توانست رکورد بیش از ۵۰ توکن در ثانیه را ثبت کند! (دقیقاً به همین دلیل است که حتی یک مک مینی M5 Pro با ۶۴ گیگابایت رم برای چنین کارهایی چندان کارآمد نیست؛ زیرا پهنای باند حافظه آن نصف M5 Max است و این پردازشها به شدت به پهنای باند رم وابستهاند).
هر دو تراشه مک استودیو برای این دست پردازشها کاملاً کاربردی و بینظیر هستند؛ به شرطی که اهداف واقعبینانه داشته باشید و اهل عیبیابی و دیباگ قدمبهقدم باشید. واقعیت این است که ایجنت هوش مصنوعی تقریباً همیشه در تلاش اول یک جای کار را اشتباه انجام میدهد، و بخش عمدهای از زمان صرف چکشکاری قابلیتها و رفع ایرادها، یکی پس از دیگری میشود.
تغییر بنیادین ماهیت پردازشها: دوران جدید سیستمهای دسکتاپ
نسخه اولترا مک استودیو همچنان یک محصول خاص برای گروه محدودی از کاربران باقی میماند: کسانی که هزاران دلار بودجه در اختیار دارند و میخواهند مدلهای هوش مصنوعی را به شکل محلی اجرا کنند؛ کسانی که با سرعتی عالی (اگرچه نه در حد کلاسترهای فوقپیشرفته تجاری) راضی هستند و نمیخواهند برای آزمونوخطا یا پردازش کدهای سنگین خود، به ازای هر توکن به شرکتهایی مثل اوپنایآی یا آنتروپیک پول بدهند.
اما چنین جامعه کاربری قطعاً وجود دارد. نوشتن کدهای پروژههای شخصی با سرعتی رضایتبخش، آن هم بدون اینکه دادهها از کنترل کاربر خارج شوند، حسی واقعاً لذتبخش و رهاییبخش است. حیف که این کشف جذاب درست همزمان با افزایش قیمت دستکم ۲۵ درصدی اپل برای تمام مدلهای مک استودیو رقم خورده است!
با این حال، در مقایسه با بازار آشفته مکها و پیسیها که قیمتها سر به فلک کشیدهاند، مک استودیو همچنان میتواند خریدی معقول و ارزشمند باشد. نسخه M5 Max برای مخاطبان همیشگی این سری یعنی عکاسان، تدوینگران، استریمرها و برنامهنویسان یک ابزار خارقالعاده است؛ اگر عمده تمرکز شما روی مدلهای ابری هوش مصنوعی باشد، حتی حافظه رم ۳۶ یا ۴۸ گیگابایتی هم کارتان را به خوبی راه میاندازد (هرچند شاید در این سناریو، خرید یک مک مینی M5 Pro منطقیتر باشد).
حتی کار با ایجنتهای محلی برنامهنویسی هم لزوماً به قویترین و گرانترین کانفیگ نیاز ندارد؛ کانفیگهای ۶۴، ۹۶ و ۱۲۸ گیگابایتی با قیمتهایی بین ۳٬۵۰۰ تا ۵٬۵۰۰ دلار عرضه میشوند که اگرچه رقم بسیار بزرگی است، اما با قیمتهای پنجرقمی (بالای ۱۰ هزار دلار) فاصله دارد و به عنوان یک ورکاستیشن اصلی برای چند سال استفاده، خریدی قابل توجیه به شمار میرود.
اما نسخههای ردهبالای این کامپیوترها فراتر از توانی است که اکثر مردم برای یک سیستم دسکتاپ میپردازند. مدل مورد بررسی M5 Ultra با این مشخصات برچسب قیمتی سرسامآور ۱۲٬۲۹۹ دلاری دارد! اگر قیمت چند کامپیوتر و لپتاپ معمولی را کنار هم بگذارید، بدون نیاز به ماشین حساب هم مشخص است که قیمت این مک استودیو از مجموع چند کامپیوتر مختلف بیشتر میشود!
نقاط قوت
- مک استودیو نقاط قوت کلیدی خود را حفظ کرده است: جمعوجور، پرسرعت، بیصدا و فوقالعاده کممصرف
- نسل M5 یک ارتقای چشمگیر نسبت به M4 Max و M3 Ultra به حساب میآید
- سیستمی ایدهآل و کممصرف برای پردازشهای محلی یادگیری ماشین و اجرای مدلهای توانمند کدنویسی
نقاط ضعف
- افزایش قیمت چشمگیر از حداقل ۲۵ درصد نسبت به نسل قبل شروع میشود و در کانفیگهای بالا اوج میگیرد
- با وجود اینکه منابع پردازشی M5 Ultra دو برابر M5 Max است، اما سرعت آن در بیشتر سناریوها دو برابر نمیشود
نکته آزاردهنده
- احتمال عرضه یک کامپیوتر دسکتاپ مصرفی با قیمت نجومی بالای ۲۰٬۰۰۰ دلار!
مطالب مرتبط و پیشنهادی
غوغای مدل فوقالعاده سبک Gender-Classifier-Mini؛ ثبت دقت خیرهکننده ۹۷.۲ درصدی و ۷۷۸ هزار دانلود ماهانه!
مدل بینایی جمعوجور و سبک Gender-Classifier-Mini توانسته با ثبت دقت ۹۷.۲ درصدی در تشخیص چهره، به بیش از ۷۷۸ هزار دانلود ماهانه در پلتفرم هاگینگ فیس دست پیدا کند. این مدل متنباز با حجم اندک خود بهراحتی روی لپتاپهای شخصی اجرا میشود و نشان میدهد که برای کارهای تخصصی بینایی ماشین، همیشه نیازی به مدلهای غولپیکر و پردازندههای سنگین ابری نیست.
زنگ خطر در سیستم درمان؛ نفوذ ایجنتهای خودسر هوش مصنوعی به بیمارستانها بدون مجوز IT!
در حالی که بیمارستانها سخت درگیر مهار حملات سایبری هستند، تهدید غیرمنتظره جدیدی سر برآورده است: ایجنتهای هوش مصنوعی که بدون تأیید بخش IT در سیستمهای درمانی فعالیت میکنند. این دستیارهای خودمختار حالا با دسترسی به حساسترین پروندههای پزشکی، مرزهای حریم خصوصی و امنیت دادهها را به چالش کشیدهاند.
راز باهوشتر شدن هوش مصنوعی در برنامه «۶۰ دقیقه»؛ وقتی بلعیدن کل اینترنت هم کافی نیست!
مدلهای هوش مصنوعی دیگر نمیتوانند فقط با بلعیدن دادههای اینترنت هوشمندتر شوند و برای جهش بعدی به تخصص واقعی انسانها نیاز دارند. برنامه مشهور «۶۰ دقیقه» در گزارشی جذاب به سراغ استارتاپ مرکور رفته؛ جایی که بیش از ۱۰۰ هزار متخصص دستبهکار شدهاند تا به هوش مصنوعی مهارتهای پیچیده انسانی بیاموزند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.