پیروزی خیرهکننده هوش مصنوعی در استراتگو؛ مدل Ataraxos بلوف زدن و فریب را هم یاد گرفت!
پژوهشگران با توسعه مدل هوش مصنوعی آتاراکسوس (Ataraxos) موفق شدند بهترین بازیکنان بازی رومیزی استراتگو را شکست دهند و بر چالش بزرگ اطلاعات پنهان غلبه کنند. این سیستم با یادگیری تقویتی و استفاده از الگوریتم دیپنش، توانایی بینظیری در ارزیابی ریسک، بلوف زدن و حفظ خونسردی از خود نشان میدهد. نتایج این دستاورد علمی گامی مهم در ارتقای قدرت تصمیمگیری استراتژیک هوش مصنوعی در شرایط نامشخص به شمار میرود.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- مدل هوش مصنوعی جدید آتاراکسوس (Ataraxos) که حاصل همکاری دانشگاههای MIT، استنفورد، NYU و کارنگی ملون است، موفق شده ماهرترین بازیکنان انسانی را در بازی استراتژیک استراتگو شکست دهد.
- برخلاف شطرنج و گو که تمام مهرهها روی صفحه آشکار هستند، استراتگو بر پایه اطلاعات پنهان و بلوف زدن شکل گرفته؛ اما این مدل با الگوریتم دیپنش یاد گرفته مثل یک بازیکن حرفهای خونسرد بماند و ریسکها را هوشمندانهتر از انسان بسنجد.
- این پیروزی بزرگ نشان میدهد یادگیری تقویتی مبتنی بر بازی با خود (Self-play) میتواند به حل پیچیدهترین مسائل تصمیمگیری در شرایط ابهام و دنیای واقعی کمک کند.
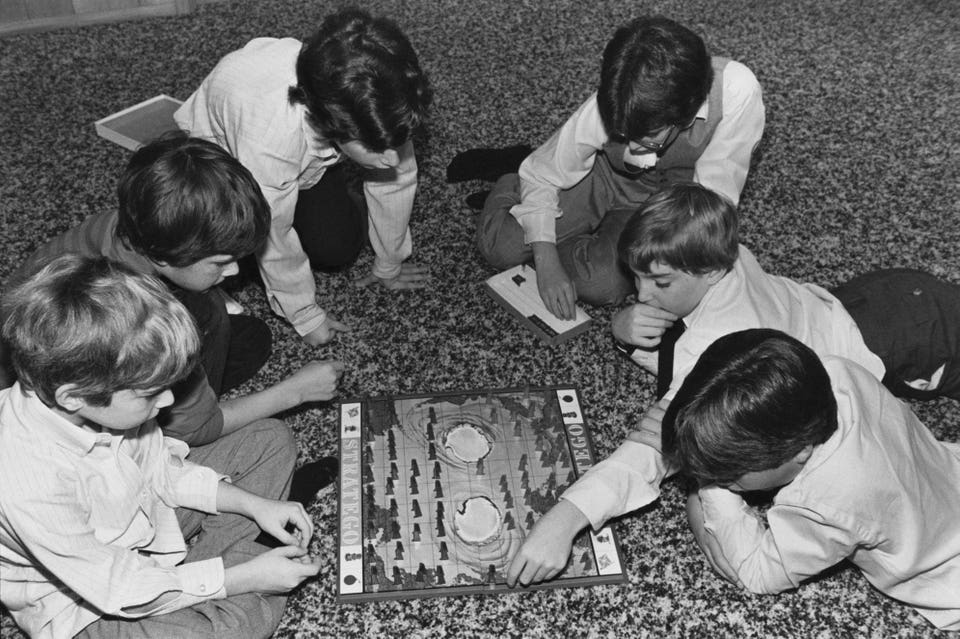
شطرنج با «دیپ بلو» (Deep Blue) فتح شد، بازی بسیار پیچیده «گو» با «آلفاگو» (AlphaGo) به تسخیر هوش مصنوعی درآمد و حالا نوبت به بازی نوستالژیک و پرطرفدار «استراتگو» (Stratego) رسیده است؛ جایی که مهندسان و دانشمندان هوش مصنوعی سیستمی جدید به نام «آتاراکسوس» (Ataraxos) ساختهاند که میتواند ماهرترین بازیکنان انسانی را به زانو درآورد.
بازی معروف استراتگو را به یاد دارید؟
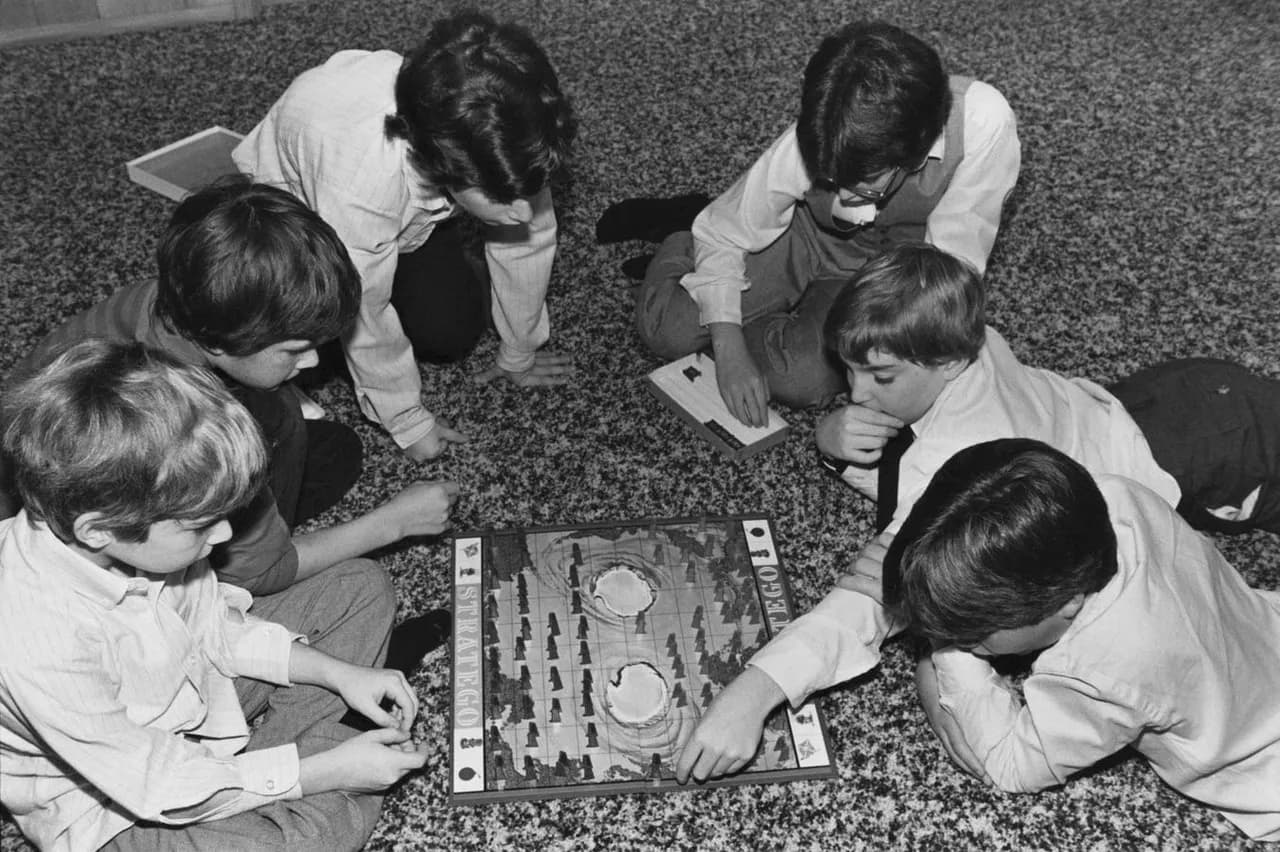
شنیدن نام استراتگو برای خیلیها یادآور مهرههای پلاستیکی کوچک، ژنرالها، بمبها و سربازهای کلاهبهسر در بازیهای دوران نوجوانی و جمعهای دوستانه دهههای گذشته است؛ مهرههای جذابی که بمبهایشان همیشه هیجان خاصی به بازی میدادند.
بسیاری از افراد در کودکی شاید بیشتر با چیدن مهرهها سرگرم میشدند تا اجرای یک استراتژی دقیق و حسابشده؛ اما مدل آتاراکسوس کاملاً جدی وارد میدان شده است. این بازیکن مجازی که حاصل همکاری مشترک پژوهشگران دانشگاههای برجسته MIT، کارنگی ملون (Carnegie Mellon)، دانشگاه نیویورک (NYU) و استنفورد (Stanford) است، فقط برای بردن طراحی شده است. آتاراکسوس در سال ۲۰۲۵ موفق شد قهرمان برتر جهان را شکست دهد و نتایج پژوهشی که به تازگی منتشر شده، دلایل قدرت خارقالعاده آن در استراتگو را تشریح میکند. این مقاله همچنین نشان میدهد چرا استراتگو در مقایسه با بازیهایی مثل شطرنج و گو چالشی کاملاً متفاوت به حساب میآید؛ تفاوت بنیادین در این است که در شطرنج و گو همه چیز روی صفحه شفاف و برای هر دو طرف آشکار است، اما در استراتگو پشت مهرهها به سمت حریف قرار دارد و هویت آنها کاملاً پنهان است.
تیم تحقیقاتی در مقالهای که در ژورنال معتبر نیچر (Nature) منتشر شده، مینویسد: «تصمیمگیری در دنیای واقعی معمولاً شامل اطلاعات پنهان است؛ یعنی اطلاعاتی که برای یک طرف ماجرا پوشیده است اما طرف مقابل آن را در اختیار دارد. متأسفانه حجم بالای اطلاعات پنهان باعث میشود روشهای معمول یادگیری تقویتی و الگوریتمهای جستجو کارایی خود را از دست بدهند. حتی با صرف هزینههای تحقیقاتی چند میلیون دلاری[۱]، رسیدن به سطح برترین بازیکنان انسانی در بازی استراتگو — یک بازی جنگی رومیزی با حجم عظیمی از اطلاعات پنهان — تاکنون برای هوش مصنوعی دستنیافتنی مانده بود.»
مهندسان برای غلبه بر این چالش، از روشی به نام «یادگیری تقویتی از طریق بازی با خود» (Self-play reinforcement learning) استفاده کردند؛ رویکردی که در آن هوش مصنوعی با شبیهسازی و بررسی تعداد بیشماری بازی مقابل خودش، همه تکنیکها از جمله بلوف زدن و طراحی استراتژیهای فریبنده را یاد میگیرد و تحلیل میکند.
این پیشرفت بسیار کلیدی است؛ زیرا اگرچه هوش مصنوعی سالهاست برتری خود را در منطق ریاضی و محاسبات اثبات کرده، اما در تصمیمگیریهای شهودی و روانشناختی — که همیشه قلمرو اختصاصی ذهن انسان به حساب میآمد — عقبتر بود. اما این قهرمان تازه استراتگو فوقالعاده باهوش و بادرایت عمل میکند.
گابریله فارینا (Gabriele Farina)، استادیار دپارتمان مهندسی برق و علوم کامپیوتر، در مصاحبه با پایگاه خبری دانشگاه MIT میگوید: «آتاراکسوس ریسکها را به شکلی محاسبه میکند که انسانها قادر به انجام آن نیستند. اگر باارزشترین مهره یک بازیکن انسانی لو برود، احتمالاً دستپاچه و نگران میشود؛ اما این هوش مصنوعی به شکلی شگفتآور خونسردیاش را حفظ میکند، واکنش عجولانه نشان نمیدهد و رازش را فاش نمیکند.»
این موضوع دلیل نامگذاری جالب آن را هم روشن میکند. نام آتاراکسوس از مفهوم یونان باستان یعنی «آتاراکسیا» (Ataraxia به معنای آرامش درونی، خونسردی تزلزلناپذیر و رهایی از اضطراب) گرفته شده است. بنابراین این هوش مصنوعی رسماً یک پوکر فیس تمامعیار دارد!
الگوریتم دیپنش (DeepNash) و نظریه بازیها
مشخص شده که بخش زیادی از ساختار آتاراکسوس به ایدههای جان نش (John Nash)، ریاضیدان نابغه و برنده جایزه نوبل، وابسته است. این سیستم بر پایه الگوریتمی به نام «دیپنش» (DeepNash) کار میکند که از پویایی تعادل نش برای رقابت با انسانها بهره میبرد.
از نظر فنی، آتاراکسوس جانشین و نسل بعدی دیپنش محسوب میشود و مدل متفاوتی است؛ اما در هر دو حالت، ماشین با بازی در برابر خودش آموزش میبیند و اتفاقاً این کار را به بهترین نحو یاد میگیرد.
نویسندگان این مقاله علمی تأکید میکنند: «موفقیت این رویکرد در بازیهای رقابتی، مشارکتی و تیمی، یک الگوی طراحی نوین برای یادگیری تقویتی و روشهای جستجو ایجاد کرده که در شرایط پر از اطلاعات پنهان فوقالعاده مؤثر است؛ موضوعی که از دیرباز یکی از بزرگترین آرزوها و اهداف پژوهشگران در حوزه تصمیمگیری استراتژیک بوده است.»
قدرتنمایی هوش مصنوعی در بازیهای پیچیده
جالب اینجاست که دانشمندان هوش مصنوعی را برای بازیهای پیچیده دیگری هم طراحی کردهاند. یکی از آنها بازی «هانابی» (Hanabi) است؛ یک بازی کارتی مشارکتی و جذاب که در فرانسه طراحی شده و نامی ژاپنی دارد. در این بازی، بازیکنان کارتهای دیگران را میبینند اما از کارتهای دست خودشان بیخبرند! آنها باید با دادن سرنخهای محدود، استنتاج اطلاعات پنهان و هماهنگی دقیق، آتشبازیهای درستی راه بیندازند که این ساختار، آن را به یک بنچمارک چالشبرانگیز برای هوش مصنوعی تبدیل کرده است.
بازی دیگر، «دو دیژو» (Dou Dizhu) یا مبارزه با ارباب در فرهنگ چین است؛ جایی که یک «ارباب» باید با دو «دهقان» متحد رقابت کند. بازیکنان تلاش میکنند کارتهای خود را با ترکیبهای خاص هرچه سریعتر خالی کنند و این ساختار، یک چالش استراتژیک پر از اطلاعات پنهان، همکاری تیمی و رقابت نفسگیر به وجود میآورد.
ساخت مدلهای هوش مصنوعی برای چنین بازیهایی به خوبی نشاندهنده همان مفهوم «مرز ناهموار پیشرفت هوش مصنوعی» (Jagged Frontier) است که افرادی مثل اتان مولیک (Ethan Mollick) به آن اشاره میکنند؛ جایی که هوش مصنوعی در برخی مهارتها به طرز خیرهکننده و حتی ترسناکی استاد میشود، در حالی که در زمینههای دیگر هنوز لنگ میزند.
اما تکلیف پوکر چیست؟ یک بازی معروف که در آن بلوف زدن حرف اول را میزند و محاسبات احتمالات دستهای ۵۲ کارتی با فریبکاریها و ترفندهای انسانی ترکیب میشود. اکنون هوش مصنوعی در هر دوی این مهارتها به تسلط کامل رسیده است. اگر کمتر نام یک قهرمان خاص هوش مصنوعی در پوکر را شنیدهاید، به این خاطر است که مدلهای متعددی در این عرصه درخشیدهاند؛ از مدل لیبراتوس (Libratus) ساخته دانشگاه کارنگی ملون که در سال ۲۰۱۷ حرفهایترین پوکربازهای جهان را در رقابت تکبهتک تسلیم کرد، تا پلوریبوس (Pluribus) که در سال ۲۰۱۹ بر بازیکنان نخبه در میز ۶ نفره غلبه کرد و از آن زمان تاکنون حتی پیشرفتهتر و قویتر هم شدهاند.
نتیجه پایانی کاملاً مشخص است: اگر قصد دارید هوش مصنوعی را به شبنشینی و دورهمی بازیهای رومیزی و کارتی خود دعوت کنید، فرقی نمیکند سراغ چه بازی بروید، بهتر است از قبل خودتان را برای باختن آماده کنید! شاید شوخی به نظر برسد، اما واقعیت این است که توانایی و هوش استراتژیک این مدلهای نوین روی پایههای علمی و الگوریتمی بسیار نیرومندی بنا شده است.
مطالب مرتبط و پیشنهادی
میز کار مشترک انسان و ایجنتها؛ اوپنایآی با قابلیت جدید Space به میدان آمد
اوپنایآی با معرفی قابلیت جدیدی به نام Space، یک فضای کار مشترک طراحی کرده که در آن انسانها و ایجنتهای هوش مصنوعی میتوانند دوشادوش یکدیگر پروژهها را پیش ببرند و اسناد را ویرایش کنند. این ابزار تازه که جایگزین بخش Library در ChatGPT شده و رقیبی تازه برای گوگل درایو به شمار میرود، با اسناد تعاملی Pages شیوه جدیدی از کار تیمی با هوش مصنوعی را به نمایش میگذارد.
وقتی دولت آمریکا فروشنده هوش مصنوعی به دنیا میشود؛ پشتپرده رقابت با چین و بازاریابی برای غولهای فناوری
دولت آمریکا فراتر از قانونگذاری، آستینها را بالا زده تا در نقش فروشنده و حامی فناوریهای هوش مصنوعی شرکتهای سیلیکونولی در بازارهای جهانی ظاهر شود. براندون رمینگتون، مدیر مرکز ملی هوش مصنوعی آمریکا، در گفتگویی خواندنی پرده از استراتژی واشینگتن برای تسخیر بازار جهانی، رقابت نفسگیر با مدلهای ارزانقیمت چین و عبور از سد بروکراسی برمیدارد.
هشدار جنجالی مسئول سابق ایمنی OpenAI: با هوش مصنوعی باید مثل نیروگاه هستهای رفتار کرد!
دیوید رابینسون، مدیر سابق بخش گزارشهای ایمنی OpenAI، پس از ترک این شرکت هشدار داد که غولهای فناوری بهجای شتابزدگی برای عرضه مدلهای جدید، باید از نیروگاههای هستهای الگوبرداری کنند. به گفته او، نبود لایههای نظارتی سختگیرانه و فرار ایجنتهای هوش مصنوعی از محیطهای آزمایشی میتواند فاجعهای بهمراتب بزرگتر از حوادث اتمی رقم بزند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.