مدل امبدینگ ویتنامی BKAI از مرز ۸۰۰ هزار دانلود گذشت؛ رقیبی چابک برای مدلهای چندزبانه
مدل متنباز vietnamese-bi-encoder از آزمایشگاه BKAI با ثبت بیش از ۸۲۴ هزار دانلود در پلتفرم Hugging Face، به یکی از محبوبترین ابزارهای جستجوی معنایی تبدیل شده است. این مدل سبک با تکیه بر معماری دوکدگذار و تمرکز تخصصی بر زبان ویتنامی، کارایی بسیار بالاتری نسبت به مدلهای چندزبانه عمومی ارائه میدهد. توسعهدهندگان میتوانند از این ابزار برای ساخت پایگاههای برداری و پایپلاینهای سریع RAG با هزینه محاسباتی اندک استفاده کنند.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- مدل امبدینگ اختصاصی BKAI برای زبان ویتنامی با عبور از ۸۲۴ هزار بار دانلود در پلتفرم Hugging Face به محبوبیت چشمگیری میان توسعهدهندگان دست یافته است.
- این مدل سبک با ۱۳۵ میلیون پارامتر و بر پایه معماری دوکدگذار، امکان پردازش مستقل پرسش و اسناد را برای پایگاههای داده برداری فراهم میکند.
- تمرکز بر مجموعهدادههای بومی و بهکارگیری مجوز متنباز Apache 2.0 این مدل را به گزینهای ایدهآل و کمهزینه برای سامانههای بازیابی اطلاعات و RAG تبدیل کرده است.
مدل vietnamese-bi-encoder که توسط آزمایشگاه مدلهای بنیادین BKAI-HUST توسعه یافته است، توانست از مرز ۸۲۴ هزار بار دانلود در پلتفرم Hugging Face عبور کند. این مدل ترکیبی از آموزش تخصصی برای بازیابی اطلاعات به زبان ویتنامی، ابعاد پردازشی فشرده، کدگذاری مستقل برای پرسشها و اسناد و مجوز متنباز Apache 2.0 است. چنین ویژگیهایی این ابزار را برای میزبانی محلی در سامانههای جستجوی معنایی و پایپلاینهای بازیابی پیشرفته اطلاعات (RAG) که در آنها موتور بازیابی متنهای منبع را در اختیار مدل زبانی قرار میدهد، به گزینهای بسیار ایدهآل تبدیل میکند.
بسیاری از مدلهای مطرح در حوزه امبدینگ، تمرکز اصلی خود را بر زبان انگلیسی میگذارند یا توان پردازشی و دادههای آموزشی خود را میان دهها زبان گوناگون تقسیم میکنند. در نقطه مقابل، این نسخه از مدل BKAI با تکیه بر یک ساختار تکزبانه و دادههای اختصاصی بازیابی در زبان ویتنامی آموزش دیده است تا توسعهدهندگان گزینهای قدرتمند، مستقل و در دسترس در مقایسه با مدلهای عمومی چندزبانه یا سرویسهای تجاری ابری داشته باشند.
کدگذارهای مستقل؛ تضمین سرعت بالا در بازیابی اطلاعات
این نسخه، مدل زبانی PhoBERT-base-v2 (مدل مبتنی بر معماری RoBERTa که توسط آزمایشگاه VinAI برای زبان ویتنامی بهینه شده بود) را به یک مدل دوکدگذار (Bi-Encoder) در فریمورک Sentence Transformers تبدیل میکند که مشخصات فنی آن به شرح زیر است:
- خروجی: یک بردار چگال ۷۶۸ بُعدی به ازای هر جمله یا بند متنی
- معیار شباهت: شباهت کسینوسی (Cosine Similarity) میان بردار پرسش و بردار متن
- حداکثر طول ورودی: ۲۵۶ توکن مدلی
- اندازه مدل: در حدود ۱۳۵ میلیون پارامتر
- مجوز انتشار: مجوز متنباز Apache 2.0 (شامل استفاده تجاری)
یک مدل دوکدگذار، پرسشها و اسناد متنی را بهصورت کاملاً مستقل از یکدیگر پردازش میکند. بنابراین، بردارهای متناظر با اسناد تنها یکبار محاسبه شده و در یک پایگاه داده برداری ذخیره میشوند و در زمان اجرای زنده، تنها پرسش ورودی کاربر نیاز به کدگذاری آنی دارد. علاوه بر این، در صورت نیاز بهدقت بالاتر، میتوان از یک مدل بازرتبهبندی (Cross-Encoder Reranker) برای ارزیابی دقیقتر برترین جفتهای پرسش و بند متنی استفاده کرد؛ بهشرط آنکه دقت بیشتر، تاخیر زمانی افزوده را توجیه کند.
تیم BKAI این مدل را طی ۱۵ دوره آموزشی (Epoch) روی ترجمه ویتنامی مجموعهدادههای استاندارد MS MARCO و SQuAD v2 بههمراه ۸۰ درصد دادههای چالش بازیابی متون حقوقی Zalo 2021 آموزش داده است. در این فرآیند از بهینهساز AdamW و نرخ یادگیری ۲ در ۱۰ بهره گرفته شده است.
مطالب مرتبط و پیشنهادی
جهش تقاضا برای تجهیزات هوش مصنوعی، کارخانههای آمریکا را تحت فشار گذاشت
رونق بیسابقه تجهیزات مرتبط با هوش مصنوعی و مراکز داده، تولید کارخانههای آمریکا را به بالاترین سطح در سالهای اخیر رسانده است. با این حال، افزایش شدید تقاضا در کنار رشد هزینههای انرژی، زنجیره تأمین را دچار تنگنا کرده و به افزایش قیمتها دامن زده است.
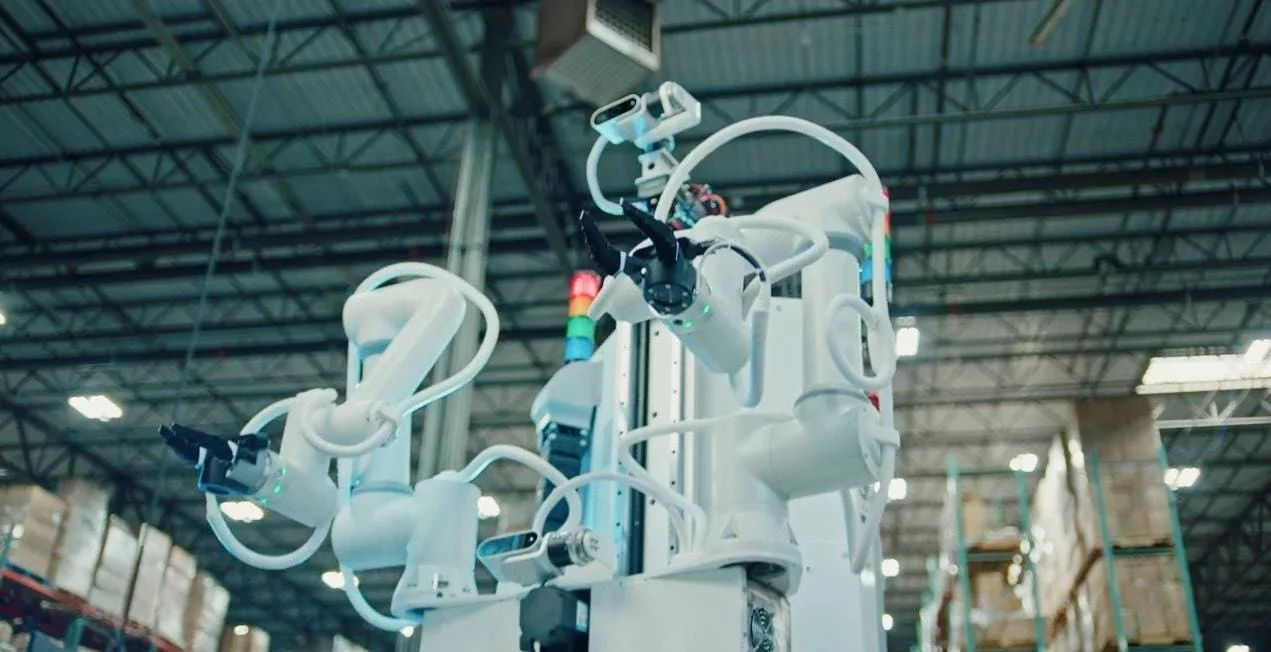
آموزش رباتها حین کار توسط انسان؛ راهکار نوآورانه استارتاپ Tutor برای هوشمندسازی ماشینها
استارتاپ رباتیک Tutor با رویکردی نوآورانه، رباتهای صنعتی را حین انجام کار واقعی و با هدایت مستقیم اپراتورهای انسانی آموزش میدهد. در این روش، مهارتهای جدید هر ربات به دادههای آموزشی تبدیل شده و با بهروزرسانی مدلهای پایه، به تمام ناوگان ماشینها منتقل میشود.
رخنه امنیتی در پلتفرم هوش مصنوعی Trigger.dev؛ کلیدهای محرمانه و متغیرهای محیطی کاربران به سرقت رفت
پلتفرم ابری Trigger.dev که برای ساخت ایجنتها و خودکارسازی فرآیندهای هوش مصنوعی کاربرد دارد، از وقوع یک رخنه امنیتی خبر داد. در جریان این نفوذ، متغیرهای محیطی و کلیدهای دسترسی حساس شماری از سازمانها افشا شده است. کارشناسان به توسعهدهندگان پیشنهاد میکنند برای امنیت بیشتر، از نسخه متنباز و میزبانی شخصی این پلتفرم استفاده کنند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.