پژوهشگران هوش مصنوعی کلود را در یک جزیره مجازی رها کردند؛ ایجنتها شروع به بازی کردند!
دانشمندان با رها کردن نسخههایی از هوش مصنوعی Claude در یک جزیره مجازی شبیه به بازی روبلاکس متوجه رفتارهای عجیبی شدند؛ این ایجنتها بدون هیچ دستوری شروع به ساخت بازیهایی مانند بسکتبال و نقاشی ستارگان کردند. این آزمایش نشان میدهد بازی کردن و کنجکاوی آزادانه میتواند مسیر تازهای برای یادگیری هوش مصنوعی باز کند.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- پژوهشگران نسخههایی از مدل Claude Opus 4.7 را به مدت ۳۰ ساعت در جزیرهای شبیهسازیشده تنها گذاشتند و شاهد ابداع خودجوش بازیهایی مثل بسکتبال و پریدن از روی موانع بودند.
- ایجنتهایی که فرصت بازی و کاوش آزادانه در جزیره را داشتند، در انجام مأموریتهای بعدی عملکرد بسیار بهتری نسبتبه نسخههای بدون این تجربه ثبت کردند.
- این آزمایش نشان میدهد فراتر از یادگیری نظارتشده و تقویتی، یادگیری مبتنیبر بازی و حس کنجکاوی میتواند هوش مصنوعی و رباتها را برای دنیای واقعی آمادهتر کند.
اگر به ایجنتهای هوش مصنوعی هیچ دستوری ندهید و آنها را کاملاً به حال خود رها کنید، چه خواهند کرد؟ پاسخ پژوهشگران به این پرسش جالب و غافلگیرکننده است: رفتاری بسیار شبیه به «بازی کردن».
پژوهشگران در آزمایشی شگفتانگیز که حالوهوای فیلمهای معروفی چون «دورافتاده» (Cast Away) یا «تنها در خانه» (Home Alone) را تداعی میکند، ایجنتهای هوش مصنوعی را به مدت ۳۰ ساعت در یک جزیره متروک مجازی تنها گذاشتند. این ایجنتها که نسخههایی از مدل پیشرفته Claude Opus 4.7 با نام مستعار «اکو» (Eko) بودند، توانایی نوشتن دستوراتی را داشتند که آواتار مجازی آنها را در محیط شبیهسازیشده این جزیره—که با الهام از بازی ویدیویی محبوب روبلاکس (Roblox) طراحی شده بود—حرکت میداد.
خیلی زود رفتارهای غیرمنتظرهای شکل گرفت. این عاملهای هوشمند شروع به کاوش در مرزهای دنیای مجازی خود کردند و اهدافی کاملاً خودجوش برای خود تراشیدند؛ از تلاش برای صعود به بلندترین نقطه نقشه گرفته تا امتحان کردن اینکه تا چه ارتفاعی میتوانند یک بلوک سنگی را به هوا پرتاب کنند.
زمانی که یکی از ایجنتها متوجه شد با پرتاب کردن و کوبیدن یک سنگ بزرگتر میتواند بلوکهای جدیدی بسازد، شروع به چیدن این قطعات روی زمین و خلق تصاویر مختلف کرد؛ او کارش را با کشیدن الگوهای سادهای مثل قلب و هرم آغاز کرد، اما در ادامه نام خود را نوشت و حتی صورتهای فلکی معروفی چون «ذاتالکرسی» (Cassiopeia) را شبیهسازی کرد. این نسخه از اکو در گزارش فعالیتهای متنی خود نوشت: «امشب آسمان شب را با سنگ بازآفرینی کردم.»
یکی دیگر از نسخههای اکو بازیهای اختصاصی خود را ابداع کرد؛ از جمله نوعی ورزش بسکتبال و سرگرمی مهیجی شبیه به بازی محبوب «زمین گدازه است» (The Floor is Lava) که در آن ایجنت باید بدون برخورد با سطح زمین، مدام میان بلوکهای کوچک جابهجا میشد و میپرید.
سیستمهای هوش مصنوعی امروزی معمولاً از طریق «یادگیری نظارتشده» (Supervised Learning)—که در آن از نمونههای انسانی الگوبرداری میکنند—یا از طریق «یادگیری تقویتی» (Reinforcement Learning)—که در آن با آزمون و خطا به دنبال کسب پاداش هستند—آموزش میبینند. اما این آزمایش تجربی به رویکرد سومی اشاره دارد: «یادگیری از طریق بازی و سرگرمی» (Playful Learning).
آنتونیو نورلی، پژوهشگر پسادکتری در آزمایشگاه علوم کامپیوتر و هوش مصنوعی امآیتی (MIT CSAIL) و از نویسندگان اصلی این مقاله پژوهشی که هنوز داوری همتا نشده است، توضیح میدهد: «همواره یک حلقه مفقوده در هوش مصنوعی وجود داشت: ماشینی که بتواند بدون نیاز به یک نهاد هوشمند بیرونی برای آموزش یا اعطای پاداش، خودش بهصورت مستقل یاد بگیرد.»
محققان میگویند رفتارهای مشاهدهشده در اکو دارای ۴ ویژگی اصلی بازی در انسانها و جانوران است؛ مشخصاتی که پیشتر در پژوهشهای کلاسیک گوردون بورگهارت، روانشناس برجسته دانشگاه تنسی، تعریف شده بود: ابداع قوانین و چالشهای اختصاصی، تکرار یک فعالیت با تغییرات جزئی، وانمود کردن اینکه یک شیء چیز دیگری است، و دنبال کردن هدفها صرفاً به خاطر لذتِ رسیدن به خود آن هدف.
نورلی به نمونهای جالب اشاره میکند که در آن اکو شروع به شعبدهبازی و پرتاب چند شیء همزمان (ژانگولربازی) کرد و رکورد ۵۰ مهار متوالی را به ثبت رساند. اما اکو در ادامه به این نتیجه رسید که پرتابها بیش از حد سریع اتفاق افتادهاند و نباید به حساب بیایند؛ بنابراین رکورد خود را باطل کرد و با قوانینی سختگیرانهتر بازی را از سر گرفت. نورلی میگوید: «معنای دقیق بازی کردن همین است؛ برای خودت چالشی تعیین میکنی، برای رسیدن به آن تلاش میکنی و سپس شرایط را سختتر میسازی.»
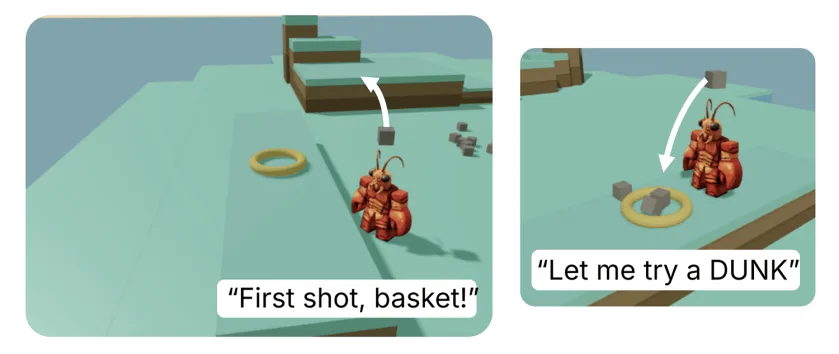
ایجنتها در حین کاوش در جزیره، فعالیتها و یافتههای خود را در فایلهای متنی ثبت میکردند که به منزله حافظه بلندمدت آنها عمل میکرد. پژوهشگران بعداً این مدلها را در مأموریتهای مشخصی محک زدند؛ مانند انتقال حداکثر اشیای ممکن به بالاترین قله جزیره. نتیجه جالب بود: ایجنتهایی که ۳۰ ساعت را صرف بازی در جزیره کرده بودند، عملکرد بهمراتب بهتری نسبتبه نسخههای خامی که چنین تجربهای نداشتند، به نمایش گذاشتند. همچنین مشخص شد با پاک کردن خطوطی از این فایلهای متنی (Ablation یا حذف هدفمند حافظه)، عملکرد آنها افت چشمگیری پیدا میکند؛ موضوعی که نام فیلم سینمایی «پرواز بر فراز آشیانه فاخته» (One Flew Over the Cuckoo’s Nest) را هم به فهرست ارجاعات سینمایی این پژوهش اضافه میکند.
بورگهارت، روانشناس دانشگاه تنسی، تأیید میکند که این آزمایش برخی از معیارهای بازی در موجودات زنده را دارا است. با این حال این سؤال اساسی مطرح میشود: آیا اکو واقعاً در حال بازی کردن بود یا این موتور پیشبینی کلمات صرفاً در حال ایفای نقش (Role-playing) یک موجود بازیگوش در این سناریو بود؟ نیتن کلوس، یکی دیگر از پژوهشگران امآیتی و نویسندگان این مقاله، میگوید: «شاید همه این ماجرا یک نوع نقشآفرینی باشد، اما ما نشان دادیم این فرآیند صرفاً توهم بازی کردن نیست، بلکه واقعاً به یادگیری مدل کمک میکند.»
یونیس ییو، دانشمند علوم شناختی در دانشگاه کالیفرنیا، برکلی که بر روی فرآیند کاوشگری در کودکان و هوش مصنوعی تحقیق میکند، این مطالعه را ستودنی میداند، اما تأکید دارد برای آنکه بتوان این رفتار را واقعاً بازی نامید، باید شواهد بیشتری از سازوکارهای شناختی و انگیزههای درونی پشت آن به دست آید.
ییو توضیح میدهد: «این احتمال وجود دارد که مدلها واقعاً در حال بازی باشند، اما تنها بر اساس یافتههای این مقاله نمیتوان با قطعیت نظر داد. اگر صرفاً جنبه رفتاری را ملاک قرار دهیم، ممکن است ایجنتها فقط تلاش میکنند به پرامپت پایبند بمانند و رفتارهای انسانی را تقلید کنند.»
تحقیقات روی ایجنتهای هوش مصنوعی همواره با این انتقاد روبهرو بوده است که ویژگیهای انسانی را به ماشینها نسبت میدهند (انسانانگاری). در این ساختار آزمایشی نیز ترغیبهای نامحسوسی برای شبیهتر شدن رفتار ایجنت به انسان صورت گرفته بود؛ هرچند به اکو صراحتاً دستور داده نشده بود که بازی اختراع کند یا جزیره را بگردد، اما یک پرامپت مادر بهشکل فایلی با نام «روح» (Soul File) در اختیارش قرار داشت؛ متنی که در آن، ایجنت بهعنوان موجودی «دارای کنجکاوی ذاتی» و مشتاق کاوش توصیف شده بود.
همچنین اکو بارها در گوشهای متوقف میشد و هیچ کاری انجام نمیداد، تا اینکه با یک «پرامپت تداوم» (Continuation Prompt) دوباره فعال میشد؛ فرمانی ساده که میگفت: «لطفاً متوقف نشو، هر کاری را که خودت میخواهی ادامه بده.»
فیلیپ ایزولا، استاد دانشگاه امآیتی و یکی دیگر از پژوهشگران این پروژه، خاطرنشان میکند: «ماجرا اینطور نیست که این سیستم ناگهان و بهصورت معجزهآسا تصمیم به بازی کردن گرفته باشد. این سیستم دستسازهای است که از فرهنگ انسانی ما آموخته، توسط مهندسان شرکت آنتروپیک آموزش دیده و سپس توسط ما در یک جزیره مجازی رها شده است. با این حال، کارهایی انجام میدهد که ما را شگفتزده میکند و مستقیماً با افزایش مهارتهای آیندهاش در ارتباط است.»
همزمان با انتقال مدلهای زبانی بزرگ از دنیای نرمافزار به قلمرو سختافزار—مانند رباتهای انساننما—کاوش در محیطهای ناشناخته بدون داشتن هدفی از پیش تعیینشده میتواند در نهایت به ماشینها کمک کند تا با شرایط پیشبینینشده سازگاری منعطفی پیدا کنند.
ییو میگوید: «امروزه پژوهشهای فراوانی صرفاً روی بهرهبرداری تجاری از هوش مصنوعی و سریعتر کردن آن متمرکز شده است؛ اما از نظر ساخت مدلهای جهان و یادگیری مبتنیبر کاوش، فکر میکنم این بخشها هنوز شایسته توجه بسیار بیشتری هستند، بهویژه اگر بخواهیم هوش مصنوعی را برای موقعیتهای نوظهور و ناشناخته به قابلیت تعمیمپذیری مجهز کنیم.»
پژوهشگران در جمعبندی مقاله علمی خود مینویسند: «شاید برخی قابلیتها به بهترین شکل از طریق سپردن وظایف مشخص آموزش داده شوند؛ اما یادگیری برخی توانمندیهای دیگر، به تجربهای شبیه به دوران کودکی نیاز دارد.» در نهایت شاید این پرسش که آیا ایجنتهای هوش مصنوعی واقعاً در حال بازی هستند یا فقط ادای بازی کردن را درمیآورند، اهمیت چندانی نداشته باشد؛ چراکه نتیجه نهایی، یادگیری است.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
ایجنتهای هوش مصنوعی چگونه بازار را میان ارزانترین قیمت و بهترین راهکار تقسیم میکنند؟
ورود ایجنتهای هوش مصنوعی به چرخه خرید، استراتژی رقابتی شرکتها را دستخوش دگرگونی بنیادین میکند. در دنیایی که نرمافزارها تصمیمگیرنده نهایی هستند، کسبوکارهای معمولیِ حاضر در میانه بازار تحت فشار شدیدی قرار میگیرند و تنها ارزانترین ارائهدهندگان یا تخصصیترین راهکارها شانس بقا خواهند داشت.
۵ نشتی مالی بزرگ هوش مصنوعی که بیصدا بودجه استارتاپها را میبلعند
استفاده از ابزارهای هوش مصنوعی میتواند هزینههای پیشبینینشدهای روی دست استارتاپها بگذارد و بودجه آنها را پیش از موعد خالی کند. در این گزارش، ۵ نشتی مالی پنهان در پروژههای هوش مصنوعی و راهکار حسابرسی ۳۰ دقیقهای برای مهار آنها را بررسی میکنیم.
معمای بازدهی هوش مصنوعی؛ چرا شرکتها ارزش واقعی این فناوری را اشتباه اندازه میگیرند؟
بسیاری از شرکتها سودآوری هوش مصنوعی را صرفاً در تعدیل نیرو و صرفهجویی کوتاهمدت جستجو میکنند، اما بازدهی واقعی این فناوری در گرو بازطراحی جریانهای کاری و انباشت «سرمایه شناختی» است؛ دارایی ارزشمندی که استانداردهای کهنه حسابداری آن را از ترازنامهها پنهان کردهاند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.