برابری کلود کد با یک اسکریپت ۱۰۰ خطی؛ چرا فریمورکهای پیچیده کدنویسی فقط هزینه میتراشند؟
پژوهشهای جدید نشان میدهد محیطهای اجرایی پیچیده در ابزارهای کدنویسی هوش مصنوعی نظیر کلود کد، بدون ایجاد بهبودی ملموس در دقت حل مسئله، هزینه پردازش را تا ۳ برابر افزایش میدهند. در این ارزیابیها، یک اسکریپت مینیمال ۱۰۰ خطی پایتون عملکردی کاملاً پایاپای با سیستمهای سنگین تجاری ثبت کرده است.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- محیطهای اجرایی یا هارنسهای پیچیده هوش مصنوعی بدون افزایش نرخ موفقیت، هزینه حل مسائل کدنویسی را تا سه برابر بالا میبرند.
- در بنچمارک SWE-bench، یک اسکریپت مینیمال ۱۰۰ خطی در پایتون توانست به دقتی کاملاً برابر با سیستم سنگین Claude Code دست یابد.
- بخش عمده هزینههای اضافی ناشی از ارسال مکرر پرامپتهای اولیه حجیم و تاریخچه گفتوگو در هر گام است، نه حجم کدهای پروژه.
محیط اجرایی یا هارنس (Harness) پیرامون یک مدل کدنویسی هوش مصنوعی — شامل پرامپت سیستمی، ابزارها و قواعد مدیریت کانتکست — بر اساس یافتههای یک پژوهش جدید، میتواند هزینه حل چالشهای برنامهنویسی را تا ۳ برابر افزایش دهد، بیآنکه بهبودی قابلسنجش در میزان دقت بههمراه داشته باشد. شرکتهای ارائهدهنده هوش مصنوعی مدام از افزایش دقت مدلها در پی بهروزرسانی هارنسهای خود صحبت میکنند؛ اما اینکه آیا یک محیط اجرایی پیچیدهتر و پرزرقوبرق واقعاً ایجنت را در حل مسائل کدنویسی تواناتر میکند یا خیر، هنوز در هالهای از ابهام قرار دارد.
پژوهشگران دانشگاه شاندونگ این فرضیه را به بوته آزمایش گذاشتند. آنها با ثابت نگه داشتن مدلهای زیربنایی، ۳ هارنس عملیاتی را روی نزدیک به ۵۰۰ وظیفه مهندسی نرمافزار مورد سنجش قرار دادند. در مجموعه وظایف بزرگتر، پیچیدهترین و مینیمالترین هارنسها از نظر آماری نرخ موفقیتی کاملاً همارز (در بازه خطای ۵ واحد درصدی) ثبت کردند، هرچند عملکرد هارنس سوم ضعیفتر ظاهر شد.
در میان ۴۵ وظیفه فوقالعاده دشوار، جابهجا کردن هارنسها دقیقاً همانقدر باعث تغییر در مسائل حلشده توسط ایجنتها شد که اجرای مجدد یک تنظیمات بدون تغییر ایجاد میکرد؛ به بیان دیگر، میانه این تغییرات در هر دو حالت حدود ۱۳ درصد وظایف بود. در این میان، محققان متوجه شدند که هزینه انجام هر وظیفه با استفاده از یک مدل یکسان، بسته به نوع هارنس میتواند تا ۳ برابر متغیر باشد.
این یافتهها هشداری صریح برای مدیران فنی و توسعهدهندگان به شمار میرود تا ایجنتهای کدنویسی را صرفاً بر اساس تفاوتهای اندک در بنچمارکهای تکنوبته انتخاب نکنند؛ بلکه تیمهای مهندسی باید همزمان نرخ موفقیت و هزینه پردازش به ازای هر وظیفه را زیر نظر داشته باشند.
چرا بنچمارکهای هارنس میتوانند گمراهکننده باشند؟
تابلوهای امتیازات عمومی (Leaderboards) معمولاً ایجنتهای کدنویسی مجهز به هارنسهای گوناگون را با یکدیگر مقایسه میکنند؛ موضوعی که تشخیص سهم واقعی خودِ هارنس را دشوار میسازد. برخی مطالعات حاکی از آن است که ثابت نگه داشتن مدل و صرفاً جابهجا کردن هارنس میتواند به اختلاف ۲۳٫۸ امتیازی در نمرهدهی وظایف و اختلاف ۲۷٫۴ واحد درصدی در معیار Pass@1 منجر شود. در همین حال، شرکت هوش مصنوعی ژیپو (Zhipu AI) مدعی است هارنس اختصاصیاش یعنی ZCode با مدلی یکسان، ۲٫۴ امتیاز بالاتر از کلود کد (Claude Code) ثبت میکند.
با این حال، مطالعه جدید هشدار میدهد که تکیه بر این ارقام به دو دلیل دشوار است. نخست آنکه بسیاری از مقایسههای منتشرشده، هر پیکربندی را تنها یک بار اجرا میکنند، در حالی که اجرای دوباره همان آزمایشها در شرایط کاملاً یکسان میتواند نتایج بسیار متفاوتی به بار آورد. مطالعه مجزایی که در این مقاله به آن استناد شده نشان میدهد که ۱۰ بار تکرار آزمایشی دقیقاً یکسان در بنچمارک SWE-bench Verified، اختلافی بین ۲٫۲ تا ۶٫۰ واحد درصد در نمرات ایجاد کرده است. بنابراین، بدون اجرای مکرر پیکربندی پایه، تیمها نمیتوانند بفهمند این اختلاف امتیاز ناشی از قدرت هارنس بوده یا صرفاً به نوسانات تصادفی میان نوبتهای مختلف اجرا برمیگردد.
دلیل دوم این است که هارنسهای مورد مقایسه اغلب در شرایط برابر قرار ندارند. بر اساس تحقیقی که در این مقاله به آن اشاره شده، یک هارنس واحد با مدلی یکسان، هنگام استفاده از آداپتور مینیمال بنچمارک نمره ۱۹٫۱ درصد و با آداپتور کامل نمره ۷۳٫۴ درصد به دست آورده است.
علاوه بر این، شرایط آزمایش نیز میتواند نتایج را مخدوش کند. زمانی که پژوهشگران اجرای اولیهای را که دسترسی به وب داشت بازبینی کردند، دریافتند که در ۳۱۲ مورد از ۴۳۹ آزمایش مدلهای دیپسیک و کیوئن (معادل ۷۱ درصد موارد)، مدلها راهحل و کد اصلی نوشتهشده توسط انسان را مستقیماً از گیتهاب برداشته بودند! محققان آن آزمایشها را کنار گذاشتند و در ارزیابی نهایی خود دسترسی به اینترنت را بهطور کامل مسدود کردند.
رویارویی مستقیم هارنسهای عملیاتی در میدان عمل
پژوهشگران برای سنجش سهم واقعی یک هارنس، سه نمونه عملیاتی را به بوته آزمایش گذاشتند: Claude Code، OpenCode و mini-SWE-agent؛ هارنس متنبازی که به سبک مینیمال و تنها در حدود ۱۰۰ خط کد پایتون نوشته شده، فقط یک ابزار bash در اختیار مدل میگذارد و هیچ عملیات فشردهسازی کانتکستی انجام نمیدهد.
محققان ۵ مدل مختلف را در هر ۳ هارنس اجرا کردند: دو مدل وزنباز که بهشکل محلی میزبانی میشدند (شامل Qwen3.6-35B-A3B و Qwen3.8-27B) و سه مدل مبتنی بر API (شامل DeepSeek-V4-Flash، GLM-5.3-Flash و HY4-Preview). آنها همچنین از مدل قدرتمند Claude Opus 5 درون کلود کد بهعنوان معیار تراز اول بهره بردند.
آنها ایجنتها را در کانتینرهای ایزوله و روی ۴۹۲ وظیفه آفلاین از بنچمارک SWE-bench Verified ارزیابی کردند؛ این وظایف شامل ۴۵ چالش فوقالعاده سخت (که حل آنها برای برنامهنویسان انسانی بین ۱ تا بیش از ۴ ساعت زمان میبرد) و ۴۴۷ وظیفه دیگر بود. هر ۵ مدل روی زیرمجموعه ۴۵ وظیفه دشوار بررسی شدند، اما در مجموعه بزرگتر تنها دو مدل کیوئن مورد ارزیابی قرار گرفتند.
نتایج نشان داد که هارنسهای پرزرقوبرق هیچ برتری پایداری در دقت ارائه نمیدهند. در مجموعه ۴۴۷ وظیفهای، هارنس سنگینوزن Claude Code و هارنس مینیمال mini-SWE-agent با اختلافی کمتر از ۲ واحد درصد در کنار هم قرار گرفتند و در هر دو مدل کیوئن، از نظر آماری در بازه خطای ۵ واحد درصدی کاملاً همارز ارزیابی شدند. در ۴۵ چالش بسیار سخت نیز با تغییر هارنس، تقریباً از هر ۸ مسئله وضعیت قبولی یا رد شدن یکی (۱۳ درصد) تغییر کرد؛ جالب آنکه تکرار اجرای یک هارنس یکسان نیز دقیقاً همین نرخ تغییر را نشان داد. حتی بررسی هارنس رسمی و خط فرمانی دیپسیک روی مدل اختصاصی خودش یعنی DeepSeek-V4-Flash به نرخ موفقیتی در همان محدوده سایر هارنسها انجامید، در حالی که بالاترین هزینه را در میان تمام هارنسهای تستشده روی آن مدل ثبت کرد.
پژوهشگران در گزارش خود تأکید میکنند: «استفاده از هارنس اختصاصی یک شرکت روی مدل همان شرکت، هیچ امتیاز یا برتری خاصی ایجاد نمیکند.»
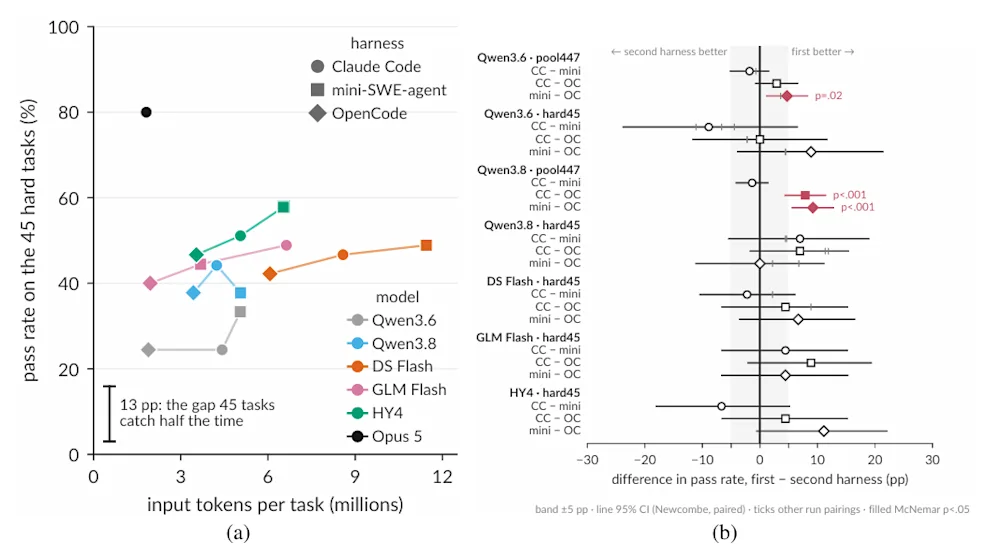
تنها اثری از هارنسها که از آستانه نویز آماری فراتر رفت، نه یک دستاورد بلکه یک افت عملکرد بود: OpenCode در مجموعه وظایف بزرگ، تا ۹ امتیاز عقب افتاد. در مدل Qwen3.8-27B، تقریباً نیمی از این فاصله به آزمایشهایی مربوط میشد که به دلیل برخورد مدل با سقف خروجی ۳۲٬۰۰۰ توکنی در میانه کار متوقف شده بودند؛ اتفاقی که اغلب پیش از توانایی مدل در نوشتن پچ کد رخ میداد. کلود کد نیز با همین سقف در مدل مذکور مواجه شد، اما بهشکل خودکار به مدل پرامپت داد تا پاسخ خود را ادامه دهد.
اگرچه هارنسهای پیچیدهتر بهبود پایداری در دقت نشان ندادند، اما انتخاب هارنس تأثیری چشمگیر بر هزینههای استنتاج و تولید پاسخ داشت.
محققان مینویسند: «با یک مدل یکسان، وظایف یکسان و تعرفه قیمتی مشابه، هزینه حل هر مسئله در میان هارنسهای مختلف تا ۳ برابر تفاوت دارد.»
در مدل GLM-5.3-Flash، هزینه هر آزمایش در Claude Code تقریباً دو برابر mini-SWE-agent و بیش از ۳ برابر OpenCode تمام شد. البته OpenCode پس از تعداد فراخوانیهای کمتری متوقف میشد که همین موضوع در کاهش هزینهاش نقش داشت. هر سه هارنس تقریباً حجم یکسانی از متن را از طریق فراخوانی ابزارها برمیگرداندند. با این حال، تفاوت هزینهها از همان اولین فراخوانی API آغاز میشد؛ جایی که هارنسها مقادیر کاملاً متفاوتی از کانتکست ثابت را در قالب پرامپتهای سیستمی و تعاریف ابزارها (Tool Schemas) ارسال میکردند: ۱۶٬۵۸۱ توکن در کلود کد، ۷٬۰۲۵ توکن در OpenCode و تنها ۸۲۹ توکن در mini-SWE-agent!
از آنجا که ایجنتها در هر گام تاریخچه گفتوگو را مجدداً ارسال میکنند، این بار اضافی اولیه در تعداد مراحل ضرب میشود؛ افزون بر این، پژوهشگران دریافتهاند که کلود کد با ارسال مکرر بلوکهای استدلال میانی مدل، بار پردازشی را سنگینتر هم میکند.
پژوهشگران توضیح میدهند: «آنچه وزن پردازشی هر مرحله از هارنسها را متمایز میکند، متنهای خود هارنس است، نه حجم کدهای مخزن نرمافزاری.»
حتی با وجود اینکه ۹۶ تا ۹۹ درصد از توکنهای ورودی در این حلقهها از حافظه کش پرامپت ارائهدهندگان (Prompt Cache) بهره میبردند، محاسبه دوباره هزینهها بر مبنای نرخهای مختلف کش ارائهدهندگان صرفاً رقم نهایی فاکتور را بالا و پایین کرد؛ اما این واقعیت را که کدام هارنس برای یک مدل معین گرانترین است، تغییر نداد.
البته رتبهبندی هزینهها بر اساس مدل نیز تغییر میکند. برای نمونه در DeepSeek-V4-Flash، هارنس mini-SWE-agent در هر آزمایش ۱۴۱ بار مدل را فراخوانی کرد (در مقایسه با ۱۰۴ بار در Claude Code) و هزینه کمی بیشتری بههمراه داشت؛ حدود ۱۵٫۲ سنت در برابر ۱۴٫۶ سنت به ازای هر آزمایش.
تأیید پدیدهای به نام «مالیات هارنس»
این یافتهها مهر تأییدی بر پژوهش هارنستکس (HarnessTax) است که پیشتر توسط محققان آزمایشگاه Sky Computing دانشگاه برکلی و پلتفرم آرنا (Arena) انجام شده بود. تیم دانشگاه برکلی ۷ مدل را در ۳ بستر Claude Code، ابزار خط فرمانی Codex از OpenAI، و Pi (یک هارنس مینیمال و متنباز با تنها ۴ ابزار ساده) ارزیابی کردند. آنها ۳۰ وظیفه از دو بنچمارک مختلف را با ۳ بار تکرار برای هر وظیفه سنجیدند و دریافتند که تغییر هارنس، نرخ قبولی را تنها چند درصد جابهجا میکند، اما هزینههای استنتاج را تا ۵ برابر افزایش میدهد.
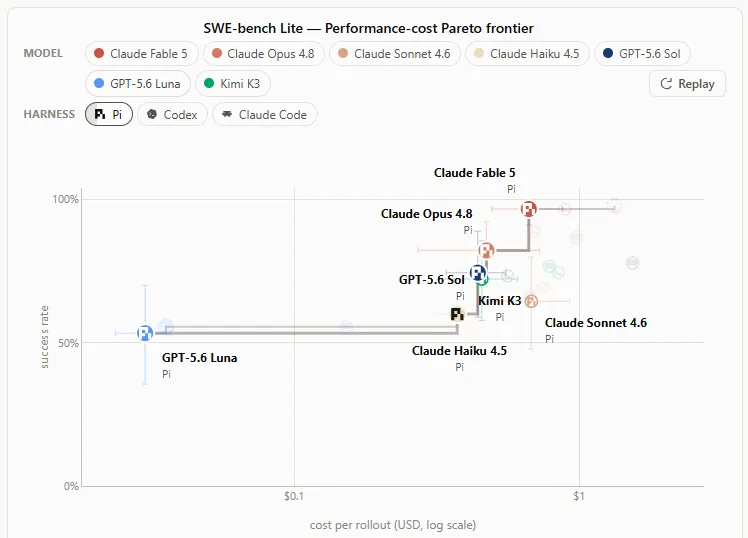
محققان برکلی دریافتند که اختلاف هزینه میتواند از همان اولین فراخوانی مدل کلید بخورد. در هر ۷ مدل، کانتکست اولیه Claude Code به دلیل دستورالعملهای طولانیتر و تعاریف مفصل ابزارها، بهطور میانگین بیش از ۱۰ برابر حجیمتر از هارنس Pi بود.
مطالعه هارنستکس برکلی نشان داد که فریمورکهای پیچیدهتر، بهبود چندانی در میانگین نرخ موفقیت وظایف در بنچمارکهای آزمایششده ایجاد نمیکنند. پژوهش جدید این نتیجه را فراتر میبرد و با سنجش مدلهای ۲۷ و ۳۵ میلیارد پارامتری کیوئن روی مجموعهای بزرگتر از وظایف، تفاوتهای هارنس را در برابر نوسانات تصادفیِ معمول میان نوبتهای مختلف اجرا میسنجد. همانطور که پژوهشگران دانشگاه شاندونگ درباره مدل Qwen3.6-35B-A3B (ضعیفترین مدل از نظر امتیاز در این آزمایش) خاطرنشان میکنند: «ضعیفترین مدل، لزوماً حساسترین مدل به نوع هارنس نیست.»
نکات کاربردی برای توسعهدهندگان و شرکتهای فعال در حوزه هوش مصنوعی
این دغدغه هزینهای تنها به ایجنتهای کدنویسی محدود نمیشود؛ در یک نظرسنجی صنعتی در ماه سپتامبر مشخص شد که از ۱۰۷ شرکت استفادهکننده از پلتفرمهای ارکستراسیون ایجنتها، ۲۳ شرکت (معادل ۲۱ درصد) هیچ سازوکار خودکاری برای مهار مصرف لجامگسیخته توکن توسط ایجنتهای خود نداشتند.
این پژوهش چند راهکار عملی ارزشمند برای مدیران فنی و توسعهدهندگانی ارائه میدهد که در حال ساخت اپلیکیشنهای هوش مصنوعی یا تخصیص بودجه برای ابزارهای کدنویسی هستند:
بنچمارکهای تبلیغاتی را با در نظر گرفتن آستانه نویز ارزیابی کنید: از آنجا که نتیجه تقریباً یک وظیفه از هر ۸ وظیفه در اجراهای کاملاً مشابه تغییر میکند، یک مجموعه ارزیابی ۴۵ وظیفهای در ۵۰ درصد مواقع تنها قادر به تشخیص یک اختلاف ۱۳ امتیازی است، و حتی یک مجموعه ۴۴۷ وظیفهای نیز تنها میتواند اختلافی ۵٫۲ امتیازی را از نوسانات عادی تفکیک کند. توسعهدهندگان باید ادعاهای مربوط به برتری ۲ تا ۳ امتیازی یک هارنس در مقایسههای تکنوبته را اثباتنشده تلقی کنند و پیش از روی آوردن به فریمورکهای پیچیدهتر، طبق توصیه پژوهشگران، پیکربندی پایه خود را حداقل دو بار به اجرا درآورند.
مقدمات نوبت اول و ساختار ابزارها را سبک کنید: پرامپت سیستمی و تعاریف ابزارها (Tool Schemas) در تمام مراحل رفتوبرگشت مجدداً ارسال میشوند، حتی اگر توکنهای کششده با تعرفه ارزانتری محاسبه شوند. هنگامی که پژوهشگران ابزارهای ویرایش فایل را از کلود کد حذف کردند تا مدل Claude Opus 5 ناچار شود فایلها را مستقیماً از طریق bash ویرایش کند، نرخ موفقیت مدل در همان محدوده آزمایشهای کنترلی باقی ماند. تیمها باید بررسی کنند که آیا استفاده از ابزارهای سبک خط فرمان بهجای دهها تعریف ایستا برای ابزارها، میتواند بدون افت نرخ تکمیل وظایف، هزینهها را کاهش دهد یا خیر.
بودجه تفکر و استدلال را متناسب با ترکیبِ مدل و هارنس تنظیم کنید: مدل Claude Opus 5 در نسخه یک سال قبل کلود کد (که قابلیت تفکر گسترده بهطور پیشفرض در آن غیرفعال بود)، ۳۴ وظیفه از ۴۵ وظیفه را حل کرد؛ در حالی که در نسخه جدیدتر ۳۵ تا ۳۶ وظیفه را با صرف ۴۴ درصد از میانگین هزینه تخمینی API حل نمود (۷۳ سنت در برابر حدود ۱٫۶۵ دلار برای هر آزمایش). با این حال، تیمها نباید تصور کنند که بودجه استدلال را میتوان بدون عواقب تغییر داد. بهعنوان مثال، خاموش کردن قابلیت تفکر در مدل Qwen3.6 باعث افت ۱۱ امتیازی نرخ قبولی در mini-SWE-agent شد، در حالی که در Claude Code و OpenCode تغییراتی در حد نوسانات تصادفی عادی به جا گذاشت. این نتایج نشان میدهد که پیامدهای تغییر بودجه استدلال، به ترکیب همزمان مدل و هارنس بستگی دارد، نه صرفاً خودِ مدل؛ بنابراین تیمها پیش از دستکاری پارامترهای تفکر برای کاهش هزینه، باید پشته فنی دقیق خود را محک بزنند.
پژوهشگران در جمعبندی خود خاطرنشان میکنند: «اعدادی که برای مقایسه عملکرد میان ارائهدهندگان مختلف باید مد نظر قرار دهید، حجم اولین فراخوانی، میزان رشد توکن در هر مرحله، و تعداد کل مراحل است.»
مطالب مرتبط و پیشنهادی
متا پلتفرم هوش مصنوعی ساندایال را تصاحب کرد؛ جهش به سوی نسل جدید ایجنتهای تحلیل داده
متا پلتفرم تحلیل داده مبتنی بر هوش مصنوعی ساندایال را تصاحب کرد تا زیرساختهای تحلیلی و ابزارهای خودکار خود را تقویت کند. این قرارداد با بازگشت دو مدیر باسابقه به متا همراه است که هدایت بخش ابزارها و ایجنتهای تحلیل داده را بر عهده خواهند گرفت.
پایان ماه عسل هوش مصنوعی در والاستریت؛ بازار دیگر با گزارشهای مالی درخشان هم قانع نمیشود
با وجود انتشار گزارشهای مالی قدرتمند از سوی شرکتهای حوزه هوش مصنوعی، والاستریت با ریزش سنگین سهام این غولها مواجه شد. این واکنش سرد از تردید فزاینده سرمایهگذاران درباره تداوم بازدهی تب هوش مصنوعی حکایت دارد و زنگ خطری جدی برای بیش از نیمی از ارزش بازار بورس آمریکا به صدا درآورده است.
مقایسه ChatGPT و Grok در پاسخ به چالشهای روزمره زندگی؛ هوش مصنوعی گراک شگفتیساز شد
در یک بررسی میدانی، دو چتبات مطرح دنیای هوش مصنوعی یعنی ChatGPT و Grok با ۵ پرسش روزمره و کاربردی در بوته آزمایش قرار گرفتند تا توانایی آنها در حل مسائل واقعی سنجیده شود. در پایان این مقایسه جذاب، مدل هوش مصنوعی گراک با پاسخهای مختصر، خودمانی و دقیق توانست برتری خود را ثابت کند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.