مقایسه دقیق روشهای RLHF و DPO؛ مقاله جدید کنفرانس ICML زمان برتری هر روش را مشخص کرد
مقاله پذیرفتهشده در کنفرانس ICML با تفکیک محدودیتهای داده و خطاهای مدلسازی، زمان برتری هر یک از روشهای RLHF و DPO را بهدقت تبیین میکند. این پژوهش به تیمهای توسعه هوش مصنوعی کمک میکند تا درباره انتخاب روش همسوسازی و نحوه تخصیص منابع برچسبگذاری دادهها هوشمندانهتر تصمیم بگیرند.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- مقاله جدید پذیرفتهشده در کنفرانس ICML چالشهای مقایسه روشهای همسوسازی مدلهای زبانی را به عوامل مدلسازی و دادههای ترجیحات تفکیک کرده است.
- روش RLHF با آموزش یک مدل پاداش مجزا عمل میکند در حالی که الگوریتمهای DPO سیاست مدل را مستقیماً روی ترجیحات تنظیم میکنند.
- این پژوهش چارچوبی کاربردی در اختیار تیمهای فنی قرار میدهد تا منابع برچسبگذاری داده و معماری بهینهسازی خود را بر اساس شرایط پروژه انتخاب کنند.
توسعهدهندگانی که قصد دارند میان روشهای RLHF، DPO آفلاین و DPO آنلاین انتخاب کنند، اغلب نتایج بنچمارکهای جامع را مقایسه میکنند؛ در حالی که این نتایج عواملی مانند گنجایش مدل، پوشش ترجیحات و رفتار بهینهسازی را با یکدیگر درهممیآمیزند. اکنون مقالهای که در کنفرانس ICML پذیرفته شده است، اثرات خطای مدلسازی و محدودیت دادههای ترجیحات را بهصورت تفکیکشده بررسی میکند. تحلیلهای این مقاله نشان میدهد که هر روش در چه شرایطی میتواند بر سایر رویکردها برتری یابد و به تیمهای فنی کمک میکند تصمیم بگیرند فرضیات مدلسازی خود را کجا متمرکز کنند و بودجه برچسبگذاری دادهها را به چه شکلی تخصیص دهند.
یک هدف مشترک و سه مسیر آموزشی متفاوت
در روش RLHF، ابتدا یک مدل پاداش بر اساس جفتپاسخهای برگزیده و ردشده آموزش داده میشود و سپس سیاست مدل زبانی در برابر این پاداشِ یادگرفتهشده بهینهسازی میگردد. سیستمهای عملی اغلب از الگوریتم PPO برای بهروزرسانی سیاست استفاده میکنند. در مقابل، روش DPO سیاست را مستقیماً روی جفتهای ترجیحات آموزش میدهد و نیازی به بهینهسازی مجزای مدل پاداش ندارد. روش Online DPO نیز همین بهروزرسانی مستقیم را تکرار میکند، اما دادههای مقایسهای جدید را از پاسخهایی گردآوری مینماید که توسط خود سیاست فعلی تولید شدهاند.
در بیشینهسازی پاداش با قاعده تنظیمگری واگرایی KL، سیاست بهینه از رابطه ریاضی π*(y|x) ∝ π_ref(y|x) exp(r(x,y)/β) پیروی میکند. در این فرمول، سیاست مرجع مانع انحراف بیش از حد مدل میشود و پارامتر β شدت این محدودیت را تنظیم میکند. روش DPO این رابطه میان پاداش و سیاست را جایگزین احتمال ترجیحات کرده و پارامترهای سیاست را مستقیماً بهینهسازی میکند. این مقاله پژوهشی بر پایه مدل ترجیحات Bradley-Terry استوار است که اختلاف پاداش بین دو پاسخ را به احتمال ترجیح داده شدن یکی بر دیگری تبدیل میکند.
روش | مولفه مورد برازش | منبع دادههای ترجیحات | مزیت بالقوه |
|---|---|---|---|
RLHF | یک مدل پاداش صریح و سپس بهینهسازی سیاست | معمولاً مجموعهداده ثابت | امکان یادگیری و کدگذاری مستقیم ساختار پاداش |
Offline DPO | آموزش مستقیم سیاست بر اساس تابع احتمال ترجیحات | معمولاً مجموعهداده ثابت | بهرهگیری از قدرت بیان مدل بدون نیاز به مدل پاداش مجزا |
Online DPO | بهروزرسانی مستقیم سیاست همراه با نمونهگیری زنده | پاسخهای تولیدشده توسط سیاست فعلی | کاهش جابهجایی توزیع داده و همسوسازی پویاتر با ترجیحات |
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
ابزار متنباز Phonon؛ تایپ صوتی کاملاً محلی روی مک با سرعتی ۸ برابر Wispr Flow
یک توسعهدهنده با انتشار برنامه متنباز Phonon، امکان تایپ صوتی دقیق و کاملاً آفلاین را برای کاربران مک فراهم کرده است. این ابزار با پردازش محلی گفتار روی تراشههای اپل و بهرهگیری از دو مدل هوش مصنوعی، متن پیادهشده را با سرعتی تا ۸ برابر بیشتر از سرویس Wispr Flow ویرایش و آماده میکند.
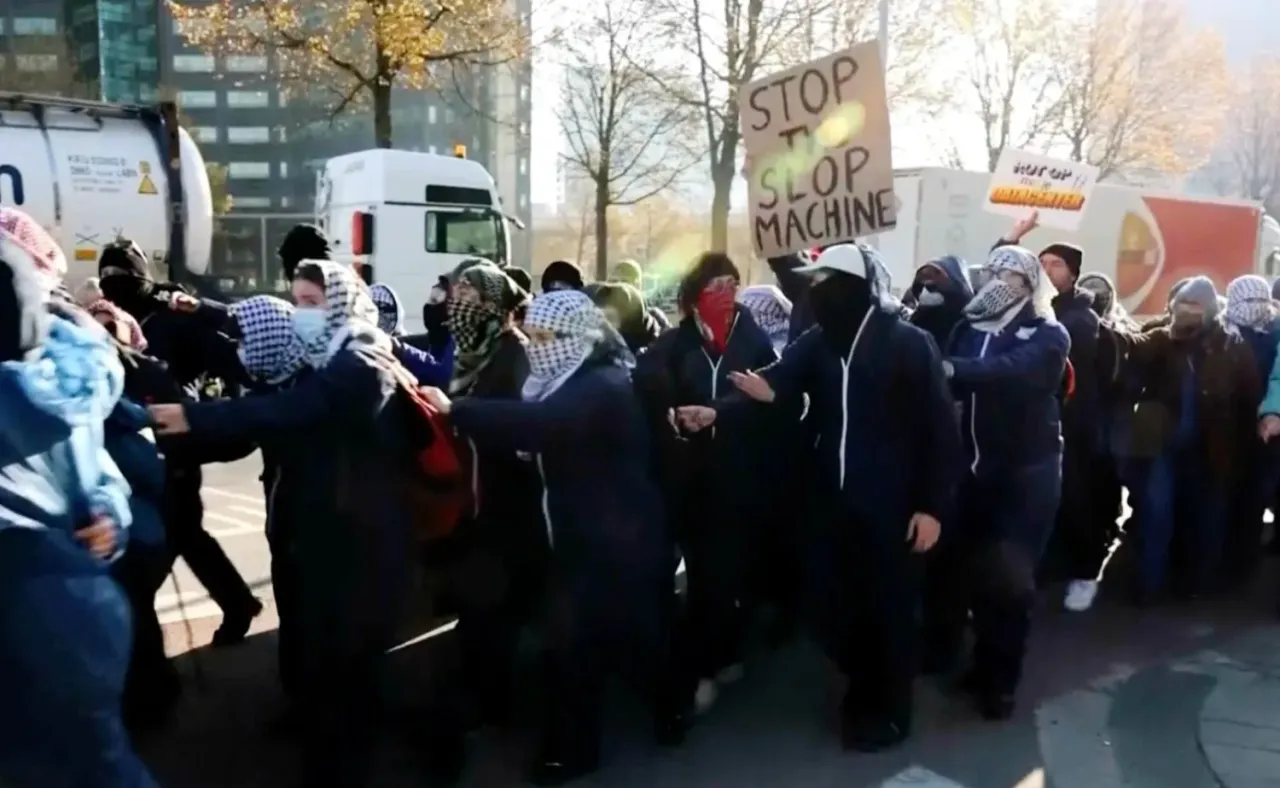
ورود معترضان به محوطه ساخت مرکز داده یک میلیارد دلاری مایکروسافت در آمستردام
نزدیک به ۱۰۰ تن از فعالان مدنی با ورود به محوطه ساخت مرکز داده یک میلیارد دلاری مایکروسافت در حومه آمستردام، به توسعه زیرساختهای هوش مصنوعی و مصرف بالای انرژی اعتراض کردند. این اقدام که به بازداشت شماری از معترضان انجامید، بخشی از پویشی هماهنگ در ۱۶ کشور علیه پیامدهای زیستمحیطی مراکز داده است.
سرقت حسابهای گوگل و مایکروسافت با تله دعوتنامههای جعلی OpenAI و Anthropic
پژوهشگران امنیتی از شناسایی کارزار فیشینگ جدیدی خبر میدهند که با سوءاستفاده از نام OpenAI و Anthropic، اطلاعات ورود به حسابهای گوگل و مایکروسافت را سرقت میکند. مهاجمان با وعدههای فریبندهای چون اشتراک رایگان هوش مصنوعی، کارمندان را به صفحات ساختگی هدایت کرده و حتی سازوکارهای احراز هویت دومرحلهای را دور میزنند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.