معیاری نوین برای پردازندهها؛ ارزیابی عملکرد CPU در اجرای ایجنتهای هوش مصنوعی
با گسترش ایجنتهای هوش مصنوعی و پیچیدهتر شدن جریانهای کاری آنها، پردازندههای مرکزی بار دیگر نقشی کلیدی پیدا کردهاند. اکنون تلاشهای تازهای برای ایجاد بنچمارکی استاندارد آغاز شده است تا سهم دقیق و گلوگاههای پردازنده در اجرای ابزارها و حلقههای ایجنتی سنجیده شود.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- بخش عمده زمان پردازش در وظایف ایجنتی تکی به پردازنده گرافیکی اختصاص دارد اما با افزایش اجرای همزمان وظایف، فشار اصلی بر دوش پردازنده مرکزی قرار میگیرد.
- این بنچمارک با ثبت رفتار مدل و اجرای مجدد پاسخها، عملکرد پردازنده را در فراخوانی ابزارها و اجرای کدهای پایتون بهشکل مستقل اندازهگیری میکند.
- معیارهای سنجش بر اساس تعداد نشستهای موفق در ثانیه تعریف شدهاند تا سقف توان پردازنده پیش از افت سرعت سیستم مشخص شود.
طی ۶ ماه گذشته، هوش مصنوعی مبتنی بر ایجنت (Agentic AI) تحول و هیجان بزرگی در دنیای پردازندههای مرکزی رقم زده است، با این حال در این حوزه هنوز بنچمارکهای معتبر و تکرارپذیری برای سنجش جایگاه دقیق سختافزارهای جدید وجود ندارد. مجموعهای از آزمونهای داخلی طراحی شده است تا دستکم یکی از جنبههای کلیدی حلقههای پرترافیک ایجنتی را بهشکل سرتاسری ارزیابی کرده و با تفکیک عملکرد پردازنده مرکزی (CPU) و حافظه از شتابدهنده گرافیکی، سهم هر قطعه در چرخه کار ایجنت را مشخص کند.
این پروژه همچنان در مراحل توسعه قرار دارد، اما بررسی پشت صحنه این تلاشها به درک شیوه مواجهه با این چالش، روششناسی آزمونها و دستاوردهای بهدستآمده درباره حلقههای ایجنتی کمک شایانی میکند. نمونه اولیه این آزمون پیادهسازی شده و معماری هسته اصلی آن به ثبات رسیده است، هرچند برای دستیابی به اعدادی که بتوانند زیر ذرهبین دقیقترین بررسیهای فنی دوام بیاورند، همچنان به پالایش نیاز است.
با توجه به اینکه این شاخه از محاسبات در لبه مرزهای فناوری قرار دارد و با سرعتی سرسامآور پیش میرود، بدون شک نقاط کور و ابهاماتی نیز در مسیر وجود دارد. این مسئله کاملاً طبیعی است. آزمون طراحیشده با این هدف ساخته شده تا رفتار پردازنده مرکزی و نحوه مقیاسپذیری آن را همگام با افزایش تعداد نشستهای همزمان (Sessions) رصد کند و سقف بهرهوری ایدهآل هر تراشه را بهگونهای بیابد که سیستم بتواند بیشترین تعداد ایجنت ممکن را در حالت پاسخگو و تعاملی مدیریت کند.
در ادامه این مطلب، کاستیهای این روش و ایدههایی برای سنجش جریانهای کاری چندمرحلهای (Multi-turn) بررسی شدهاند. شایان ذکر است که این آزمونها قرار نیست جایگزین سایر بنچمارکهای هوش مصنوعی محلی شوند، بلکه مکمل آنها خواهند بود. با تکامل این حوزه و مشخصتر شدن ویژگیهای سختافزاری مورد نیاز، مسیر توسعه این روشهای ارزیابی نیز روشنتر خواهد شد.
تعریف حلقه در هوش مصنوعی ایجنتی
اصطلاح «ایجنتهای هوش مصنوعی» معمولاً ذهن را به سمت کارگزاران کوچکی میبرد که مجهز به یک مدل زبانی بزرگ (LLM) هستند و هر وظیفهای که به آنها محول شود به سرانجام میرسانند. هرچند این توصیف برای درک اولیه خوب است، اما برای طراحی بنچمارک و سنجش دقیق عملکرد هوش مصنوعی ایجنتی، به تعریفی بسیار فنیتر و منسجمتر نیاز داریم.
در این چرخه دو بخش کلیدی وجود دارد. نخست، توابع (Functions) هستند. در هوش مصنوعی ایجنتی، مدل زبانی به ابزارهایی دسترسی پیدا میکند که در فریمورکهای محبوبی مانند LangGraph در قالب توابع پایتون تعریف میشوند. این ابزار میتواند خواندن یا نوشتن یک فایل، ارسال کوئری به پایگاه داده، اجرای تستهای نرمافزاری یا هر عملیات دیگری باشد که در قالب تابع قابل تعریف است. نمونه سادهای از آن را در ادامه مشاهده میکنید:
@tool
    def run_command(command: str) -> str:
        \"\"\"Run a build or test command in the repository root. Allowed: make [targets], python -m pytest [args].\"\"\"
return traced(\"run_command\", {\"command\": command}, lambda: ws.run_command(command))
این ساختار نشان میدهد که چگونه یک ابزار با فریمورک LangGraph در پایتون نوشته میشود؛ در این مثال، مدلی که درون پرسونا تعبیه شده امکان فراخوانی این ابزار را دارد. با دکوراتور «tool@» تابع بهعنوان ابزاری در دسترس مدل زبانی مشخص میشود و سپس مانند توابع استاندارد پایتون با «def run_command» تعریف شده و دستور بهعنوان ورودی به آن داده میشود. عبارت «str <-» در پایان نیز بیانگر آن است که این تابع یک رشته متنی را بازمیگرداند.
در ادامه، توضیحات ابزار (Docstring) قرار دارد که مدل زبانی با خواندن آن از کارکرد ابزار مطلع میشود. در این بخش به مدل اعلام میشود که میتواند دستورات بیلد یا تست را با ابزارهای make یا pytest اجرا کند. در این نمونه، تابع با یک تابع بینام (Lambda) بستهبندی شده و به سیستم ردیابی (Trace) ارسال میشود. جزییات این بخش در حال حاضر اهمیتی ندارد؛ هدف اصلی نمایش نحوه ساختاریافتن فراخوانی ابزار است.
این دستور تنها یکی از چندین ابزاری است که در اختیار ایجنت کدنویسی قرار دارد. این ایجنت میتواند فایلها را بخواند و بنویسد، کدها را ویرایش کند و با استفاده از عبارات باقاعده (Regex) درون کدها به جستجو بپردازد که همگی در قالب توابع پایتون پیاده شدهاند. با این حال، هوش مصنوعی ایجنتی اغلب با مفهوم «حلقه» (Loop) شناخته میشود، زیرا حل یک مسئله معمولاً نیازمند فراخوانی مکرر یک ابزار یا استفاده زنجیرهای از ابزارهای گوناگون است.
برای مثال، در یک پروژه پایتون اگر به مدل زبانی دستور داده شود «این اسکریپت پایتون را اشکالزدایی کن»، ایجنت ممکن است ابتدا ابزار «فهرست کردن فایلها» را صدا بزند تا فایل هدف را بیابد. سپس ابزار «خواندن فایل» را برای فهم کد فراخوانی کند یا با ابزار «جستجو در کد» نقطه شروع عیبیابی را بیابد. در مرحله بعد ابزارهای «ویرایش فایل» و «اجرای دستور» به کار گرفته میشوند و اگر ایراد برطرف نشد، ایجنت چند بار دیگر این چرخه را تکرار میکند.
این دقیقاً همان حلقه ایجنتی است؛ دستوری به مدل زبانی داده میشود، مدل موضوع را تحلیل کرده و ابزارهای لازم را فراخوانی میکند، سپس بر اساس خروجی ابزارها مجدداً وضعیت را میسنجد و در صورت نیاز ابزارهای بیشتری را به کار میگیرد تا به پاسخ نهایی برسد.
تمرکز بر پردازش همزمان
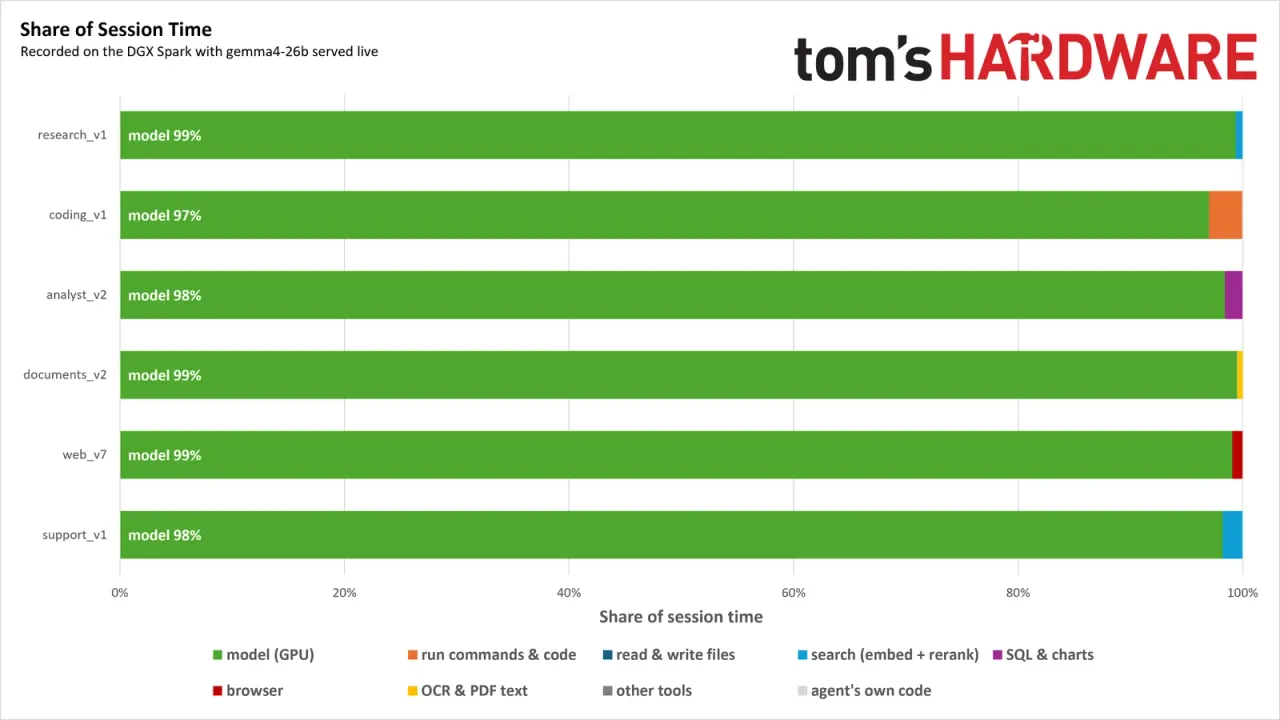
طراحی این بنچمارک بر اساس منطق مشخصی شکل گرفته است. این آزمون روی سرور انویدیا DGX Spark (GB10) مجهز به ۱۲۸ گیگابایت حافظه یکپارچه، پردازنده گرافیکی معماری Blackwell و پردازنده مرکزی نسبتاً ضعیفتر Grace مبتنی بر Arm توسعه یافته است. در نمودار بالا، زمان صرفشده برای اجرای این حلقههای ایجنتی روی سیستم GB10 با استفاده از مدل gemma4-26b-a4b نمایش داده شده است. البته نوع مدل تا زمانی که توانایی فراخوانی ابزارها را داشته باشد تفاوت بنیادینی ایجاد نمیکند، زیرا با عرضه مدلهای جدیدتر میتوان آزمونها را دوباره ضبط و بهروزرسانی کرد.
نکته کلیدی در اینجا سهم زمانی هر پردازنده است، نه خود مدل یا نوع وظیفه خاصی که ایجنتها انجام میدهند. هر نتیجه حاصل اجرای ترتیبی فهرستی از وظایف توسط ایجنت در تعامل با مدل است و تقریباً تمام این زمان در پردازنده گرافیکی (GPU) سپری میشود. حتی وظایف سنگینتر برای پردازنده مرکزی، مانند اقدامات ایجنت کدنویسی، تنها سهم ناچیزی از کل زمان محاسبات را به خود اختصاص میدهند. بنابراین اجرای یک یا چند ایجنت محدود در سیستمی که به یک پردازنده گرافیکی قدرتمند و مدلی بزرگ مجهز است، هرگز چالشی برای پردازنده مرکزی ایجاد نمیکند.
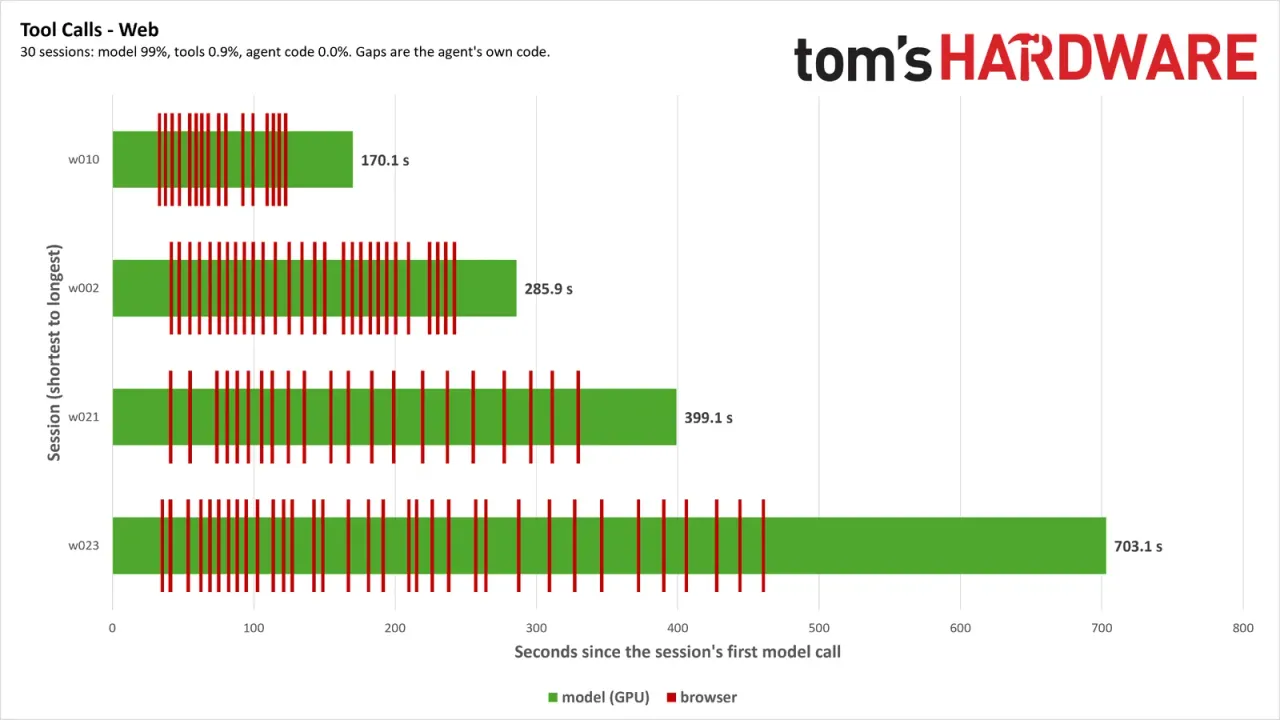
نگاهی دقیقتر به مجموعهای از این وظایف نشان میدهد که در این بازه، دستورات متعددی برای اجرا به پردازنده مرکزی محول میشود؛ اما سرعت اجرای آنها به قدری بالاست که سهم آنها در کل زمان پردازش تقریباً به چشم نمیآید.
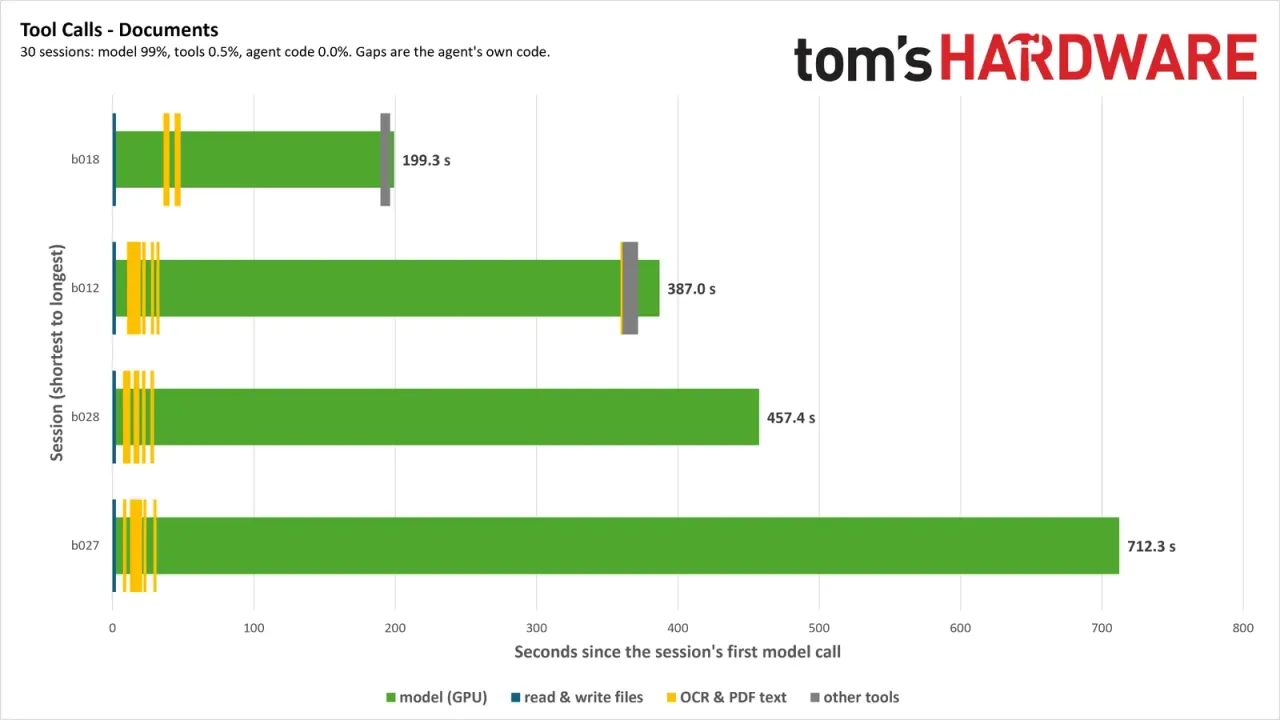
توزیع زمانی این وظایف نیز یکنواخت نیست. بسته به اینکه ایجنت چه زمانی نیاز به استفاده از ابزار پیدا کند، ساختار بار پردازشی کاملاً دگرگون میشود. برای نمونه در نمودار بالا، ایجنت اسناد که مأموریت اسکن و استخراج اطلاعات از فایلهای PDF را دارد، تقریباً تمام زمان فعالیت خود در پردازنده مرکزی را در همان آغاز کار سپری میکند و پس از آن تمام بار بر دوش استنتاج مدل در پردازنده گرافیکی قرار میگیرد.
بیتردید یک پردازنده گرافیکی قدرتمندتر مراحل استنتاج را با سرعت بالاتری پردازش میکند، اما برای اینکه بخش پردازنده مرکزی در یک حلقه ایجنتی تکی به گلوگاه سیستم بدل شود، باید ناهماهنگی بسیار شدیدی میان CPU و GPU وجود داشته باشد؛ دستکم در کار با این ابزارهای متداول چنین رخدادی بعید است. با این حال، ایجنتها صرفاً به اجرای وظایف متوالی محدود نمیشوند؛ آنها ایجنتهای فرعی ایجاد میکنند و هنگامی که چندین نشست مختلف در محیطهای ایزوله (Sandbox) روی یک سیستم بهطور همزمان فعال شوند، رقابت بر سر منابع محدود به چالشی جدی تبدیل میشود.
بهجای ایجاد عدم تعادل تصنعی میان پردازنده مرکزی و گرافیکی در محیط آزمایش، تمرکز بر پردازش همزمان (Concurrency) قرار گرفت. ایده اصلی این است که با اجرای همزمان چندین نشست از وظایف مختلف در فرآیندهای مجزا، تمام ظرفیت تراشه بررسی شود. با افزایش مقیاس این نشستها، رقابت بر سر منابع پردازنده مرکزی آشکار میشود و تفاوتهای جزئی در فراخوانی ابزارها، کامپایل و اجرای کد، وبگردی و سایر وظایف ایجنتها روی هم انباشته شده و وزن پردازشی خود را نشان میدهند.
سازوکار درونی بنچمارک
با در نظر گرفتن پردازش همزمان بهعنوان محور اصلی، میتوان ساختار داخلی بنچمارک را واکاوی کرد. معماری کلی سیستم در عین سادگی بسیار کارآمد است؛ ایجنتهای سفارشی که با فریمورک LangGraph پیادهسازی شدهاند، فهرستی شامل ۳۰ وظیفه را بهصورت متوالی روی سرور llama.cpp اجرا میکنند که در حال پردازش مدل gemma4-26b-a4b است. با این حال، درخواست ایجنتها بهجای ارسال مستقیم به سرور مدل، از یک سرور پروکسی واسط عبور میکند که وظیفه ثبت ردپا و جزییات عملیات (Trace) را بر عهده دارد.
در مرحله ضبط اولیه، ایجنت با سرور پروکسی ارتباط برقرار میکند و این پروکسی فراخوانی را به سرور llama.cpp انتقال میدهد. همزمان، سرور پروکسی تمامی درخواستهای فرستادهشده به مدل زبانی و پاسخهای دریافتی از آن را در یک فایل JSON جامع ذخیره مینماید. فراخوانی ابزارها نیز بدون درگیر کردن زنجیره سرور بهصورت مجزا در فایلهای JSON اختصاصی ثبت میشوند. در نهایت، برای هر وظیفه یک پاسخ صحیح تولید شده و پس از محاسبه هش، در فایل JSON مستقلی نگهداری میشود.
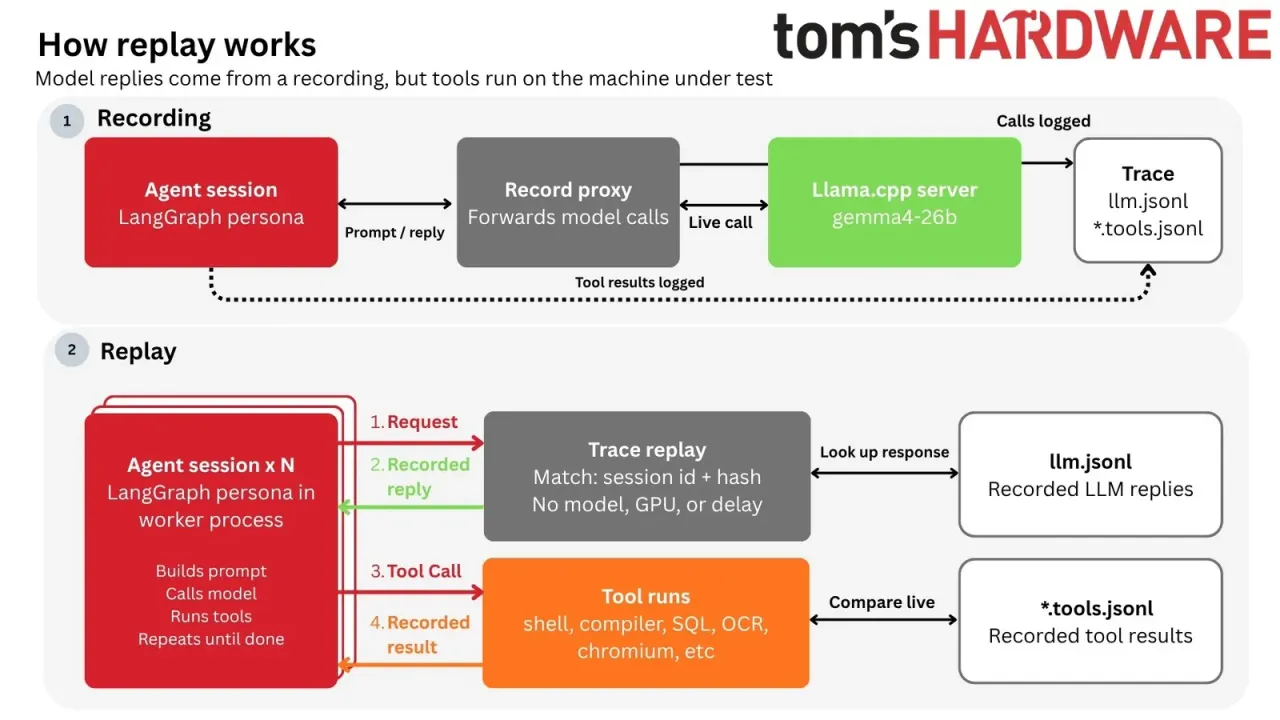
ضبط تمام جزئیات این امکان را فراهم میکند که مدل زبانی زنده بهطور کامل از چرخه تست حذف شود. ایجنتها همچنان روال عادی خود را طی میکنند، اما بهجای ارتباط با یک مدل هوش مصنوعی زنده، با سرور پروکسی تعامل دارند و دادههای از پیش ضبطشده را بازخوانی میکنند. درخواستها و فراخوانی ابزارها همگی در لحظه و زنده اجرا میشوند، اما پاسخ مدل بلافاصله از روی دادههای استنتاج ذخیرهشده به ایجنت بازگردانده میشود.
درخواست ایجنت ابتدا بر اساس برچسب نشست و مقدار هش تطبیق داده میشود تا از صحت آن اطمینان حاصل شود و سپس پاسخ متناظر در فایل JSON اصلی جستجو میشود. در صورت عدم انطباق، فرایند متوقف شده و آزمون نامعتبر شناخته میشود. اگر همهچیز دقیق باشد، پاسخ به ایجنت تحویل داده شده و ایجنت ابزارهای مورد نیازش را صدا میزند. سپس این فراخوانی ابزار با دادههای ذخیرهشده مقایسه شده و نتیجه ضبطشده به آن برگردانده میشود؛ این موضوع اهمیتی حیاتی دارد.
آزمون فراخوانی زنده ابزار را با نتیجه ضبطشده مقایسه میکند، اما همواره نتیجه ثبتشده قبلی را بازمیگرداند تا از هرگونه انحراف در جریان آزمون جلوگیری شود، حتی اگر فراخوانی زنده ابزار کاملاً درست باشد. مغایرتهای واقعی در فراخوانی ابزارها ثبت میشوند و هرچند تست به کار خود ادامه میدهد، اما سطح حاوی خطا نامعتبر علامتگذاری خواهد شد.
چنین ساختاری، بازطراحی و گسترش بنچمارک را بسیار آسان میکند. میتوان پرسوناهای جدیدی با پایتون و LangGraph تعریف کرد یا آزمون را به سایر فریمورکها نظیر CrewAI تعمیم داد. علاوه بر این، در آینده میتوان ردپای پردازشی را با مدلهای توانمندتر مجدداً ضبط کرد. ت زمانی که ارتباط از طریق درگاههای سازگار با OpenAI صورت گیرد، امکان ترکیب اجزای مختلف برای شبیهسازی طیف وسیعتری از بارهای کاری وجود خواهد داشت.
آزمون از یک فرآیند پردازشی (Worker) آغاز میشود و بهمرور تا حداکثر تعداد رشتههای پردازشی (Threads) پردازنده مرکزی ارتقا مییابد و در هر سطح سه بار تکرار میشود. هر فرآیند، فهرستی متشکل از ۳۰ وظیفه را اجرا میکند و هر فرآیند جدید از وظیفه بعدی در فهرست آغاز به کار مینماید؛ بدین ترتیب، اولین فرآیند از وظیفه یکم و دومین فرآیند از وظیفه دوم کار خود را شروع میکنند. با توجه به اینکه زمان اجرای همه وظایف یکسان نیست، این جابهجایی زمانی باعث ایجاد رقابتی نامتقارن و واقعی برای تصاحب منابع پردازنده هنگام همپوشانی وظایف میشود.
این بنچمارک چه پارامترهایی را اندازه میگیرد؟
معیار اصلی خروجی این آزمون، تعداد نشستها در ثانیه (Sessions per second) است. یک نشست به معنای اجرای کامل و سرتاسری یک وظیفه است و نرخ تکمیل این نشستها در هر ثانیه برای هر سطح همزمانی محاسبه میشود. طبیعی است که در سطوح همزمانی پایین، تعداد نشستها در ثانیه کمتر بوده و حتی گاهی به زیر ۱ میرسد که نشان میدهد انجام هر وظیفه بیش از یک ثانیه طول کشیده است. با افزایش تعداد نشستهای همزمان، تفاوت رفتار و تفکیک تراشهها آشکار میشود و میزان توان خروجی و پهنای باند پردازشی پردازنده مرکزی در اجرای فعالیتهای ایجنتی مشخص میگردد.
از این ارزیابی دو امتیاز اصلی استخراج میشود؛ نخستین شاخص «حداکثر توان پردازشی» (Peak Throughput) است که بالاترین رکورد نشستهای تکمیلشده در ثانیه و سطح همزمانی متناظر با آن را نشان میدهد. شاخص دوم «توان پردازشی ایدهآل» (Ideal Throughput) نام دارد که نشاندهنده نقطهای است که در ۹۵ درصد سناریوها، مدت زمان اجرای نشستها حداکثر ۱٫۵ برابر زمان اجرای یک نشست تکی در سطح پایه باشد. طبیعی است که با افزایش تعداد نشستها، مدت اجرای وظایف بیشتر شود، اما فراتر از این آستانه ۱٫۵ برابری، زمان تکمیل کارها بهشدت طولانی شده و بسته به ساختار معماری پردازنده، افت محسوس کارایی آغاز میشود.
باید یادآوری کرد که در این ارزیابی همزمانی، هیچگونه تاخیری از جانب پردازنده گرافیکی دخیل نیست. با حذف کامل پردازنده گرافیکی از چرخه، بیشترین بار پردازشی همزمان ممکن به پردازنده مرکزی وارد میشود تا نقطه اوج توان آن مشخص گردد. با این حال پردازنده گرافیکی نقشی تعیینکننده در دنیای واقعی ایفا میکند و این آمار باید در بستری واقعبینانه تحلیل شوند.
با افزایش تعداد ایجنتهای فعال روی پردازنده مرکزی، رقابت برای تصاحب منابع داخلی تراشه بالا میگیرد، اما این موازنه بهراحتی میتواند تغییر یابد. اگر پردازنده گرافیکی توان کافی نداشته باشد، ایجنتها در صف انتظار پردازش معطل میمانند و این امر مانع از بهرهبرداری کامل از توان هر دو پردازنده میشود. این شیوه ارزیابی هرچند از محاسبات تئوری و فرضی بسیار فراتر میرود، اما همچنان شبیهسازی کامل یک سیستم یکپارچه نهایی نیست؛ چراکه در یک محیط واقعی، متغیرهای فراوانی وجود دارند که استخراج نتایج استاندارد و تعمیمپذیر را ناممکن میسازند.
با این حال میتوان این ارزیابی را همراه با استنتاج زنده نیز اجرا کرد تا کارایی در سطح کل سیستم سنجیده شود. در آزمایشهای زنده، برای حفظ یکپارچگی و برابری شرایط تست، پاسخهای دادهشده به ایجنتها کماکان از دادههای از پیش ضبطشده تأمین میشوند، اما سرور llama.cpp درخواست را ثبت کرده و دقیقاً همان تعداد توکن را تولید و سپس رها میکند. این سازوکار تمام مراحل خط لوله استنتاج استاندارد شامل مراحل پیشتکمیل (Prefill)، رمزگشایی (Decode)، عملکرد حافظه کَش و حتی معطلی ایجنتها در صف انتظار را شبیهسازی میکند.
هر دو داده ارزشمند هستند؛ ارزیابی زنده تصویری دقیق و واقعگرایانه از هوش مصنوعی محلی در سطح کل سیستم ارائه میدهد، در حالی که بازخوانی دادههای از پیش ضبطشده، سقف توان پردازنده مرکزی را در شرایطی که هیچ کمبودی از نظر قدرت پردازش گرافیکی وجود نداشته باشد، میسنجد.
پرسوناهای اولیه ایجنتها در بنچمارک
در این پروژه شش پرسونای مختلف برای ایجنتها تعریف شده است. یک «پرسونا» در واقع اسکریپتی به زبان پایتون است که با LangGraph توسعه یافته و محدوده توانمندیهای ایجنت را مشخص میکند. فراخوانی ابزارها توسط ایجنت در قالب توابع پایتون تعریف شدهاند که گرههای LangGraph را به یکدیگر پیوند میدهند. هر پرسونا فهرستی اختصاصی از وظایف متکی بر اسناد محلی را دنبال میکند؛ برای مثال، پرسونای پژوهشگر توانایی پاسخ به پرسشها از طریق کاوش در مجموعهای شامل حدود ۵۰ هزار مقاله از ویکیپدیا را دارد.
پرسونا | وظایف فرعی | شرح عملکرد | ابزارها |
|---|---|---|---|
تحلیلگر (Analyst) | برنامهریز، تحلیلگر، نویسنده | پاسخ به پرسشهای مرتبط با یک شرکت خردهفروشی فرضی با استفاده از کوئریهای SQL در پایگاه داده DuckDB و نگارش گزارش نهایی. | فهرست جداول، شرح جداول، اجرای کوئری SQL، رسم نمودار از خروجی کوئری |
کدنویسی (Coding) | برنامهنویس، بازبین کد | رفع باگ در یکی از چهار پروژه آزمایشی (دو پروژه C و دو پروژه پایتون) بر اساس گزارش خطا. | فهرست فایلها، خواندن فایل، جستجو در کد، ویرایش فایل، اجرای دستور، بررسی نتایج تست |
اسناد (Documents) | دریافت، استخراج داده، حسابرس | اسکن سفارشهای خرید، فاکتورها و سایر اسناد حسابداری و تطبیق صورتحسابها با سفارشهای خرید. | فهرست اسناد، استخراج متن از PDF، استخراج جداول از PDF، ابزار Tesseract OCR، محاسبات پایه ریاضی |
پژوهشگر (Research) | برنامهریز، محقق، نویسنده | جستجو در بایگانی محلی مقالات انگلیسی ویکیپدیا برای پاسخگویی به پرسشها. | جستجو در پایگاه مقالات |
پشتیبانی (Support) | تریاژ و دستهبندی، محقق، پاسخدهنده | پاسخ به تیکتهای پشتیبانی یک شرکت فرضی با استفاده از پایگاه دانش داخلی. | جستجو در پایگاه دانش، مطالعه مقالات |
وبگردی (Web) | برنامهریز، ایجنت مرورگر، نویسنده | یافتن محصولاتی با معیارهای مشخص در یک نشست بدون رابط کاربری (Headless) در مرورگر Chromium. | باز کردن نشانی وب، کلیک روی المان، وارد کردن متن، انتخاب گزینهها، بازگشت به صفحه قبل، ادامه خواندن صفحه |
جدول بالا نمای کلی هر یک از این پرسوناها را نشان میدهد. در پنج مورد از این شش پرسونا، کار ابتدا با مرحله برنامهریزی آغاز میشود، سپس حلقه اصلی ایجنت به جریان میافتد و در نهایت گزارشی تدوین میگردد. بهعنوان نمونه در پرسونای تحلیلگر، بخش برنامهریز پرسشها را دریافت کرده و به خروجیهای ساختاریافته در قالب دو تا چهار مرحله تقسیم میکند؛ سپس تحلیلگران بهصورت موازی پایگاه داده را کاوش کرده و در نهایت نویسنده، یافتهها را به پاسخی منسجم تبدیل میکند.
تنها استثنا در این میان، پرسونای کدنویسی است که سازوکار متفاوتی دارد. این ایجنت روی چهار پروژه کار میکند و هدفش رفع باگ بر اساس گزارش خطا (مشابه ایشوهای گیتهاب) است. بخش کدنویس باگ را شناسایی کرده و با اجرای تستهای مختلف صحت راهکار را میسنجد؛ در ادامه، کد برای بازبینی ارسال شده و پس از تأیید نهایی اعمال میشود.
در پیکربندی فعلی، تمام پرسوناها با وظایف تکمرحلهای (Single-turn) سنجیده میشوند. با وجود اینکه ایجنتها بسته به نوع کار چندین بار به مدل هوش مصنوعی مراجعه کرده و مکرراً از ابزارها استفاده میکنند، اما تمام این فرآیند برای حل یک مسئله مجزا و بدون اتکا به سوابق قبلی صورت میگیرد. بهعنوان مثال در مواجهه با پرسش پشتیبانی، ایجنت ممکن است چندین بار پایگاه دانش را زیرورو کند؛ اما پس از ارائه پاسخ و حرکت به سمت درخواست بعدی، وظیفه جدید بهعنوان اقدامی کاملاً مستقل و بدون پیشزمینه قبلی پردازش میشود.
این ساختار نمایانگر تمامی سناریوهای ایجنتی نیست، زیرا در دنیای واقعی بخش زیادی از فرایندها بهشکل چندمرحلهای انجام میشوند. امکان تعریف وظایف چندمرحلهای وجود دارد، اما این کار خطر انحراف مدل از مسیر اصلی و حتی از کار افتادن برنامه را بهشدت بالا میبرد. در اجرای محلی، تنها چند رفتوبرگشت پیچیده کافی است تا پنجره زمینه (Context Window) مدل پر شود. اجرای چنین فرایندی شدنی است، اما در حال حاضر در اولویتهای نخست این پروژه قرار ندارد.
مرور تمام وظایف پرسوناهای فعلی فراتر از حوصله این مطلب است؛ با این حال بررسی نمونهای از عملکرد هر پرسونا تصویر شفافی از آنچه در پشت صحنه میگذرد فراهم میسازد.
پرسونا | نمونه وظیفه | منبع حقیقت و دادهها |
|---|---|---|
تحلیلگر (Analyst) | «تخفیفها چگونه حاشیه سود ناخالص را در دستهبندیهای مختلف تحت تأثیر قرار میدهند؟» | انبار داده DuckDB |
کدنویسی (Coding) | پروژه فاکتور: انتقال موعدهای پرداخت روز شنبه به یکشنبه بهجای دوشنبه | ابزارهای PyTest و make |
اسناد (Documents) | تأیید فاکتورهای صحیح سفارشهای خرید بر اساس قیمت از میان شش سند در چهار اسکن مختلف | فاکتورهای جعلی PDF، سفارشهای خرید و رسیدهای انبار حاوی خطاهای ساختگی |
پژوهشگر (Research) | «چه عواملی موجب زلزله میشوند و مقیاس سنجش آنها چیست؟» | پایگاه مقالات انگلیسی ویکیپدیا با ۵۰ هزار مقاله |
پشتیبانی (Support) | «مدت زمان اعتبار کدهای تأیید دومرحلهای چقدر است؟» | پایگاه دانش یک شرکت فرضی خانه هوشمند |
وبگردی (Web) | یافتن کولهپشتی ۵۵ لیتری با بالاترین امتیاز و سبکترین کفش ضدآب | وبسایت محلی یک فروشگاه لوازم طبیعتگردی |
سایر وظایف نیز رویکردی مشابه دارند. بهعنوان مثال، پرسونای اسناد همواره در پی تأیید فاکتورهای معتبر است، اما ترکیب مدارک و خطاهای تعبیهشده در هر نوبت تغییر میکند. پرسونای پشتیبانی نیز همواره پاسخگوی تیکتهاست، با این تفاوت که گاهی خطاهای نرمافزاری را عیبیابی میکند، گاهی سیاستها و قوانین را توضیح میدهد و گاه در قالب یک پیام به چند پرسش همزمان پاسخ میگوید که ایجنت را ناچار به تجمیع اطلاعات از بخشهای مختلف پایگاه دانش میسازد.
نقاط ضعف و چالشهای رویکرد فعلی
با وجود تلاش برای پوشش دامنه وسیعی از بارهای کاری ایجنتی، نسخه فعلی این بنچمارک با محدودیتهایی روبهرو است. مهمترین کاستی به این بازمیگردد که دادهها و الگوهای فعلی تنها از دو پیکربندی سختافزاری استخراج شدهاند؛ یک سیستم آزمایشی مجهز به پردازنده ۶۴ هستهای Threadripper با ۱۲۸ گیگابایت حافظه رم DDR5-6000 RDIMM و یک سرور DGX Spark.
با ورود سایر پلتفرمها به چرخه آزمایش، ممکن است بازنگری در طراحی تستها، ضبط مجدد الگوها یا تغییر مدل زبانی اجتنابناپذیر شود که این امر به جمعآوری مجدد تمام دادهها نیاز خواهد داشت. این تنوع پلتفرم صرفاً به پردازندههای اینتل محدود نمیشود؛ از خوشههای مک استودیو گرفته تا ایستگاههای کاری سنگین با چندین پردازنده گرافیکی، چیدمانهای متفاوتی برای پردازش محلی هوش مصنوعی وجود دارد. بار کاری تحمیلشده بر پردازنده مرکزی بسته به توان پردازنده گرافیکی، نوع مدل، سطح کوانتایزیشن و تنظیمات سرور تغییرات چشمگیری را تجربه میکند.
محدودیت دیگر به عملکرد رابطهای برنامهنویسی کاربردی (API) مربوط میشود. این آزمون به گونهای طراحی شده که امکان اتصال آسان به مدلهای آزمایشگاههای پیشرو از طریق API را فراهم میسازد. در این شرایط، هرچند مدل اصلی روی ابر پردازش میشود، اما ابزارها کماکان بهصورت محلی روی سختافزار کاربر اجرا میشوند، مگر اینکه کل سیستم در فضایی کاملاً ابری مستقر باشد. برای مثال در یک جریان کدنویسی با هوش مصنوعی روی لپتاپی اقتصادی، تمام فرایندهای کامپایل، اجرای تست و کدهای ایجنت روی سیستم شخصی کاربر پردازش میشوند.
با اینکه برنامههایی برای سنجش این مدل ترکیبی (سیستم محلی معمولی در کنار API ابری) تدوین شده، اما در مراحل نخستین توسعه بررسی عمیقی روی آن صورت نگرفت؛ زیرا هزینه استفاده از API مدلها بالاست و صرف بیرویه توکنها در مرحله پیکربندی اولیه بنچمارک توجیه اقتصادی نداشت.
در نهایت، مسئله ایزولهسازی محیط (Sandboxing) مطرح است. در نگارش کنونی، آزمونها درون ایمیج داکر (Docker) ایزوله شدهاند که در مقایسه با اجرای مستقیم روی سختافزار خام کمتر از ۲ درصد سربار پردازشی ایجاد میکند. با این حال، بررسی اثر روشهای دیگر ایزولهسازی ایجنتهای محلی، حوزهای است که باید در آینده مورد ارزیابی دقیقتری قرار گیرد.
چشمانداز و گامهای آینده
هوش مصنوعی مبتنی بر ایجنت با چنان سرعتی تحول مییابد که هر متخصص ممکن است تعریفی متفاوت از بارهای کاری ایجنتی و سختافزارهای مناسب آن ارائه دهد. با در نظر گرفتن دگرگونی پیاپی مدلها و سختافزارها، بدیهی است که نمیتوان بنچمارکی نفوذناپذیر ساخت که برای همیشه بینقص باقی بماند. چنین تصوری واقعبینانه نیست؛ آنچه امروز پایهگذاری شده تنها نقطه آغازی است که بهمرور ارتقا خواهد یافت.
در مرحله کنونی، گام بعدی استخراج نخستین دادههای واقعی از عملکرد سختافزارها است. تاکنون آزمایشهایی ابتدایی برای اطمینان از عملکرد صحیح سیستم انجام شده است (نظیر اجرای نسخه بدون قفل مفسر یا Free-threaded پایتون به منظور ارزیابی تأثیر قفل سراسری مفسر GIL در یک نشست)، اما تمرکز اصلی این پروژه تاکنون بر پیادهسازی زیرساخت ثبت ردپاها و بازخوانی مجدد آنها استوار بوده است.
همچنین این سامانه در حال حاضر بهطور کامل به فریمورک LangGraph متکی است. بررسی سایر فریمورکها مانند CrewAI و ابزارهای سریع با راهاندازی تککلیکی نظیر Hermes و OpenClaw از جمله برنامههای پیش رو در توسعه این بنچمارک خواهند بود.
مطالب مرتبط و پیشنهادی
رشد ۷۰ درصدی درآمد Unitree در نخستین گزارش مالی پس از ورود به بورس
شرکت چینی Unitree، سازنده سرشناس رباتهای انساننما و چهارپا، در نخستین گزارش مالی خود پس از ورود به بورس از رشد نزدیک به ۷۰ درصدی درآمد سهماهه سوم خبر داد. این شرکت همزمان با افزایش چشمگیر بودجه تحقیق و توسعه، در حال گسترش فعالیتهای خود از سختافزار به مدلها و نرمافزارهای هوش مصنوعی تجسمیافته است.
OpenAI تا ۵۰۰ دلار اعتبار ماهانه API به مشترکان ChatGPT Pro اختصاص میدهد
شرکت OpenAI ارائه اعتبار ماهانه API را برای مشترکان واجد شرایط ChatGPT Pro و حسابهای تجاری آغاز کرد. کاربران بر اساس طرح اشتراکی خود میتوانند ماهانه تا سقف ۵۰۰ دلار برای فراخوانی مدلها از پلتفرم توسعهدهندگان استفاده کنند. این اقدام گامی مهم برای پیوند زدن سیستمهای پرداخت مجزای اشتراک گفتگو و دسترسی به API محسوب میشود.
تنسنت مدلهای جدید Hy4 و Hy4 flash را با قابلیت درک بصری عرضه میکند
تنسنت بهزودی مدلهای هوش مصنوعی Hy4 و Hy4 flash را با قابلیت درک بصری به سبد محصولات خود اضافه میکند. این مدلهای جدید با تمرکز بر استدلال مداوم، کاهش هزینهها و پشتیبانی از ایجنتهای هوشمند طراحی شدهاند تا عملکرد ابزارهای کاربردی را ارتقا دهند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.