نسخه جدید دیپسیک V4.1 Flash معرفی شد؛ جهش خیرهکننده در کاهش مصرف حافظه و چالش توهم
دیپسیک با انتشار نسخه جدید مدل وزنباز V4.1 Flash، مصرف حافظه HBM و فضای ذخیرهسازی را بهشکل چشمگیری کاهش داده و هزینههای اجرای ایجنتها را به حداقل رسانده است. بااینحال، ارزیابیهای فنی نشان میدهند که این سرعت سرسامآور و قیمت فوقالعاده ارزان، به بهای نرخ نگرانکننده توهم در پاسخها تمام شده است.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- نسخه بهروزشده V4.1 Flash تنها به یکچهارم حافظه HBM و یکهشتم حافظه SSD برای کَش نسبت به نسل قبل نیاز دارد.
- هزینه پردازش مدل در ساعات خلوت به ۰٫۱۵ دلار بهازای هر میلیون توکن ورودی میرسد که اجرای ایجنتهای هوش مصنوعی را بسیار اقتصادی میکند.
- در بنچمارک Omniscience، این مدل در ۶۷ درصد از موارد عدم قطعیت دچار توهم شد که استفاده از آن را برای پژوهشهای حساس محدود میکند.
دیپسیک بهتازگی مدل وزنباز V4.1 Flash را با انتشار بازنگری ۱۰۱۷ بهروزرسانی کرده است؛ ارتقایی که شاید در ظاهر صرفاً یک ویرایش جزئی بهنظر برسد، اما در عمل گامی چشمگیر در بهبود بهرهوری مدل به شمار میرود. شرکت دیپسیک در صفحه رسمی محصول از شعار «تحقق برنامهنویسی مبتنی بر آرزو» استفاده کرده است که احتمالاً به مفهوم عامیانه «vibe coding» اشاره دارد و نشان میدهد این مدل گزینهای بسیار مناسب برای انجام کارهای چندمرحلهای با توضیحات کلی است. بااینحال، هرچند این مدل بهشدت ارزانقیمت است و امتیازهای بالایی کسب میکند، اما پتانسیل بالایی برای تولید توهم دارد.
مدلهای زبانی بزرگ را بهطور کلی میتوان به دو دسته تقسیم کرد: مدلهای تجاری و انحصاری توسعهیافته در آزمایشگاههای پیشرو که هزینه اجرای بسیار بالایی دارند اما نتایجی بینقص ارائه میدهند، و رقبای وزنباز چینی که تا حد زیادی قابلیت اطمینان را فدای هزینههای اجرای بسیار ارزانتر، بهویژه در وظایف طولانی ایجنتها، کردهاند.
مدل Deepseek V4.1 Flash (بهاختصار DSF) از معماری ترکیبی از متخصصان (MoE) بهره میبرد و در مجموع ۵۵۲ میلیارد پارامتر دارد که ۱۶ میلیارد پارامتر آن هنگام تولید پاسخ (استنتاج) فعال هستند. این مدل چندوجهی توانایی پردازش همزمان متن و تصویر را بهعنوان ورودی دارد و طول پنجره زمینه (کانتکست) آن نیز به استاندارد این روزهای دنیای هوش مصنوعی، یعنی ۱ میلیون توکن میرسد.
طبق بنچمارکهای داخلی دیپسیک، این مدل جایگاهی دقیقاً میان GPT-5.6 Sol و Claude Opus 5 پیدا میکند و حتی در برخی آزمونهای عملکردی موفق شده مدل زبانی آنتروپیک را پشت سر بگذارد. این دستاورد فینفسه عملکردی قدرتمند بهحساب میآید، اما درخشش اصلی این ویرایش جدید DSF در نسبت عملکرد به هزینه و بازدهی مصرف توکن است. ارتقا از V4 Flash به V4.1 Flash نیازهای سختافزاری را بهشدت کاهش داده است؛ طوریکه نسخه ۴٫۱ برای کَش کلید-مقدار (KV cache) در مقایسه با نسل قبلی خود، تنها به یکچهارم حافظه HBM و یکهشتم حافظه ذخیرهسازی SSD نیاز دارد و برای هر ورودی توکن فقط ۸۹۰ بایت مصرف میکند.
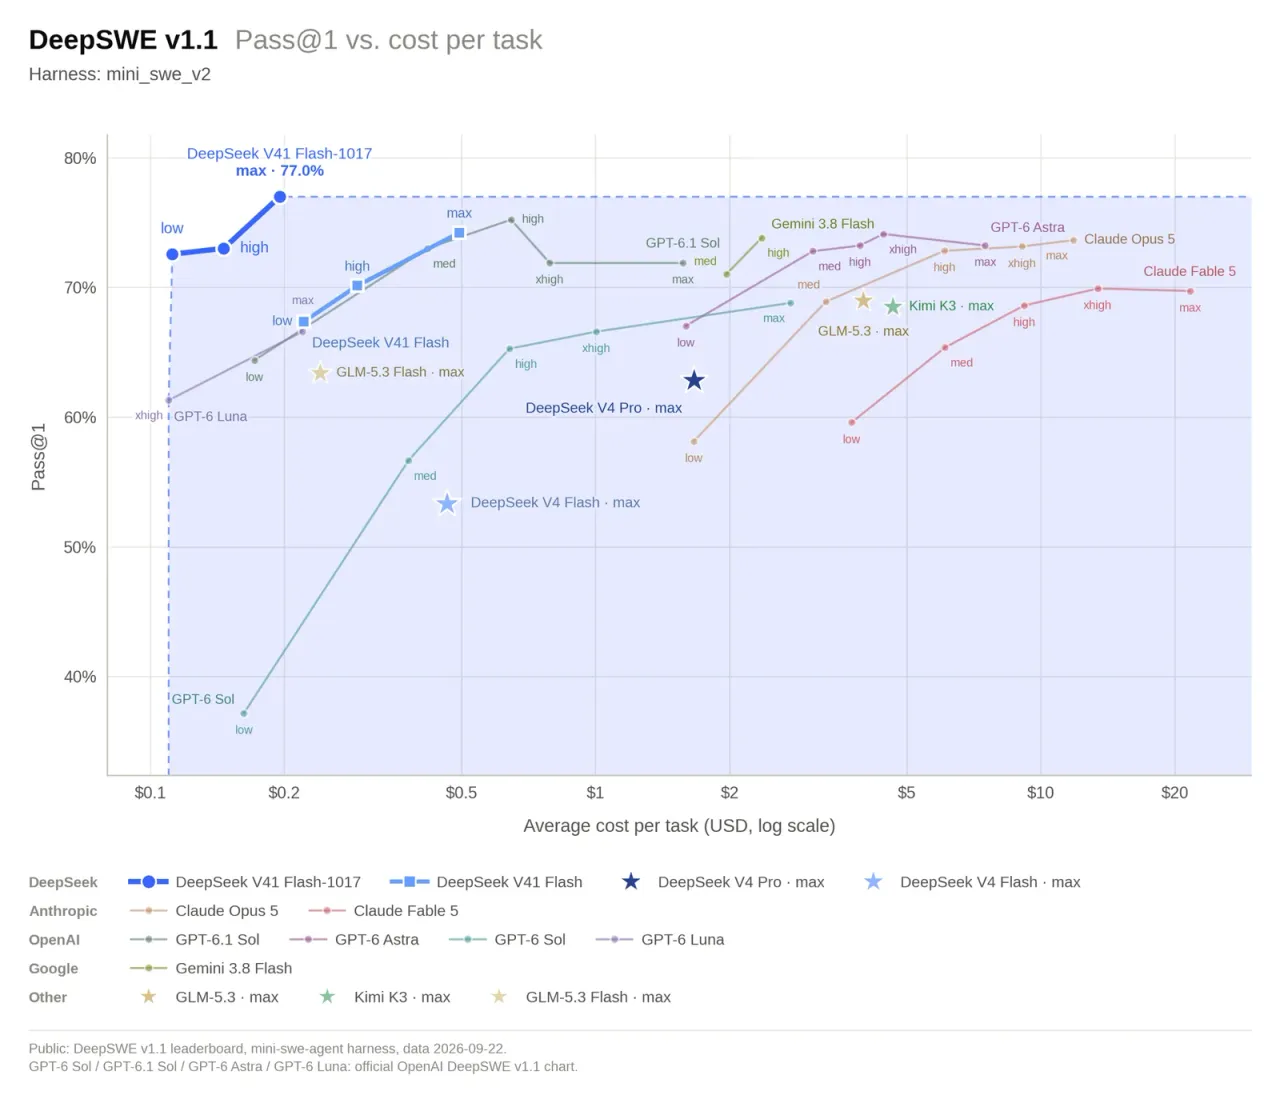
دیپسیک برای اثبات این ادعا، نموداری از هزینه بهازای هر تسک را بر پایه مجموعهداده DeepSWE (مربوط به ۲ سپتامبر) منتشر کرده و دادههای مربوط به دو نسخه DSF و DSF-1017 را در آن گنجانده است. هر دو نسخه در ناحیه مطلوب بالا و سمت چپ نمودار جای گرفتهاند و حتی در سناریوهای با بار پردازشی پایین، نسخه DSF-1017 نرخ تکمیل تسکی نزدیک به بالاترین تنظیمات (Max) رقبای گرانقیمت خود به ثبت میرساند. اگرچه DeepSWE تنها یکی از بنچمارکهای متعدد موجود است، اما ثبت چنین نتیجهای همچنان فوقالعاده چشمگیر محسوب میشود.
حتی بر اساس قیمتگذاری رسمی خود دیپسیک (فراموش نکنید که با مدلی وزنباز روبهرو هستیم و میتوانید آن را روی هر سروری میزبانی و اجرا کنید)، هزینه هر یک میلیون توکن در ساعات خلوت تنها ۰٫۱۵ دلار برای ورودی و ۰٫۶ دلار برای خروجی است. در صورت پاسخگویی از طریق کَش (Cache Hit)، هزینه توکن ورودی تا رقم شگفتانگیز ۰٫۰۰۳ دلار کاهش مییابد. علاوه بر این، ارائهدهندگان متفرقه ابری پیش از این هم سرویسهای خود را ارزانتر از API دیپسیک عرضه کرده بودند؛ بنابراین اگر به سراغ ارائهدهندگان خدمات استنتاج بروید، احتمالاً به ارقام پایینتری هم دست خواهید یافت. دیپسیک همچنین قابلیت جستجو را با هزینه ۰٫۷۵ دلار بهازای هر ۱۰۰۰ درخواست ارائه میدهد؛ رقمی که بسیار کمتر از رقباست و نزدیکترین رقیب آن، یعنی پلتفرم Parallel، این خدمات را با قیمت ۱ دلار ارائه میکند.
البته DeepSWE تنها معیار سنجش نیست. مؤسسه Artificial Analysis در شاخص هوشمندی مدلهای وزنباز بزرگ، مدل DSF-1017 (تنظیمات Max) را با کسب امتیاز ۴۵ در رتبه دوم قرار میدهد. برای مقایسه، هوشمندترین مدل فعلی یعنی Claude Opus 5.5 (در حالت Max با بازگشت خطا) امتیاز ۵۸ را به دست آورده است. نسخه جدید دیپسیک همچنین یکی از سریعترین مدلها در دسته خود محسوب میشود و از نظر کمترین هزینه بهازای هر تسک، تنها مدل MiMo V2.6-Pro ساخت شیائومی توانسته است آن را پشت سر بگذارد.
شاید تمام این آمار و ارقام بیش از حد ایدهآل به نظر برسند، اما ضربالمثل معروف دنیای مهندسی را به یاد داریم: «از میان سرعت، ارزانی و قابلیت اطمینان، فقط دو تا را میتوانید انتخاب کنید». پس ماجرا چیست و برگ برنده کجاست؟ پاسخ در یک کلمه خلاصه میشود: توهم هوش مصنوعی. هوشمند بودن یک مدل لزوماً بهمعنای قابل اعتماد بودن آن نیست. کاربران عموماً ترجیح میدهند وقتی مدل فکت و سندی برای یک ادعا ندارد، پاسخی ندهد؛ اما بهنظر میرسد DSF-1017 توانایی چندانی در درک نادانستههای خود ندارد.
بنچمارک Omniscience مؤسسه Artificial Analysis این واقعیت را بهروشنی آشکار میکند و این مدل را در زمره ضعیفترین گزینهها قرار میدهد. مدل دیپسیک در ۴۳ درصد مواقع به سؤالات پاسخ درست داده که هرچند در میان مدلهای وزنباز رتبه بالایی است، اما هنوز با رقبای تجاری و انحصاری فاصله زیادی دارد. اگر مدل پاسخهای فاقد مدرک را نادیده میگرفت، این نتیجه کاملاً قابل قبول بود؛ اما مشکل اینجاست که در ۶۷ درصد از پاسخهای نامطمئن، مدل دست به تولید توهم زده است.
در شاخص اصلی این بنچمارک، پاسخهای درست امتیاز مثبت دارند، پاسخهای اشتباه جریمه میشوند و بیپاسخ گذاشتن سؤالات هیچ امتیازی کسر نمیکند. مدل DSF-1017 در این ارزیابی تنها ۵ امتیاز کسب کرده، درحالیکه مدل Kimi K3-max موفق به دریافت ۲۰ امتیاز شده و مدلهای پیشرو امتیازی بالاتر از ۴۲ به ثبت رساندهاند. در نهایت، این نتایج به این معنا نیست که DSF-1017 مدلی ضعیف و ناکارآمد است؛ بلکه برعکس، توانایی بسیار بالایی دارد اما توسعهدهندگان باید در سپردن مأموریتها به آن وسواس و دقت به خرج دهند.
وظایفی که خروجیهای آنها قابل راستیآزمایی است—مانند برنامهنویسی، تبدیل فرمتها و نویسهخوان نوری (OCR) بههمراه بازبینی انسانی—گزینههایی ایدهآل برای این مدل هستند؛ چراکه ایجنت میتواند خروجی کار خود را اعتبارسنجی کند و در صورت بروز خطا دوباره تلاش کند. بااینحال، پژوهشهای باز و نامحدود، جستجوی فکتها و نگارش یا تفسیر اسناد فوقالعاده حساس، کارهایی هستند که برای مدلهای مرجع پیشتاز، یا حتی نیروی انسانی، مناسبترند؛ زیرا توهمهای مدل در این زمینهها مهار نمیشوند و نتایج حاصله قابل اتکا نخواهند بود.
رویکرد «سریع اما با دقت فداشده» ظاهراً به روندی تازه در میان مدلهای وزنباز بسیار قدرتمند تبدیل شده است. چند ماه قبل، هنگام عرضه مدل Kimi K3، همه از کارایی بالا و قیمت ناچیز آن شگفتزده شدند؛ مدلی که مدعی بود هوشمندی همتراز با پرچمداران را با کسری از هزینه آنها عرضه میکند. بااینحال، تجربیات عملی کارشناسان با Kimi نشان داد که جذابیت اولیه چندان پایدار نیست؛ چراکه مدل حتی در پاسخ به فکتهای کوتاه و دقیق نیز اطلاعات ساختگی تولید میکرد و آمارهای مؤسسه Artificial Analysis نیز مهر تأییدی بر همین مشاهدات میزند.
با تمام این اوصاف، مدلهای وزنباز همچنان نقشی حیاتی در صنعت ایفا میکنند؛ این مدلها هم دسترسی به ایجنتهای هوش مصنوعی را با هزینههایی بسیار پایینتر برای همگان ممکن میسازند و هم بهعنوان ابزاری قدرتمند برای شکستن انحصار و مهار قیمتها در برابر افزایش احتمالی تعرفه آزمایشگاههای پیشرو عمل میکنند.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
مدیر فناوری کپیتال وان: بهترین هوش مصنوعی سازمانی سیستمی است که کارمندان اصلاً متوجه حضورش نشوند
مدیر ارشد فناوری سازمانی در کپیتال وان توضیح میدهد که چرا ابزارهای هوش مصنوعی بهجای تحمیل پرامپتها و رابطهای کاربری پیچیده، باید در پسزمینه محو شوند. بهباور او، هوش مصنوعی زمانی در سازمانها موفق است که اصطکاک کاری را حذف کند و میدان را برای قضاوت تخصصی کارکنان باز بگذارد.
ورود ایجنتهای هوش مصنوعی به بازار ۸۰ تریلیون دلاری؛ نقشه مسترکارت برای تسویه خودکار خریدها
مسترکارت با توسعه ابزارهای تحلیلی و پروتکلهای امنیتی نوین، درصدد است خریدهای بینشرکتی B2B را به ایجنتهای هوش مصنوعی بسپارد. این غول پرداخت با همکاری غولهای فناوری میکوشد ریسک خطاهای مالی نرمافزارها را کاهش دهد و سهم قابلتوجهی از این بازار ۸۰ تریلیون دلاری کسب کند.
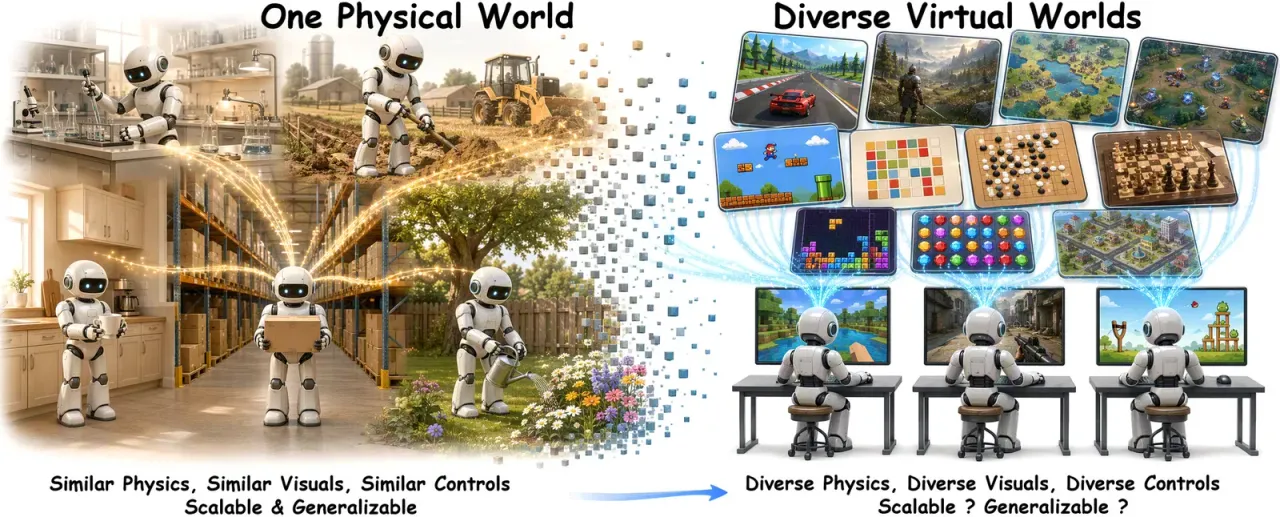
مدلهای هوش مصنوعی GameScaling متنباز شدند؛ کنترل بازیها تنها با ماوس و کیبورد
پژوهشگران هوش مصنوعی شرکت میهویو با همکاری محققان دانشگاهی، خانواده مدلهای GameScaling را بهصورت متنباز منتشر کردند. این مدلها با تحلیل فریمهای بصری بازیها، فرمانهای حرکتی ماوس و کیبورد را شبیهسازی کرده و عناوینی مانند ماینکرفت و دووم را بهطور خودکار اجرا میکنند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.