مدل کمحجم USER2 با ۱۴۹ میلیون پارامتر، رقبای ۷ میلیاردی را در جستجوی زبان روسی شکست داد
تیم DeepVK از مدل زبانی USER2-base با ۱۴۹ میلیون پارامتر برای پردازش و درک جملات به زبان روسی رونمایی کرد. این انکودر کمحجم با پشتیبانی از ورودیهای طولانی تا ۸ هزار توکن، عملکردی فراتر از مدلهای بسیار بزرگتر ثبت کرده است. بهینهسازی پیشرفته این مدل به توسعهدهندگان امکان میدهد هزینههای ذخیرهسازی برداری و جستجوی معنایی را بهشکل چشمگیری کاهش دهند.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- تیم DeepVK مدل کمحجم USER2-base را با ۱۴۹ میلیون پارامتر و پشتیبانی از متون طولانی تا ۸۱۹۲ توکن برای جستجوی معنایی زبان روسی منتشر کرد.
- این مدل با تکیه بر روش یادگیری ماتریوشکا امکان تولید بردارها در هفت اندازه مختلف از ۳۲ تا ۷۶۸ بعد را فراهم میکند تا هزینههای ذخیرهسازی و جستجو کاهش یابد.
- مدل USER2-base در ارزیابیهای استاندارد زبان روسی امتیازی بالاتر از مدلهای چندزبانه ثبت کرده و بازدهی نزدیک به مدلهای غولپیکر با پارامترهای بسیار بیشتر ارائه میدهد.
تیم DeepVK از مدل USER2-base رونمایی کرد؛ یک انکودر جملات زبان روسی که بر پایه معماری RuModernBERT توسعه یافته است. این مدل از ورودیهایی با طول حداکثر ۸۱۹۲ توکن پشتیبانی میکند و امبدینگهایی با هفت بعد مختلف و قابل انتخاب تولید مینماید. علاوه بر این، نسخه سبکتر USER2-small با ۳۴ میلیون پارامتر نیز برای کاربردهایی با محدودیت شدید حافظه و تاخیر زمانی منتشر شده است.
مدل USER2-base با ۱۴۹ میلیون پارامتر، گزینهای بسیار کمحجم و بهینه را در اختیار توسعهدهندگان قرار میدهد تا از آن در جستجوی معنایی زبان روسی، تولید مبتنی بر بازیابی (RAG)، خوشهبندی و سنجش شباهت متن استفاده کنند. این مدل با شیوه «یادگیری بازنمایی ماتریوشکا» (Matryoshka Representation Learning) آموزش دیده است؛ رویکردی که به یک مدل واحد اجازه میدهد بردارهایی کاربردی با ابعاد ۳۲ تا ۷۶۸ تولید کند و بدین ترتیب، هزینههای ذخیرهسازی برداری و محاسبات جستجو را بدون نیاز به آموزش چندین انکودر جداگانه بهشدت کاهش دهد.
۱۴۹ میلیون پارامتر و پشتیبانی از ورودی ۸ هزار توکنی
- مدل پایه (Backbone): RuModernBERT-base
- تعداد پارامترها: ۱۴۹ میلیون
- حداکثر طول ورودی: ۸۱۹۲ توکن برای هر متن
- ابعاد امبدینگ: ۳۲، ۶۴، ۱۲۸، ۲۵۶، ۳۸۴، ۵۱۲ و ۷۶۸
- مجوز: Apache 2.0
- فرمتهای عرضه: Safetensors و ONNX
درخشش در بنچمارکها با تمرکز بر بازیابی اطلاعات
نتایج رسمی منتشرشده نشان میدهد که USER2-base در معیار mean(task) از بنچمارک MTEB-rus، که میانگین عملکرد در تمام بخشهای ارزیابی را میسنجد، به امتیاز ۶۱٫۱۲ دست یافته است. این نتیجه نه تنها نسخه پیشین USER-base و مدل multilingual-e5-base را پشت سر میگذارد، بلکه عملکرد آن را به انکودرهایی با تعداد پارامترهای بسیار سنگینتر نزدیک میکند.
مدل | تعداد پارامترها | میانگین امتیاز |
|---|---|---|
jina-embeddings-v3 | ۵۷۲ میلیون | ۶۳٫۴۵ |
ru-en-RoSBERTa | ۴۰۴ میلیون | ۶۱٫۷۱ |
USER2-base | ۱۴۹ میلیون | ۶۱٫۱۲ |
multilingual-e5-base | پایه | پایینتر از ۶۱٫۱۲ |
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
خطر ورود هوش مصنوعی به دانشگاهها؛ وقتی اتوماسیون بار اداری استادان را سنگینتر میکند
استفاده از هوش مصنوعی در دانشگاهها ممکن است بهجای کاستن از بار اداری، بوروکراسی و وظایف حاشیهای استادان را افزایش دهد. اگر این فناوری برای خودکارسازی رویههای ناکارآمد اداری به کار رود، دانشگاهها از هدف بنیادین خود یعنی پژوهش عمیق، آموزش باکیفیت و پرورش اندیشه نقادانه دور خواهند شد.
شناسایی دقیق باگهای پنهان نرمافزاری با هوش مصنوعی؛ فریمورک SemLoc ابزارهای سنتی را پشت سر گذاشت
پژوهشگران با توسعه فریمورک SemLoc راهکاری نوآورانه برای رفع یکی از بزرگترین چالشهای خطایابی نرمافزار ارائه دادهاند. این سیستم با تبدیل استدلالهای مدلهای زبانی به قیدهای اجرایی، باگهای معنایی پیچیده را با دقتی به مراتب بالاتر از روشهای کلاسیک شناسایی میکند. این دستاورد گامی ارزشمند در جهت هوشمندسازی فرایند عیبیابی و افزایش پایداری کدهای برنامهنویسی است.
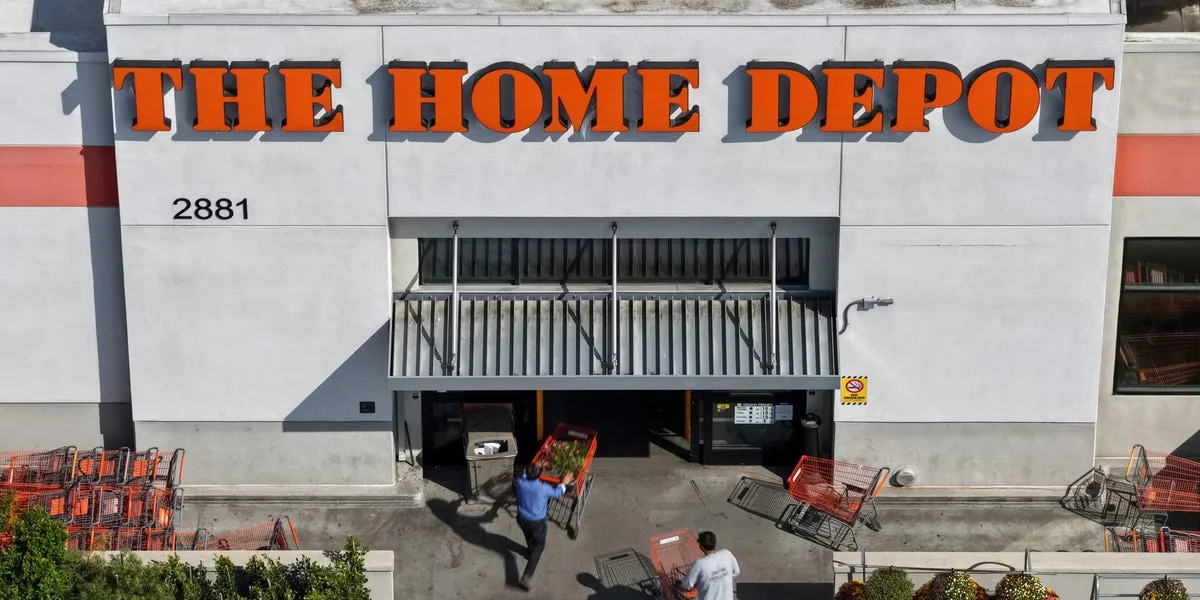
فروشگاه Home Depot: ایجنتهای هوش مصنوعی قبل از خرید باید احراز هویت شوند
فروشگاه زنجیرهای Home Depot اعلام کرد از خرید خودکار توسط ایجنتهای هوش مصنوعی استقبال میکند، اما این ابزارها ابتدا باید هویت خود و کاربر واقعی را احراز کنند. این غول خردهفروشی در حال همکاری با متا برای تدوین پروتکلهای شناسایی است تا ضمن حفظ ارتباط با مشتریان وفادار، بستری امن برای نسل جدید تجارت الکترونیک فراهم آورد.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.