ابزار EAGLE-4 با تنظیم هوشمند بار پردازشی، سرعت پاسخگویی Qwen3 را ۳ برابر میکند
نسخه جدید ابزار EAGLE-4 با تنظیم خودکار عمق درخت حدس توکنها بر اساس ترافیک و سختافزار سرور، جهش بزرگی در سرعت استنتاج مدلهای زبانی ایجاد کرده است. این سیستم با ادغام آسان در فریمورکهای محبوبی مثل vLLM، سرعت پاسخگویی مدل Qwen3 را تا ۳ برابر افزایش میدهد.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- سیستم EAGLE-4 درخت حدس توکنها را با توجه به ترافیک لحظهای و اندازه دسته سرور هماهنگ میکند تا بیشترین بازدهی حاصل شود.
- این ابزار از طریق پکیج eagle-harness بدون نیاز به تغییر در کدها، مستقیماً با SGLang و vLLM یکپارچه میشود.
- در آزمایشهای عملی، ترکیب این راهکار با مدل Qwen3.8-27B توانسته است سرعت پاسخگویی را تا ۳ برابر ارتقا دهد.
تیم توسعهدهنده EAGLE از نسخه جدید ابزار خود به نام EAGLE-4 رونمایی کرد؛ یک مدل پیشنهاددهنده (Drafter) تطبیقپذیر برای تکنیک دیکودینگ گمانهزن (Speculative Decoding) که در قالب بسته پایتونی eagle-harness از طریق pip قابل نصب است. این مدل هوشمند با سنجش هزینههای سرور، درخت گمانهزنی خود را بر اساس اندازه دسته (بچسایز)، مشخصات سختافزار و حجم بار پردازشی لحظهای تنظیم میکند و نیاز به تعریف پیکربندیهای جداگانه برای حالتهای تعاملی تککاربره یا سناریوهای شلوغ با همزمانی بالا را از بین میبرد.
تکنیک دیکودینگ گمانهزن از یک مدل سبکتر برای پیشنهاد چند توکن اولیه استفاده میکند و سپس مدل اصلی، صحت آنها را بهصورت موازی بررسی و تأیید میکند. این راستیآزمایی دقیق سبب میشود توزیع خروجی مدل اصلی بدون افت کیفیت دستنخورده باقی بماند و همزمان، تعداد فراخوانیهای پیاپی مدل هدف کاهش یابد. بنابراین کارایی نهایی سیستم مستقیماً بهسرعت مدل پیشنهاددهنده در تولید کاندیداهای دقیق و میزان پردازش لازم برای تأیید آنها توسط مدل اصلی بستگی دارد.
pip install eagle-harnessپکیج eagle-harness از طریق قلابهای ثبتی داخلی و بدون نیاز به دستکاری کدهای زمان اجرا، بهسادگی با موتورهای محبوب پردازش هوش مصنوعی نظیر SGLang، vLLM و موتور آزمایشی TokenSpeed ادغام میشود. ترکیب مرجع در آزمایشها از مدل Qwen3.8-27B در کنار چکپوینت رسمی EAGLE-4 بهره میبرد.
گمانهزنی هوشمند متناسب با ترافیک لحظهای سرور
مدل EAGLE-4 فرآیند تولید توکنهای حدسی و تأیید آنها توسط مدل هدف را متناسب با اندازه دسته فعال ارزیابی میکند؛ سپس عمق و ضریب شاخهبندی درخت را بهگونهای تنظیم میکند که بالاترین توان پردازشی ممکن حاصل شود. تنظیم مقدار top-k روی ۱ یک زنجیره حدسی ساده میسازد، در حالی که مقادیر بالاتر درختی از توکنهای ادامهدهنده کاندیدا را شکل میدهند.
این مدل پیشنهاددهنده چند نوآوری فنی را به خدمت میگیرد تا بار محاسباتی و مصرف حافظه خود را به حداقل برساند:
- لایه پیشنویس با پنجره لغزان (Sliding-window draft layer): بهجای توجه همزمان به تمام توکنهای متن، تنها یک بازه محدود از حالتهای پنهان اخیر را نگه میدارد.
- هِد کاندیدای کمرتبه (Low-rank candidate head): فرآیند پیشبینی توکنها را به ماتریسهای کوچکتر تجزیه میکند تا بار محاسباتی پیشنهاد کاندیداها سبک شود.
- حافظه کش فقط-افزودنی (Append-only draft cache): حافظه کش KV درَفت را در هر مرحله فقط توسعه میدهد و از بازسازی پرهزینه آن از ابتدا جلوگیری میکند.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
قوانین هوش مصنوعی در محیط کار؛ راهکاری حیاتی برای جلوگیری از بحرانهای بزرگ شرکتی
با گسترش روزافزون استفاده از هوش مصنوعی در محیطهای کاری، نبود چارچوبهای نظارتی مشخص میتواند شرکتها را با بحرانهای امنیتی و حقوقی سنگینی روبهرو کند. مدیران کسبوکارها با تدوین قوانین شفاف، آموزش مستمر کارکنان و کنترل دسترسی ابزارها میتوانند بهرهوری سازمان را بدون به خطر انداختن اطلاعات حساس ارتقا دهند.
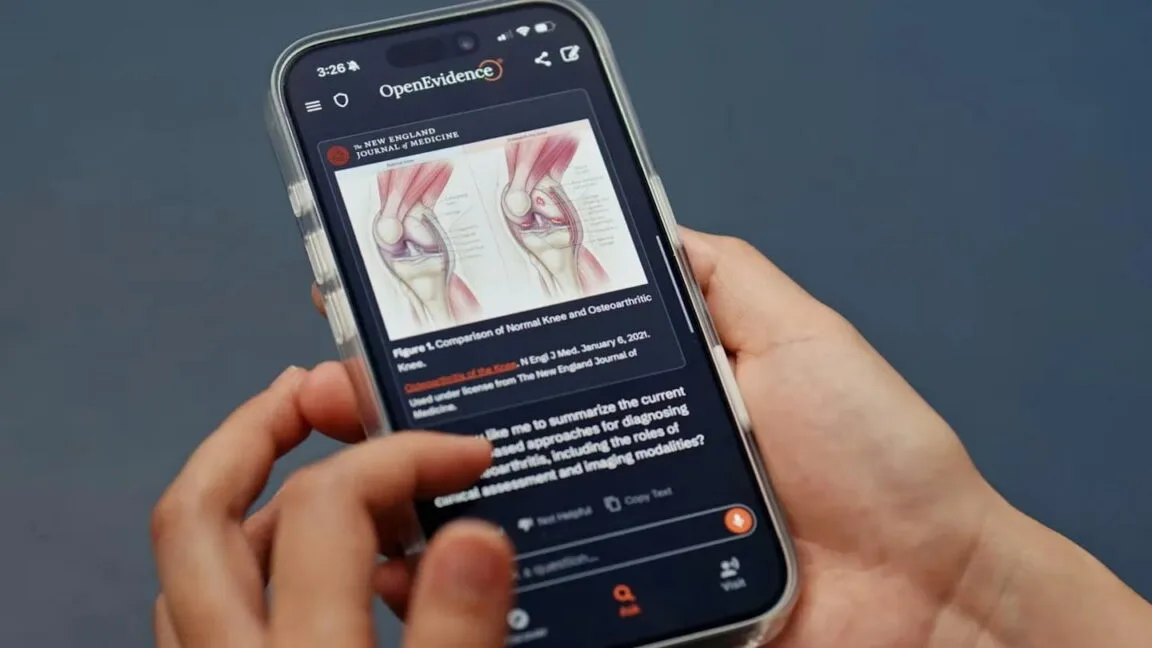
استارتاپ ۱۵ میلیارد دلاری اوپن اویدنس؛ موتور جستجوی هوش مصنوعی که شاید پزشک شما هم از آن استفاده کند
پلتفرم هوش مصنوعی اوپن اویدنس (OpenEvidence) با تکیه بر مدل درآمدی تبلیغات و استقبال گسترده جامعه پزشکی، به ارزشگذاری خیرهکننده ۱۵ میلیارد دلاری دست یافته است. با وجود محبوبیت بالای این ابزار تشخیصی، تردیدها درباره دقت علمی آن در مقایسه با مدلهای پیشرو و ورود رقبای قدرتمندی چون اوپنایآی و آنتروپیک، آینده این استارتاپ را با چالش روبهرو کرده است.
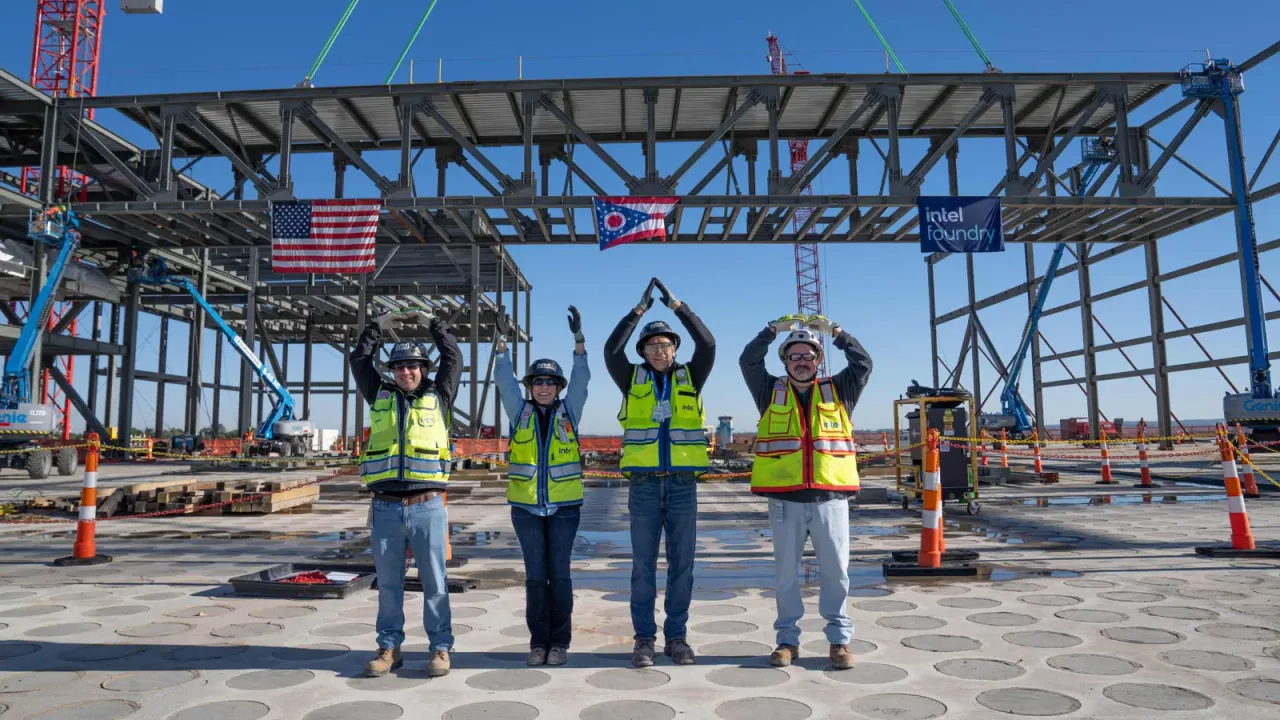
پیشرفت کارخانه تراشهسازی اینتل در اوهایو؛ تلاش برای جبران ۵ سال تأخیر در اوج تقاضای هوش مصنوعی
اینتل نخستین خرپای سازهای اصلی کارخانه غولپیکر تراشهسازی خود را در ایالت اوهایو نصب کرد تا گامی دیگر در مسیر ساخت این پروژه بردارد. با وجود تأخیر دستکم ۵ ساله در راهاندازی و انتقال بهرهبرداری به سال ۲۰۳۰، عطش شدید بازار هوش مصنوعی برای تراشههای پیشرفته میتواند برگ برنده اینتل در جذب مشتریان بزرگ باشد.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.