ElevenLabs از مدل هوش مصنوعی SFX v3 برای تولید افکتهای صوتی چندلایه رونمایی کرد
شرکت ElevenLabs از نسخه جدید ابزار صوتی خود با نام SFX v3 رونمایی کرد. این مدل هوش مصنوعی توانایی تولید همزمان چندین لایه صوتی مجزا را از طریق یک توصیف متنی دارد و کیفیت اصوات موسیقی و آواها را بهبود میبخشد.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- مدل جدید SFX v3 امکان تولید همزمان چندین لایه صوتی مجزا و واقعگرایانه را تنها با یک پرامپت متنی ساده فراهم میکند
- این نسخه با شفافیت صوتی بالاتر در فرکانسهای بالا و تقویت تولید قطعات موسیقی و آوایی عملکرد بهتری نسبت به نسل قبل نشان میدهد
- دسترسی به این مدل صوتی جدید از طریق وبسایت استودیو، اپلیکیشن موبایل و رابط برنامهنویسی رسمی ElevenLabs برای کاربران امکانپذیر شده است
معرفی مدل
مدل SFX v3 جدیدترین مدل تبدیل متن به جلوههای صوتی از سوی ElevenLabs است که در ۲۹ اکتبر ۲۰۲۶ عرضه شد. این مدل بهطور ویژه برای تولیدکنندگانی طراحی شده است که به تولید چندین لایه صوتی همزمان از دل یک پرامپت نیاز دارند (مانند ترکیب صدای جمعیت، برخورد توپ و فریاد تماشاگران، یا صدای باز شدن در بههمراه غرش موتور و گامهای پا) و علاوه بر آن، در تولید موسیقی و اصوات آوایی نیز خروجی بسیار طبیعیتری در مقایسه با SFX v2 ارائه میدهد.
برای مشاهده جزییات عرضه میتوانید به صفحه اختصاصی معرفی SFX v3 در وبلاگ ElevenLabs مراجعه کنید. همچنین شناسه این مدل در API با عنوان eleven_text_to_sound_v3 برای توسعهدهندگان فعال شده است.
ویژگیها و نکات کلیدی
- نامگذاری محصول: این نسخه با عنوان تجاری SFX v3 و شناسه
eleven_text_to_sound_v3ارائه شده است و مدل SFX v2 تا زمان انتخاب اختیاری نسخه جدید، بهعنوان گزینه پیشفرض فعال خواهد ماند. - بهبودهای فنی: درک دقیقتر پرامپتهای چندبخشی، شفافیت بالاتر صدا در فرکانسهای بالا، پردازش طبیعیتر قطعات موسیقی و آواها، و دسترسی گسترده در بخش جلوههای صوتی، قابلیت Flows، استودیو، ویرایشگر موسیقی، اپلیکیشن موبایل و ElevenAPI از مهمترین نقاط قوت این نسخه بهشمار میروند.
- استقبال کاربران: همزمان با اعلام رسمی در حساب کاربری ElevenLabs، دهها نمونه ساختهشده توسط کاربران (شامل فضاسازیهای صوتی، تبلیغات و کلیپهای صوتی ASMR) بهسرعت در شبکه اجتماعی اکس منتشر شد.
- نحوه دسترسی: دسترسی به این مدل در برخی مناطق بهشکل تدریجی باز میشود، و کاربردهای تجاری و سازمانی به پلنهای اشتراکی و داشتن اعتبار متکی است.
- تمایز از سایر پروژهها: این مدل خط تولید تخصصی افکتهای صوتی است و ارتباطی با پروژه آزمایشی ElevenLabs Chimera ندارد.
چرا این خبر اهمیت دارد؟
انتشار رسمی یک مدل صوتی پیشرفته همراه با پشتیبانی کامل در API و مستندات توسعه در همان روز، به طراحان صدا و سازندگان ویدیو امکان میدهد بدون درگیر شدن با ویرایش دستی و ترکیب لایهها، طراحی صوتی صحنههای پیچیده را در چند ثانیه به هوش مصنوعی بسپارند.
راهنمای استفاده و آزمایش مدل
- وارد محیط ElevenCreative شده، به بخش Sound Effects یا Flows بروید و مدل SFX v3 را انتخاب کنید، یا در کد فراخوانی API شناسه
model_id: "eleven_text_to_sound_v3"را قرار دهید. - پرامپتهای ترکیبی و چندبخشی بنویسید (مانند تعیین تقدم و تأخر وقایع صوتی و تفاوت حجم صدا در لایههای مختلف) و نتیجه را با نسخه قبلی مقایسه کنید.
- صداهای تولیدشده را در ویرایشگر موسیقی یا نرمافزارهای تدوین ویدیوی خود جایگذاری کنید و مراقب میزان مصرف اعتبارات زمانی خود باشید.
پیش از اجرای پروژههای سنگین از دسترسی حساب کاربری خود به مدل v3 مطمئن شوید و در صورت لزوم نسخه v2 را بهعنوان گزینه پشتیبان مدنظر داشته باشید.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
مدل Wan-Animate-2 علیبابا به ComfyUI اضافه شد؛ جانبخشی به تصاویر بدون نیاز به اسکلتبندی
تیم توسعه مدلهای Wan در آزمایشگاه Tongyi متعلق به علیبابا، از مدل متنباز Wan-Animate-2 رونمایی کرد که امکان متحرکسازی تصاویر را بدون نیاز به استخراج اسکلت و نقاط حرکتی فراهم میسازد. این ابزار با پشتیبانی بومی در ComfyUI عرضه شده است و با درک همزمان ظاهر و حرکت، جزئیاتی چون حالت چهره و لباس را با دقت بسیار بالا بازآفرینی میکند.
سرور رسمی MCP استارتاپ Suno منتشر شد؛ ساخت مستقیم موسیقی در محیط گفتگو با هوش مصنوعی
استارتاپ Suno با انتشار نسخه آزمایشی سرور رسمی پروتکل زمینه مدل (MCP)، امکان ساخت و ویرایش مستقیم موسیقی را به ابزارهایی مانند Claude، ChatGPT، Gemini و Cursor آورده است. این اتصال جدید به کاربران اجازه میدهد بدون نیاز به تنظیمات پیچیده یا اتوماسیون مرورگر، از طریق دستورات متنی آهنگهای دلخواه خود را بسازند.
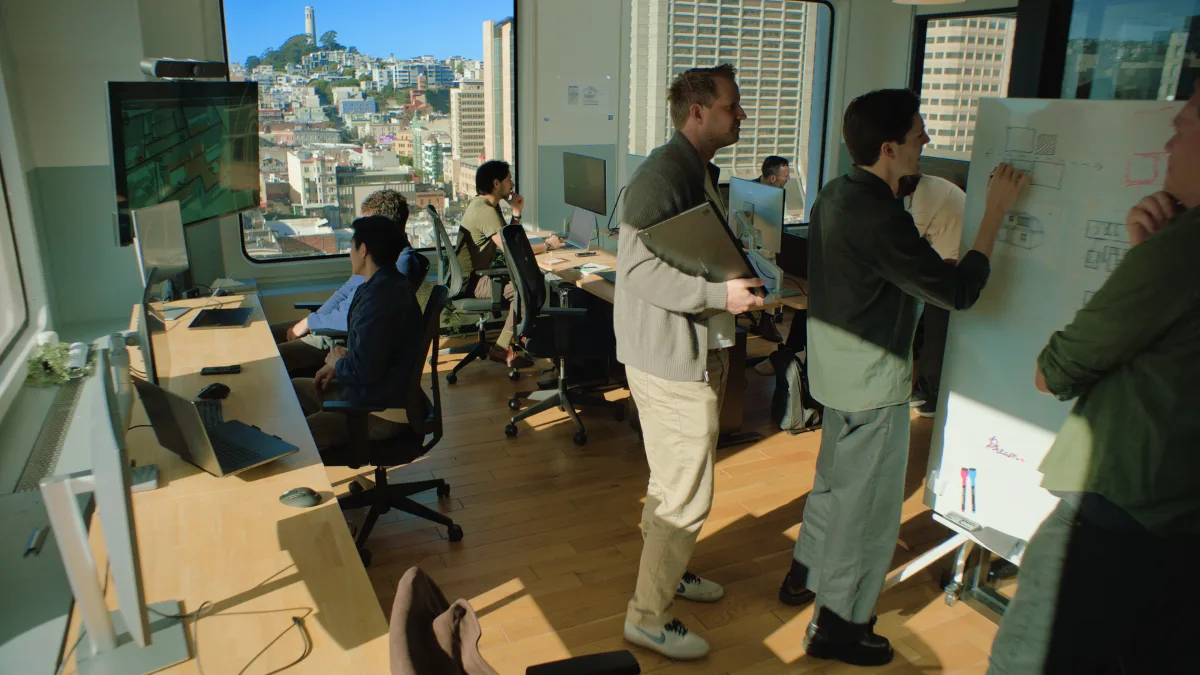
مدیران سابق Palantir با جذب ۱۷ میلیون دلار، استارتاپ Dream را برای طراحی خودکار ساختمان راهاندازی کردند
دو تن از مدیران ارشد سابق Palantir با جذب سرمایه ۱۷ میلیون دلاری از صندوق a16z، استارتاپ Dream را راهاندازی کردند. این پلتفرم با توسعه مدلهای جهانشناختی هوش مصنوعی، بهدنبال خودکارسازی کامل طراحی و مهندسی ساختمان بر اساس قوانین واقعی فیزیک است.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.