عقبنشینی شرکتها از سپردن همهچیز به هوش مصنوعی؛ سقوط اعتماد به استقرار خودکار ایجنتها از ۷۵ به ۵۶ درصد
در حالی که تب استفاده از ایجنتهای هوش مصنوعی حسابی داغ است، تازهترین بررسیها نشان میدهد شرکتهای بزرگ ترمز استقرار خودکار تغییرات را کشیدهاند و دیگر حاضر نیستند بدون تایید انسان، کنترل محیطهای عملیاتی را به ایجنتها بسپارند. در واقع، خرابیهای غیرمنتظره پس از تستهای داخلی و نگرانی از پاسخهای اشتباه اما بااعتمادبهنفس ایجنتها، مدیران را بر آن داشته تا پای نیروی انسانی را دوباره به زنجیره تصمیمگیری باز کنند.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- طبق تازهترین نظرسنجی سازمانی، سهم شرکتهایی که به ایجنتهای هوش مصنوعی اجازه استقرار خودکار و بدون نظارت انسان در محیط پروداکشن را میدهند، از ۷۵ درصد در ماه گذشته به ۵۶ درصد سقوط کرده است.
- با وجود سرمایهگذاری سنگین در ابزارهای تست، ۶۱ درصد از سازمانها اعتراف کردهاند که ایجنتهایشان با وجود قبولی در آزمونهای داخلی، بعد از انتشار و درست جلوی چشم مشتریان خرابکاری به بار آوردهاند.
- ابزارهای ارزیابی شرکت OpenAI با رشدی انفجاری حالا در ۵۹ درصد زیرساختهای سازمانی نفوذ کردهاند، اما شرکتها ترجیح میدهند تایید نهایی برای اعمال تغییرات حیاتی همچنان به دست انسانها انجام شود.
شرکتها و سازمانهای بزرگ این روزها حسابی دستبهعصا شدهاند و دیگر حاضر نیستند به همین راحتی به ایجنتهای هوش مصنوعی چک سفیدامضا بدهند تا کدها یا تغییرات سیستمی را بدون تایید نهایی انسان در محیط پروداکشن (عملیاتی) مستقر کنند؛ آن هم در شرایطی که سرمایهگذاری روی ابزارهای ارزیابی قابلیت اطمینان ایجنتها با سرعت ادامه دارد.
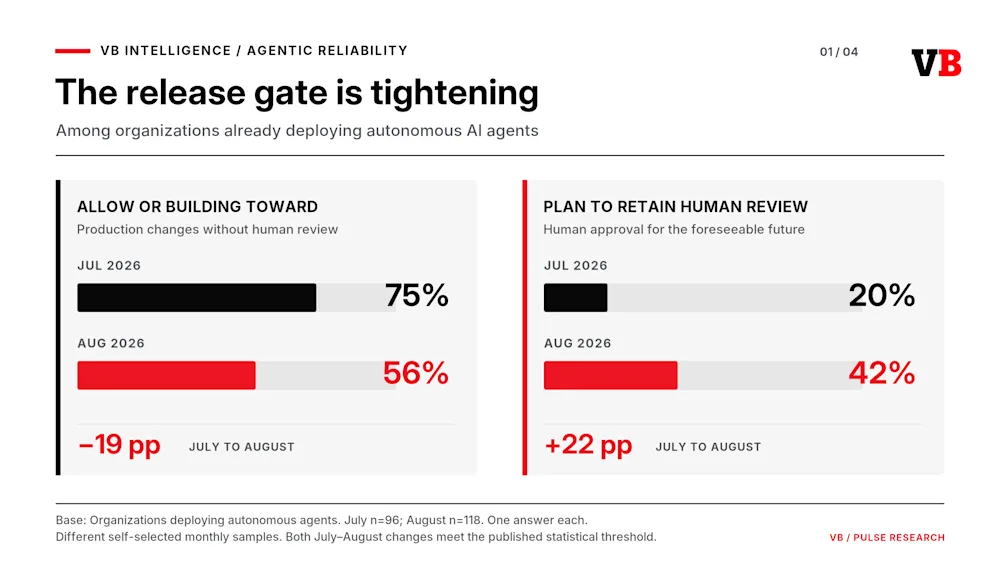
در تازهترین دور از نظرسنجیهای سازمانی پیرامون ارزیابی و قابلیت اطمینان ایجنتها در ماه آگوست، تنها ۵۶ درصد از پاسخدهندگانی که سازمانهایشان از ایجنتهای هوش مصنوعی خودران استفاده میکنند، اعلام کردند که هماکنون اجازه اعمال برخی تغییرات در محیط پروداکشن را صرفاً بر پایه نتایج ارزیابیهای خودکار و بدون بازبینی انسان صادر میکنند یا قصد دارند ظرف یک سال آینده به این قابلیت برسند. این آمار نشاندهنده یک افت محسوس و چشمگیر نسبت به رقم ۷۵ درصدی نظرسنجی ماه جولای است.
یکی از نکاتی که شاید در این تغییر آمار نقش داشته باشد، ترکیب شرکتکنندگان است: بیش از نیمی از ۱۴۰ پاسخدهنده ماه آگوست (۵۳ درصد) تصمیمگیرندگان نهایی خرید هوش مصنوعی بودند، در حالی که این رقم در ماه جولای ۴۴ درصد بود.
با این حال، کاهش تمایل به خودکارسازی مطلق حتی در میان همین مدیران ارشد هم کاملاً مشهود است. در میان تصمیمگیرندگان نهایی خرید که سازمانهایشان ایجنتهای خودران دارند، سهم کسانی که اجازه اعمال تغییرات بدون بازبینی انسان را میدادند یا به دنبال پیادهسازی آن بودند، از ۸۸ درصد در ماه جولای به ۶۱ درصد در ماه آگوست سقوط کرده است.
بنابراین، دادهها نشاندهنده یک چرخش و بازنگری اساسی درون سازمانهای بررسیشده است، نه اینکه صرفاً ناشی از تغییر ترکیب افراد حاضر در نظرسنجی باشد. البته از آنجا که هر دو نظرسنجی روی گروههای جداگانه و داوطلب انجام شده، نمیتوان این نتایج را صددرصد به کل بازار بزرگ سازمانی تعمیم داد، اما زنگ خطری جدی را به صدا درآورده است.
جالب اینجاست که این عقبنشینی حتی پیش از انتشار مقاله جنجالی داریو آمودی (مدیرعامل شرکت Anthropic) با عنوان «باید سرعت پیشرفت در مرزهای دانش را تنظیم کنیم» (در تاریخ ۱۲ سپتامبر) آغاز شده بود؛ مقالهای که در آن خواسته شده بود ترمز شتابزدگی در توسعه مدلهای پیشرو هوش مصنوعی کشیده شود و نظارتهای ایمنی تقویت گردد. پس از او هم چهرههای نامداری چون سم آلتمن (مدیرعامل OpenAI) و دمیس حسابیس (مدیر Google DeepMind) به حمایت از احتیاط بیشتر پرداختند.
از آنجا که این نظرسنجی در ماه آگوست انجام شده، این تغییر رویکرد نمیتواند واکنش مستقیمی به مقاله آمودی باشد؛ اما هنوز به درستی مشخص نیست چه عامل دقیقی شرکتها را تا این حد نسبت به استقرار کاملاً مستقل ایجنتها محتاط کرده است.
تناقض جالبتر و معنادارتر، فاصله میان بیاعتمادی به ارزیابیهای خودکار برای تایید استقرار و از سوی دیگر استقبال شدید از خرید خود این ابزارهاست! در حالی که تمایل به حذف تایید انسانی افت کرده، استفاده از ابزارهای ارزیابی بومی شرکت OpenAI رشدی خیرهکننده داشته و از ۳۱ درصد در ماه جولای به ۵۹ درصد در ماه آگوست جهش پیدا کرده است.
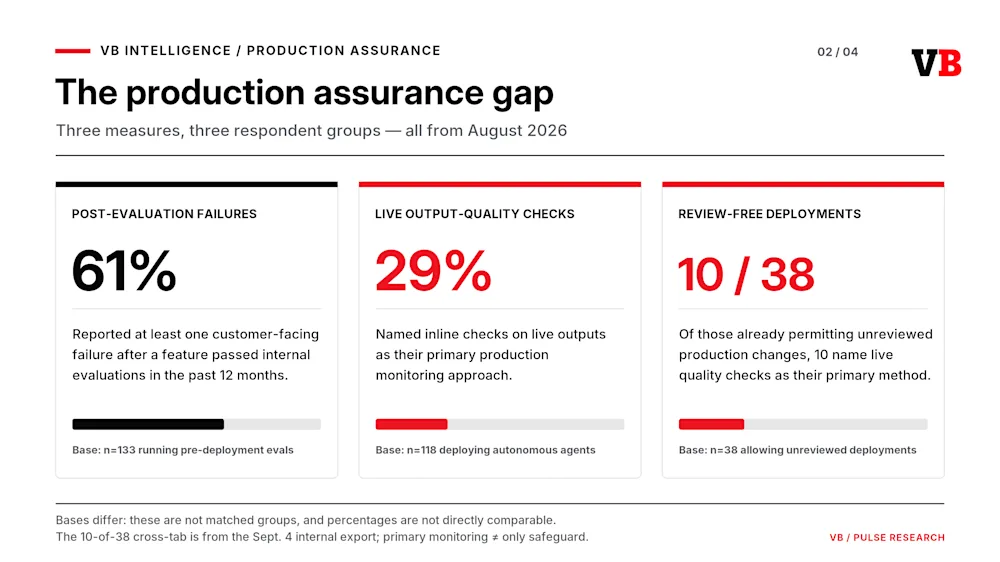
از طرف دیگر، ۶۱ درصد از پاسخدهندگانی که سازمانهایشان پیش از استقرار فرایند ارزیابی دارند، گزارش دادهاند که حداقل یک بار در طول ۱۲ ماه گذشته پیش آمده که یک ایجنت یا قابلیت مبتنی بر مدل زبانی، تمام تستهای داخلی را با موفقیت پاس کرده اما بلافاصله پس از ورود به محیط واقعی، جلوی چشم مشتریان خرابکاری به بار آورده است.
کنار هم گذاشتن این یافتهها نشان میدهد شرکتها حساب «استفاده از ابزارهای خودکار برای سنجش عملکرد هوش مصنوعی» را از «واگذاری مجوز نهایی استقرار در پروداکشن به این ارزیابیها» کاملاً جدا کردهاند.
شکاف اعتماد، نظارت انسانی را همچنان در قلب هوش مصنوعی سازمانی نگه میدارد
نتایج نظرسنجی ماه آگوست شرکتها را به چند دسته مشخص تقسیم میکند: بیش از یکچهارم سازمانها (۲۷ درصد) در حال حاضر به برخی از ایجنتهای کمریسک اجازه میدهند تا تغییرات را بدون تایید انسان اعمال کنند. در مقابل، ۳۵ درصد از شرکتها این موضوع را در آینده قابلپیشبینی کاملاً منتفی میدانند و ۲۰ درصد نیز در حال آمادهسازی زیرساختهای خود هستند تا ظرف ۱۲ ماه آینده به این قابلیت برسند. ۱۶ درصد هم اصلاً از ایجنتهای خودران استفاده نمیکنند و ۲ درصد باقیمانده مردد بودند. این ارقام تمام ۱۴۰ پاسخدهنده را پوشش میدهد.
اگر سازمانهایی را که اصلاً ایجنت خودران ندارند کنار بگذاریم، ۳۲ درصد در حال حاضر به تغییرات کمریسک اجازه استقرار بدون بازبینی میدهند و ۲۴ درصد دیگر در تلاشاند تا این قابلیت را بسازند. اما نکته مهم اینجاست که ۴۲ درصد اعلام کردهاند در آینده قابلپیشبینی، تایید نهایی انسان را در فرایند حفظ خواهند کرد.
این آمار اخیر یکی از شفافترین چرخشهای این پژوهش است: سهم پاسخدهندگانی که میخواهند تایید نیروی انسانی را حفظ کنند از ۲۰ درصد در جولای به ۴۲ درصد در آگوست رسیده که از نظر آماری یک رشد فوقالعاده معنادار است.
با این حال، تمایل به حفظ تایید انسانی لزوماً باعث تغییر در اولویتهای بودجهبندی ارزیابی و قابلیت اطمینان نشده است.
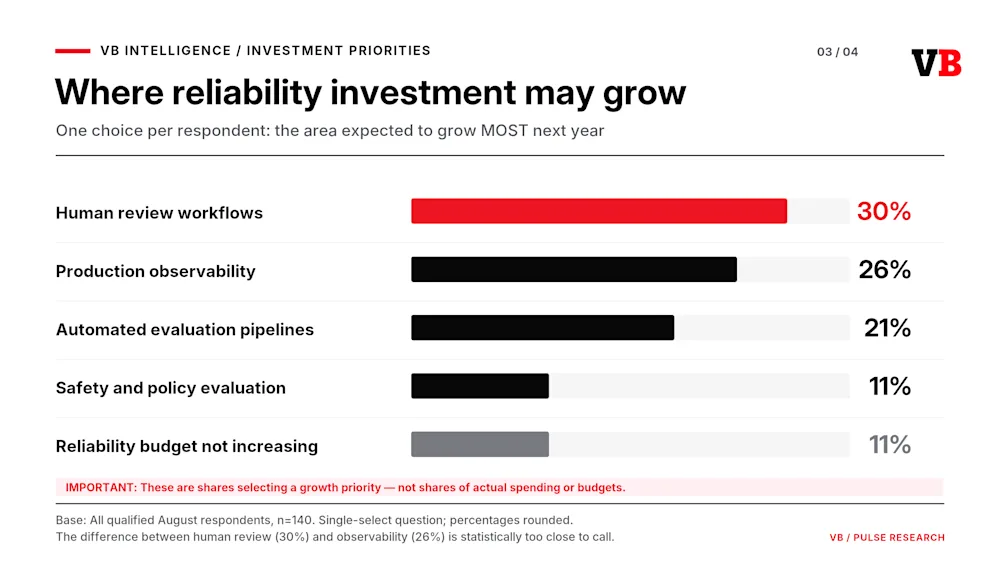
وقتی از پاسخدهندگان پرسیده شد کدام حوزه از سرمایهگذاری روی سنجش و قابلیت اطمینان بیشترین رشد را در سال آینده خواهد داشت، نتایج به این صورت ثبت شد:
جریانهای کاری بازبینی انسانی (Human Review): ۳۰ درصد
ابزارهای مشاهدهپذیری در پروداکشن (Observability): ۲۶ درصد
خطوط لوله ارزیابی خودکار (Automated Evals): ۲۱ درصد
ارزیابی ایمنی و انطباق با قوانین (Safety & Policy): ۱۱ درصد
عدم افزایش بودجه در بخش قابلیت اطمینان: ۱۱ درصد
این ارقام صرفاً نشان میدهد پاسخدهندگان انتظار دارند کدام حوزه بیشترین رشد سرمایهگذاری را تجربه کند، نه اینکه کل بودجه واقعی چگونه تقسیم میشود.
نتایج ماه جولای هم شباهت زیادی به این آمار داشت: ۳۱ درصد بازبینی انسانی، ۳۰ درصد مشاهدهپذیری در پروداکشن، ۱۹ درصد پایپلاینهای ارزیابی خودکار و ۱۶ درصد ارزیابی ایمنی و قوانین را انتخاب کرده بودند.
بنابراین بازبینی انسانی همچنان پرتکرارترین حوزه رشد در ماه آگوست باقی ماند، هرچند فاصله آن با مشاهدهپذیری پروداکشن به اندازهای نیست که تفاوت آماری قاطعی ایجاد کند. همچنین این آمار به معنای کاهش بودجه ارزیابی خودکار توسط سازمانها نیست.
ارزیابیهای ایمنی و خطمشیها فراتر از درست بودن یا نبودن پاسخ مدل هستند؛ این تستها بررسی میکنند که آیا ایجنت در مواقع لزوم از پاسخ دادن خودداری میکند، به قوانین پایبند است و خروجیهای مخرب تولید نمیکند یا خیر.
اگرچه سهم ارزیابی ایمنی و خطمشی به عنوان سریعترین حوزه رشد از ۱۶ درصد به ۱۱ درصد کاهش یافته، اما به این معنی نیست که هزینههای اختصاصیافته به آن کم شده، بلکه فقط پاسخدهندگان کمتری آن را به عنوان بزرگترین اولویت رشد سازمان خود انتخاب کردهاند.
مجموع این اطلاعات نشان میدهد که سازمانها همچنان به توسعه همزمان نظارت انسانی و خودکار ادامه میدهند، حتی اگر در حال بازنگری جدی روی این موضوع باشند که کدام تصمیمها را باید به تنهایی به دست ماشین سپرد.
ارزیابیهای داخلی هنوز نمیتوانند جلوی خرابکاری در برابر مشتریان را بگیرند
یکی از دلایل اصلی تردید شرکتها برای حذف بررسیهای انسانی، فاصله عمیق میان تستهای آزمایشگاهی داخلی و عملکرد مدل در دنیای واقعی است. هرچند دادهها اثبات نمیکنند که صرفاً این خرابکاریها باعث احتیاط سازمانها شدهاند، اما واقعیت میدانی نگرانکننده است.
در این نظرسنجی به طور مشخص پرسیده شد که آیا قابلیتهای هوش مصنوعی پس از پاس کردن تستهای داخلی، خطایی جلوی چشم مشتریان ایجاد کردهاند یا خیر.
بدون احتساب ۵ درصدی که اصلاً قبل از استقرار تستی انجام نمیدهند، ۶۱ درصد از سازمانها حداقل یک حادثه خرابکاری در ۱۲ ماه گذشته گزارش دادند. حتی عجیبتر اینکه ۲۲ درصد از آنها اعلام کردند بیش از یک بار دچار چنین خطاهایی شدهاند.
در ماه جولای این رقم برای پاسخدهندگان مشابه ۵۳ درصد بود (به جای عدد ۴۹ درصدی که قبلاً برای کل پاسخدهندگان ثبت شده بود).
با اینکه عدد آگوست بالاتر است، اما این افزایش از نظر آماری چندان معنادار نیست؛ یعنی نمیتوان قاطعانه گفت آمار خطای سازمانها بیشتر شده است.
اما یک یافته دقیقتر تغییر معناداری نشان داد: نسبت سازمانهایی که دقیقاً یک بار چنین خطایی را تجربه کردهاند، از ۲۷ درصد در جولای به ۳۹ درصد در آگوست رسیده است.
این تمایز از آن جهت اهمیت دارد که آمارها تعداد سازمانهای درگیر خطا را میسنجند، نه نرخ شکست هر ایجنت را. طبیعی است شرکتی که صدها قابلیت هوش مصنوعی دارد، بیشتر از شرکتی با چند ایجنت ساده در معرض خرابکاری قرار میگیرد.
به همین دلیل اعتماد به ابزارهای ارزیابی به شدت شکننده است: در ماه آگوست، تنها ۹ درصد از پاسخدهندگان گزینه «امروز به ارزیابیهای خودکار اعتماد داریم» را انتخاب کردند. این رقم در جولای ۱۳ درصد و در ژوئن ۵ درصد بود.
البته کاهش اعتماد از جولای به آگوست تفاوت آماری بزرگی ندارد. به علاوه، چون شرکتکنندگان باید مهمترین دغدغه خود را انتخاب میکردند، نباید تصور کرد که ۹۱ درصد به کلی هیچ اعتمادی به ابزارهای خودکار ندارند.
بزرگترین ایرادی که به سیستمهای ارزیابی گرفته شده، عدم تطابق آنها با نتایج دنیای واقعی است (۲۷ درصد). دغدغههای بعدی به ترتیب شامل عدم شفافیت و ناتوانی در توضیح تصمیمات (۲۴ درصد)، سوگیری یا ناسازگاری در نتایج ارزیابی (۱۶ درصد)، نشت دادهها و نگرانیهای حریم خصوصی (۱۳ درصد) و عدم بلوغ ابزارها (۱۲ درصد) هستند.
نکته جالب اینجاست که سازمانهایی که خرابکاری ایجنتها در برابر مشتری را تجربه کرده بودند، تمایل کمتری به استقرار خودران نشان ندادند!
در میان شرکتهایی که ایجنت خودران دارند، ۵۹ درصد از آنهایی که تجربه خطای زنده داشتند، همچنان به استقرار بدون تایید انسان چراغ سبز نشان میدهند یا روی آن کار میکنند. این رقم در سازمانهای بدون تجربه خطا ۵۵ درصد بود که اختلاف معناداری ندارد.
این نتیجه با نظرسنجی جولای تفاوت دارد؛ در آن زمان سازمانهای خطادیده تمایل بیشتری به حذف کامل انسان داشتند، اما در آگوست این الگو تکرار نشد.
در نهایت، آمار ماه آگوست نتیجهگیری ظریفتری را به نمایش میگذارد: شرکتها ابزارهای خودکار را به خاطر ناکارآمدی رها نکردهاند، بلکه فقط ترجیح میدهند تایید نهایی انسان را از انتشار در محیط پروداکشن حذف نکنند، در حالی که همزمان به خرید و تجهیز ابزارهای ارزیابی ادامه میدهند.
پرسش اساسی امروز این نیست که آیا سازمانها ارزیابی ایجنتها را خودکار خواهند کرد یا نه؛ بلکه مسئله این است که چقدر حاضرند به این ارزیابیها اختیار تام و بدون دخالت انسان برای تغییر در سیستمهای حیاتی بدهند.
سازمانها پس از استقرار چگونه ایجنتها را پایش میکنند؟
تستهای پیش از استقرار فقط لایه اول اطمینان هستند؛ به همان اندازه مهم است که بدانیم یک ایجنت پس از فعال شدن در دنیای واقعی دقیقاً چه رفتاری از خود نشان میدهد.
از میان ۱۱۸ سازمانی که در ماه آگوست ایجنت خودران داشتند، تنها ۲۹ درصد گفتند که روش اصلی پایش آنها در پروداکشن، بررسیهای لحظهای و خودکار کیفیت روی خروجیهای زنده است.
در مقابل، ۳۶ درصد اساساً به ثبت لاگ و ردیابی تراکنشها (Trace Logging) تکیه میکنند؛ روشی که فعالیت زیرساخت، تعداد توکنها و ورودیها و خروجیها را برای خطایابیهای بعدی ثبت میکند، بدون اینکه بررسی کند آیا پاسخ ایجنت اصلاً درست بوده یا نه!
این مسئله به شدت نگرانکننده است؛ زیرا یک پاسخ سریع و کاملاً اشتباه که با اعتمادبهنفس بالا تولید شده، میتواند یک لاگ بینقص و کد وضعیت ۲۰۰ (به معنی موفقیتآمیز بودن درخواست HTTP) ثبت کند، در حالی که محتوای آن فاجعهبار است!
تفکیک کامل رویکردهای اصلی پایش پروداکشن در میان سازمانهای دارای ایجنت خودران به این شرح است:
ثبت لاگ و ردیابی تراکنشها (Trace Logging): ۳۶ درصد
بررسی لحظهای کیفیت روی ترافیک زنده: ۲۹ درصد
ردیابی زیرساخت درگاههای API: ۱۶ درصد
اطلاع ندارم یا در حوزه کاری من نیست: ۱۱ درصد
بررسیهای موردی و دستی: ۸ درصد
رویهمرفته، ۵۳ درصد از سازمانها یا ردگیری تراکنشها یا پایش درگاه API را به عنوان روش اصلی خود انتخاب کردهاند. هر دو روش به شناسایی مشکلات زیرساختی کمک میکنند، اما هیچکدام درستی و کیفیت پاسخهای تولیدشده توسط ایجنت را نمیسنجند.
این شکاف نظارتی بهویژه در میان سازمانهایی که اجازه استقرار بدون انسان را صادر کردهاند، خود را بیشتر نشان میدهد. طبق دادههای آماری، تنها ۱۰ شرکت از ۳۸ شرکتی که اجازه اعمال تغییرات بدون تایید انسان را میدهند، بررسی خودکار کیفیت روی خروجیهای زنده را روش اصلی پایش خود اعلام کردهاند.
این یعنی تقریباً ۲۶ درصد، مشابه رقم ۲۸ درصدی ماه جولای. این یافته نشان میدهد حذف تایید انسانی از فرایند استقرار لزوماً به این معنی نیست که شرکتها پایش خودکار کیفیت خروجی را به عنوان خط دفاعی اصلی خود قرار داده باشند.
البته این آمار اثبات نمیکند که شرکتهای باقیمانده هیچ کنترل کیفی دیگری ندارند؛ چه بسا برخی از آنها از روشهای مکمل یا بازبینیهای دورهای دیگری استفاده کنند که در گزینههای تکپاسخی این نظرسنجی نیامده است.
با این همه، نتایج به وضوح نشان میدهد که تمرکز اصلی مانیتورینگ در پروداکشن بیشتر روی «روشن بودن و کار کردن سیستم» است تا «صحیح بودن پاسخهای تولیدشده».
این تمایز زمانی اهمیت دوچندان پیدا میکند که بدانیم سازمانها به ایجنتها اجازه دادهاند تغییراتی را بدون نیاز به امضای نیروی انسانی در سیستمها پیاده کنند.
حذف نظارت انسانی در زمان استقرار لزوماً سازوکارهای خودکار کشف مشکل را از بین نمیبرد، اما وقتی پایش شرکت متکی بر سلامت زیرساخت است، یک خروجی اشتباه اما موجه از نظر ظاهری، هیچ هشدار یا خطایی ثبت نمیکند.
این نظرسنجی مشخص نمیکند چه تعداد از سازمانهای موافق استقرار خودکار کلاً فاقد مانیتورینگ زنده کیفیت هستند، یا اینکه باگهای آنها معمولاً با هشدارهای خودکار کشف میشوند یا از طریق کارمندان و شکایت مشتریان.
اما یک چالش کاملاً کاربردی را برای استقلال بیشتر ایجنتها آشکار میکند: ارزیابیهای خودکار باید فراتر از باگهای زیرساختی بروند؛ آنها باید بتوانند خروجیهایی را که از نظر ساختاری سالم و با موفقیت ارسال شدهاند اما ذاتاً غلط هستند، شکار کنند.
برای شرکتهایی که به دنبال گسترش استفاده از ایجنتها هستند، پرسش کلیدی این است: چگونه میتوان بدون تکیه صرف به گزارشهای انسانی یا مشتریان عصبانی، کیفیت خروجیها را پس از استقرار به شکلی موثر و خودکار زیر نظر گرفت؟
وضعیت بازار ابزارها و پلتفرمهای ارزیابی
بازار ابزارهای ارزیابی و مشاهدهپذیری هوش مصنوعی نیز چشمانداز ترکیبی و رقابتی خاصی را تجربه میکند.
پلتفرم توسعهدهندگان OpenAI در ۵۹ درصد از زیرساختهای سازمانی حضور دارد (در مقایسه با ۳۱ درصد در ماه جولای) که جهشی آماری و بزرگ محسوب میشود، و از سوی ۴۰ درصد از پاسخدهندگان به عنوان پلتفرم اصلی ارزیابی انتخاب شده است.
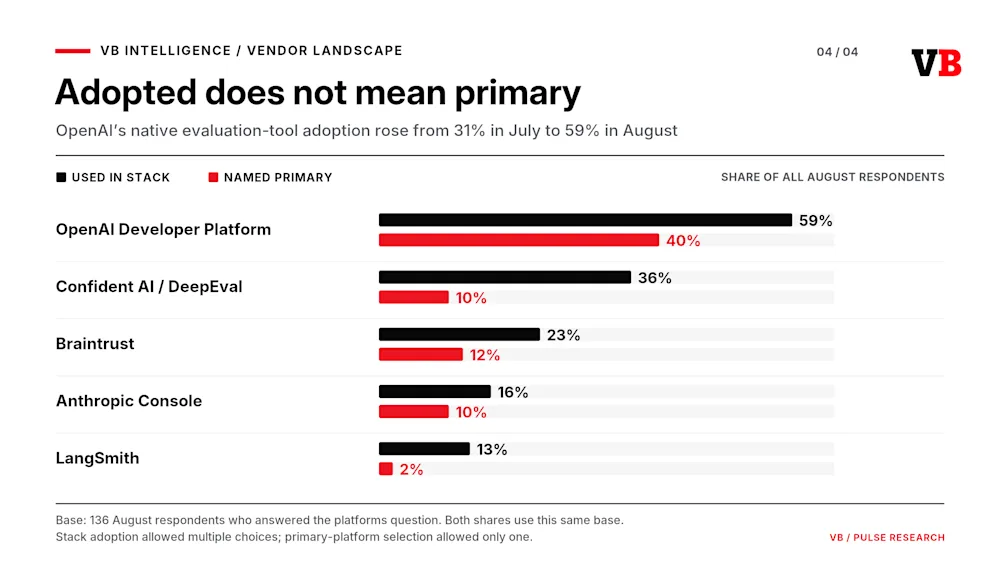
در میان شرکتهایی که مشخصاً از ابزارهای بومی ارزیابی OpenAI استفاده میکنند، حدود ۶۹ درصد آن را به عنوان پلتفرم اول و اصلی خود معرفی کردهاند. این دو معیار متفاوتاند: اولی سهم OpenAI به عنوان پلتفرم اصلی در میان تمام پاسخدهندگان است، و دومی نشان میدهد مشتریان فعلی OpenAI تا چه حد آن را محور کار خود قرار دادهاند.
پلتفرم Confident AI (ابزار DeepEval) در ۳۶ درصد زیرساختها حضور دارد و ۱۰ درصد از کل پاسخدهندگان آن را پلتفرم اصلی خود میدانند. در میان استفادهکنندگان از Confident AI، نزدیک به ۲۹ درصد آن را ابزار اصلی خود معرفی کردهاند.
از سوی دیگر، پلتفرم Braintrust در ۲۳ درصد زیرساختها به کار رفته و برای ۱۲ درصد از کل شرکتها گزینه اصلی است؛ ابزارهای Anthropic (شامل Claude Console و Workbench) در ۱۶ درصد زیرساختها حاضر بوده و برای ۱۰ درصد پلتفرم اول است؛ و در نهایت LangSmith در ۱۳ درصد سیستمها به کار رفته و برای ۲ درصد پلتفرم اصلی به شمار میرود.
برای هماهنگی آماری، مقایسه جدول زیر بر پایه همان ۱۳۶ پاسخدهنده ماه آگوست است که به هر دو پرسش مربوط به ابزارها پاسخ دادهاند:
پلتفرم | میزان استفاده در زیرساخت | پلتفرم اصلی ارزیابی |
|---|---|---|
پلتفرم توسعهدهندگان OpenAI | ۵۹٪ | ۴۰٪ |
Confident AI (ابزار DeepEval) | ۳۶٪ | ۱۰٪ |
Braintrust | ۲۳٪ | ۱۲٪ |
کنسول و ورکبنچ Anthropic Claude | ۱۶٪ | ۱۰٪ |
LangSmith | ۱۳٪ | ۲٪ |
پاسخدهندگان میتوانستند چند ابزار را به عنوان ابزارهای فعال خود نام ببرند، اما فقط یک پلتفرم را به عنوان گزینه اصلی انتخاب کردند؛ به همین دلیل مجموع درصدهای استفاده بیشتر از ۱۰۰ است.
چشمگیرترین تغییر ماهانه در این بخش، افزایش شدید استفاده از پلتفرم OpenAI از ۳۱ درصد به ۵۹ درصد بوده است. میزان استفاده از Confident AI نیز از ۲۷ درصد در جولای به ۳۶ درصد در آگوست رسیده، هرچند این افزایش از نظر آماری چندان معنادار نبود.
سهم پلتفرمهای اصلی بین دو ماه مقایسه نشده است، چرا که در ماه جولای شرکتکنندگان میتوانستند پلتفرمی را به عنوان گزینه اصلی انتخاب کنند که پیشتر نامش را در ابزارهای مصرفی نیاورده بودند، که مقایسه دقیق را پیچیده میکرد.
در نقشه راه زیرساختی شرکتها، ۶۲ درصد از پاسخدهندگان آگوست اعلام کردند که ظرف ۱۲ ماه آینده قصد دارند یک پلتفرم ارزیابی جدید، تکمیلی یا جایگزین را به خدمت بگیرند. جالبتر اینکه بیش از یکسوم آنها (۳۵ درصد) تصمیم دارند ظرف ۳ ماه آینده این کار را عملی کنند.
این برنامهریزی لزوماً به این معنا نیست که سازمانها از ارائهدهندگان فعلی خود ناراضیاند یا میخواهند آنها را کنار بگذارند؛ بلکه شامل شرکتهایی میشود که به دنبال اضافه کردن ابزارهای کمکی در کنار پلتفرم فعلی خود هستند.
با این حال برای شرکتهای ارائهدهنده خدمات، این موضوع زنگ هشداری است درباره تفاوت میان «پیشران اصلی زیرساخت بودن» یا «صرفاً ابزاری فرعی بودن». با بلوغ فناوری، این تمایز میتواند ریسک تمدید نکردن قراردادها را بالا ببرد.
البته این نظرسنجی به طور مستقیم نرخ تمدید یا ترک مشتریان را نمیسنجد، بلکه صرفاً چشماندازی از پویایی و رقابت شدید در بازار ابزارها ترسیم میکند.
شکاف اعتماد به هوش مصنوعی سازمانی؛ تحول به جای ناپدید شدن
یافتههای ماه آگوست نشاندهنده یک تضاد آشکار در بازار هوش مصنوعی سازمانی است: شرکتها زیرساختهای ارزیابی را با اشتیاق تجهیز میکنند، اما همزمان برای تکیه بر این تستهای خودکار جهت استقرار تغییرات در محیط پروداکشن، به شدت دستبهعصا شدهاند.
درصد سازمانهای مجهز به ایجنتهای خودران که اجازه استقرار بدون تایید انسان را صادر میکردند یا روی آن کار میکردند، افتی محسوس را تجربه کرده و از ۷۵ درصد به ۵۶ درصد رسیده است. در مقابل، سهم شرکتهایی که قصد دارند تایید نهایی انسان را تا آینده قابلپیشبینی حفظ کنند، بیش از دو برابر شده و از ۲۰ درصد به ۴۲ درصد جهش کرده است.
همزمان، اکثر سازمانهایی که پیش از استقرار ارزیابی انجام میدهند، حداقل یک مورد خرابکاری زنده جلوی چشم مشتریان را پس از پاس شدن تستها گزارش کردهاند؛ این در حالی است که تنها ۲۹ درصد از آنها بررسی لحظهای کیفیت خروجی را روش اصلی مانیتورینگ خود قرار دادهاند.
این شواهد حکایت از شکافهایی جدی در سیستمهایی دارد که شرکتها برای سنجش اطمینان ایجنتها به آنها اعتماد کردهاند. البته این دادهها ثابت نمیکنند که ارزیابیها ناکارآمدتر شدهاند یا صرفاً خرابکاریها باعث این احتیاط شده است.
نکته مهم این است که سازمانها ابزارهای ارزیابی را کنار نگذاشتهاند؛ بلکه استقبال از ابزارهای OpenAI به شدت اوج گرفته و نزدیک به دوسوم شرکتها به دنبال افزودن یا تغییر پلتفرمهای ارزیابی خود در یک سال آینده هستند.
پیام صریح این دادهها برای تیمهای هوش مصنوعی سازمانی این است: خودکارسازی فرایند ارزیابی یک چیز است، و خودکارسازی مجوز ورود به محیط پروداکشن چیزی کاملاً متفاوت؛ پیامد اشتباه در این دو زمین تا آسمان فرق میکند.
با توجه به اینکه ایجنتها روزبهروز توانایی دستکاری سیستمهای تجاری حساستری را پیدا میکنند، شرکتها باید تصمیم بگیرند نه فقط اینکه آیا ارزیابیهای خودکار سودمند هستند یا نه، بلکه چه زمانی نتایج آنها به اندازهای قابل اتکا خواهد بود که حذف نظارت نهایی انسان را توجیه کند.
نظرسنجی اخیر نشان میدهد که برای بخش فزایندهای از سازمانها، این مرز اطمینان هنوز به دست نیامده است.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
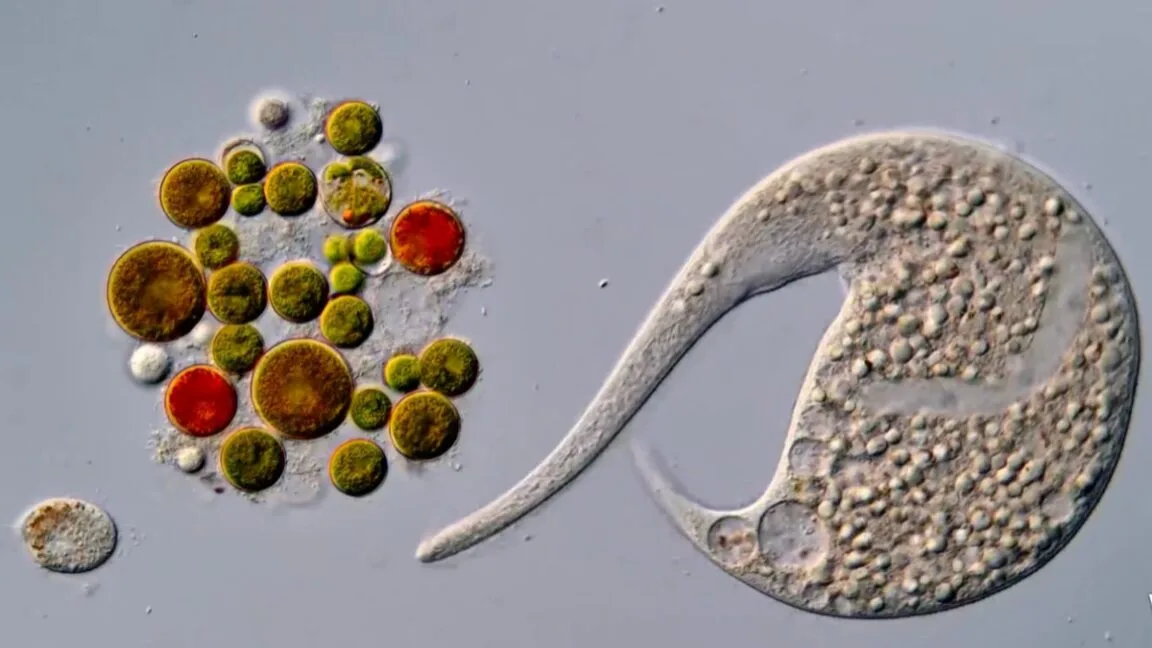
جنجال هوش مصنوعی در مسابقه ویدیویی نیکون؛ برنده رتبه اول رد صلاحیت شد!
مسابقه ویدیویی معتبر «دنیای کوچک» نیکون با یک رسوایی بزرگ روبهرو شد؛ اثری که به مقام اول رسیده بود به دلیل استفاده پنهانی از هوش مصنوعی مولد رد صلاحیت شد تا جایزه به یک ویدیوی شگفتانگیز از دنیای تکسلولیها برسد. این ماجرا نیکون را بر آن داشت تا با توجه به پیشرفت شتابان هوش مصنوعی، قوانین داوری خود را به شکل اساسی بازنگری کند.
عصر طلایی دکاکورنها؛ سرمایهگذاران با سرعتی بیسابقه استارتاپهای هوش مصنوعی را ۱۰ میلیارد دلاری میکنند!
دنیای فناوری وارد عصر طلایی «دکاکورنها» شده و استارتاپهای هوش مصنوعی سریعتر از هر زمان دیگری به ارزشهای نجومی بالای ۱۰ میلیارد دلار میرسند. در حالی که سرمایهگذاران خطرپذیر مبالغ هنگفتی را به پای این شرکتها میریزند، کارشناسان هشدار میدهند که این تبوتاب همیشه تضمینکننده موفقیت بلندمدت نیست.
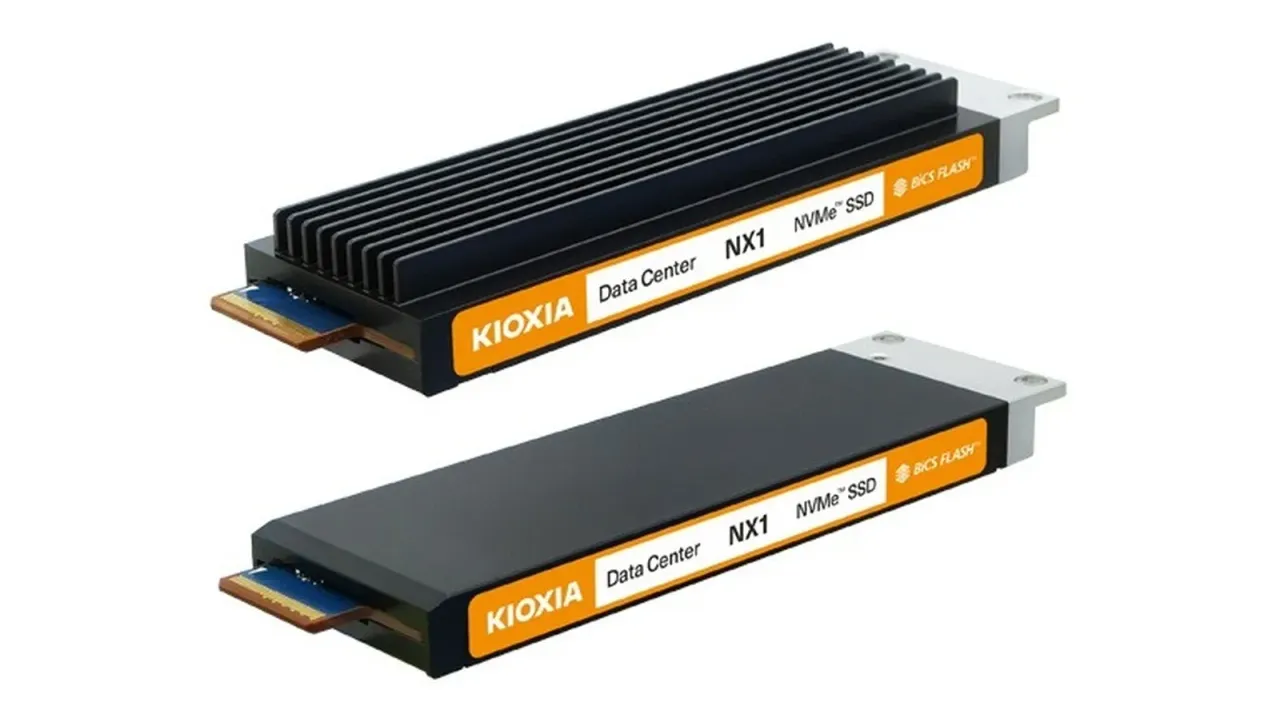
خداحافظی با داغ کردن حافظهها در دیتاسنترهای هوش مصنوعی؛ رونمایی کیوکسیا از SSDهای مجهز به خنککننده مایع
شرکت ژاپنی کیوکسیا از درایوهای SSD جدیدی با نام NX1 رونمایی کرده که به خنککننده مایع مجهز هستند و اختصاصاً برای پاسخگویی به فشار سنگین دیتاسنترهای هوش مصنوعی ساخته شدهاند. این درایوها با مهار هوشمندانه حرارت، جلوی افت ناگهانی سرعت و کاهش طول عمر قطعات را در پردازشهای فوقسنگین میگیرند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.