روش جدید GG-EZ، نقطه کور مدلهای هوش مصنوعی در شناخت فرهنگهای بومی را برطرف میکند
بسیاری از مدلهای هوش مصنوعی بهدلیل اتکا به دادههای وب غربی، در شناخت محیط و فرهنگهای بومی سراسر جهان دچار خطا میشوند. پژوهشگران با معرفی روش کمهزینه GG-EZ موفق شدهاند بدون کاهش کارایی عمومی مدلها، دقت آنها در درک نمادها و واقعیتهای فرهنگی جنوب شرق آسیا را تا ۱۵ درصد بهبود بخشند.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- مدلهای پیشروی بینایی و زبانی بهدلیل غلبه دادههای آموزشی غربی، در درک صحیح بازارها، فرهنگ و نمادهای بومی سایر مناطق جهان دچار اشتباه میشوند.
- پژوهشگران آسیایی با معرفی چارچوب ارزیابی منطقهای و روش GG-EZ، شناخت مدلهای هوش مصنوعی از ویژگیهای بومی را ۵ تا ۱۵ درصد ارتقا دادند.
- روش GG-EZ با ترکیب پالایش هوشمند دادهها و ادغام مدلها، امکان سازگارسازی فرهنگی را بدون افت تواناییهای عمومی و بدون نیاز به آموزش از پایه فراهم میکند.
مدلهای پیشروی بینایی و زبان دادههای خود را از وب جمعآوری میکنند؛ فضایی که در آن اطلاعات مربوط به آمریکای شمالی و اروپای غربی حضور بسیار پررنگتری دارد. در نتیجه این سوگیری، چنین مدلهایی ممکن است یک مغازه شیرینیفروشی در نیویورک را با جزئیات کامل و دقیق توصیف کنند، اما در تشخیص یک بازارچه شبانه در تایلند، خودروهای بومی فیلیپین یا دکه فروش میوههای محلی دچار اشتباه شوند. این قبیل خطاها کیفیت قابلیت ساخت شرح تصاویر، پاسخ به سؤالات تصویری، بازیابی اطلاعات و تولید تصویر از متن را بهشدت کاهش میدهند.
در همین راستا، تیمی متشکل از پژوهشگران جنوب شرق آسیا چارچوبی برای سنجش این شکافهای جغرافیایی و روشی کمهزینه و سبک برای برطرف کردن آنها ارائه دادهاند. پژوهشگران در مقاله پژوهشی خود، چارچوب ارزیابی را Anthropogenic Regional Adaptation و روش انطباق حاصل را GG-EZ نامگذاری کردهاند که مخفف عبارت «سادهسازی تعمیم جغرافیایی» است. نتایج آزمایشها روی سه خانواده مختلف از مدلها نشان میدهد که میزان درک فرهنگی مدلها بین ۵ تا ۱۵ درصد بهبود یافته، در حالی که بیش از ۹۸ درصد از کارایی کلی آنها در بنچمارکهای جهانی دستنخورده باقی مانده است.
غلبه دادههای غربی نقاط کور منطقهای ایجاد میکند
مدلهای درک تصویر، توزیع جغرافیایی دادههایی را که با آنها آموزش دیدهاند به ارث میبرند. این مدلها ممکن است اشیای خاص بومی را با برچسبهای بسیار کلی جایگزین کنند، در تشخیص پوشش یا سبک معماری سنتی به خطا بیفتند، یا تصاویری مرتبط با فرهنگهای غربیتر را بهجای آنها بازگردانند. مدلهای مولد هوش مصنوعی نیز رفتاری مشابه نشان میدهند و در پاسخ به درخواستهای مربوط به جشنها، بازارها، خانهها و مناظر سنتی سایر نقاط جهان، ناخواسته المانها و زیباییهای بصری غربی را بازتولید میکنند.
استفاده از یک بنچمارک عمومی و جهانی معمولاً این نقاط ضعف را پنهان میکند، زیرا عملکرد عالی مدل روی دادههای غربی، میانگین کل امتیازات را بالا میکشد. چارچوب سنجش Anthropogenic Regional Adaptation عملکرد مدل را در شناخت افراد، اشیا، زبانها و محیطهای اختصاصی یک منطقه میسنجد و همزمان بررسی میکند که آیا سازگارسازی بومی به تواناییهای عمومی مدل آسیب میزند یا خیر. این رویکرد به توسعهدهندگان اجازه میدهد تا بهجای یک نمره کلی و گمراهکننده، ارزیابیهای تفکیکشدهای از عملکرد محلی و جهانی در اختیار داشته باشند.
سازگارسازی مدلها در سه مرحله با روش GG-EZ
روش GG-EZ سه گام شامل پالایش دادهها، فاینتیون نظارتشده و ادغام خطی مدلها را با یکدیگر ترکیب میکند. هر مرحله از تکنیکهای اثباتشده و شناختهشده بهره میگیرد تا تیمهایی که توان مالی یا زیرساخت لازم برای آموزش کامل یک مدل از پایه را ندارند، بتوانند بهراحتی از این فرایند استفاده کنند.
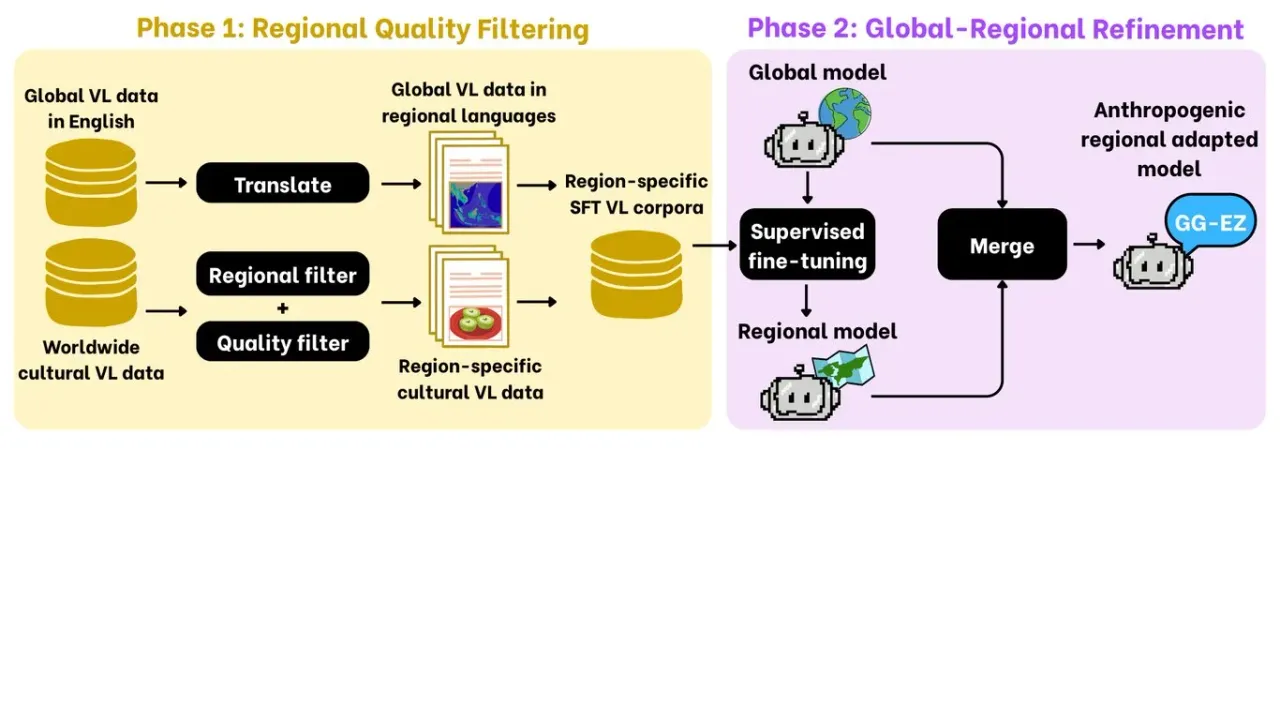
- پالایش دادههای منطقهای: این خط لوله ابتدا تصویرها و متنهایی را که وابستگی جغرافیایی دارند انتخاب میکند و سپس با ابزار سنجش کیفی مبتنی بر مدل به نام UnifiedReward، فیلترهای مشخصی را روی آنها اعمال مینماید. در آزمایشهای مربوط به جنوب شرق آسیا، محققان دادههای دستوری انگلیسی را نیز به زبانهای اصلی منطقه ترجمه کردند.
مطالب مرتبط و پیشنهادی
معرفی فریمورک SpecPilot؛ جهش ۱۰ برابری سرعت اجرای مدلهای زبانی بدون افت کیفیت
پژوهشگران دانشگاههای برکلی، پرینستون، استنفورد و شرکت انویدیا از فریمورک SpecPilot رونمایی کردند که با بهرهگیری از ایجنتهای کاوشگر، سرعت رمزگشایی حدسی مدلهای زبانی را تا بیش از ۱۰ برابر افزایش میدهد. این سیستم خودکار بدون نیاز به آموزش مجدد و بدون کوچکترین افت کیفیت خروجی، گلوگاههای پردازشی را برطرف میکند.
فریمورک متنباز CoworkOS رونمایی شد؛ ابزاری برای همکاری پایدار انسان و ایجنتهای هوش مصنوعی
محققان آزمایشگاه RUC-NLPIR از فریمورک متنباز CoworkOS برای تسهیل همکاری بلندمدت میان انسان و ایجنتهای هوشمند رونمایی کردند. این سامانه با معماری سهلایهای و ذخیرهسازی محلی فایلها، امکان ویرایش مشترک اسناد، ارائهها و پروژههای سهبعدی را بدون از دست رفتن حافظه مدل فراهم میکند.
اشنایدر الکتریک: مالکان دیتاسنترها علاوه بر مجوز ساخت، به جلب اعتماد مردم نیاز دارند
شرکت اشنایدر الکتریک اعلام کرد با وجود مخالفتهای فزاینده عمومی، ساخت دیتاسنترها با شتاب ادامه دارد، اما اپراتورها باید درباره مصرف آب، برق و زمین با مردم شفافتر باشند. به باور مدیران این شرکت، توسعه مراکز داده هوش مصنوعی اکنون بیش از هر چیز به جلب اعتماد جوامع محلی و سنجش کارایی بر پایه پردازش توکنها وابسته است.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.