گیتهاب مدلهای زبانی را کنار گذاشت؛ کاهش ۹۸ درصدی هزینه شناسایی اطلاعات حساس با ModernBERT
گیتهاب سیستم اسکن کدهای حساس خود را با جایگزینی مدلهای زبانی بزرگ با انکودر بهینهشده ModernBERT متحول کرد. این تغییر نه تنها دقت شناسایی کلیدهای امنیتی را افزایش داده و هشدارهای اشتباه را کاهش میدهد، بلکه هزینههای عملیاتی را بیش از ۹۸ درصد کم کرده است.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- گیتهاب با کنار گذاشتن مدلهای زبانی بزرگ و مهاجرت به مدل اختصاصی ModernBERT، هزینه اجرای سیستم تشخیص کلیدهای امنیتی را بیش از ۹۸ درصد کاهش داد.
- مدل جدید با داشتن حدود ۱۰۰ میلیون پارامتر، سرعت اسکن کدها را ۸۶ درصد افزایش داده و امکان مسدودسازی رمزهای افشاشده را در همان لحظه بارگذاری فراهم کرده است.
- استفاده هوشمندانه از الگوهای متنی سریع در کنار هوش مصنوعی، دقت تشخیص را ۱۳ درصد و نرخ پوشش کلیدهای حساس را ۱۹ درصد بهبود بخشیده است.
گیتهاب مدل زبانی بزرگ پیشین خود را در سیستم شناسایی اطلاعات حساس و عمومی، با یک انکودر کوچکتر و بهینهسازیشده به نام ModernBERT جایگزین کرد. طبق گزارش فنی منتشرشده از سوی گیتهاب، این مدل دستهبندیکننده جدید کدهای افشاشده بیشتری را پیدا میکند، هشدارهای اشتباه کمتری تولید میکند، زمان پاسخدهی بسیار سریعتری دارد و هزینه اجرای آن بهشکل چشمگیری پایینتر است.
گیتهاب برای سنجش دقیق کارایی، خطوط پردازش جدید و قبلی را روی ترافیک واقعی کدهای عمومی پس از بارگذاری (Post-push) بررسی کرد. سپس در قالب یک آزمایش مقایسهای A/B در میان کاربران، نحوه برخورد مالکان مخازن کد با هشدارهای ارسالی را زیر نظر گرفت.
شاخص | میزان تغییرات گزارششده | روش ارزیابی |
|---|---|---|
دقت تشخیص (Precision) | ۱۳ درصد افزایش | بررسی ترافیک عمومی پس از بارگذاری |
نرخ پوشش (Recall) | ۱۹ درصد افزایش | بررسی ترافیک عمومی پس از بارگذاری |
پذیرش هشدارها توسط مالکان مخازن | ۱۱٫۵ درصد افزایش | آزمایش مقایسهای A/B روی کاربران |
زمان اجرای بررسی کدها (Latency) | ۸۶ درصد کاهش | خط لوله عملیاتی در مرحله تولید |
هزینه اجرا و میزبانی مدل | بیش از ۹۸ درصد کاهش | خط لوله عملیاتی در مرحله تولید |
شاخص دقت یا Precision نشان میدهد چه میزان از مواردی که سیستم بهعنوان اطلاعات حساس شناسایی کرده، واقعاً کلیدها و اطلاعات محرمانه معتبر بودهاند. شاخص پوشش یا Recall نیز مشخص میکند سیستم توانسته چه درصدی از کل اطلاعات حساس موجود را پیدا کند. گیتهاب برای جلوگیری از سوگیری در نتایج آزمایش A/B، میزان پذیرش هشدارها را بر اساس مالکان مخازن وزندهی کرد تا کاربرانی که تعداد بسیار زیادی هشدار را یکجا تأیید یا رد میکنند، نتیجه کلی را منحرف نکنند.
چرا الگوهای متنی، هشها را با کلیدهای امنیتی اشتباه میگیرند؟
بسیاری از کلیدها و توکنهای اختصاصی که توسط ارائهدهندگان خدمات صادر میشوند، پیشوندهای مشخص، طول ثابت، ساختار الفبایی معین یا کد اعتبارسنجی (Checksum) دارند. در مقابل، اطلاعات حساس و توکنهای عمومی فاقد این نشانههای اختصاصی هستند؛ به همین دلیل، سیستمهای اسکن کد مجبورند این کلیدها را از شناسههای بیلد، هشهای فایلها، مقادیر آزمایشی و متون نمونه در فایلهای آموزشی که ساختار ظاهری کاملاً مشابهی دارند، تشخیص دهند.
تیمهای امنیتی این موارد فریبنده را «منفیهای کاذبِ دشوار» یا Hard Negatives مینامند؛ یعنی مقادیری که از نظر الگو شبیه کلید دسترسی هستند، اما هویت امنیتی واقعی ندارند. تعریف استثناهای بیشتر در الگوهای متنی regex میتواند مانع ثبت این هشدارهای اشتباه شود، اما هر استثنای جدید ممکن است چشم سیستم را روی یک رخنه امنیتی واقعی و خطرناک نیز ببندد.
فیلتر سریع اولیه و سپس تحلیل متن و بستر کد
گیتهاب برای حفظ سرعت و پوشش بالا، همچنان از عبارات باقاعده (regex) در گام نخست استفاده کرد و بررسی موارد مشکوک را به مدل ModernBERT سپرد؛ به این ترتیب، تطبیق سریع الگوها حفظ شده و از تحلیل کدهای اطراف برای حذف هشدارهای اشتباه استفاده میشود. این خط پردازش در مرحله عملیاتی از دو بخش تشکیل شده است:
- تولید کاندیداها: فیلترهای regex محتوای مخزن کد را برای پیدا کردن رشتههایی شبیه به رمزها و کلیدها اسکن میکنند. در این مرحله، پوشش حداکثری در اولویت است؛ چراکه اگر موردی جا بماند، هرگز به دست مدل هوش مصنوعی نخواهد رسید.
- دستهبندی هوشمند بر اساس بستر کد: مدل ModernBERT هر کاندیدا را بههمراه مسیر فایل، نوع احتمالی کلید و کدهای اطراف ارزیابی میکند و سپس تشخیص میدهد که آیا این مقدار یک کلید دسترسی واقعی است یا خیر.
این انکودر ورودی خود را به یک نمایش عددی برداری تبدیل کرده و مستقیماً نتیجه دستهبندی را بازمیگرداند؛ در نتیجه نیازی به محاسبات سنگین تولید متن مشابه مدلهای زبانی ندارد. در این فرآیند، کلمات کلیدی موجود در متن مانند example، dummy، fake یا replace-me به شناسایی نمونههای آموزشی و غیرواقعی کمک میکنند؛ در حالی که انتساب یک مقدار به متغیرهای محیطی در فایلهای استقرار، نشاندهنده یک کلید دسترسی واقعی و فعال است.
آموزش مدل با اتکا بر خطاهای پیشین سیستم اسکن
گیتهاب دادههای آموزشی خود را بر پایه مواردی جمعآوری کرد که معمولاً سیستمهای اسکن را به اشتباه میاندازند. این مجموعهداده از ترکیب نمونههای واقعی مخازن، الگوهای گسترده regex و حالتهای مرزی تولیدشده تشکیل شده است:
- نمونههای برگرفته از محیط عملیاتی: دادههای واقعی از مخازن کد که توسط ناظران انسانی بازبینی و تأیید شدهاند.
- کاندیداهای با پوشش بالا: خروجی الگوهای regex که از طریق برچسبگذاری انسانی و یادگیری با نظارت ضعیف (Weak Supervision) آماده شدهاند؛ روشی که در آن قواعد و سیگنالهای کمکی، برچسبگذاری انبوه را ممکن میسازند.
- نمونههای مصنوعی: دادههای ساختگی شامل مستندات آموزشی، فایلهای تست، کدهای اعتبارسنجی، متغیرهای فرضی و مقادیری که بهشدت شبیه کلیدهای معتبر هستند.
دادههای مصنوعی پیش از ورود به مجموعه آموزشی، از فیلترهای کنترلی دقیق و بررسی کیفی مبتنی بر مدلهای هوش مصنوعی عبور میکنند. هر ورودی مدل شامل مقدار کاندیدا، مسیر فایل، نوع احتمالی کلید امنیتی و پنجره مشخصی از کدهای اطراف است.
گیتهاب پیش از تقسیم دادهها به بخشهای آموزش و آزمون، دادههایی را که متعلق به یک مخزن مشترک، مقدار مشابه یا منبع یکسان بودند دستهبندی کرد. این ساختاربندی مانع از ورود دادههای تکراری یا بسیار نزدیک به بخشهای ارزیابی میشود و از بروز خطای نشت دادهها (Data Leakage) و نمایش غیرواقعی دقت مدل جلوگیری میکند.
برای بهکارگیری مدل در مقیاس وسیع عملیاتی، گیتهاب مدل آموزشدیده را به فرمت استنتاجی ONNX منتقل کرده و از کوانتایزیشن ۸ بیتی بهره برده است. فرمت ONNX اجرای پرتابل و سریع مدل را ممکن میسازد و کوانتایزیشن نیز با کاهش حجم محاسبات و حافظه مصرفی، پردازش را بسیار بهینهتر میکند.
کاهش چشمگیر تأخیر و انتقال بررسی به زمان بارگذاری کد
کاهش ۸۶ درصدی در زمان پردازش، بررسی کدهای حساس را در همان لحظه بارگذاری (Push) ممکن ساخت؛ قابلیتی که به گیتهاب اجازه میدهد پیش از نهایی شدن تغییرات در مخزن، نتیجه بررسی را اعلام کند. پیش از این، سنگینی خط پردازش مبتنی بر مدلهای زبانی بزرگ سبب میشد این ارزیابی عمدتاً پس از ثبت نهایی کد در مخازن انجام پذیرد.
- قابلیت Push Protection: تغییرات را در همان لحظه ارسال کد بررسی میکند و مانع از ورود اطلاعات حساس به مخازن میشود.
- اسکن پس از بارگذاری (Post-push): محتوای مخازن را بهطور پیوسته تحلیل کرده و در صورت کشف موارد امنیتی، هشدارهایی را برای بررسی توسعهدهندگان و تیمهای امنیت صادر میکند.
تیمهایی که در حال حاضر از سیستم اسکن کدهای حساس یا مستندات قابلیت Push Protection استفاده میکنند، این تغییرات را با دریافت نتایج سریعتر و هشدارهای اشتباه بسیار کمتر تجربه خواهند کرد. همچنین تحلیل گیتهاب درباره امنیت کدهای حساس نشان میدهد با افزایش حجم تولید کد توسط ابزارهای کمکی هوش مصنوعی نظیر GitHub Copilot، احتمال افشای تصادفی اطلاعات و کلیدهای محرمانه نیز افزایش یافته و نیاز به چنین ابزارهای کارآمدی را دوچندان کرده است.
یک مدل تخصصی برای مأموریتی ویژه
انکودر اختصاصی گیتهاب با حدود ۱۰۰ میلیون پارامتر، در تمام شاخصها از جمله دقت، پوشش، زمان پاسخدهی و هزینه میزبانی نسبت به خط لوله پیشین مبتنی بر مدلهای زبانی بزرگ عملکرد بهتری ثبت کرد. این مأموریت ویژگیهایی دارد که استفاده از یک مدل دستهبندی تخصصی را توجیه میکند: خروجی شفاف و معین، دادههای برچسبخورده فراوان، اطلاعات زمینهای مفید در اطراف کد و حجم بسیار بالای درخواستها در طول روز.
این معماری میتواند الگوی مناسبی برای سایر سیستمهای دستهبندی در مقیاس بزرگ باشد؛ سیستمهایی که ابتدا کاندیداها را با روشهای کمهزینه فیلتر کرده و سپس ابهام موجود را بر اساس کدهای اطراف برطرف میکنند. موفقیت این شیوه به آموزش دقیق روی دادههای منفی دشوار، ارزیابی بدون نشت داده و آمادهسازی بهینه مدل برای استفاده در محیط عملیاتی وابسته است.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
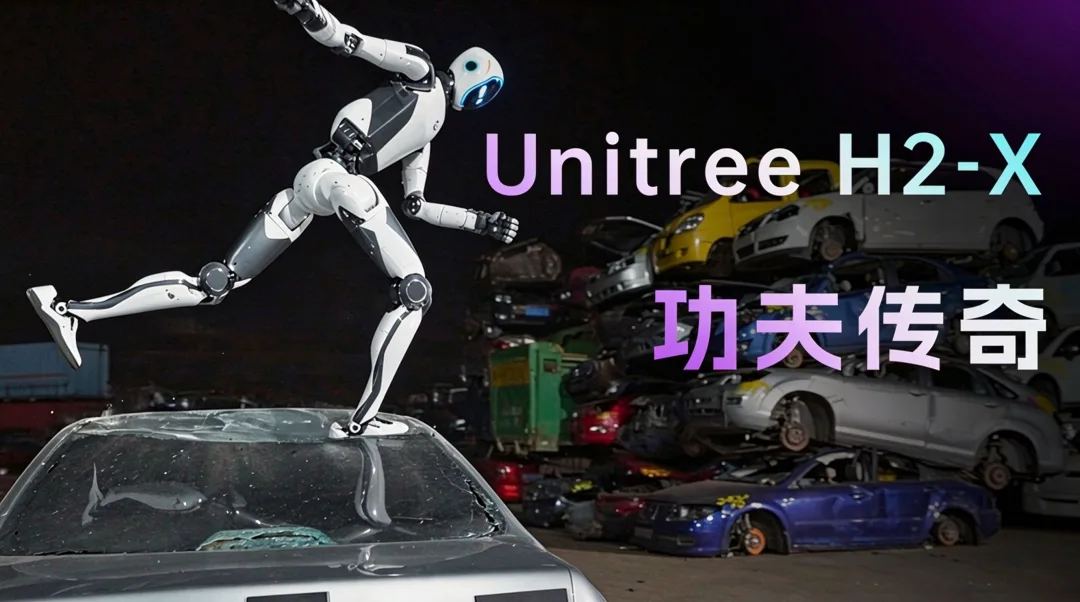
پای ربات انساننمای H2-X شرکت Unitree در حین اجرای نمایش زنده شکست و جدا شد
ربات انساننمای جدید H2-X ساخت شرکت Unitree تنها یک روز پس از رونمایی رسمی، در جریان اجرای حرکات آکروباتیک در نمایشگاه هوش مصنوعی با حادثه روبهرو شد و یکی از پاهای مکانیکی آن پس از فرود ناموفق کاملاً جدا شد. این اتفاق بار دیگر چالشهای بزرگ پایداری سختافزاری و الگوریتمهای حرکتی را در مسیر تجاریسازی رباتهای انساننما به تصویر کشید.
۸ مهارت شغلی حیاتی برای موفقیت در عصر هوش مصنوعی تا سال ۲۰۲۷
در دنیای کار تا سال ۲۰۲۷، تنها کار با ابزارهای هوش مصنوعی تضمینکننده پیشرفت شغلی نخواهد بود. با فراگیر شدن این فناوری، مزیت رقابتی از آن کسانی است که توانایی راستیآزمایی پاسخها، تفکر انتقادی و قضاوت مستقل انسانی دارند. بررسی روندهای بازار کار نشان میدهد که مهارتهای غیرقابل خودکارسازی بیش از هر زمان دیگری ارزشمند میشوند.
تیم Nous Research ۱۸ افزونه رسمی عامل هوشمند Hermes Agent را در یک مخزن متنباز یکپارچه کرد
تیم Nous Research با انتشار مخزن رسمی hermes-official-plugins، مجموعهای شامل ۱۸ افزونه اختصاصی برای عامل هوشمند Hermes Agent را تحت مجوز متنباز MIT یکپارچه کرد. توسعهدهندگان اکنون میتوانند تنها با یک دستور ساده، قابلیتهای متنوعی از کنترل خانه هوشمند گرفته تا ابزارهای چندرسانهای و ارتباط مستقیم با Claude را به این عامل اضافه کنند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.