انقلاب حریم خصوصی گوگل در Gboard: آموزش مدلهای هوش مصنوعی به سرورهای فوقامنیتی TEE منتقل شد
گوگل در اقدامی تازه، شیوه آموزش مدلهای هوش مصنوعی کیبورد Gboard را متحول کرده و به جای پردازش روی گوشی کاربران، از محیطهای ابری فوقامنیتی موسوم به TEE استفاده میکند. این معماری جدید با ترکیب رمزنگاری دادهها و حریم خصوصی تفاضلی، سرعت آموزش هوش مصنوعی را به شکل چشمگیری افزایش میدهد و خیال کاربران را از محرمانه ماندن اطلاعات شخصی کاملاً راحت میسازد.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- گوگل معماری یادگیری فدرال (Federated Learning) کیبورد محبوب Gboard رو ارتقا داده و حالا به جای فشار آوردن به گوشی کاربرها، دادههای رمزگذاریشده رو برای آموزش مدل تو سرورهای فوقامنیتی و ایزوله پردازش میکنه.
- تو سیستم قبلی، آموزش هوش مصنوعی برای پیشبینی کلمات بعدی انگلیسی و ژاپنی ۱ تا ۲ ماه طول میکشید؛ چون سیستم منتظر میموند تا گوشیها بیکار و به شارژر وصل بشن، ولی معماری جدید این محدودیت رو کلاً برداشته.
- گوگل برای اثبات ادعای امنیت و حریم خصوصی، کدهای این زیرساخت رو در قالب دو مخزن متنباز منتشر کرده تا محققها بتونن دستکاری نشدن دادهها و صحت الگوریتمهای حریم خصوصی تفاضلی رو اعتبارسنجی کنن.
انتقال یادگیری فدرال گوگل به محفظههای امن سرور (TEE)
گوگل از استک جدیدی برای سیستم یادگیری فدرال (Federated Learning) پرده برداشته که نمونههای آموزشی رمزگذاریشده را از گوشیها دریافت میکند و محاسبات مربوط به آموزش مدل را مستقیماً داخل محیطهای اجرای امن سرور (معروف به TEE) انجام میدهد. بر اساس آنچه در پست وبلاگ فنی گوگل آمده، این سیستم پیشرفته در حال حاضر برای آموزش مدلهای هوش مصنوعی پیشبینی کلمه بعدی در کیبورد Gboard برای زبانهای انگلیسی و ژاپنی به کار گرفته شده است.
در معماری اولیه یادگیری فدرال گوگل، نمونههای دادههای آموزشی کلاً روی گوشی کاربران باقی میماندند. خود گوشیها محاسبات آپدیت مدل را به صورت محلی انجام میدادند و مکانیزمی به نام «تجمیع امن» (Secure Aggregation) مانع از آن میشد که سرور بتواند بهروزرسانیهای تکی هر گوشی را قبل از ترکیب نهایی مشاهده کند. این ترفند دسترسی سرور مرکزی به دادههای خصوصی کاربران را عملاً به صفر میرساند، اما یک دردسر بزرگ داشت: همهچیز به روشن بودن، بیکار بودن و قدرت پردازشی گوشی کاربران وابسته بود که فرآیند آموزش را بسیار کند میکرد. از طرفی، بازرسان و ممیزان امنیتی خارجی هم مدرک چندانی نداشتند تا بررسی کنند آیا نرمافزار سمت سرور واقعاً استانداردهای حریم خصوصی را موبهمو رعایت میکند یا نه.
حالا در استک جدید، مرز حفاظت از دادههای محرمانه از روی گوشی به سختافزارهای تأییدشده سرور منتقل شده است. یعنی گوشیها همچنان دادهها را به شکل غیرمتمرکز تولید میکنند، اما نمونههای رمزگذاریشده از دستگاه خارج میشوند. از آن طرف، سرویس مدیریت کلید فقط زمانی کلیدهای رمزگشایی را در اختیار سرور میگذارد که ترافیک پردازشی متعلق به TEEهای مورد تأیید باشد؛ سپس این پردازندههای امن قبل از اینکه وزنهای جدید مدل از محفظه امن خارج شوند، مکانیزم «حریم خصوصی تفاضلی» (Differential Privacy) را روی آنها پیاده میکنند تا هیچ داده خامی لو نرود.
بخش | معماری قبلی | معماری جدید |
|---|---|---|
دادههای آموزشی | نمونهها روی دستگاه کاربر باقی میمانند. | دستگاهها نمونههای رمزگذاریشده محلی را آپلود میکنند. |
محاسبات مدل | گوشیها بهروزرسانیها را محاسبه میکنند. | محیطهای TEE سمت سرور محاسبات را انجام میدهند. |
دسترسی سرور | روش تجمیع امن (Secure Aggregation) بهروزرسانیهای تجمیعی را نشان میدهد. | تنها معیارهای تأییدشده و وزنهای مجهز به حریم خصوصی تفاضلی از محیط امن خارج میشوند. |
اعتبارسنجی | بازرسان میتوانند پروتکلهای منتشرشده و کدهای کلاینت را بررسی کنند. | بازرسان علاوه بر آن میتوانند سیاستهای کاری، باینریهای بازتولیدپذیر و تأییدیههای TEE را بازرسی کنند. |
گلوگاه اصلی | در دسترس بودن گوشیها و توان پردازشی دستگاه. | ظرفیت TEE و موازیسازی سمت سرور. |
پنج مرحله برای اعمال سختگیرانه سیاستهای دسترسی
- آپلود رمزگذاریشده: کلاینت (گوشی کاربر) نمونههای آموزشی را به شکل محلی رمزگذاری میکند و یک سیاست دسترسی به آنها پیوست مینماید. این سیاست مشخص میکند دقیقاً کدام بارهای کاری امن اجازه پردازش دادهها را دارند و دسترسی آنها تا چه زمانی معتبر خواهد بود.
- ثبت عمومی: این سیاستهای دسترسی در Rekor که یک لاگ شفافیت عمومی است ثبت میشوند؛ به طوری که ممیزان امنیتی میتوانند لیست دقیق پردازشهایی را که دستگاهها به آنها میپیوندند رصد کنند.
- آزادسازی کلید با اعتبارسنجی: سرویس مدیریت کلید روی خوشهای از TEEها و بر پایه پروتکل اجماع Raft اجرا میشود. این سرویس کلیدهای رمزگشایی را تنها پس از تأیید اینکه محیط پردازشی درخواستکننده دقیقاً با سیاستهای مجاز همخوانی دارد، آزاد میکند.
- اجرای محرمانه: یک TEE ریشه (Root TEE) حلقه اصلی آموزش پایتون را اجرا کرده و بارهای کاری موازی را به TEEهای کارگر (Worker TEEs) میسپارد. گوگل هماهنگی این پردازشها را با فریمورک Federated Language (نسخه نسل جدید و متنباز TensorFlow Federated) انجام میدهد.
- بازیابی محافظتشده: برنامه پس از هر دور آموزش، وضعیت بازیابی را به صورت رمزگذاریشده ذخیره میکند. بنابراین در صورت بروز هرگونه قطعی یا خرابی، بار کاری جایگزین میتواند بدون افشای چکپوینتهای متنی ساده و بدون رمز، کار را از همان نقطه ادامه دهد.
تأییدیه دیجیتال (Attestation) دایره اعتماد را محدودتر میکند
محیطهای اجرای معتمد یا TEE سه ویژگی حیاتی فراهم میکنند: اعتبارسنجی از راه دور (Remote Attestation)، حافظه محرمانه و یکپارچگی در اجرا. اعتبارسنجی از راه دور به سیستمهای دیگر اجازه میدهد هویت و پیکربندی کدی را که روی سختافزار در حال اجراست موشکافی و تأیید کنند. محرمانگی نیز حالت داخلی بار کاری را از سیستم میزبان پنهان میکند و قابلیتهای یکپارچگی مانع از آن میشوند که سرور میزبان بتواند بیسروصدا روند اجرای کد را تغییر دهد.
گوگل این قابلیتهای سختافزاری را به یک مسیر حسابرسی عمومی متصل کرده است. باینریهای مدیریت کلید و پردازش دادهها را میتوان به صورت کاملاً بازتولیدپذیر از مخزن متنباز Confidential Federated Compute ساخت. این یعنی یک بازرس امنیتی میتواند نرمافزار را خودش مجدداً کامپایل کند، خروجی هش آن را با محیط TEE در حال اجرا بسنجد، سیاستهای دسترسی را در لاگ Rekor زیر ذرهبین بگذارد و کدهای پایتونی را که سهم هر کاربر را محدود میکنند و با اضافه کردن نویز، خروجیها را امن نگه میدارند، دقیقاً بررسی کند.
همچنین با امکان لود کردن لحظهای (Runtime sideloading)، داراییهای انحصاری گوگل از جمله پارامترهای مدل، توکنایزرها و جزئیات معماری میتوانند بدون نیاز به افشا شدن در مخازن عمومی، وارد محیط پردازشی امن شوند. در این حالت، برنامه پایتونِ ممیزیشده همچنان کنترل جریان داده را به دست دارد؛ ترفندی هوشمندانه که شفافیت حریم خصوصی را به حداکثر میرساند و در عین حال مالکیت معنوی مدلهای اختصاصی گوگل را کاملاً حفظ میکند.
خداحافظی Gboard با تاخیرهای گوشی و مهاجرت به قدرت TEE
کیبورد Gboard تا پیش از این چارهای نداشت جز اینکه منتظر گوشیهای واجد شرایط بماند؛ یعنی گوشیهایی که بیکار بودند و به شارژر وصل شده بودند. به همین دلیل پیشرفت آموزش مدل با تغییر ساعات شبانهروز، در دسترس بودن دستگاهها، قدرت پردازشی گوشی و رقابت پردازشهای مختلف بر سر تصاحب سختافزار دستگاهها نوسان شدیدی داشت. اما در معماری جدید، گوگل ابتدا دادههای رمزگذاریشده را جمعآوری میکند و سپس آموزش را در زمان در دسترس بودن ظرفیت سرورهای TEE زمانبندی و اجرا مینماید.
جالب است بدانید در مدل قبلی، آموزش کامل مدلهای Gboard ممکن بود یک تا دو ماه تمام زمان ببرد! گوگل حالا از افزایش چشمگیر سرعت آموزش به لطف اجرای موازی روی سرورها خبر داده، هرچند عدد دقیقی از مدتزمان چرخه کامل آموزش در پست خود ارائه نکرده است. حالا تنها سقف سرعت، میزان ظرفیت سختافزارهای TEE در دسترس است.
از سوی دیگر، پیادهسازی حریم خصوصی تفاضلی متمرکز (Central Differential Privacy) داخل این محیطهای محرمانه بسیار سادهتر شده است. سیستم به راحتی میتواند میزان اثرگذاری دادههای هر دستگاه را محدود کند و پیش از انتشار وزنهای نهایی مدل، نویز کالیبرهشده به آنها بیفزاید. به این ترتیب، هیچ کاربری نمیتواند خروجی نهایی هوش مصنوعی را به نفع دادههای خودش منحرف کند و بودجه حریم خصوصی نیز ضریب امنیت این مرزبندی را تضمین میکند.
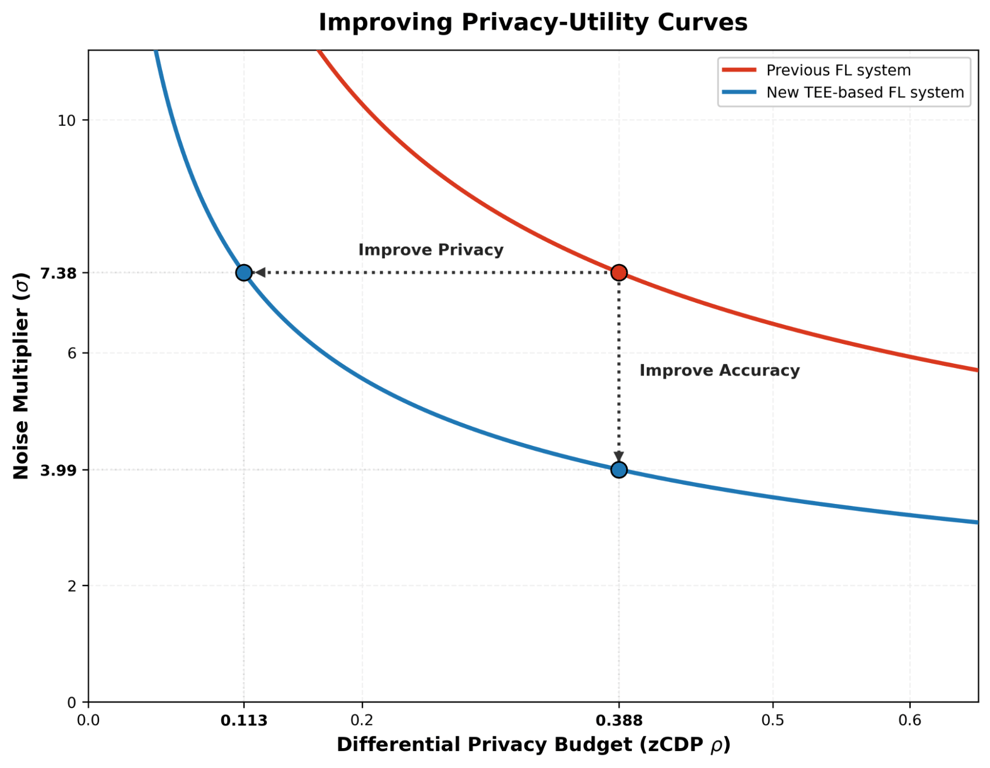
گوگل در یک بنچمارک برای پیشبینی کلمه بعدی در زبان انگلیسی، ۵ هزار دور آموزش را با گروههایی شامل ۶٬۵۰۰ دستگاه اجرا کرد. نمودارهای منتشرشده از بدهبستان حریم خصوصی و کارایی مدل نشان میدهند که افت کیفیت مدل در اهداف مشخص حریم خصوصی نسبت به سیستم قبلی به شکل محسوسی کمتر بوده است.
مرزهایی که این ضمانت امنیتی در آنها متوقف میشود
- کانالهای جانبی همچنان آسیبپذیرند: محیطهای TEE امروزی ممکن است از طریق حملات کانال جانبی مانند زمانبندی پردازش، رفتار حافظه کَش و الگوهای دسترسی به حافظه، اطلاعاتی را لو بدهند. گوگل هم تأیید کرده که سختافزارهای فعلی این حملات را به طور کامل ریشهکن نمیکنند.
- اعتماد نهایی به ریشه سختافزار: اعتبارسنجی در نهایت به شرکت سازنده پردازنده، زیرساخت امضای دیجیتال آن، فریمور و امنیت پیادهسازی TEE وابسته است.
- محدودیت بازرسی کدهای اختصاصی: اگرچه بازرسان میتوانند منطق حریم خصوصی را بررسی کنند، اما دسترسی به اجزای مدلهای اختصاصی گوگل ندارند. یک تأییدیه معتبر صرفاً مشخص میکند که دقیقاً کدام کد کامپایلشده اجرا شده، نه اینکه آیا تمام ورودیهای اختصاصی صددرصد بیخطر هستند یا خیر.
- نیاز حریم خصوصی تفاضلی به پارامترهای دقیق: محیطهای TEE میتوانند مکانیزمهای تعریفشده را اجرا کنند، اما قدرت محافظت در نهایت به سقفهای مجاز، میزان نویز، فرضیات نمونهبرداری و محاسبات دقیق حریم خصوصی گره خورده است.
- انتقال بار پردازشی به دیتاسنتر: سرعت آموزش حالا وابسته به سختافزارهای پردازش محرمانه در دسترس است. پشتیبانی سختافزاری برای تراشههای گرافیکی (GPU) و پردازندههای تانسوری (TPU) در مقایسه با TEEهای مبتنی بر پردازنده مرکزی (CPU) هنوز برای مدلهای یادگیری عمیق غولپیکر به بلوغ کامل نرسیده است.
دو مخزن متنباز؛ پایههای اصلی این زیرساخت
گوگل قطعات اصلی پردازش محرمانه و فریمورک هماهنگکننده Federated Language را به صورت متنباز منتشر کرده است. با این حال، هنوز سرویس ابری آماده یا رابط برنامهنویسی تجاری (API) برای توسعهدهندگان عرضه نشده تا بتوانند این زیرساخت کامل Gboard را به سادگی اجرا کنند.
اجزای لازم برای پیادهسازی معماری مشابه
- کلاینتهایی که آپلود دادهها را رمزگذاری کرده و سیاستهای دسترسی صریح به آنها میدهند
- یک لاگ شفافیت عمومی و غیرقابل دستکاری
- باینریهای قابل بازتولید TEE همراه با کدهای منبع منتشرشده
- یک سرویس مدیریت کلیدِ آگاه به اعتبارسنجی دیجیتال
- بارهای کاری محرمانهای که محدودیت مشارکت کاربران و حریم خصوصی تفاضلی را پیاده میکنند
- چکپوینتهای رمزگذاریشده برای حفظ حریم خصوصی هنگام بازیابی پس از خرابی
- ابزارهای حسابرسی که کدهای منبع، هشدارهای باینری، سیاستها و تأییدیهها را به هم پیوند میدهند
شتابدهندههای امنیتی؛ افق بعدی یادگیری محرمانه
انتقال محاسبات هوش مصنوعی به سرورهای امن TEE، محدودیتهای رم، شارژ باتری و زمان اجرای روی گوشیها را برای همیشه کنار میزند. با مجهز شدن شتابدهندههای سختافزاری ویژه به ایزولاسیون قویتر، اعتبارسنجی دقیق و ادغام با سیستمهای مدیریت کلید، آموزش مدلهای غولپیکرتر نیز در این محیطها عملی خواهد شد.
گوگل همچنین این زیرساخت را به عنوان یک محیط همهمنظوره برای اجرای کدهای پایتون توصیف کرده و در حال آزمایش آن برای کارهایی مثل تولید دادههای ساختگی (Synthetic Data) است. همین طراحی مبتنی بر سیاستگذاری، اعتبارسنجی و آزادسازی کنترلشده میتواند در آینده برای تحلیل محرمانه دادهها یا اجرای استنتاج مدلهای هوش مصنوعی روی حساسترین دادههای کاربران به کار رود.
برای توسعهدهندگانی که با دادههای حساس و خصوصی سر و کار دارند، ارزش اصلی این معماری در پیوند میان سیاستهای تأییدشده کلاینت، لاگهای شفافیت عمومی، بیلدهای بازتولیدپذیر، اجرای معتمد، کنترل شدید کلیدها و خروجیهای مجهز به حریم خصوصی تفاضلی نهفته است؛ زنجیرهای مطمئن که اثبات میکند چه کسی به دادههای رمزگذاریشده دسترسی دارد، چه کدی آنها را میخواند و چه اطلاعاتی حق خروج از محفظه امن را خواهد داشت.
مطالب مرتبط و پیشنهادی
۹۰ درصد کاربران هدف حملات سایبری؛ هوش مصنوعی کلاهبرداری را ارزانتر و سریعتر کرده است!
گزارش جدید نهاد Consumer Reports نشان میدهد ۹۰ درصد کاربران هدف حملات سایبری یا کلاهبرداریهای دیجیتال قرار گرفتهاند. در این میان، پیشرفت ابزارهای هوش مصنوعی کار هکرها را برای طراحی حملات شخصیسازیشده، سریع و ارزان بسیار راحتتر کرده و اعتماد کاربران به امنیت دادههایشان را به کمترین حد رسانده است.
آدمکهای تست تصادف برای هوش مصنوعی؛ استارتاپی که مانع آسیب روانی چتباتها به کودکان میشود
در روزهایی که همه از خطرات آخرالزمانی هوش مصنوعی حرف میزنند، آسیبهای روانی چتباتها تا کنون قربانیان واقعی بر جای گذاشته است. حالا استارتاپ نوپای Circuit Breaker Labs با شبیهسازی ارتش بزرگی از کاربران و ساخت «آدمکهای تست تصادف»، قصد دارد مدلهای هوش مصنوعی را پیش از آنکه به کودکان و نوجوانان صدمه بزنند، به چالش بکشد و عیار امنیت روانی آنها را بسنجد.
کلاهبرداری ۱۷۰۰ دلاری با عکس ساختگی هوش مصنوعی؛ دست میزبان ایربیانبی با واترمارک پنهان گوگل رو شد!
ماجرای جنجالی یک ادعای خسارت ۱۷۰۰ دلاری در ایربیانبی (Airbnb) نشان میدهد چطور ابزارهای هوش مصنوعی مولد به سلاحی جدید برای جعل شواهد تبدیل شدهاند؛ هرچند این بار فناوری واترمارک نامرئی SynthID گوگل به داد مسافر رسید و حقه میزبان را برملا کرد. با آسانتر شدن ساخت تصاویر بسیار طبیعی از خرابی خانه، پلتفرمهای اقامتی با چالش امنیتی بزرگی در تفکیک واقعیت از تصاویر هوش مصنوعی روبهرو شدهاند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.