دستفرمان مدل GPT-6 Astra پشت تویوتای واقعی؛ وقتی گراک بعد از دو فرمان تصادف کرد!
پژوهشگران در آزمایشی جذاب و کمسابقه، کنترل یک تویوتای واقعی را به مدلهای زبانی سپردند تا دستفرمان آنها را در یک مسیر پر از مانع محک بزنند. در این چالش، مدل GPT-6 Astra موفق شد مسیر ۱۳۴ متری را تا انتها طی کند، اما مدلهایی مثل گراک و کلود خیلی زود با موانع برخورد کردند یا از مسیر خارج شدند. این بررسی نشان داد که میان پاسخگویی متنی بینقص و هدایت ایمن یک وسیله در دنیای فیزیکی، هنوز فاصلهای طولانی وجود دارد.
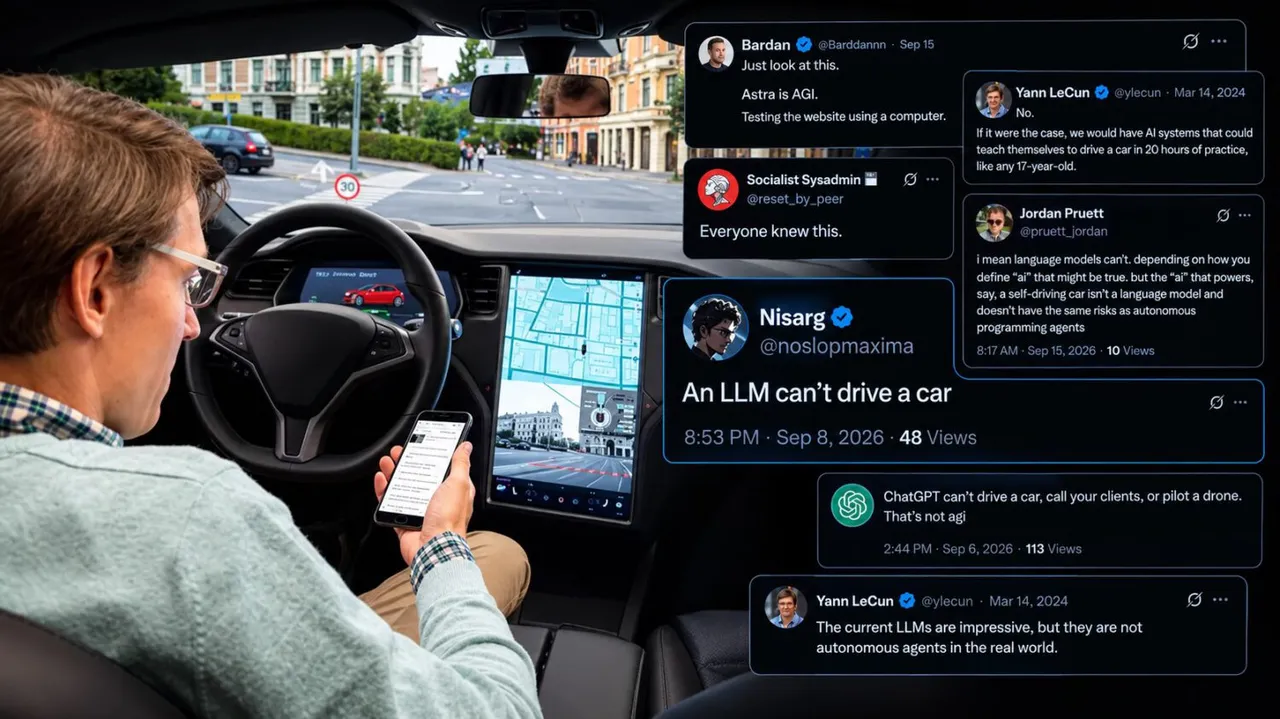
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- در بنچمارک جدید DrivingBench، برای اولین بار چهار مدل هوش مصنوعی پیشگام کنترل مستقیم یک خودروی تویوتا کرولا واقعی را در پیست موانع به دست گرفتند.
- تنها مدلی که موفق شد کل مسیر ۱۳۴ متری را پشت سر بگذارد GPT-6 Astra بود؛ در حالی که مدل Grok 4.6 تنها پس از دو فرمان مسیر را اشتباه گرفت و تصادف کرد و کلود هم نتوانست نیمی از مسیر را برود.
- این آزمایش نشان داد درک زبانی فوقالعاده لزوماً به مهارت فیزیکی ختم نمیشود؛ به ویژه که تأخیر ارسال اینترنتی دادهها و ضعف در استدلال فضایی، رانندگی را برای این ایجنتها بسیار دشوار کرده است.
مدل GPT-6 Astra موفق شد یک مسیر ۱۳۴.۷ متری چیدهشده با موانع مخروطی را پشت فرمان تویوتا کرولا طی کند، در حالی که مدل Grok 4.6 تنها پس از دو فرمان از ادامه کار بازماند.
مدل GPT-6 Astra توانست یک خودروی واقعی را در محوطه پارکینگ هدایت کرده و مسیر ۱۳۴.۷ متری پر از مانع را در ۵ دقیقه و ۲۲ ثانیه به پایان برساند؛ آن هم در شرایطی که سه مدل رقیب حتی پیش از رسیدن به پیچ اول شکست خوردند. اما این اتفاق در عمل چه پیامی دارد؟
بنچمارک DrivingBench که توسط جمعی از پژوهشگران به نامهای آدیتیا رامابادران، سایمون مانس و توبیاس گسلر طراحی شده، یکی از اولین تلاشهای ساختاریافته برای سنجش این است که آیا ایجنتهای هوش مصنوعی همهمنظوره به جز پاسخگویی روان، توانایی کنترل فیزیکی در دنیای واقعی را هم دارند یا خیر.
در این آزمایش دقیقاً چه چیزی سنجیده شد؟
چهار مدل پیشگام هوش مصنوعی به یک تویوتای واقعی متصل شدند، کنترل خودرو به آنها واگذار شد و مأموریت یافتند یک مسیر ساده مشخصشده با مخروطهای ترافیکی را طی کنند.
محققان مدلهای GPT-6 Astra، GPT-5.6 Sol، Claude Fable 5.1 و Grok 4.6 را به یک خودروی تویوتا کرولا ۲۰۲۲ متصل کردند. این خودرو به سختافزار Comma Four و نرمافزار کنترلی openpilot مجهز شده بود.
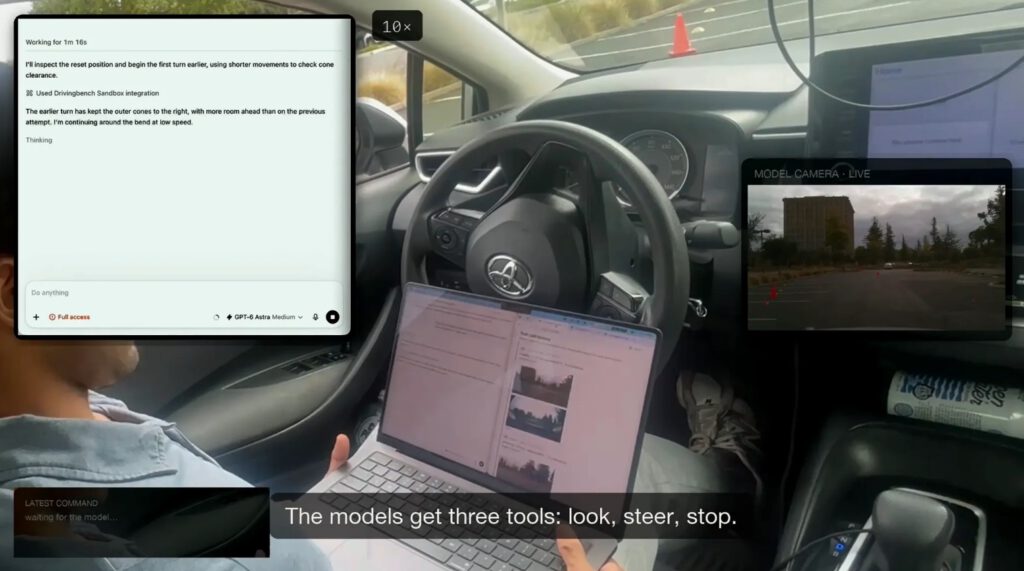
هر مدل تصاویر زنده دوربین و دادههای تلهمتری خودرو را دریافت میکرد و سپس فرمانهای چرخش فرمان، شتابگیری و ترمز را از طریق اتصال بیسیم به دیتاسنترهای راه دور میفرستاد. مدل در هر مرحله مشاهدات و تصمیمات خود را نیز به صورت متنی روایت میکرد.
این اتصال بیسیم نقش بسیار مهمی داشت؛ از آنجا که تکتک فرمانها باید تا دیتاسنتر میرفتند و برمیگشتند، خودرو وسط مانورها مدام متوقف میشد تا دستور بعدی برسد؛ رفتاری که کاملاً برخلاف طراحی سیستمهای اختصاصی خودروهای خودران است.
چه مدلی به خط پایان رسید و چه مدلهایی ناکام ماندند؟
از مجموع ۱۱ بار آزمایش روی این چهار مدل، فقط یک بار خودرو موفق شد مسیر را به پایان برساند.
مدل Astra تنها مدلی بود که توانست به خط پایان برسد، آن هم در دومین تلاش خود. مسیر حرکت آن در یک پیچ طولانی راستگرد بیش از حد به کناره چسبید و نزدیک خط پایان هم چیزی نمانده بود از مسیر خارج شود، اما در نهایت کار را تمام کرد.
مدل Claude Fable 5.1 در بهترین حالت به حدود ۴۵ درصد از مسیر رسید. مدل Grok 4.6 فقط به حدود ۱۱ درصد مسیر دست یافت؛ به طوری که در تلاش اول تنها پس از دو فرمان متوقف شد، چون فاصله خالی میان دو مخروط را به اشتباه دروازه ورود دید و مستقیم به سمت آن گاز داد! مدل GPT-5.6 Sol هم تنها توانست حدود ۶ درصد مسیر را پیش برود.
بررسی ارقام و هزینهها ماجرا را ملموستر میکند؛ دور موفق Astra حدود ۶.۶ میلیون توکن مصرف کرد و ۷.۷۴ دلار هزینه داشت؛ یعنی تقریباً چهار برابر هزینه تلاش قبلیاش که نیمی از مسافت را طی کرده بود.
کنترل یک وسیله فیزیکی به کمک یک مدل زبانی، اصلاً شبیه مسیریابی ساده نیست؛ بیشتر شبیه این است که روی صندلی عقب ماشین بنشینید و قدمبهقدم برای دوستتان پیامک بفرستید که کجا بپیچد، آن هم در حالی که بین هر پیامک تأخیری کلافهکننده وجود دارد!
ناکامیها چه رازهایی را برملا کردند؟
استدلال کلامی روان و کنترل مطمئن یک وسیله فیزیکی، دو مهارت کاملاً متفاوت از آب درآمدند.
خطاهای مدلها فراتر از کجفهمی ساده دستورالعملها بود. مدلها در استدلال فضایی دستوپا میزدند؛ به خصوص در تبدیل تصمیمِ پیچیدن به زاویه دقیق گردش فرمان. حتی یکی از مدلهای GPT برای خودش یک قانون مندرآوردی درباره رنگ مخروطها ساخت؛ قانونی که دقیقاً خلاف دستورات اولیه بود!
کنترل حلقه بسته (Closed-loop) عمیقترین چالش را نشان داد: چرخه مداومِ دیدن وضعیت خودرو، واکنش نشان دادن و تصحیح مسیر بر اساس خروجی قبلی، نشان داد که تولید روان کلمات چقدر بد به حرکات پیوسته فیزیکی تبدیل میشود.
صحنه جالبی که در این آزمایش دیده میشود این است: مدل به طور دقیق و شمرده هرچه را میبیند شرح میدهد، در حالی که خودرو دقیقاً در جهتی اشتباه دارد منحرف میشود!
پروژه DrivingBench مدلها را در برابر سیستمهای تجاری خودران نسنجیده است؛ سیستمهایی که ادراکات تخصصی، موقعیتیابی دقیق، پیشبینی رفتار، برنامهریزی و معماری چندلایه ایمنی را در هم میآمیزند. این پژوهش ایجنتهای هوش مصنوعی همهمنظوره را با یک سازوکار آزمایشی به خودرو متصل کرده بود و درک این تمایز برای تفسیر درست نتایج ضروری است.
نتیجهگیری پایانی
یک دور رانندگی در پارکینگ آزمون جادهای نیست، اما روششناسی پشت آن ارزش پیگیری دارد.
یک دور حرکت موفق با سرعت پایین هرگز مهارت کامل در رانندگی، تکرارپذیری یا آمادگی برای حضور در جادههای عمومی را ثابت نمیکند. اما این آزمایش نشان داد که در ارزیابیهای آینده، احتمالاً کمتر از مدلها سوالات متنی پرسیده میشود و بیشتر توانایی آنها در حل چالشهای دنیای فیزیکی به آزمون گذاشته خواهد شد. شکاف عمیق میان «توضیح دادن آنچه میبینید» و «کنترل ایمن آنچه لمس میکنید» هنوز به قوت خود باقی است.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
ابزار امنیتی VulnHunter از انحصار کلود آزاد شد: شکار هوشمند باگها در هر محیط کدنویسی!
ابزار امنیتی محبوب VulnHunter که توسط شرکت Capital One توسعه یافته بود، با یک فورک جامعهمحور تازه از انحصار محیط Claude Code رها شد. این ابزار متنباز با رویکرد هکرهای واقعی کدهای پروژه را اسکن میکند و حالا توسعهدهندگان میتوانند ایجنتها و اسکیلهای آن را در هر محیط کدنویسی دلخواهی برای کشف و رفع تضمینی آسیبپذیریها به کار بگیرند.
متا ابزار Rebalancer را متنباز کرد؛ حل روزانه ۴۰ میلیون معمای زیرساختی در دیتاسنترها
متا پس از ۹ سال استفاده داخلی، کتابخانه اختصاصی Rebalancer را بهصورت متنباز در اختیار عموم توسعهدهندگان قرار داد. این ابزار قدرتمند روزانه بیش از ۴۰ میلیون مسئله پیچیده تخصیص منابع و چیدمان سختافزار را در زیرساختهای عظیم این شرکت حلوفصل میکند. انتشار این پروژه همراه با ابزار بصری Explorer، مدیریت دیتاسنترها و سرورهای توزیعشده را برای تیمهای فنی متحول خواهد کرد.
کلود آنتروپیک وارد گوگل داکس و شیتس شد؛ ویرایش مستقیم اسناد بدون نیاز به کپیپیست!
شرکت آنتروپیک نسخه بتای عمومی Claude for Workspace را عرضه کرد تا کاربران بتوانند چتبات کلود را مستقیماً داخل گوگل داکس، شیتس و اسلایدز به کار بگیرند. با این قابلیت، بدون نیاز به کپیپیست مداوم میان تبهای مختلف مرورگر، میتوانید متنها را در لحظه اصلاح کنید، در شیتس فرمول بسازید و اسلایدهای حرفهای طراحی کنید.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.