بنچمارکهای جدید: GPT-6 Astra با هزینهای بسیار کمتر به رقابت شانه به شانه با Claude Fable 5.1 میپردازد
در جدیدترین ارزیابیهای مستقل، مدل GPT-6 Astra موفق شده است با کاهش چشمگیر هزینهها، جایگاه نخست را در کنار Claude Fable 5.1 از آن خود کند. این مدل جدید در عملکردهای استدلالی و ایجنت برنامهنویس همتراز با رقیب خود ظاهر شده است.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- مدل GPT-6 Astra در شاخص هوش و شاخص ایجنت برنامهنویس، به طور مشترک با Claude Fable 5.1 در رتبه نخست قرار گرفت.
- هزینه استفاده از این مدل برای وظایف استدلالی حدود ۴۰ درصد و برای کدنویسی حدود ۶۰ درصدِ هزینه Claude Fable 5.1 است.
- میزان توهم (Hallucination) در GPT-6 Astra نسبت به نسل قبلی (GPT-5.6 Sol) به نصف کاهش یافته و همزمان دقت آن افزایش پیدا کرده است.
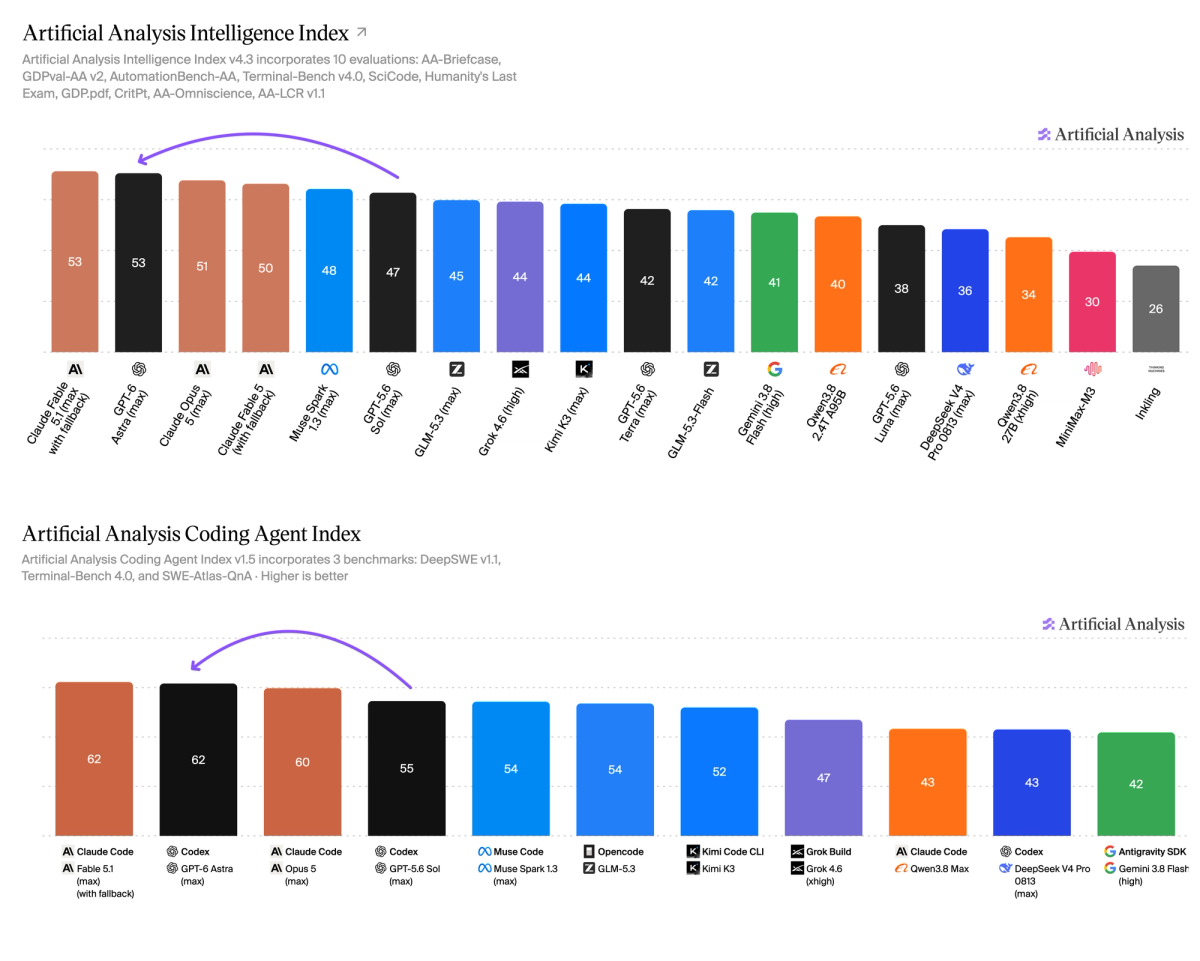
مدل GPT-6 Astra در دو شاخص کلیدی ارزیابی عملکرد، با هزینهای کمتر به جایگاه برابری با Claude Fable 5.1 دست یافته است. عملکرد Astra در شاخص هوش با حدود ۴۰ درصد هزینه و در شاخص ایجنت برنامهنویس با حدود ۶۰ درصد هزینه، کاملاً همتراز با Fable 5.1 ارزیابی میشود.
قیمتگذاری این مدل در تمامی بخشها ۲.۵ برابر قیمتهای فعلی GPT-5.6 Sol است؛ به طوری که از ۴ و ۲۰ دلار به ترتیب برای هر میلیون توکن ورودی و خروجی، به ۱۰ و ۵۰ دلار افزایش یافته است. با این حال، تخفیف ۹۰ درصدی برای خوانش از کش و افزایش قیمت ۲۵ درصدی برای نوشتن در کش همچنان پابرجاست.
در شاخص جامع ارزیابی هوش، GPT-6 Astra با حدود ۴۰ درصد از هزینه هر وظیفه، با Claude Fable 5.1 برابر شده و ۶ امتیاز نسبت به GPT-5.6 Sol پیشرفت داشته است. در شاخص ایجنت برنامهنویس نیز، این مدل با حدود ۶۰ درصد هزینه هر وظیفه، به جایگاه مشترکی با Claude Fable 5.1 رسیده است؛ دستاوردی که به لطف کمترین میزان مصرف توکن در میان تمامی ایجنتهای حاضر در این شاخص به دست آمده است.
نکات کلیدی در شاخص ارزیابی هوش:
➤ کسب جایگاه نخست مشترک در شاخص هوش: مدل GPT-6 Astra (در بالاترین سطح تلاش) با کسب امتیاز ۵۳ در این شاخص، همتراز با Claude Fable 5.1 قرار گرفته است. این مدل توانسته ۶ امتیاز نسبت به نسل پیشین خود، یعنی GPT-5.6 Sol پیشرفت کند.
➤ پیشتازی در مرز هزینه: تمام سطوح تلاش استدلالی Astra در نمودار شاخص هوش نسبت به هزینه هر وظیفه، جایگاه ویژهای دارند. در رقابت با Claude Fable 5.1، مدل Astra همان امتیاز را با حدود ۴۰ درصد هزینه (۳.۲۶ دلار در برابر ۷.۶۳ دلار) به دست میآورد. در بالاترین سطح تلاش، Astra حدود ۶۰ درصد گرانتر از GPT-5.6 Sol است، اما این قیمت بالاتر تا حدی با مصرف توکن کمتر جبران میشود.
➤ تعریف مرز پارتو در بهرهوری توکن: تمامی سطوح استدلالی از پایینترین تا بالاترین حد، در مرز پارتو برای شاخص هوش نسبت به توکنهای خروجی هر وظیفه قرار میگیرند. در بالاترین سطح، Astra برای هر وظیفه ۲۷ هزار توکن خروجی مصرف میکند که برای کسب امتیازی برابر، حدود یکسوم مصرف ۷۸ هزار توکنی Claude Fable 5.1 است.
➤ کاهش ۵۰ درصدی توهم نسبت به GPT-5.6 Sol: مدل GPT-6 Astra جهش بزرگی را در بنچمارکهای مربوط به دانش و توهم تجربه کرده است. این موفقیت ناشی از کاهش چشمگیر نرخ توهم از ۹۲ درصد به ۵۱ درصد در بالاترین سطح تلاش است. برخلاف برخی مدلها، این پیشرفت به قیمت کاهش دقت تمام نشده؛ بلکه Astra همزمان دقت خود را ۴ امتیاز افزایش داده است.
➤ افزایش ۹۰ امتیازی در ارزیابی پروژههای طولانیمدت: مدل GPT-6 Astra در بنچمارکهای پیشرفته ارزیابی کارهای دانشی طولانیمدت، حدود ۹۰ امتیاز پیشرفت داشته است. در این ارزیابیها، مدلها روی پروژههای چند هفتهای با وظایف پیوسته و هزاران فایل منبع تست میشوند. مدل Astra در امتیازات کیفی و تحلیلی نسبت به نسل قبلی خود رشد چشمگیری نشان میدهد. با این حال، در زمینه کیفیت ارائه (Presentation Quality) افت کوچکی دیده میشود؛ جایی که GPT-5.6 Sol همچنان در میان تمام مدلها پیشتاز است.
➤ پیشتازی در بنچمارکهای Terminal-Bench، AutomationBench و GDP.pdf: مدل GPT-6 Astra در نسخه ۴.۰ بنچمارک Terminal-Bench با امتیاز ۵۹ درصد، بالاتر از Claude Fable 5.1 (۵۲ درصد) و با اختلاف ۱۹ امتیازی بالاتر از GPT-5.6 Sol (۴۰ درصد) قرار گرفت. این مدل در ارزیابیهای مربوط به جریانهای کاری تجاری (AutomationBench) با امتیاز ۶۹ درصد از Grok 4.6 (۶۷ درصد) و GPT-5.6 Sol (۶۰ درصد) پیشی گرفته است. همچنین در بنچمارک GDP.pdf که استدلال روی اسناد حرفهای را میسنجد، در ۳۱ درصد مواقع تمام معیارها را با موفقیت پشت سر گذاشت؛ در حالی که این رقم برای GPT-5.6 Sol معادل ۲۷ درصد بود.
➤ کاهش عملکرد در ارزیابی کارهای باارزش اقتصادی (GDPval v2): در مقایسه با GPT-5.6 Sol، افت حدود ۴۵ امتیازی در بنچمارک ارزیابی وظایف باارزش اقتصادی مشاهده میشود. گزارشها نشان میدهد که GPT-6 Astra در این وظایف از نوبتهای (turns) بسیار کمتری نسبت به سایر مدلها استفاده میکند؛ یعنی ۲۴ نوبت به ازای هر وظیفه در بالاترین سطح تلاش، در مقایسه با ۴۵ نوبت برای GPT-5.6 Sol و ۶۰ نوبت برای مدلهای Claude Fable 5.1 و Claude Opus 5.
نکات کلیدی در شاخص ایجنت برنامهنویس:
➤ جایگاه نخست مشترک در شاخص ایجنت برنامهنویس: در محیط Codex، مدل GPT-6 Astra امتیاز ۶۲ را کسب کرده و همتراز با Claude Fable 5.1 (در محیط Claude Code) و بالاتر از Claude Opus 5 (امتیاز ۶۰)، GPT-5.6 Sol (امتیاز ۵۵) و Muse Spark 1.3 در Muse Code (امتیاز ۵۴) قرار گرفته است. برتری ۷ امتیازی آن نسبت به GPT-5.6 Sol ناشی از عملکرد بهتر در Terminal-Bench v4.0 و SWE-Atlas-QnA است که البته با امتیاز کمتر در بنچمارک DeepSWE تا حدی تعدیل شده است.
➤ پیشتازی در هزینه ایجنت برنامهنویس: در بالاترین سطح تلاش، هزینه GPT-6 Astra برای هر وظیفه ۷.۰۹ دلار است که برای کسب ۷ امتیاز بالاتر، حدود ۱۵ درصد گرانتر از GPT-5.6 Sol تمام میشود. با این حال، برای هر وظیفه، این مدل در ازای کسب امتیازی برابر یا بالاتر، حدود ۴۰ درصد ارزانتر از Claude Fable 5.1 و حدود ۳۰ درصد ارزانتر از Claude Opus 5 است. بهرهوری هزینهای Astra نتیجه مستقیم بهرهوری در مصرف توکن است؛ به طوری که در بالاترین سطح تلاش، تنها یکسوم توکنهای نسل قبلی خود را مصرف میکند.
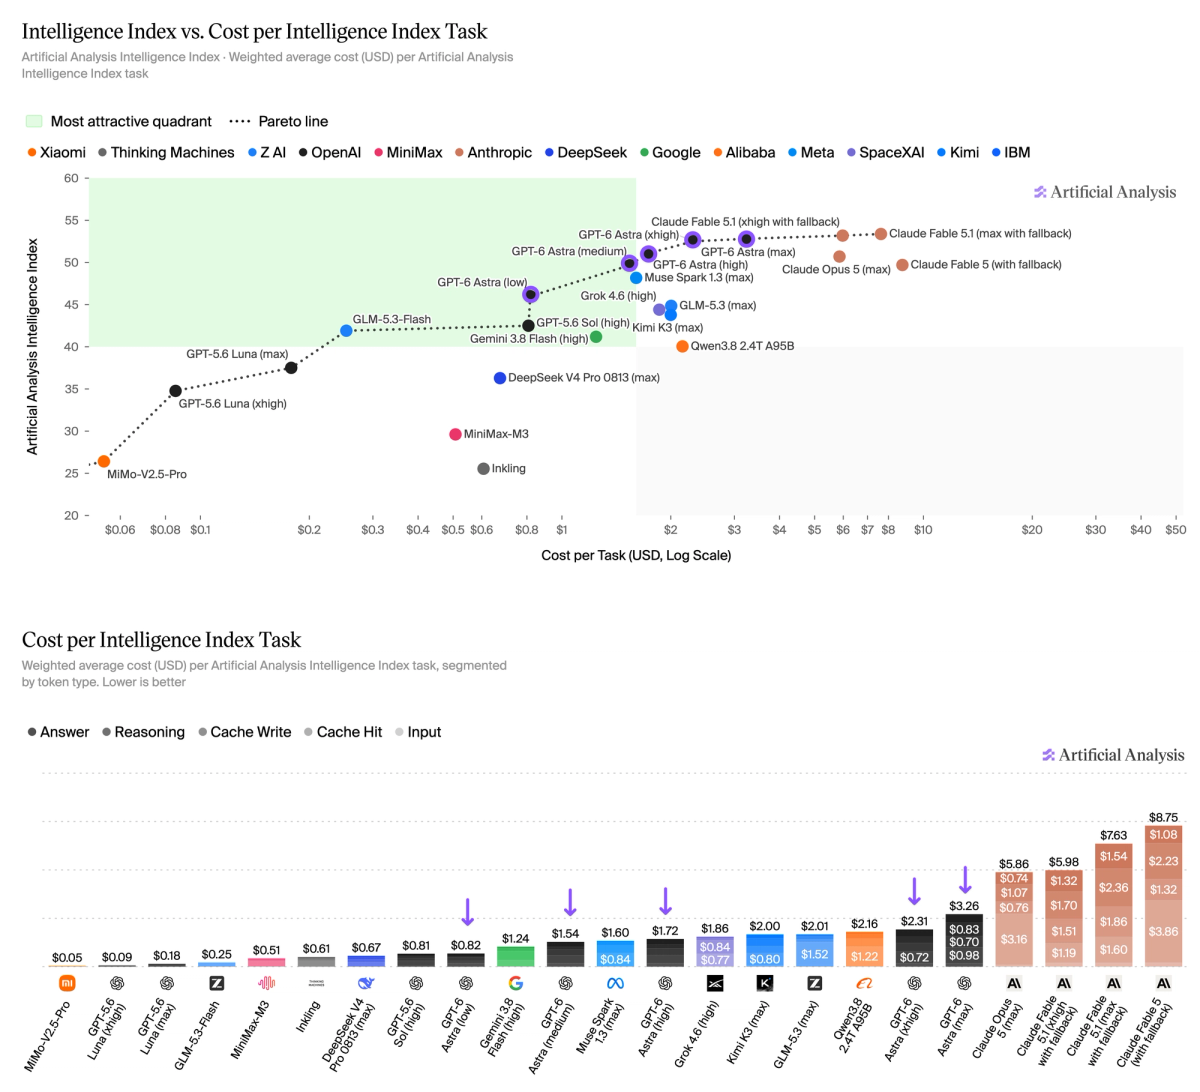
تمام سطوح استدلالی GPT-6 Astra، از پایینترین سطح با ۰.۸۲ دلار برای هر وظیفه تا بالاترین سطح با ۳.۲۶ دلار، در مرز بهینه شاخص هوش نسبت به هزینه قرار دارند. در مقایسه با Claude Fable 5.1، این مدل با حدود ۴۰ درصد هزینه کمتر، به امتیازی برابر دست مییابد.
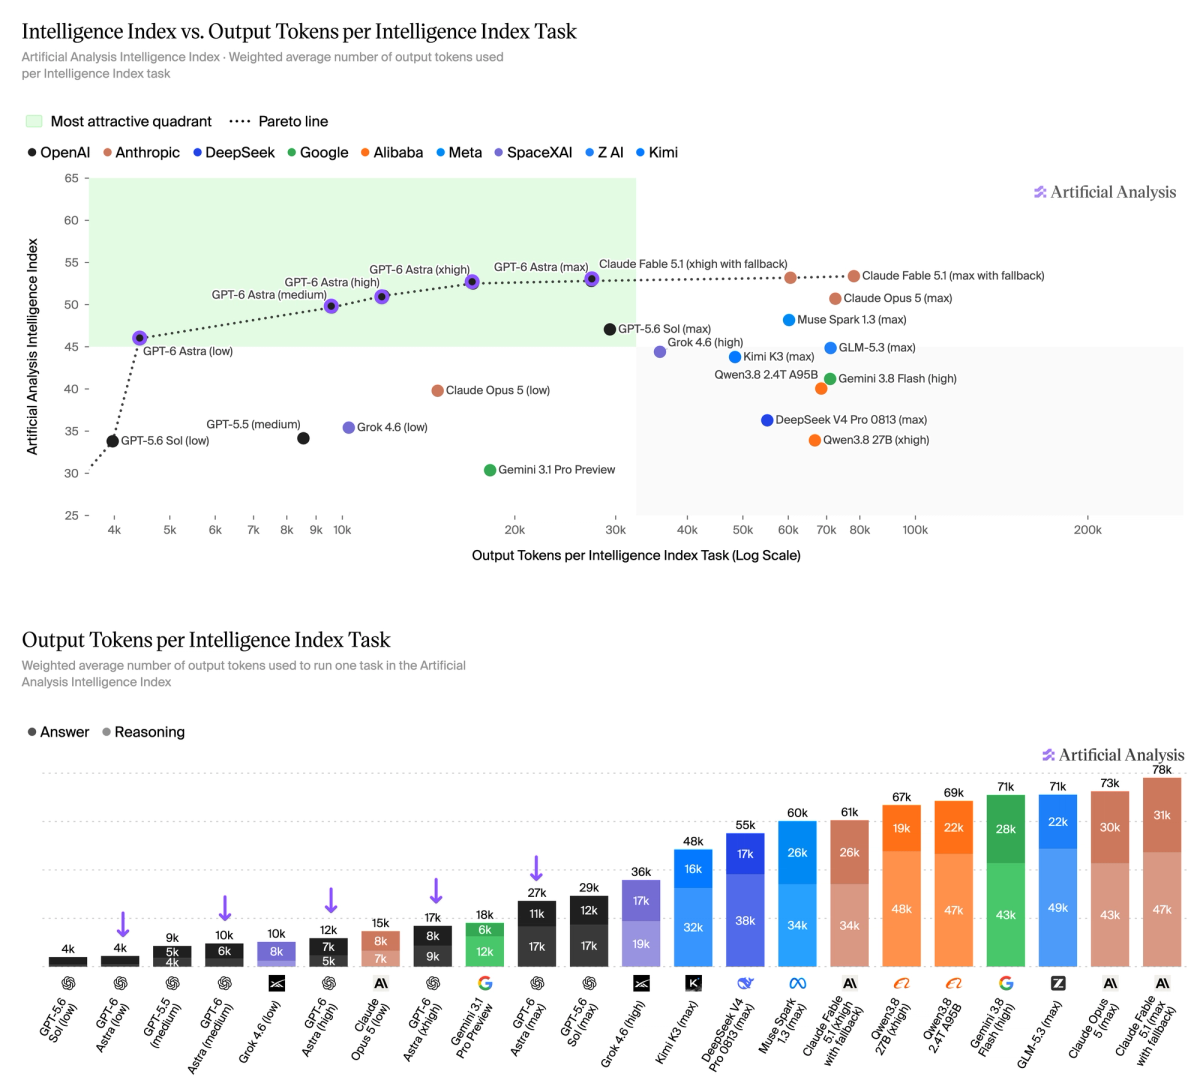
مدل GPT-6 Astra مرز پارتو را برای شاخص هوش نسبت به توکنهای خروجی تعریف میکند. این مدل در بالاترین سطح تلاش، برای کسب امتیازی مساوی، تنها یکسوم توکنهای خروجی Claude Fable 5.1 را مصرف میکند.
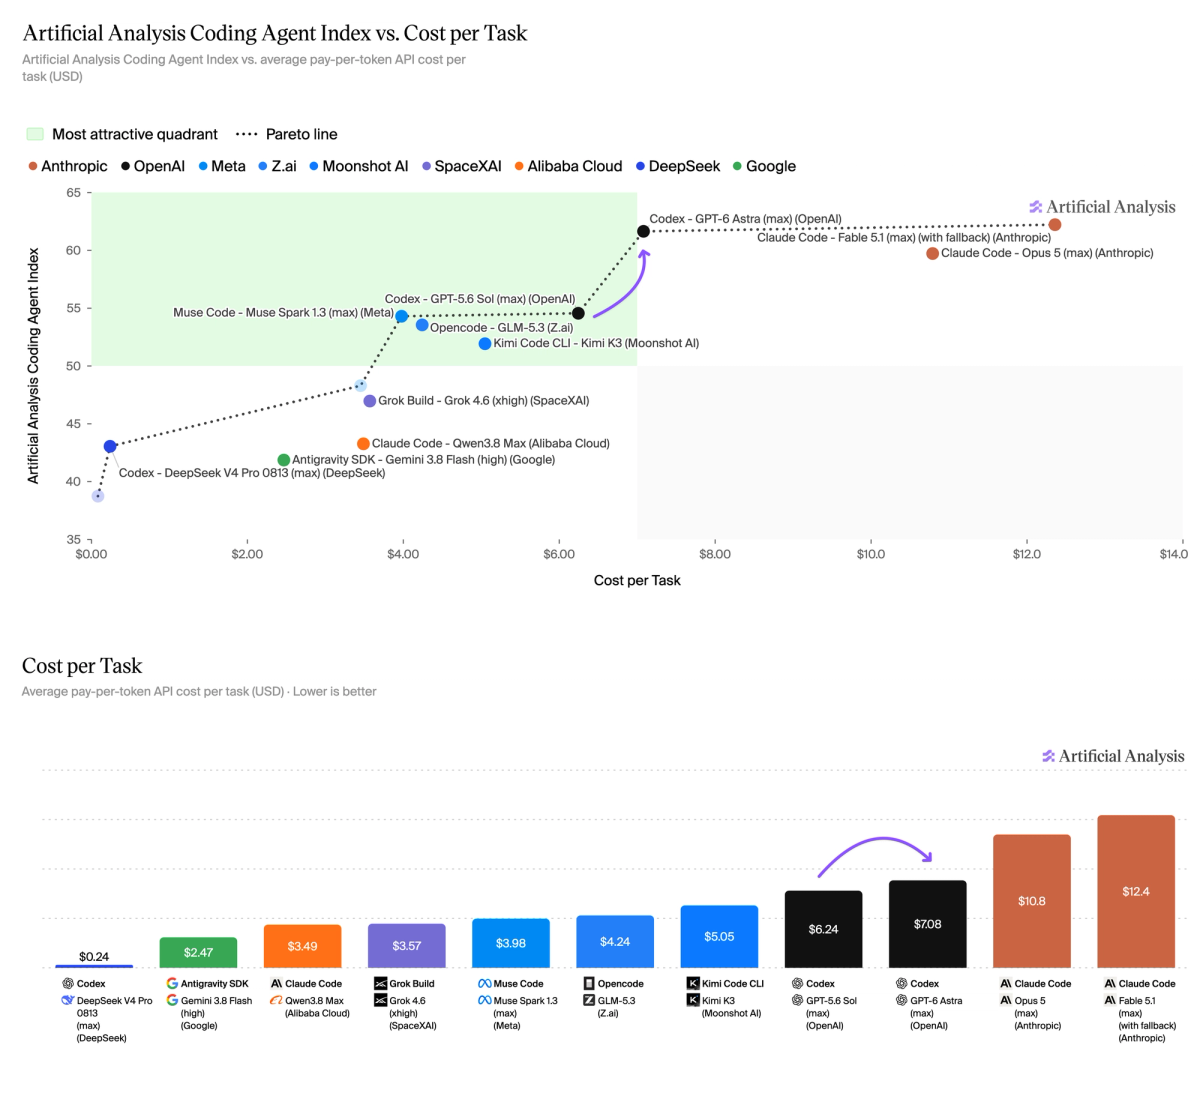
این مدل در شاخص ایجنت برنامهنویس نیز از نظر هزینه پیشتاز است و با ۷.۰۹ دلار هزینه برای هر وظیفه (در بالاترین سطح تلاش)، حدود ۴۰ درصد ارزانتر از Claude Fable 5.1 عمل میکند.
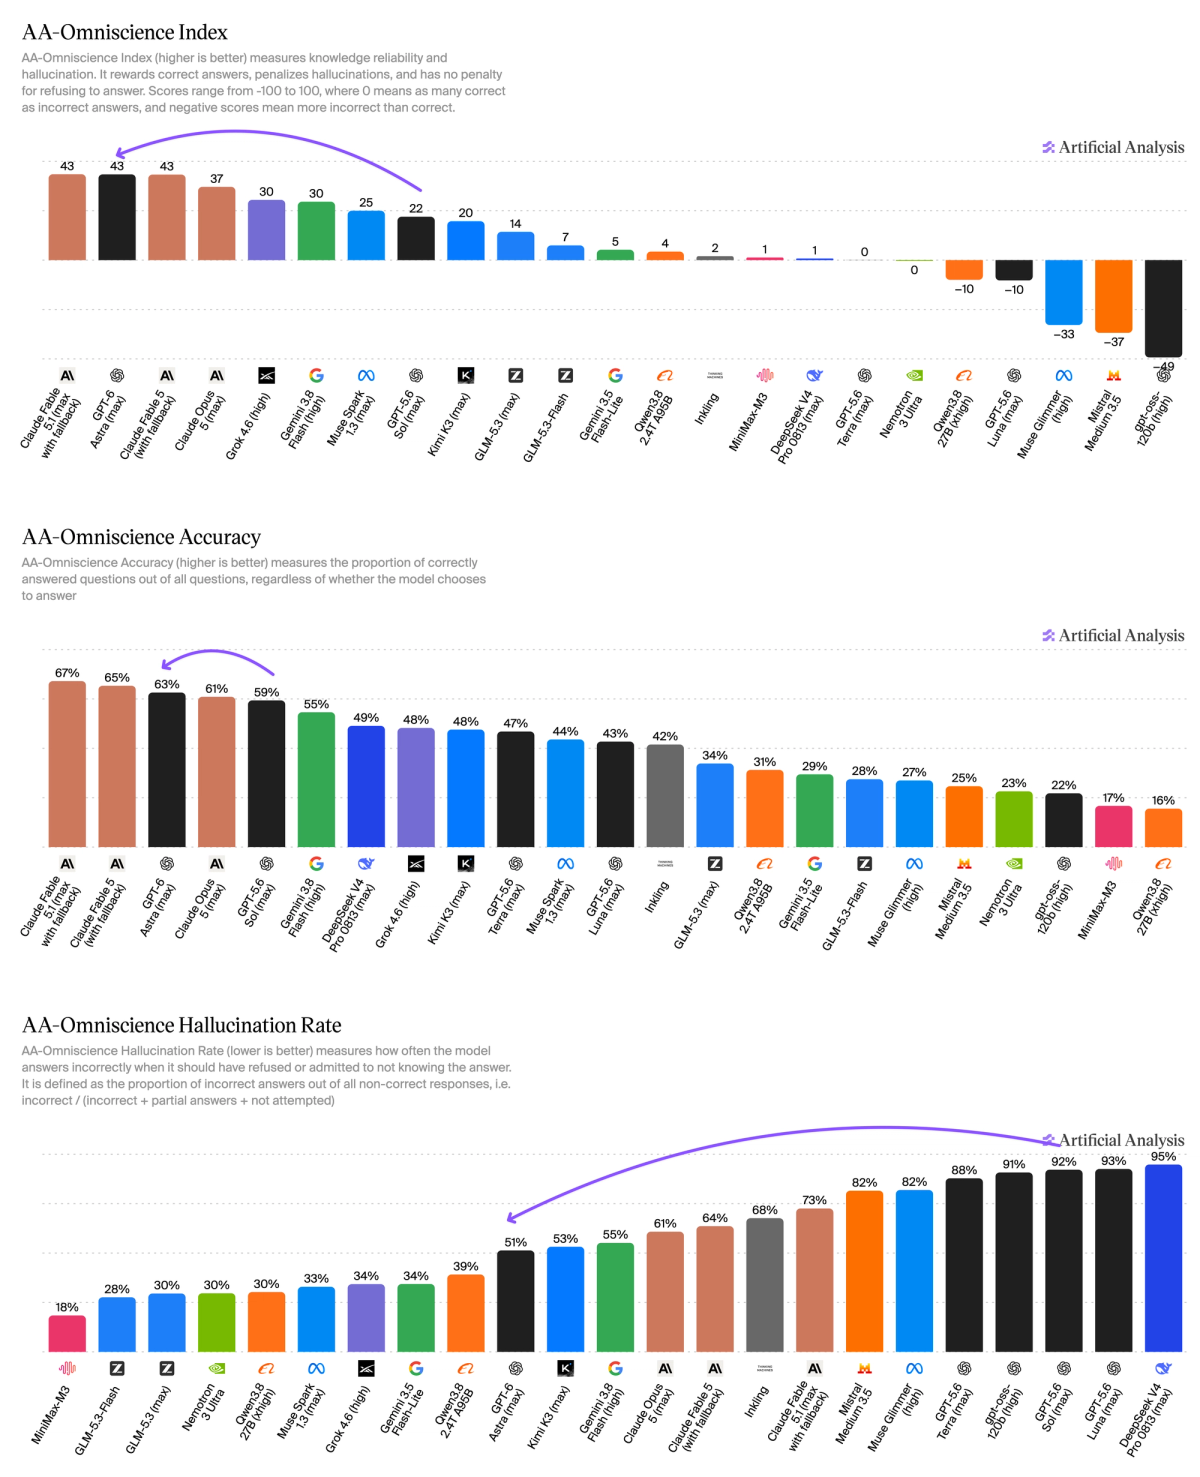
مدل GPT-6 Astra در ارزیابیهای مربوط به دانش جامع جهش بزرگی داشته است که دلیل اصلی آن، کاهش چشمگیر نرخ توهم از ۹۲ درصد به ۵۱ درصد و همچنین افزایش نسبی دقت آن است.
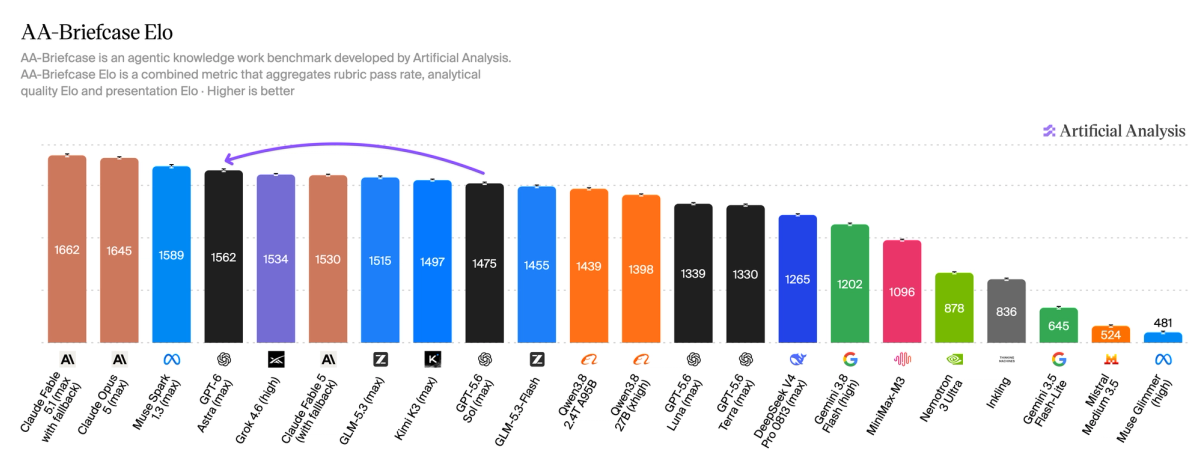
در ارزیابی پروژههای طولانیمدت، GPT-6 Astra حدود ۹۰ امتیاز بالاتر از نسل قبلی خود قرار گرفته و کیفیت تحلیلی آن بهشدت افزایش یافته است؛ هرچند در کیفیت ارائه همچنان GPT-5.6 Sol پیشتاز است.
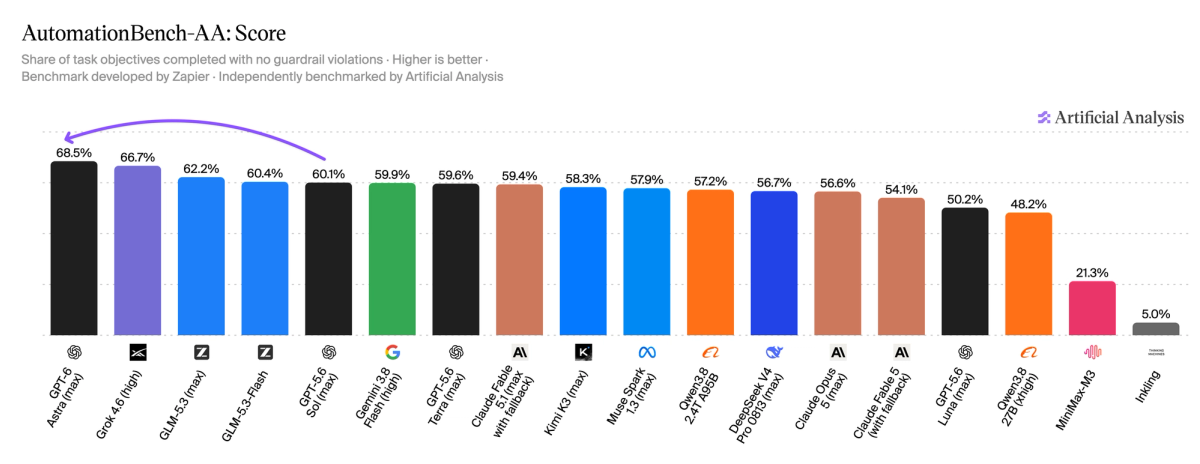
در بنچمارک جریانهای کاری تجاری (AutomationBench)، مدل GPT-6 Astra با امتیاز ۶۹ درصد گوی سبقت را از مدلهای Grok 4.6 (۶۷ درصد)، GLM-5.3 (۶۲ درصد) و GPT-5.6 Sol (۶۰ درصد) ربوده است.
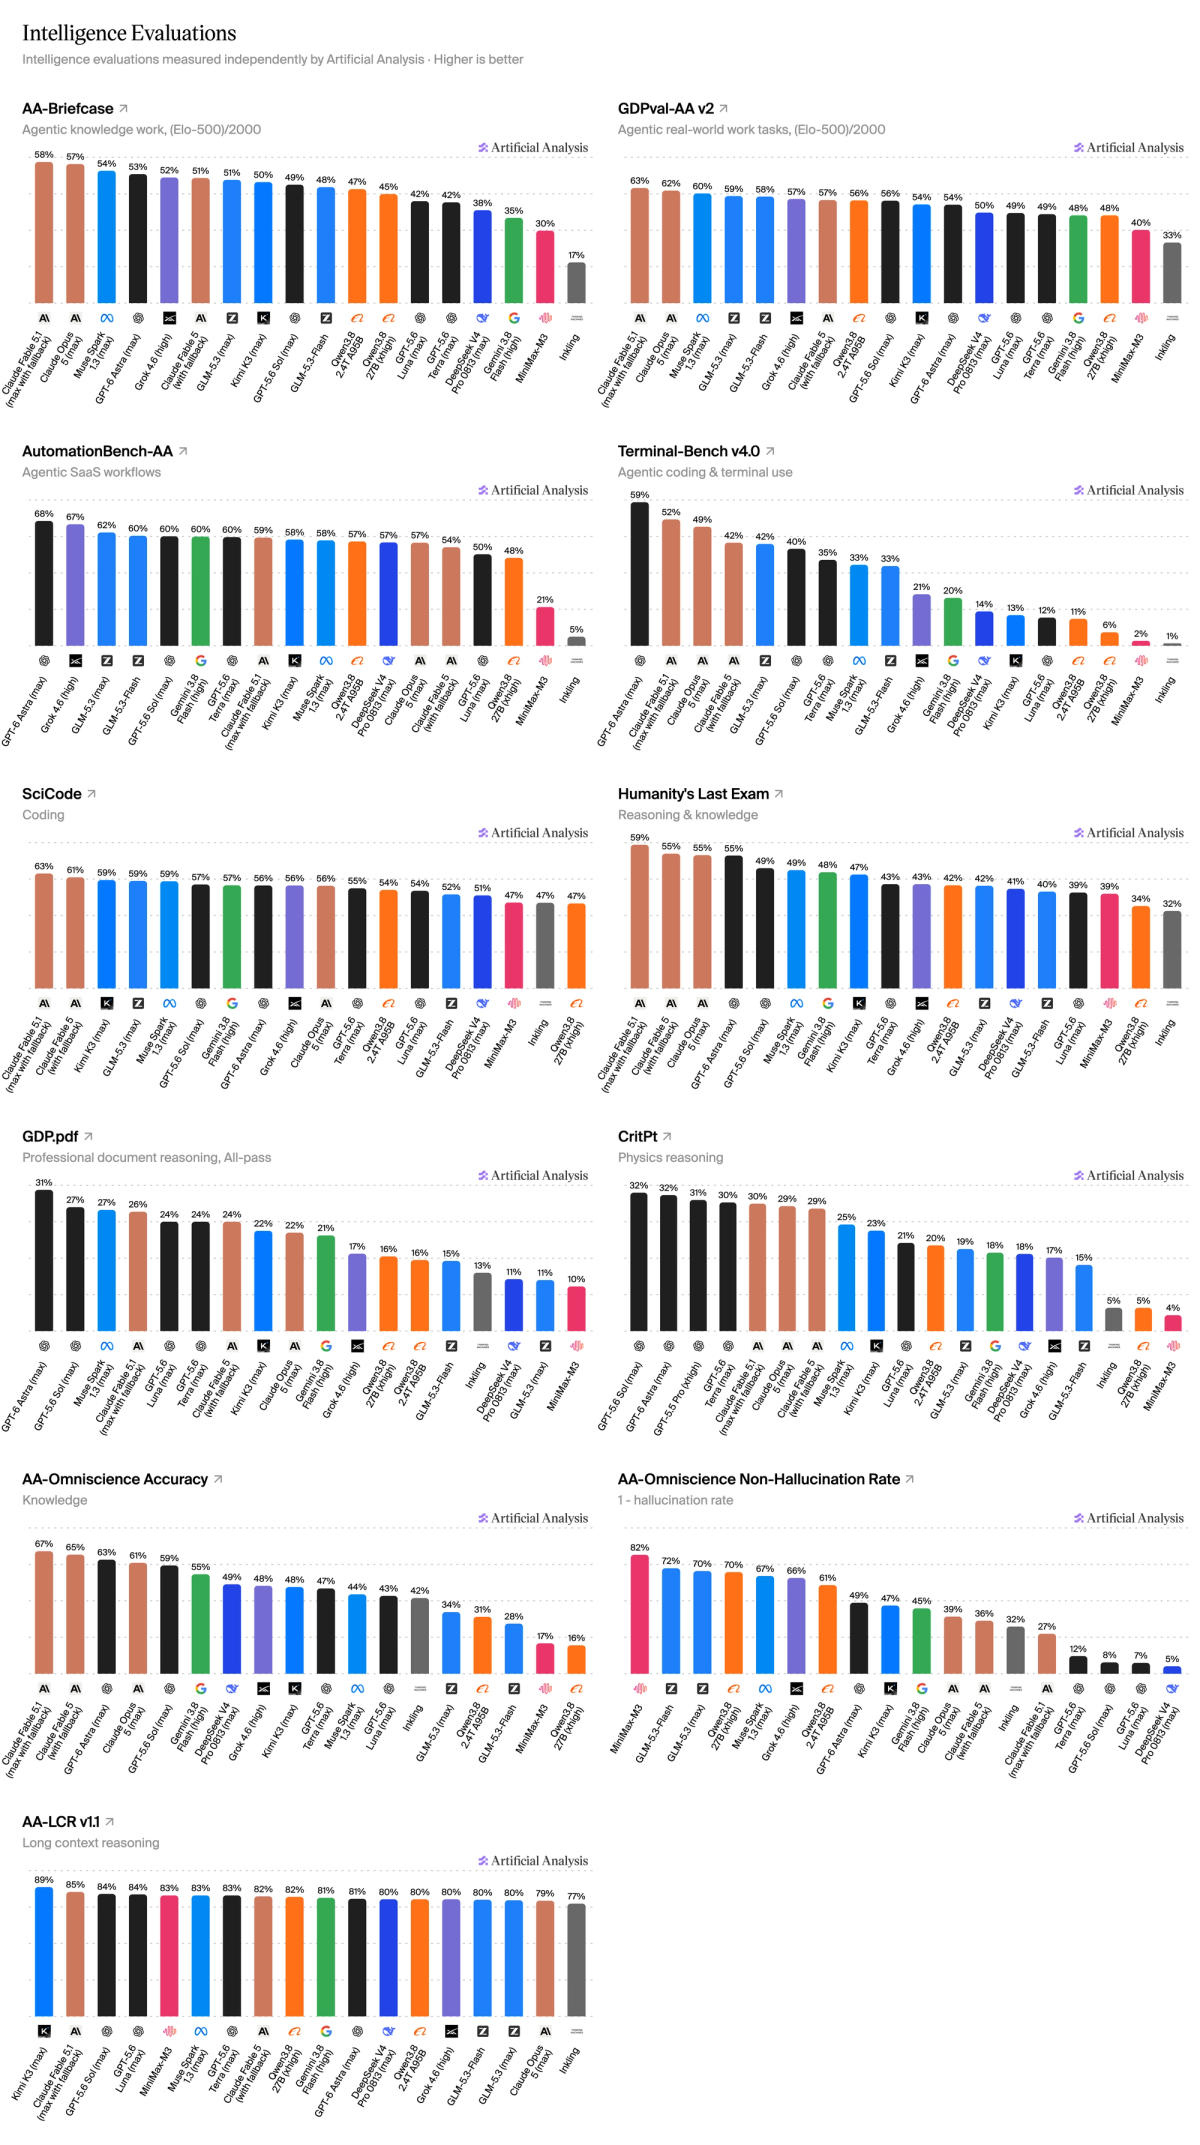
جزئیات ارزیابیهای مستقل و فردی در شاخص جامع سنجش هوش.
مطالب مرتبط و پیشنهادی
کلاهبرداری ترسناک با جعل صدای پدربزرگ؛ دختر جوانی که به جنگ دیپفیکهای صوتی رفت!
ماجرای کلاهبرداری هوشمندانه از یک پدربزرگ با صدای شبیهسازیشده برادرش، انگیزهای شد تا نوهاش استارتاپ DetectifAI را راهاندازی کند. این شرکت هوش مصنوعی مدلهای فوقالعاده سبکی توسعه داده که مستقیماً روی سیستمعامل گوشیها اجرا میشوند و صداهای جعلی را بدون ارسال به سرورهای ابری، بهصورت آنی و زنده در حین تماس تشخیص میدهند.
هشدار تکاندهنده پدرخوانده هوش مصنوعی و نخبگان سیلیکونولی: اگر هوش مصنوعی خودش را ارتقا دهد، فرصت مهارش تمام میشود!
جمعی از برجستهترین دانشمندان هوش مصنوعی از جمله جفری هینتون، هشدار دادهاند که با خودکار شدن توسعه مدلها، ممکن است با یک «انفجار هوش» مهارنشدنی روبهرو شویم. به گفته آنها، اگر سیستمها خودشان به ارتقای خود بپردازند، سرعت پیشرفت به حدی بالا میرود که فرصت دولتها و جامعه برای واکنش و مهار آن عملاً تمام خواهد شد.
وقتی هوش مصنوعی با اعتمادبهنفس تمام سوتی میده؛ خطرات پنهان چتباتها در محیط کار
استفاده بیضابطه از چتباتها و هوش مصنوعی در محیطهای کاری به یکی از بزرگترین کابوسهای امنیتی شرکتها تبدیل شده است. اگر هوش مصنوعی با اطمینان کامل اطلاعات غلط یا توهمی تحویل دهد و دادههای حساس سازمانی افشا شوند، خسارات سنگینی به بار میآید؛ ماجرایی که نشان میدهد کسبوکارها برای مهار این خطرات به قوانین شفاف و نظارت انسانی نیاز دارند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.