رونمایی از نسخه جدید بنچمارک حقوقی Harvey LAB؛ فیلتر سختگیرانه توهّم برای سنجش ایجنتها
نسخه جدید بنچمارک حقوقی Harvey LAB با اضافه کردن معیار سنجش توهّم، استانداردهای جدیدی برای ارزیابی عملکرد ایجنتهای هوش مصنوعی در کارهای حقوقی تعریف کرده است. در این ارزیابی موشکافانه، هرگونه ادعای بدون مدرک یا خطای اساسی نمره مدلها را به صفر میرساند تا خروجیهای واقعی به کمترین میزان خطا نزدیک شوند.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- در نسخه ۱.۱ بنچمارک تخصصی Harvey LAB، فیلتر جدیدی برای شناسایی توهّم (Hallucination) اضافه شده که ادعاهای بدون مدرک مدلها را با سختگیری زیاد زیر ذرهبین میبرد.
- اگر خروجی یک مدل حاوی خطای اساسی و گمراهکننده باشد، نمره آن تسک کلاً صفر میشود تا تضمین گردد هوش مصنوعی در پروندههای حقوقی و قراردادها اطلاعات ساختگی ارائه نمیدهد.
- نتایج اولیه نشان میدهد مدلهای سری GPT-6 با ثبت کمترین میزان توهّم در صدر نشستهاند، در حالی که برخی مدلهای پرسرعت مانند Gemini 3.8 Flash بالاترین نرخ خطای ساختگی را ثبت کردهاند.
امتیازها و رتبهبندی
تغییرات کلیدی در نسخه ۱.۱ بنچمارک Harvey LAB
معیار سنجش توهّم (Hallucination)
در مطالعات مربوط به ترجیحات انسانی که توسط هاروی (Harvey) انجام شد، متخصصان حقوقی اعلام کردند که توهّم هوش مصنوعی مهمترین فاکتور در انتخاب پاسخ برتر بین دو خروجی جامع بهحساب میآید. سیستم سنجش توهّم در این ارزیابی، دقیقاً روی خطاهایی دست میگذارد که میتوانند تأثیر واقعی و مخربی روی کارهای حقوقی بگذارند و البته رویکردی محتاطانه در ثبت خطاها در پیش گرفته است. این سیستم ادعاهای بیپایه و اساس درباره پرونده مورد نظر را از دانش حقوقی عمومی متمایز میکند؛ بنابراین اگر مدلی فراتر از فایلهای ارائهشده به قوانین موضوعه یا رویه قضایی عمومی استناد کند، جریمه نمیشود.
تمام خروجیهایی که یک مدل ارائه میدهد، بر اساس اسناد و مدارک اولیه همان تسک ممیزی میشوند. اگر برای تسکی خروجی قابل استفادهای ارائه نشود، امتیازش صفر میشود و وارد محاسبات نرخ توهّم نخواهد شد. در این تعریف، توهّم به هرگونه ادعایی در متن نهایی گفته میشود که مدارک اولیه پشتیبان آن نباشند و به یکی از این سه دسته تقسیم میشود:
- تناقض مستقیم با اسناد و مدارک پرونده.
- جعل و ساختن محتوا یا نقلقولهای غیرواقعی از منبع.
- بیان ادعایی مشخص و بدون هیچگونه مدرک در سوابق موجود.
هر مورد توهّم در دو دسته «بنیادین و اثرگذار» (Material) یا «جزئی» (Minor) رتبهبندی میشود. توهّم بنیادین به خطایی گفته میشود که مخاطب را در یک نکته اساسی به اشتباه بیندازد؛ مثلاً درج نادرست تاریخی که طبق قرارداد الزامی بوده است. در مقابل، توهّم جزئی یک خطای واقعی است اما بعید به نظر میرسد تفسیر حقوقی کلی از سند را دگرگون کند. نکته مهم اینجاست که فقط توهّمهای بنیادین روی امتیاز نهایی اثر منفی میگذارند: وجود حتی یک توهّم بنیادین باعث میشود نمره آن تسک در شاخص جدید «All-Pass Rate با فیلتر توهّم» کاملاً صفر شود. شاخص قبلی میزان رعایت معیارهای حقوقی را قبل از فیلتر توهّم میسنجد و تعداد توهّمهای جزئی و بنیادین نیز برای شفافیت گزارش میشود، هرچند خطاهای جزئی نمرهای کم نمیکنند.
طبق نتایج بهدستآمده، مدلهای سری GPT-6 کمترین میزان توهّم را ثبت کردهاند؛ مدل GPT-6 Astra با میانگین ۰.۰۳ توهّم بنیادین در هر تسک (تنها ۴ توهّم در کل ۱۲۰ تسک) و GPT-6 Sol با میانگین ۰.۰۷ (۸ توهّم در کل ۱۲۰ تسک) پیشتاز هستند. در نقطه مقابل، مدل Gemini 3.8 Flash با میانگین ۱۳.۹۶ توهّم در هر تسک بالاترین نرخ خطا را در مجموعه اولیه داشته است. این آمار نشان میدهد تکمیل معیارها و نداشتن توهّم دو مهارت کاملاً متفاوت هستند؛ برای مثال مدل Muse Spark 1.3 بالاترین درصد پوشش معیارها (۹۶.۰٪) را پاس کرده اما به طور میانگین ۱.۶۸ توهّم بنیادین در هر تسک ثبت نموده است. جالب اینکه تمام مدلهای وزنباز (Open-Weights) به طور میانگین حداقل ۲.۰۹ توهّم بنیادین در هر تسک داشتهاند؛ موضوعی که ثابت میکند نرخ توهّم بیش از حوزه حقوقی، مستقیماً به معماری و قدرت خود مدل بستگی دارد.
مدل داور برای تشخیص توهّم چگونه انتخاب شد؟
در این فرآیند، از مدل قدرتمند GPT-6 Sol (در بالاترین حالت استدلال) برای هر دو مرحله بررسی و ممیزی توهّم استفاده شده که کاملاً مستقل از هیئت داوری سهنفره عمل میکند. برای انتخاب بهترین مدل داور، شش کاندیدا شامل GPT-6 Sol، GPT-6 Luna، Grok 4.7، Claude Opus 5.5، Claude Sonnet 5.5 و Gemini 3.8 Flash (همگی در بالاترین سطح استدلال) روی ۲۰ تسک مشترک و خروجیهای هشت مدل مختلف با یکدیگر مقایسه شدند.
در این ارزیابی مشخص شد که GPT-6 Sol و GPT-6 Luna عموماً توهّمهای بنیادین بیشتری را کشف و ثبت کردهاند، در حالی که Claude Sonnet 5.5 و Gemini 3.8 Flash موارد بسیار کمتری را تشخیص دادهاند. مدل Claude Opus 5.5 نیز در تمام ردیفها بین Grok 4.7 و Claude Sonnet 5.5 قرار گرفت. در مجموع، مدل Opus حدود ۹۹ توهّم بنیادین را تأیید کرد؛ در حالی که این رقم برای Grok به ۲۱۹، برای Sonnet به ۵۷ و برای GPT-6 Sol به ۴۷۰ مورد رسید. نکته جالب توجه اینجاست که GPT-6 Sol حتی با وجود رویکرد محتاطانه سیستم، توانسته توهّمهای بنیادین بسیار بیشتری را شکار کند.
همچنین هر شش مدل داور در خروجیهای مدل GPT-6 Astra هیچ توهّم بنیادینی پیدا نکردند و برای GPT-6 Sol نیز این رقم بین ۰ تا ۰.۲۰ توهّم در هر تسک متغیر بود؛ نتیجهای که نشان میدهد این دو مدل تحت نظارت هر داوری جزو دقیقترین و کمخطاترین گزینهها هستند.
نرخ قبولی مشروط (Near-Pass Rate) با فیلتر توهّم
هزینهها
میزان مصرف توکن
سرعت پردازش و پاسخدهی
تعداد رفتوبرگشتها (Turns)
اندازه مدلها (ویژه مدلهای وزنباز)
مقایسه امتیاز بر اساس تاریخ عرضه
علاقهمندان میتوانند نمونه تسکهای شاخص این بنچمارک، فایلهای مرجع دادهشده به مدلها و خروجیهای نهایی تولیدشده توسط هر مدل را در مجموعه دادههای عمومی بررسی کنند.
منابع و مستندات بنچمارک Harvey LAB
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
جنجال هوش مصنوعی در مسابقه ویدیویی نیکون؛ برنده رتبه اول رد صلاحیت شد!
مسابقه ویدیویی معتبر «دنیای کوچک» نیکون با یک رسوایی بزرگ روبهرو شد؛ اثری که به مقام اول رسیده بود به دلیل استفاده پنهانی از هوش مصنوعی مولد رد صلاحیت شد تا جایزه به یک ویدیوی شگفتانگیز از دنیای تکسلولیها برسد. این ماجرا نیکون را بر آن داشت تا با توجه به پیشرفت شتابان هوش مصنوعی، قوانین داوری خود را به شکل اساسی بازنگری کند.
عصر طلایی دکاکورنها؛ سرمایهگذاران با سرعتی بیسابقه استارتاپهای هوش مصنوعی را ۱۰ میلیارد دلاری میکنند!
دنیای فناوری وارد عصر طلایی «دکاکورنها» شده و استارتاپهای هوش مصنوعی سریعتر از هر زمان دیگری به ارزشهای نجومی بالای ۱۰ میلیارد دلار میرسند. در حالی که سرمایهگذاران خطرپذیر مبالغ هنگفتی را به پای این شرکتها میریزند، کارشناسان هشدار میدهند که این تبوتاب همیشه تضمینکننده موفقیت بلندمدت نیست.
خداحافظی با داغ کردن حافظهها در دیتاسنترهای هوش مصنوعی؛ رونمایی کیوکسیا از SSDهای مجهز به خنککننده مایع
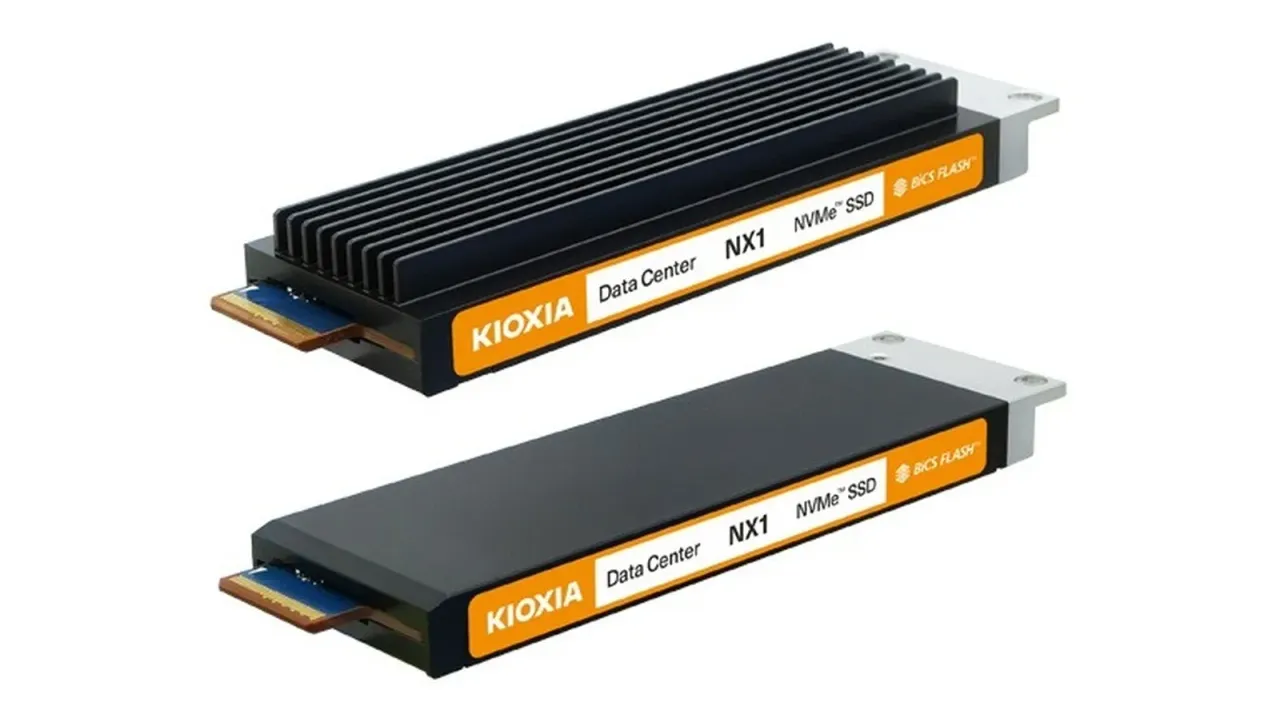
شرکت ژاپنی کیوکسیا از درایوهای SSD جدیدی با نام NX1 رونمایی کرده که به خنککننده مایع مجهز هستند و اختصاصاً برای پاسخگویی به فشار سنگین دیتاسنترهای هوش مصنوعی ساخته شدهاند. این درایوها با مهار هوشمندانه حرارت، جلوی افت ناگهانی سرعت و کاهش طول عمر قطعات را در پردازشهای فوقسنگین میگیرند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.