معماری شگفتانگیز H-JEPA؛ یان لکان چطور برنامهریزی چندسطحی را به رباتها یاد میدهد؟
محققان آزمایشگاه یان لکان با معرفی معماری نوآورانه H-JEPA، تحول چشمگیری در توسعه مدلهای جهان ایجاد کردهاند. این سیستم پیشرفته با تفکیک تصمیمگیریهای کلان از حرکات فیزیکی لحظهای، به رباتها یاد میدهد مانند انسان در چند لایه مختلف فکر کنند و اهداف پیچیده را با کمترین توان پردازشی به سرانجام برسانند.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- پژوهشگران آزمایشگاه هوش ماشین پیشرفته (AMI) یان لکان از معماری جدید H-JEPA رونمایی کردند؛ سیستمی که محیط را در مقیاسهای زمانی مختلف تحلیل میکند تا رباتها بتوانند اهداف بزرگ و پیچیده را به کارهای کوچک و قابلمدیریت بشکنند.
- برخلاف مدلهای قبلی که در جزئیات فیزیکی غرق میشدند و پردازش زیادی هدر میدادند، H-JEPA تفکر استراتژیک را از حرکات لحظهای جدا میکند و در شبیهساز ماز توانسته موفقیت رباتها را به دو برابر برساند.
- این معماری گام مهمی برای تحول در اتوماسیون انبارها و رباتیک است؛ محققان حتی در حال کار روی اتصال لایههای بالای این مدل به زبان طبیعی هستند تا رباتها مستقیماً با دستورات متنی هدایت شوند.
پژوهشگران آزمایشگاه هوش ماشین پیشرفته (AMI Labs) وابسته به یان لکان به همراه چند مؤسسه دانشگاهی، از معماری جدیدی به نام H-JEPA رونمایی کردند؛ یک معماری پیشرفته برای «مدلهای جهان» (World Models) که با استفاده از بازنماییهای تفکیکشده از محیط، یاد میگیرد چطور در مقیاسهای زمانی گوناگون برنامهریزی کند.
این سیستم در مقایسه با مدلهای معمولی و یکسطحی JEPA، نهتنها دقت ناوبری و مسیریابی را بهشدت بالا میبرد، بلکه توان پردازشی به مراتب کمتری هم برای برنامهریزی و تصمیمگیری مصرف میکند.
این دستاورد دقیقاً دست روی یکی از چالشهای بزرگ هوش مصنوعی گذاشته است: درک دنیای فیزیکی و عمل کردن درست در آن. برای مثال، رباتی را تصور کنید که میخواهد داخل یک ساختمان حرکت کند؛ این ربات هم باید مقصد کلیاش را بداند و هم تکتک حرکات و گامهای فیزیکیاش را لحظهبهلحظه کنترل کند. معماری H-JEPA این گره را با برنامهریزی در سطوح مختلف انتزاع باز میکند؛ یعنی به سیستم اجازه میدهد در سطح کلان درباره مقصد تصمیم بگیرد و بعد این نقشه را مرحلهبهمرحله به حرکات دقیق فیزیکی تبدیل کند.
چرا مدلهای جهان JEPA به ساختار سلسلهمراتبی نیاز دارند؟
معماریهای پیشبین تعبیهشده مشترک یا همان JEPAs طوری طراحی شدهاند که جهان اطراف را بدون درگیر شدن در جزئیات ریز و دستوپاگیر مدلسازی کنند. برعکس مدلهای هوش مصنوعی مولد که سعی میکنند تکتک پیکسلها را حدس بزنند و بسازند، مدلهای JEPA ورودیهای بصری مثل عکس و ویدیو را به «نمایشهای نهفته» (Latent Representations) تبدیل میکنند؛ یعنی مجموعهای جمعوجور از ویژگیهای کلیدی که مفهوم صحنه را خلاصه میکند. همین ترفند باعث شده تا این مدلها فوقالعاده سبکتر و کارآمدتر از مدلهای مولد باشند و در کارهایی مثل مسیریابی در محیط فیزیکی یا جابهجایی اشیا—که اصلاً نیازی به ساختن تکتک پیکسلها ندارند—عملکردی خیرهکننده و دقیق نشان دهند.
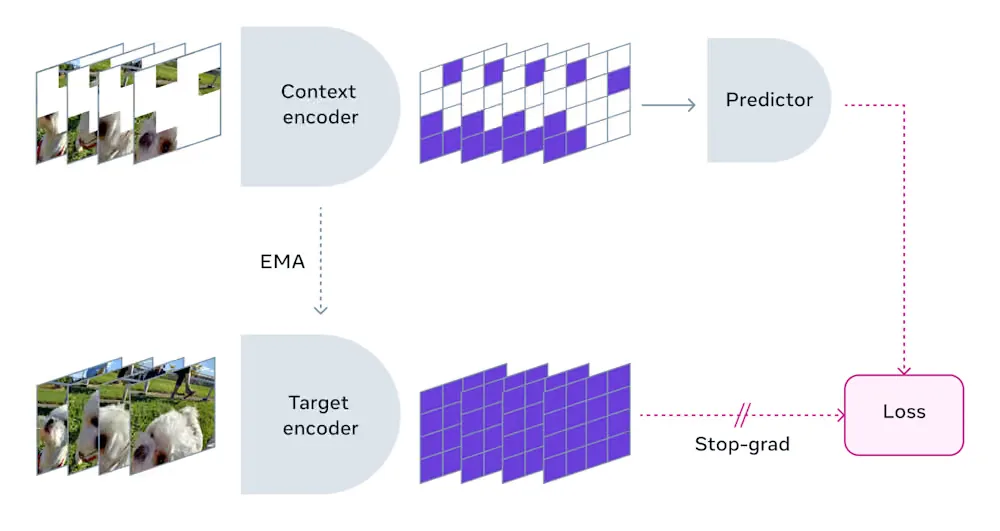
در نسخههایی از JEPA که بر پایه کنش عمل میکنند (Action-conditioned JEPAs)، مدل علاوه بر دادههای بصری، اقدامات و کنشها را هم تحویل میگیرد. به این ترتیب میتواند نتیجه کارهای مختلف را در ذهنش شبیهسازی کند و خروجی پیشبینیشده را با هدفی که برایش تعیین شده بسنجد.
اما روشهای فعلی با دو چالش بزرگ دستبهگریبان هستند؛ اول اینکه پیشبینی یک نتیجه دوردست مستلزم شبیهسازی بیشمار گام کوچک است که هم هزینههای سرسامآور پردازشی روی دست سیستم میگذارد و هم خطاهای ریز را بهمنوار روی هم تلنبار میکند. دوم اینکه مدل ناچار است پویاییهای فیزیکی بسیار ریز را همزمان با ارزیابی پیشرفت کلی بهسوی هدف بلندمدت، در یک بستر واحد تحلیل کند که کار را فوقالعاده دشوار میسازد.
برای درک بهتر، یک ربات چهارپا را در یک ماز یا هزارتو تصور کنید. موقع کنترل حرکت، موقعیت تکتک پاهای ربات اهمیت حیاتی دارد؛ اما سیستم برنامهریزی که وظیفه تعیین مسیر کلی را بر عهده دارد، در درجه اول فقط میخواهد بداند ربات در کجای ماز قرار گرفته است. وقتی تلاش کنید موقعیت کلی ربات و حرکات ظریف فیزیکی پاها را توی یک نمایش نهفته یکسان جا بدهید، کار به شدت گره میخورد و یادگیری برای مدل عذابآور میشود.
مدل H-JEPA دقیقاً برای حل همین مشکل به میدان آمده و بازنماییها را در لایهها و سطوح مختلف یاد میگیرد. به این ترتیب، برنامهریزی بلندمدت با اطلاعاتی کاملاً مستقل و متمایز از بخشی که کارهای فوری و لحظهای را مدیریت میکند، پیش میرود.
مدل H-JEPA چطور یاد میگیرد و برنامهریزی میکند؟
مدل H-JEPA بر اساس توالیهایی از مشاهدات و اقداماتی که آنها را به هم وصل میکند، آموزش میبیند. پایینترین سطح این معماری، مشاهدات بصری را کدگذاری میکند و بر اساس وضعیتهای قبلی و اقدامات انجامشده، وضعیت نهفته بعدی را پیشبینی میکند. در مقابل، سطوح بالاتر بازنماییهای سطح پایینتر را میگیرند و تغییرات و انتقالها را در بازههای زمانی بسیار طولانیتر پیشبینی میکنند.
هر سطح از این ساختار به انکودر وضعیت (State Encoder)، انکودر اقدام (Action Encoder) و پیشبین (Predictor) اختصاصی مجهز است. انکودر وضعیت، محیط را متناسب با همان مقیاس زمانی به تصویر میکشد؛ انکودر اقدام، فعالیتها را در طول بازه زمانی مربوطه خلاصه میکند؛ و بخش پیشبین هم یاد میگیرد که آن وضعیت به چه شکل تغییر پیدا میکند.
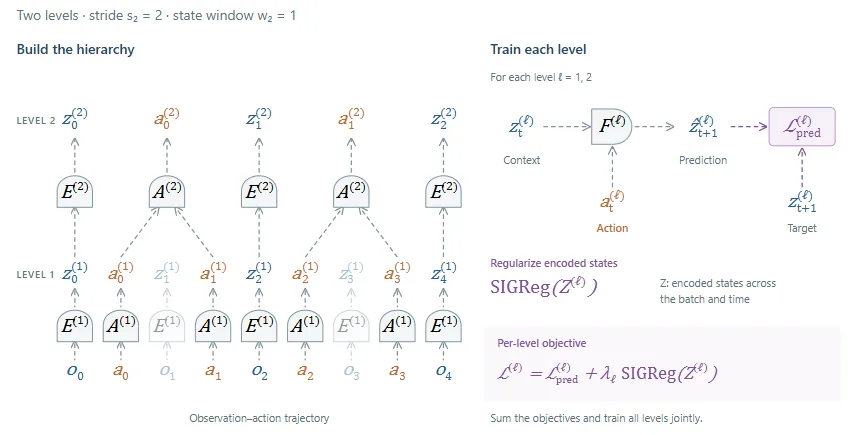
تیم تحقیقاتی این ساختار سلسلهمراتبی را بهصورت سرتاسری (End-to-End) آموزش دادهاند. در این فرایند، هر سطح نمایش پیشبینیشدهاش را با آینده واقعی مقایسه میکند. یک سازوکار منظمسازی (Regularization) نیز مانع از این میشود که مدل برای تمام مشاهدات خروجی یکسانی تولید کند و دچار فروپاشی بازنمایی شود. جالب اینجاست که سیگنالهای آموزشی از سطوح بالاتر هم به سمت انکودرهای سطوح پایین سرازیر میشوند تا هماهنگی کامل حفظ شود.
اگرچه فواصل زمانی میان سطوح از قبل مشخص شده است، اما اطلاعاتی که هر سطح در حافظه نگه میدارد، کاملاً یادگرفتنی است. وقتی بخشهای مختلف محیط با سرعتهای متفاوتی تغییر میکنند، سطوح بالاتر ویژگیهای کندتر و پایدارتری را که در طولانیمدت قابل پیشبینی هستند حفظ میکنند و جزئیات گذرا و تند را دور میریزند.
در همان مثال ماز، پایینترین سطح برای پیشبینی حرکات آنی ربات به وضعیت مفاصل آن نیاز دارد؛ در حالی که سطح بالاتر میتواند صرفاً موقعیت مکانی کلی ربات را بدون حفظ جزئیات مفاصل ثبت و نگهداری کند.
در جریان برنامهریزی، H-JEPA وضعیت فعلی و هدف نهایی را در تمامی سطوح کدگذاری میکند. بخش برنامهریزی سطح بالا، میان گزینههای موجود میگردد تا اقداماتی را پیدا کند که خروجیهای پیشبینیشدهشان در فضای نهفته، به هدف نزدیکتر است.
وضعیتهای پیشبینیشده در این سطح، به ریزهدفها یا اهداف میانی (Subgoals) برای سطح بعدی تبدیل میشوند؛ سطحی که خودش به دنبال اقداماتی برای رسیدن به این اهداف میانی میگردد. به همین ترتیب، هر سطح نقشه را جزئیتر و صیقلیتر میکند تا در نهایت، پایینترین سطح اقدامات فیزیکی و پایهای را برای اجرا تحویل دهد.
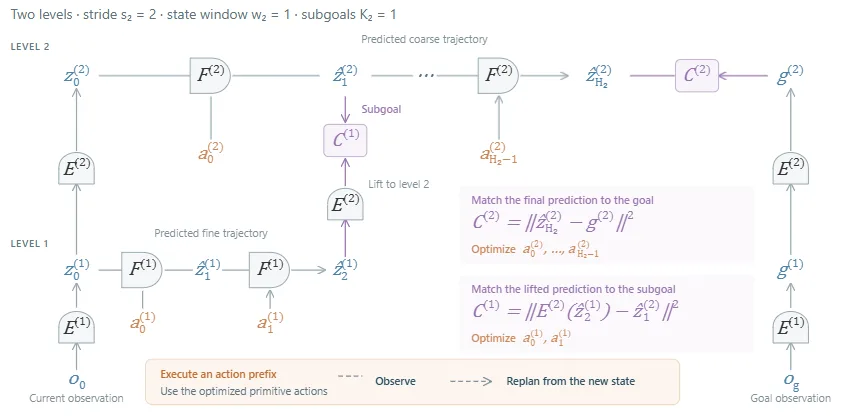
در نتیجه، در هزارتو بالاترین سطح تمام تمرکزش را روی پیشروی بهسوی مقصد نهایی میگذارد، در حالی که سطوح پایینتر جابهجاییهای کوتاهمدت و حرکات فیزیکی را راستوریس میکنند.
پس از اجرای یک زنجیره کوتاه از اقدامات، سیستم بلافاصله با توجه به مشاهدات جدید محیطی و بررسی انحرافاتی که نسبت به مسیر پیشبینیشده مشاهده میکند، نقشه و برنامهاش را بهروزرسانی میکند.
عملکرد H-JEPA در میدان عمل و آزمونهای واقعی
پژوهشگران عملکرد H-JEPA را در چهار محیط شبیهسازیشده ناوبری و دستکاری اشیا بررسی کردند: FourRoom Distractors، Visual AntMaze، Push-T و OGBench Cube. آنها این مدل را در برابر LeWM (یک مدل JEPA تکسطحی) و HWM (یک مدل جهان سلسلهمراتبی که در فضای نهفته مشترک برنامهریزی میکند) محک زدند.
در محیطهای FourRoom، AntMaze و Cube، افزایش سطوح تا یک ساختار سه لایه بهطور چشمگیری نرخ موفقیت را بالا برد و در عین حال، مصرف پردازش برنامهریزی را کاهش داد. برتری تفکیک بازنماییها بیش از همه در AntMaze به چشم آمد؛ جایی که H-JEPA سهسطحی به نرخ موفقیتی تقریباً دو برابر مدل رقیب یعنی HWM دست یافت.
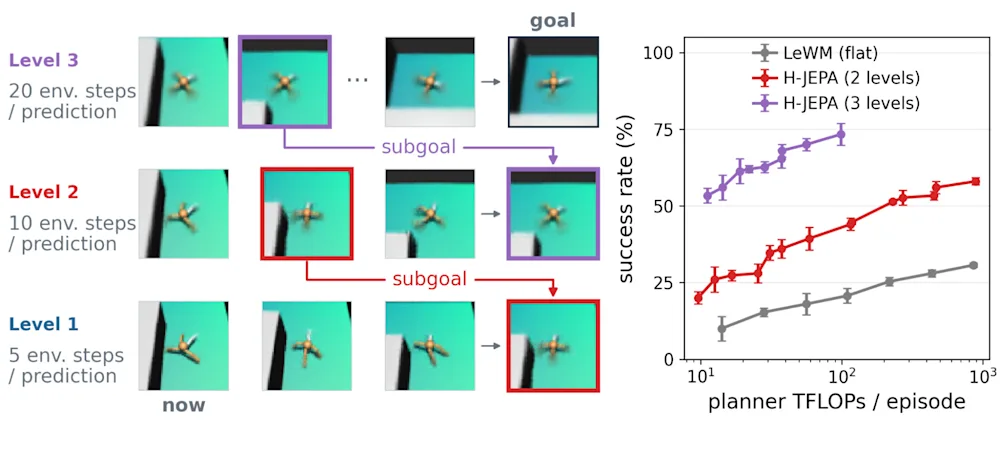
در محیط AntMaze، موقعیت کلی ربات از نمایشهای سطوح بالاتر کاملاً قابل تشخیص است، در حالی که اطلاعات مربوط به چینش پاهای آن کنار گذاشته میشود. علاوه بر این، سطوح بالاتر تخمین روانتر و دقیقتری از فاصله تا مقصد در طول راهروهای ماز ارائه میدهند و سیگنال شفافتری برای رد شدن از دیوارها به بخش برنامهریز میرسانند.
تیم تحقیقاتی در گام بعد، H-JEPA را روی مجموعه داده DROID آزمایش کرد؛ دیتاستی از ویدیوهای واقعی جابهجایی اشیا توسط ربات با نورپردازیها، اشیا و پسزمینههای متنوع. آموزش پیشبین خالص در ابتدا تمایل داشت جزئیات ساکن صحنه را حفظ کند و اطلاعات حرکتی ربات را نادیده بگیرد؛ بنابراین محققان یک هدف «پویایی معکوس» (Inverse Dynamics) به آن اضافه کردند که اقدامات ارتباطدهنده میان دو وضعیت مشاهدهشده را پیشبینی میکند و به حفظ دادههای مرتبط با عمل کمک میرساند. نتیجه این شد که H-JEPA با توان پردازشی به مراتب کمتر، دقت برنامهریزی آفلاین را نسبت به رقبا ارتقا داد.
معماری H-JEPA میتواند انقلابی در ناوبری رباتیک، اتوماسیون انبارها و سیستمهای رباتیک بازویی ایجاد کند؛ همان سامانههایی که باید اهداف بلندمدت را با حرکات فیزیکی میلیمتری هماهنگ کنند. البته این مدل هنوز بینقص نیست و محدودیتهایی دارد؛ آزمایشها نشان میدهد که لایههای سلسلهمراتبی بیشتر همیشه لزوماً بازدهی بهتری نمیآورد و مزایای آن بستگی زیادی به گستره دادههای آموزشی دارد.
پژوهشگران در چشمانداز آینده پیشنهاد میکنند که بازنماییهای سطوح بالاتر به زبان متصل شوند؛ موضوعی که در نهایت به ایجنتها امکان میدهد اهداف خود را به جای تصاویر تارگت، بهصورت دستورات متنی ساده دریافت کنند. در حال حاضر، H-JEPA پتانسیل عظیم تفکیک بازنماییها برای حرکات لحظهای و اهداف بلندمدت را به زیباترین شکل به رخ کشیده است.
مطالب مرتبط و پیشنهادی
یک ماه هر روز به خودم ایمیل زدم و جمینای جواب داد؛ نتیجه جالب این آزمایش با هوش مصنوعی گوگل
چه اتفاقی میافتد اگر به مدت یک ماه هر روز افکار، یادداشتها و دغدغههای ذهنیتان را برای خودتان ایمیل کنید و بگذارید هوش مصنوعی جمینای به آنها جواب دهد؟ این آزمایش تجربی نشان میدهد که دستیار هوش مصنوعی گوگل فراتر از پاسخهای اداری و کلیشهای، چطور میتواند ابزاری غافلگیرکننده برای مرتب کردن شلوغیهای ذهن و پیدا کردن زوایای پنهان کارهای روزمره باشد.
دستهگلهای جنجالی هوش مصنوعی آنتروپیک؛ کاخ سفید گزارش تخلفات را اجباری کرد!
پس از دستهگلهای اخیر مدلهای هوش مصنوعی آنتروپیک و نفوذ ناخواسته آنها به سامانههای دولتی، کاخ سفید رویکرد ملایم قبلی را کنار گذاشت. حالا دولت آمریکا با ابلاغ دستورالعملی تازه، تمامی توسعهدهندگان هوش مصنوعی را موظف کرده که هرگونه حادثه و خطای امنیتی مدلهای خود را فوراً گزارش داده و خسارات ناشی از آن را جبران کنند.
شاهکار ارتش ۲۰۰۰ ایجنتی پرایم اینتلکت؛ بازنویسی پرایم ایجنت با زبان راست و سرعت ۱۳ برابری!
استارتاپ پرایم اینتلکت در اقدامی شگفتانگیز، با هماهنگی بیش از ۲۰۰۰ ایجنت هوش مصنوعی موفق شد فریمورک پرایم ایجنت را ظرف دو هفته از تایپاسکریپت به زبان راست بازنویسی کند. نتیجه این مهاجرت عظیم، کاهش ۸۳ درصدی مصرف حافظه و جهش چشمگیر ۱۳ برابری در سرعت اجرای این ابزار متنباز است.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.