نسخه پنجم شاخص هوش مصنوعی آرتیفیشل آنالیسیس در راه است؛ تستهای محرمانه کدنویسی برای مچگیری از مدلها!
پلتفرم ارزیابی آرتیفیشل آنالیسیس از نسخه پنجم شاخص معروف خود (Intelligence Index v5) رونمایی میکند که بزرگترین بازنگری این بنچمارک در سال جاری به شمار میرود. در این نسخه با اضافه شدن بنچمارک علمی ترمینال و آزمونهای محرمانه کدنویسی، رتبهبندی مدلهای برتر هوش مصنوعی حسابی دگرگون خواهد شد.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- نسخه پنجم بنچمارک جامع اینتلیجنس ایندکس (Intelligence Index v5) اواخر اکتبر با آزمونهای سختگیرانهتر منتشر میشود و میتواند ردهبندی فعلی مدلهای برتر هوش مصنوعی را حسابی به هم بریزد.
- این نسخه شامل بنچمارک Terminal-Bench Science با ۷۰ تسک پژوهشی در محیط خط فرمان و یک بنچمارک کدنویسی با تستهای محرمانه و منتشرنشده است تا مانع نشت دادهها در مرحله آموزش مدلها شود.
- در ارزیابیهای اولیه این بنچمارک علمی، حتی قدرتمندترین مدلها هم نتوانستهاند به مرز موفقیت ۶۴ درصدی برسند که نشان میدهد ایجنتهای هوش مصنوعی هنوز فاصله زیادی تا اجرای بینقص وظایف پیچیده دارند.
پلتفرم ارزیابی مستقل آرتیفیشل آنالیسیس (Artificial Analysis) قصد دارد در اواخر ماه اکتبر از نسخه پنجم شاخص هوش خود تحت عنوان «Intelligence Index v5» پرده بردارد؛ آپدیتی که بزرگترین بازنگری این بنچمارک ترکیبی در سال جاری محسوب میشود. در این بهروزرسانی مهم، بنچمارک علمی «Terminal-Bench Science» و یک بنچمارک اختصاصی کدنویسی اضافه خواهد شد که مجموعه دادههای آزمایشی آن کاملاً محرمانه میماند و هرگز منتشر نخواهد شد.
شاخص Intelligence Index نتایج چندین ارزیابی گوناگون را جمعبندی کرده و در قالب یک امتیاز واحد برای نشان دادن توانمندی مدلها ارائه میدهد. جالب اینکه پژوهشگران در حال حاضر در مقالههای پژوهشی مدلهای شخص ثالث به این شاخص استناد میکنند؛ به همین دلیل تغییر بنچمارکهای آن میتواند جدول ردهبندی مدلها را زیر و رو کند و امکان مقایسه مستقیم نتایج جدید با گذشته را از بین ببرد.
نسخه ۵ دو معیار سختگیرانهتر را اضافه میکند
تیم آرتیفیشل آنالیسیس این تغییرات را به صورت مرحلهای اعمال کرده است. بیلد فعلی یعنی نسخه ۴.۳.۲ شامل بنچمارکهای مختلفی مثل AA-Briefcase v1.1، GDPval-AA v2.1، AutomationBench-AA، Terminal-Bench 4.0، SciCode، آزمون Humanity's Last Exam، GDP.pdf، CritPt، AA-Omniscience و AA-LCR v1.1 است.
دستهبندی | وزن فعلی |
|---|---|
ایجنتها (Agents) | ۳۰٪ |
کدنویسی (Coding) | ۲۰٪ |
عمومی (General) | ۳۰٪ |
استدلال علمی (Scientific reasoning) | ۲۰٪ |
نسخه پنجم قرار است بخشهای زیر را به این ترکیب اضافه کند:
- ترمینال بنچ ساینس (Terminal-Bench Science): یک آزمون ارزیابی مستقل که توسط پژوهشگران دانشگاه استنفورد به همراه تیم Terminal-Bench و Harbor و با مشارکت دانشمندانی از سراسر جهان توسعه یافته است. تسکهای این بنچمارک در واقع فرآیندهای واقعی پژوهشی را در محیط خط فرمان شبیهسازی میکنند.
- یک بنچمارک محرمانه کدنویسی: ارزیابی جدیدی که بر پایه دادههای تستی منتشرنشده ساخته شده است. آرتیفیشل آنالیسیس هنوز جزییات تسکها، شیوه نمرهدهی یا ترکیب دیتاست آن را فاش نکرده است.
همچنین این مجموعه هنوز وزن نهایی هر دستهبندی در نسخه پنجم، تاریخ دقیق انتشار و راهنمای مقایسه نمرات نسخه ۵ با نسخه ۴.۳.۲ را اعلام نکرده است. انتظار میرود این جزییات همزمان با انتشار لاگ تغییرات (Changelog) رسمی اعلام شوند.
ورود تسکهای علمی به شاخص هوش
بنچمارک Terminal-Bench Science میسنجد که آیا یک ایجنت هوش مصنوعی میتواند با استفاده از شل (محیط ترمینال)، فرآیندهای علمی و واقعی پژوهشی را با موفقیت جلو ببرد یا نه. این آزمون شامل ۷۰ تسک در پنج حوزه مختلف است و هر تسک سه بار اجرا میشود. نتایج با معیار pass@1 ثبت میشوند؛ یعنی تنها در صورتی یک تلاش موفق به حساب میآید که تمام تستها با موفقیت پاس شوند و اگر اعتبارسنج (Verifier) با تایماوت مواجه شود، شکست تلقی خواهد شد.
لیدربورد فعلی و مستقل این بنچمارک به خوبی نشان میدهد که این آزمون تا چه اندازه دشوار و بیرحم است:
- مدل GPT-6 Astra (نسخه Max): ۶۳.۳٪
- مدل Claude Opus 5.5 (نسخه Xhigh با Default Fallback): ۶۱.۹٪
- مدل Claude Opus 5.5 (نسخه Max با Default Fallback): ۵۹.۰٪
- مدل Claude Sonnet 5.5: ۵۳.۰٪
هیچکدام از سیستمهای موجود در لیست نتوانستهاند به امتیاز ۶۴ درصد برسند؛ رقمی که نشان میدهد ایجنتهای فعلی هنوز فاصله زیادی تا قابلیت اطمینان صددرصدی در انجام وظایف دارند. اضافه شدن این بنچمارک میتواند جدول ردهبندی کلی را به نفع مدلهایی تغییر دهد که در نشستهای طولانیمدت ترمینال دوام میآورند، پس از خطاهای حین اجرا خودشان را بازیابی میکنند و از پس مراحل چندگانه تحقیقاتی برمیآیند.
تستهای محرمانه؛ راهکاری برای جلوگیری از نشت دادههای آموزشی
وقتی سؤالات بنچمارکهای عمومی در سطح اینترنت دستبهدست میشوند، این احتمال وجود دارد که وارد دادههای آموزشی مدلها شوند. در این حالت، مدل هوش مصنوعی به جای اینکه قدرت حل مسائل ندیدهشده و جدید را نشان دهد، صرفاً راهحلهای حفظی و آشنا را بازتولید میکند؛ اتفاقی که ارزش و اعتبار بنچمارک را به عنوان معیاری برای سنجش مهارت واقعی کدنویسی زیر سؤال میبرد.
آرتیفیشل آنالیسیس برای کاهش این ریسک، بیش از پیش به سراغ نسخههای تستی محرمانه و فیلترینگهای دقیق رفته است؛ درست همان رویکردی که در بنچمارک AutomationBench-AA در پیش گرفت. بنچمارک جدید کدنویسی هم همین مسیر را ادامه میدهد. دادههای منتشرنشده این آزمون میتوانند ارزیابی دقیقتر و پاکتری ارائه دهند، هرچند تیمهای بیرونی دیگر نمیتوانند کل ارزیابی را به شکل مستقل بازتولید کرده یا توزیع دادههای آزمون را بررسی کنند.
برای تغییر ناگهانی نمرات آماده باشید
- مقایسههای داخلی را پس از انتشار مجدداً اجرا کنید: نمرات نسخه ۴.۳.۲ و نسخه ۵ باید به عنوان دو سری کاملاً جداگانه در نظر گرفته شوند تا زمانی که آرتیفیشل آنالیسیس وزنها و متدولوژی جدید را به طور رسمی منتشر کند.
- خط مبنای ایجنتهای کدنویسی را بهروزرسانی کنید: نسخه Terminal-Bench 4.0 پیش از این جایگزین نسخه ۲.۱ شده و با مجموعهای سختتر شامل ۶۶ تسک، بازنگری در سقف پردازش و زمان، و محیطها و اعتبارسنجهای جدید همراه شده است؛ بنابراین با کوچ تیمها از فریمورکهای قدیمی، احتمال افت نمرات وجود دارد.
- شکستهای ایجنت در تسکهای علمی را دقیق زیر نظر بگیرید: نمرات تجمیعی گاهی پنهان میکنند که آیا ایجنت در بخش برنامهریزی، کار با شل، مدیریت وابستگیها، محاسبات یا اعتبارسنجی شکست خورده است. این تفاوتها برای ارتقا و بهبود ایجنتهای پژوهشی نقشی حیاتی دارند.
- نسخه بنچمارک را دقیق ثبت کنید: گزارشها باید همیشه نسخه دقیق شاخص هوش (Intelligence Index)، پیکربندی مدل و تاریخ ارزیابی را مشخص کنند تا نتایج بعدی در طول زمان قابل تحلیل و تفسیر باقی بمانند.
آرتیفیشل آنالیسیس شیوههای امتیازدهی و استانداردهای ارزیابی فعلی خود را در صفحه متدولوژی بنچمارک مستند کرده است. انتظار میرود گزارش تغییرات نسخه ۵ تکلیف وزنهای نهایی، طراحی بنچمارک محرمانه کدنویسی و قوانین مقایسه نتایج میان نسخههای مختلف این شاخص را به طور شفاف مشخص کند.
مطالب مرتبط و پیشنهادی
شکار بخش گمشده کیهان با هوش مصنوعی آنتروپیک؛ کلود نقشه فرابنفش آسمان را کامل کرد
یک اخترفیزیکدان در دانشگاه جانز هاپکینز با استفاده از پلتفرم Claude Science موفق شد یکسوم گمشده از نقشه فرابنفش کیهان را بازسازی و کامل کند. این پروژه عظیم که در گذشته به ماهها کار طاقتفرسا نیاز داشت، حالا به لطف ایجنتهای هوشمند کلود و در عرض چند روز به سرانجام رسیده است.
سرمایهگذاری ۱ میلیارد دلاری انویدیا برای سلطه علمی آمریکا؛ پول خردی که خرج ابررایانههای هوش مصنوعی شد!
انویدیا از اختصاص یک میلیارد دلار برای توسعه پژوهشهای علمی و ابررایانههای هوش مصنوعی در آمریکا خبر داد؛ بودجهای که برای این غول تراشهساز حکم پول خرد را دارد اما ارتش پردازشی این کشور را در رقابت با چین تقویت میکند. این طرح بلندپروازانه با تجهیز آزمایشگاههای ملی به تراشههای بلکول، پیشتازی هوش مصنوعی و محاسبات کوانتومی را هدف گرفته است.
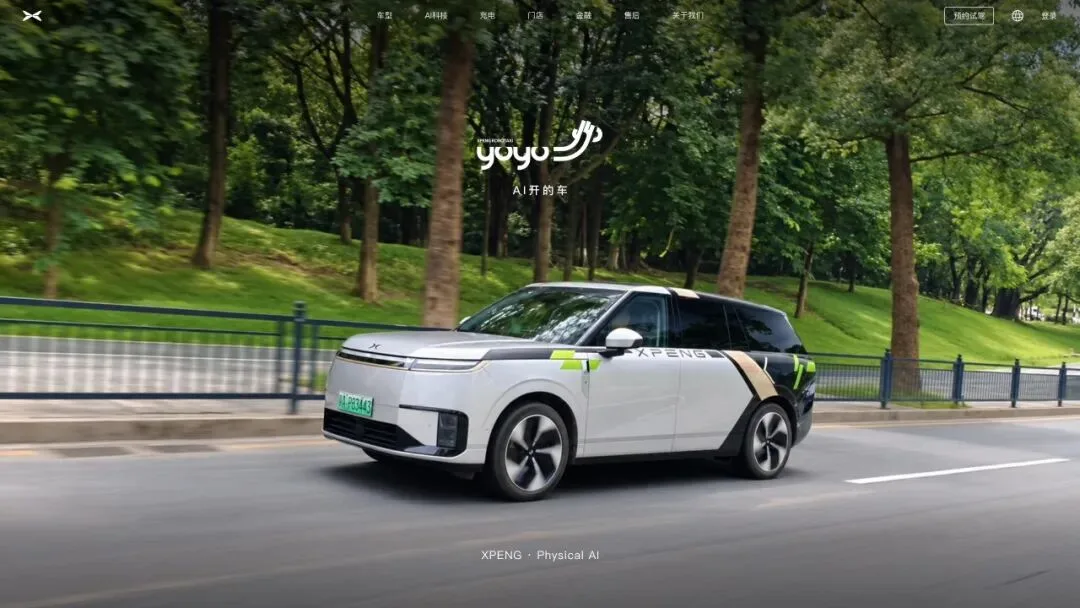
تاکسی خودران اختصاصی ایکسپنگ به خیابانها آمد؛ رونمایی از سرویس XPENG YOYO و آغاز تستهای عمومی
شرکت چینی ایکسپنگ (XPENG) با معرفی برند جهانی «XPENG YOYO» رسماً وارد فاز آزمایش عمومی تاکسیهای خودران خود شد. این روبوتاکسی تمامعیار با تکیه بر ۴ تراشه هوش مصنوعی تورینگ و مدل پیشرفته بینایی-زبانی VLA 2.0، بدون نیاز به لیدار در خیابانها مسافرگیری میکند. کاربران منتخب در چین از همین حالا میتوانند با کدهای دعوت اختصاصی، سفر در کابین لوکس و هوشمند این تاکسی را تجربه کنند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.