جهش ۱۲ امتیازی مدل LFM2.5 در ۴ محیط مختلف؛ راهکار جدید هاگینگفیس و لیکوئید ایآی برای ایجنتهای کدنویسی
هاگینگفیس و لیکوئید ایآی از فریمورک متنباز جدیدی رونمایی کردهاند که امکان آموزش ایجنتهای کدنویسی را از طریق یادگیری تقویتی در چندین محیط مختلف فراهم میکند. با این راهکار نوآورانه، مدل سبک LFM2.5 توانسته در چهار محیط ایجنت معروف جهش چشمگیر ۱۲ امتیازی را ثبت کند و تعداد فراخوانی ابزارها را به شکلی محسوس کاهش دهد. این دستاورد مسیر را برای توسعه ایجنتهای هوشمند چندمنظوره و سازگار با انواع پلتفرمها هموارتر میکند.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- هاگینگفیس و لیکوئید ایآی با انتشار یک استک متنباز، امکان آموزش ایجنتهای کدنویسی مثل Claude Code و Codex رو با یادگیری تقویتی (RL) و بدون نیاز به دستکاری کدهای اصلیشون فراهم کردن.
- با این روش نوین، دقت مدل جمعوجور LFM2.5-2.6B در حل چالشها در چهار محیط مختلف از ۴۲.۲ به ۵۴.۲ درصد رسید و تعداد فراخوانی ابزارهاش هم ۳۱ درصد کمتر و بهینهتر شد.
- این فریمورک با یه پروکسی هوشمند بین محیط ایجنت و سرور مدل، زبان و پروتکلهای مختلف رو یکدست میکنه تا مدلها بدون خطا روی هر پلتفرمی با بالاترین کارایی اجرا بشن.
یک مدل، چهار محیط اجرایی و ۱۲ امتیاز ارتقا
شاید براتون جالب باشه که وزنهای کاملاً یکسان یک مدل هوش مصنوعی میتونن در یک محیط ایجنت (Agent Harness) امتیاز ۵۲ درصد بیارن و در محیطی دیگه امتیازشون به ۲۳ درصد سقوط کنه! دلیلش هم سادهست: نرمافزاری که مدل رو احاطه کرده، دقیقاً تعیین میکنه که مدل چه چیزهایی رو ببینه و دستوراتش چطور اجرا بشن. هارنس یا چارچوب یک ایجنت وظیفه جمعآوری بستر متنی (Context)، ارسال فراخوانی ابزارها، پردازش پاسخها و تصمیمگیری درباره زمان پایان کار رو به دوش میکشه. حالا هاگینگفیس و لیکوئید ایآی (Liquid AI) یک استک متنباز برای یادگیری تقویتی (RL) درون محیطهای عملیاتی و واقعی مثل Claude Code، Codex و OpenCode منتشر کردهان که نیازی به دستکاری کدهای اصلی این محیطها نداره.
طبق گزارش راهنمای یادگیری تقویتی چندمحیطی (Multi-Harness RL)، آزمایش اصلی نشون داده که دقت مدل LFM2.5-2.6B بر اساس معیار pass@1 در چهار محیط مختلف از ۴۲.۲ درصد به ۵۴.۲ درصد جهش کرده است. معیار pass@1 نشوندهنده سهم تسکهایی هست که در همون تلاش اول با موفقیت حل میشن. جالبتر اینکه این مدل آموزشدیده در وظایفی که هر دو مدل (پایه و جدید) حل کردن، ۳۱ درصد کمتر به سراغ فراخوانی ابزارها رفته و بسیار بهینهتر عمل کرده. حالا پروکسی ضبط دادهها، ادغام با بخش آموزش، مجموعه تسکها، دادههای فاینتیونینگ نظارتشده و هر هفت چکپوینت آموزشدیده به شکل عمومی و رایگان در دسترس همگان قرار گرفته است.
انتخاب محیط ایجنت میتواند امتیاز مدل را نصف کند!
اجرای وزنهای کاملاً یکسان یک مدل در ابزارهایی مثل Claude Code، Cursor یا Cline میتونه رفتارهای کاملاً متفاوتی ایجاد کنه؛ چون هر محیط هارنس، پرامپتها، ابزارها، ساختار دادهها، منطق تلاش مجدد (Retry) و قوانین توقف مخصوص خودش رو داره. بنابراین مدل نه فقط باید اصل کار رو یاد بگیره، بلکه باید قلقهای محیط و رابطی رو هم که توش کار میکنه یاد بگیره.
برای مثال، در بنچمارک SWE-bench Pro مدل GLM-5.2 در یک محیط خاص امتیاز ۲۳ درصد گرفت، اما در محیطی دیگه به امتیاز فوقالعاده ۵۲ درصد رسید! حتی رتبهبندی هارنسها هم با تغییر مدل عوض شد: پلتفرم Codex بین ده محیط مختلف برای مدل GLM-5.2 در رتبه دوم ایستاد، در حالی که برای مدل Gemma 4 26B-A4B رتبهای بهتر از نهم پیدا نکرد.
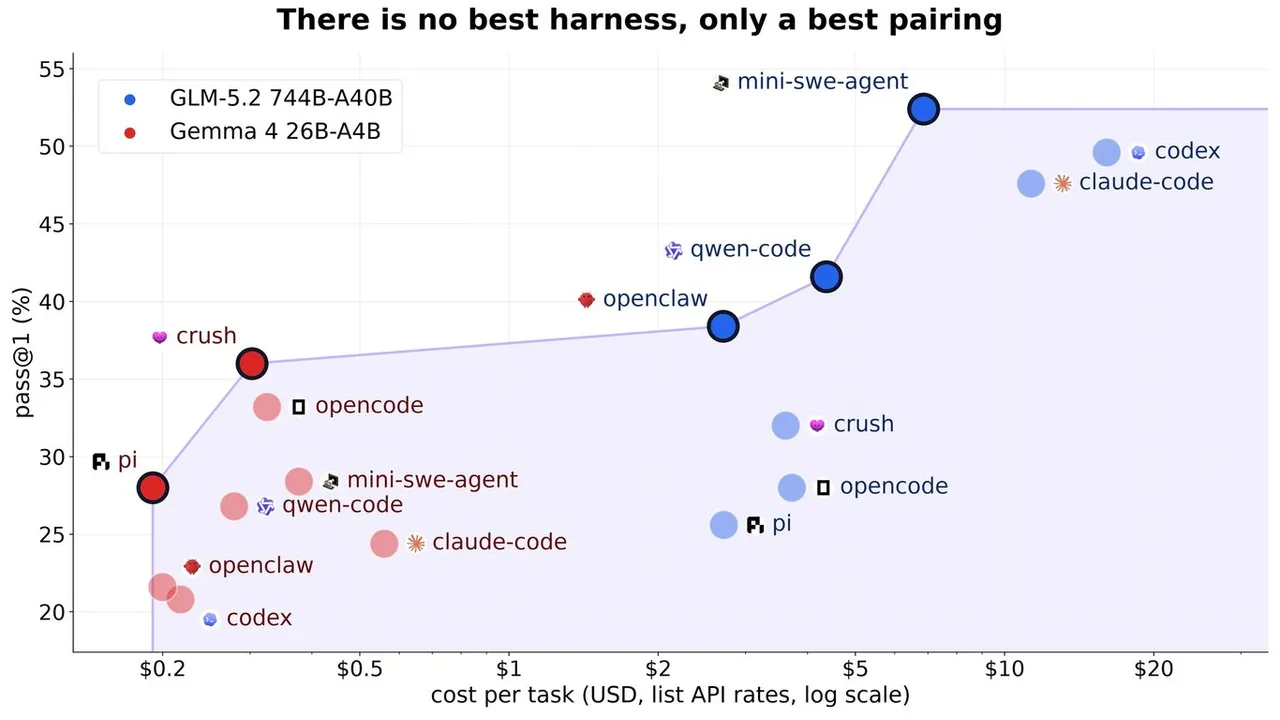
مدلهای با وزن باز (Open-weight) وقتی فقط در یک محیط آموزش میبینن، با چالش جدی انتقال تجربه روبهرو میشن. مدلی که فقط برای یک فریمورک تربیت شده، ممکنه سراغ ابزارهای ناموجود بره، آرگومانهایی تولید کنه که محیط قادر به خواندنشون نیست، یا الگوهایی از جریان کنترل رو پیش بگیره که فقط مختص همون محیط اولیه بوده. مقاله تحقیقاتی Orchard این اثر منفی رو بهخوبی ثبت کرده: وقتی مدل OpenSWE-32B از پلتفرم OpenHands به Kimi-CLI منتقل شد، امتیازش در بنچمارک SWE-bench Verified با سقوط سنگین ۵۸.۸ امتیازی به تنها ۳.۶ درصد رسید و در Terminal-Bench 2.0 هم امتیاز صفر دشت کرد! مدل Scale-SWE هم فقط و فقط در همون محیطی که آموزش دیده بود میتونست ابزارها رو بهدرستی فراخوانی کنه.
یک پروکسی هوشمند که جعبههای سیاه را آموزشپذیر میکند
آموزش چندمحیطی (Multi-harness) با قرار دادن یک پروکسی ضبط داده (Capture Proxy) میان هر محیط هارنس و سرور استنتاج vLLM کار میکنه. توسعهدهندگان کافیه محیط ایجنت رو جوری تنظیم کنن که از این پروکسی بهعنوان اندپوینت مدل استفاده کنه. به این ترتیب، هارنس با همون گویش و قالب API بومی خودش ارتباط برقرار میکنه، در حالی که پروکسی در پسزمینه تمام دادههای حیاتی برای یادگیری تقویتی رو ضبط و ذخیره میکنه.
- تشخیص پروتکل: پروکسی یکی از چهار فرمت API پشتیبانیشده رو از روی مسیر درخواست، هدرها و بدنه پیام شناسایی میکنه.
- استانداردسازی درخواست: مبدلهایی که از درگاه Polar شرکت انویدیا (NVIDIA) اقتباس شدهان، درخواست دریافتی رو به قالب استاندارد Chat Completions تبدیل میکنن.
- ثبت نمونه: سرور vLLM شناسههای دقیق توکنهای نمونهبرداریشده (Token IDs) و لاگ احتمالات پردازششده اونها رو برمیگردونه.
- بازپخش پاسخ: پروکسی پاسخ نهایی رو دوباره به قالبی که همون محیط ایجنت انتظار داره تبدیل میکنه و تحویلش میده.
بهروزرسانیهای گرادیان خطمشی (Policy-Gradient) به تکتک توکنهای دقیق تولیدشده در طول مسیر و احتمالات دقیق ثبتشده برای هر کدوم نیاز دارن. اگر فقط متن پاسخ رو ذخیره کنیم و بعداً دوباره توکنایزش کنیم، ممکنه برای همون متن یکسان، شناسههای توکن متفاوتی تولید بشه! علاوه بر این، محیطهای مختلف ممکنه نشانگرهای نقش (Role markers) اضافه کنن، فاصلهها رو دستکاری کنن یا JSON ناقص رو اصلاح کنن؛ اتفاقاتی که باعث میشه متن ضبطشده با نمونه اولیه مدل فاصله بگیره.
همچنین اجراهای پیچیده و نامنظم ایجنتها نیازمند بازسازی ساختار هستن؛ چون مواردی مثل تلاشهای مجدد، سابایجنتها و فشردهسازی متن بستر میتونن انشعابهای درختی بسازن. این پروکسی هر فراخوانی مدل رو مثل یک نود ذخیره میکنه و سپس اون رو به فراخوانی قبلی متصل میکنه؛ همون فراخوانیای که پرامپت و خروجیاش طولانیترین پیشوند توکن مشترک با پرامپت جدید رو شکل داده باشن. ادامه مسیرهای عادی یک شاخه رو گسترش میدن، تلاشهای مجدد تبدیل به گرههای همسطح (Siblings) میشن و درخواستهای با پیشوند نامرتبط هم ریشههای جدیدی رو رقم میزنن. در نهایت، هر مسیر از ریشه تا برگ، به یک توالی آموزشی ارزشمند تبدیل میشه.
هشت اجرای همزمان؛ خلق یک سیگنال یادگیری دقیق
این آزمایشها با استفاده از مدل LFM2.5-2.6B روی مجموعه دادگان SmolDataEnvs (شامل ۱۰۰۰ تسک تحلیل داده برگرفته از نوتبوکهای کگل) اجرا شد. هر دو فرایند آموزش از الگوریتم Async GRPO استفاده کردن؛ این الگوریتم پیادهسازی ناهمگام بهینهسازی خطمشی نسبی گروهی در کتابخانه TRL هست که برای ۱۰۰۰ گام آموزشی روی دو پردازنده گرافیکی قدرتمند H100 اجرا شد.
نوع اجرا | محیطهای هارنس انتخابی |
|---|---|
فقط OpenCode | تمام اجراها منحصراً در محیط OpenCode انجام شدند. |
چندمحیطی (Multi-harness) | هر گروه از ترکیبی شامل OpenCode، Claude Code، Codex یا Mini-SWE-Agent استفاده کرد. |
هر گروه GRPO شامل هشت تلاش برای انجام یک تسک یکسان بود. پاسخ درست ۱ امتیاز، پاسخ غلط ۰ امتیاز و پاسخ درستی که از ابزارهای کمتری استفاده کرده بود تا سقف ۰.۱ پاداش کارایی (Efficiency Bonus) دریافت میکرد. روش GRPO عملکرد هر اجرا رو با میانگین پاداش همون گروه مقایسه میکنه. اگر هر هشت تلاش به پاسخ درست میرسیدن، پاداش درستی پاسخی واریانسی نداشت؛ بنابراین پاداش مصرف بهینه ابزار نقش سیگنال یادگیری رو بازی میکرد و به نفع مسیرهای موفقتر و کوتاهتر وارد عمل میشد.
آموزش همهجانبه مصرف ابزارها را کاهش میدهد
آموزش همزمان روی چهار محیط باعث بهبود قابلیت انتقال و کارایی مدل شد، در حالی که مدل آموزشدیده روی یک محیط تنها در خانه خودش درخشید!
- دقت چندمحیطی: یادگیری تقویتی چندمحیطی میانگین کلی pass@1 را از ۴۲.۲ درصد به ۵۴.۲ درصد رساند و در هر چهار محیط رشد محسوسی ثبت کرد.
- اوج در محیط خانگی: مدلی که فقط با OpenCode آموزش دید، در محیط OpenCode به رکورد ۵۸ درصد رسید؛ اما مدل چندمحیطی در پلتفرمهای Claude Code و Codex عملکرد بهمراتب برتر و باثباتتری به نمایش گذاشت.
- کارایی ابزارها: در تسکهایی که توسط هر دو نسخه با موفقیت حل شدند، مدل چندمحیطی ۳۱ درصد کمتر از مدل پایه به فراخوانی ابزارها دست زد. این کاهش برای مدل تکمحیطی تنها ۱۱ درصد بود.
- افت در محیطهای غریبه: مدل تکمحیطی OpenCode وقتی در محیط Claude Code قرار گرفت، حتی نسبت به مدل پایه فراخوانی ابزار و توکن بیشتری مصرف کرد و دچار پسرفت شد!
پیروزی مقتدرانه یادگیری تقویتی بر روش تقطیر مسیر
تیم تحقیقاتی روش فاینتیونینگ نظارتشده (SFT) را نیز با استفاده از مسیرهای موفق یک مدل معلم بزرگتر محک زد. آنها مدل توانمند Qwen3.8-27B را در هر چهار محیط اجرا کردند، ۳۱۸۹ اجرای پیروزمندانه را جدا کردند و مدل LFM2.5-2.6B را با این دادهها آموزش دادند.
مقایسه جداگانه نتایج تقطیر دانش (Distillation) نشاندهنده ارقام زیر در شاخص pass@1 بود:
روش آموزش | شاخص Pass@1 |
|---|---|
یادگیری تقویتی چندمحیطی (Multi-harness RL) | ۵۴.۶٪ |
فاینتیونینگ در OpenCode (روش SFT) | ۴۷.۵٪ |
فاینتیونینگ چندمحیطی (Multi-harness SFT) | ۴۳.۱٪ |
جالب اینجاست که در محیط Mini-SWE-Agent، روش فاینتیونینگ چندمحیطی حتی امتیاز مدل پایه رو از ۶۲.۱ درصد به ۴۵.۲ درصد کاهش داد و پیشرفتهای حاصل در سه محیط دیگه رو خنثی کرد! دلیلش اینه که روش SFT فقط روی تقلید شانس توالیهای موفق مدل معلم تمرکز میکنه؛ اما یادگیری تقویتی مستقیماً رفتارهای جدیدی رو از سیاست خودِ مدل دانشآموز تولید میکنه و اونها رو بر اساس پاداشهای هر تسک بهبود میده. این یعنی مدل فرصت پیدا میکنه تا از اشتباهات و رفتارهای خودش در هر محیط درس بگیره.
نمونهبرداری کامل و بدون هرس توکنها
این پروکسی با تنظیم top_p روی مقدار 1.0 و غیرفعالسازی هرس top_k، نمونهبرداری رو از کل توزیع احتمالات مدل انجام میده. فرایند هرس کردن (Truncation) توزیع اجراها رو تغییر میده و میتونه فروپاشی آنتروپی (Entropy Collapse) رو در طول یادگیری تقویتی تسریع کنه. علاوه بر این، هرس کردن روی لاگ احتمالات خروجی vLLM هم اثر منفی میذاره و باعث عدم تطابق بین رفتار ثبتشده در طول اجرا و سیاست مورد استفاده در آموزش میشه.
وقتی نسبت نمونهبرداری اهمیت (Importance-Sampling Ratio) نزدیک به عدد ۱ باشه، نشون میده که احتمالات زمان اجرا با احتمالات آموزش کاملاً همراستا هستن. جالب اینجاست که تغییر top_p به 1.0 باعث شد این نسبت از محدوده ۰.۹۸۵ تا ۰.۹۹۳ به عدد چشمگیر ۰.۹۹۸۴ تا ۰.۹۹۹۹ ارتقا پیدا کنه.
فلگهای ضروری برای اجرای vLLM
vllm serve <model> --return-tokens-as-token-ids --logprobs-mode processed_logprobsابزارهایی که توسعهدهندگان میتوانند همین حالا اجرا کنند
توسعهدهندگان مدلهای پیشرو هماکنون آموزش روی چندین محیط هارنس مختلف رو در دستور کار دارن؛ برای نمونه، مدل Kimi K3 محیطهای Claude Code و Codex رو از ماژولهای ترکیبی میسازه. همچنین مدل Qwen3-Coder-Next دادههای ایجنتی رو در شش محیط مختلف تولید میکنه و پروژه Poolside هم از مسیرهای اجرایی OpenHands، OpenCode و Mini-SWE-Agent بهره میبره.
پروژه Harbor 0.22.0 آداپتورهایی برای بیش از ۴۰ محیط ایجنت فراهم کرده و پروژه OpenEnv نیز ده محیط مختلف رو بهصورت سرتاسری اعتبارسنجی کرده است. این سطح از پوشش فوقالعاده حیاتیه؛ چرا که مدلها پس از استقرار در دنیای واقعی با رابطها، الگوهای ابزار و حلقههای کنترلی مواجه میشن که شاید در زمان آموزش اولیه هیچ اثری ازشون نبوده است.
بخشهای منتشرشده | کاربرد |
|---|---|
ثبت درخواستها، توکنهای نمونهبرداریشده، لاگ احتمالات و ساختار مسیرهای اجرایی. | |
تعریف محیطها و اجرای فرایندهای آموزش چندمحیطی. | |
اتصال اجراهای ناهمگام به فرایند آموزش الگوریتم GRPO. | |
مجموعه SmolDataEnvs | ارائه ۱۰۰۰ وظیفه تکرارپذیر در حوزه تحلیل دادهها. |
دادههای SFT و چکپوینتها | ارائه مسیرهای اجرای مدل معلم و انتشار تمام هفت نسخه آموزشدیده. |
تیمهای هوش مصنوعی میتونن بهراحتی اندپوینت مدل هر محیط هارنس رو به این پروکسی هدایت کنن، قالب بومی درخواست و پاسخ اون رو دستنخورده نگه دارن و وزنهای مدل رو دقیقاً در برابر همون حلقههای ابزاری آموزش بدن که قرار است در دنیای واقعی به کار بروند. این استک منتشرشده بدون نیاز به ساخت یا نگهداری فورکهای سفارشی و اختصاصی، امکان آموزش یادگیری تقویتی رو برای Claude Code، Codex، OpenCode و سایر محیطهای محبوب فراهم میکنه.
مطالب مرتبط و پیشنهادی
درخشش دیجی هوش مصنوعی در رادیوی لسآنجلس؛ مجریان واقعی حسابی شاکی شدند!
دیجی هوش مصنوعی جدیدی به نام «کویوتک» حسابی در رادیوی لسآنجلس گل کرده و با جذب مخاطبان، حالا پایش به چندین شهر دیگر هم باز شده است. اما در شرایطی که صنعت رادیو با موج شدید تعدیل نیرو دستوپنجه نرم میکند، درخشش این گوینده مجازی صدای اعتراض مجریان واقعی و اتحادیههای صنفی را بلند کرده است.
شگفتی در عصر هوش مصنوعی؛ چرا حتی قدرتمندترین مدلها هم جای حس ناب انسانی را نمیگیرند؟
این روزها پیشرفتهای خیرهکننده هوش مصنوعی مدام هوش از سرمان میبرد، اما نباید یادمان برود که اصیلترین حس شگفتی از دل کارهای انسانی متولد میشود. پژوهشهای علمی نشان میدهد آنچه بیش از هر شاهکار ماشینی انسانها را به وجد میآورد، شجاعت، مهربانی و ازخودگذشتگی همنوعان ماست، نه فقط قدرت الگوریتمها.
از عکس یخچال تا سفارش غذا؛ ایجنت هوش مصنوعی دوردش به آیمسیج اپل آمد!
دوردش در حال آزمایش یک ایجنت هوش مصنوعی اختصاصی در آیمسیج اپل است که فرآیند سفارش غذا را به سادگی ارسال یک پیامک میکند. این ایجنت هوشمند حتی میتواند با تحلیل عکس یخچال شما، ایده آشپزی پیشنهاد دهد و مواد لازم کسری را خودکار به سبد خرید اضافه کند؛ هرچند نسخه بتای آن فعلاً با خطاهایی مثل قیمتهای اشتباه دستوپنجه نرم میکند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.