ایجنتهای هوش مصنوعی روی سیستم شما چقدر سریع اجرا میشن؟ بنچمارک جذاب RTX 5090، مکبوک و رقبا
با انتشار ابزار متنباز AgentPerf-Local، حالا میتوانید سرعت اجرای ایجنتهای هوش مصنوعی را روی لپتاپ و سیستم شخصی خود به چالش بکشید. اولین بنچمارکها روی غولهایی مثل RTX 5090، مکبوک پرو M5 Pro و تراشههای هوش مصنوعی نشان میدهد پهنای باند حافظه و بهینهسازی نرمافزاری چقدر در زنده نگهداشتن سرعت ایجنتها حیاتی است.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- ابزار متنباز AgentPerf-Local منتشر شد تا کاربران بتونن سرعت واقعی اجرای ایجنتهای هوش مصنوعی رو مستقیماً روی لپتاپ و ورکاستیشن شخصی خودشون تست کنن.
- کارت گرافیک غولپیکر RTX 5090 به لطف پهنای باند حافظه ۱۷۹۲ گیگابایتی، مدلهایی که تو حافظهش جا شدن رو بیش از ۳.۵ برابر سریعتر از رقبا اجرا کرد.
- مکبوک پرو M5 Pro ارزونترین گزینه این تست بود و رقابت پایاپایی نشون داد، اما سیستم DGX Spark انویدیا به خاطر برتری در پردازش ورودی و بلوغ درایورهای CUDA، در اکثر مدلها سریعتر از تراشه Ryzen AI عمل کرد.
معرفی AgentPerf-Local؛ ابزار متنباز تست عملکرد اینفرنس مدلهای محلی هوش مصنوعی – بررسی کنید ایجنتهای هوش مصنوعی با چه سرعتی روی لپتاپ یا ورکاستیشن شما اجرا میشوند و با ارزیابی کانفیگهای گوناگون، سیستم ایدهآل خود را برای اجرای محلی ایجنتها آماده کنید.
نکات کلیدی:
➤ ابزار متنباز AgentPerf-Local با بازپخش تعاملات واقعی ایجنتها روی سختافزارهای دسکتاپ و لپتاپ، عملکرد واقعی اینفرنس را اندازهگیری میکند.
➤ نتایج اولیه برای سیستمهای NVIDIA DGX Spark، کارت گرافیک NVIDIA GeForce RTX 5090، پلتفرم AMD Ryzen AI Halo و لپتاپ مکبوک پرو M5 Pro منتشر شده است.
➤ این ابزار و جدول ردهبندی آن بهمرور برای پوشش سختافزارها، فریمورکها و مدلهای بیشتر توسعه خواهد یافت و با عرضههای جدید آپدیت میشود.
پس از بررسی عملکرد اینفرنس روی گوشیهای هوشمند و سرورهای دیتاسنتری، اکنون پوشش تستها به لپتاپها و ورکاستیشنها گسترش یافته است. در کنار جدول ردهبندی نتایج ترکیب سختافزارها و مدلهای پرطرفدار، تمامی کدها و دادههای لازم برای اجرای AgentPerf-Local بهصورت متنباز در دسترس قرار گرفته تا تیمها و توسعهدهندگان بتوانند سیستمهای خود را ارزیابی کرده و بهترین تصمیم را برای راهاندازی هوش مصنوعی محلی بگیرند.
ابزار AgentPerf-Local جلسات واقعی تعامل ایجنتها را مجدداً اجرا میکند. سناریوی آزمایشی پیشفرض شامل ۸ تسک ضبطشده از ایجنتهاست که در ۱۶۸ نوبت رفتوبرگشت مدل انجام میشوند. درست مانند یک ایجنت در دنیای واقعی، هر درخواست شامل کل تاریخچه گفتوگو تا آن لحظه است؛ در نتیجه طول کانتکست تا حدود ۵۶ هزار توکن افزایش مییابد. در هر نوبت، سیستم دقیقاً همان تعداد توکن ثبتشده را تولید میکند تا بار پردازشی تمامی سیستمها کاملاً یکسان باشد. اجرای ابزارها (Tools) بهطور پیشفرض نادیده گرفته میشود تا سرعت خالص پردازش هوش مصنوعی تفکیک شود؛ با این حال، کاربران میتوانند تأخیرهای واقعی ثبتشده ابزارها را بازپخش کنند یا فراخوانی ابزارها را بهصورت زنده روی پردازنده اصلی (CPU) به اجرا درآورند.
در فاز نخست، تمرکز بر عملکردی است که یک تکایجنت میتواند با استفاده از تمام توان سیستم به دست آورد. در ادامه این سناریوها برای سیستمهای چندایجنت و شرایطی که ایجنت در کنار سایر برنامههای روزمره اجرا میشود نیز گسترش خواهد یافت.
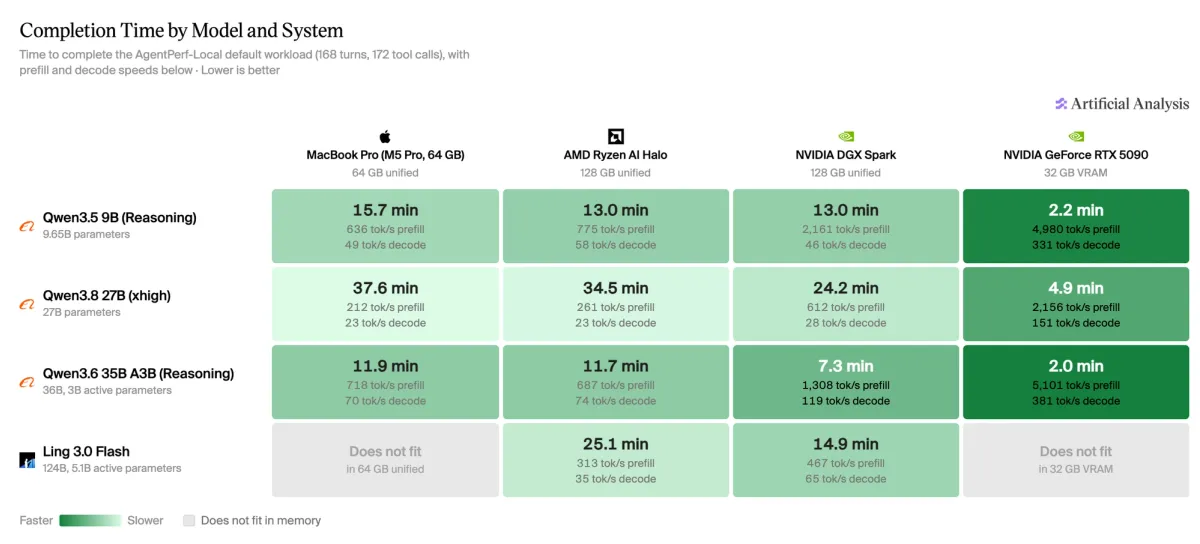
سختافزارهای اولیه آزمایششده عبارتند از: سیستم NVIDIA DGX Spark با ۱۲۸ گیگابایت حافظه، پلتفرم AMD Ryzen AI Halo با ۱۲۸ گیگابایت حافظه، مکبوک پرو M5 Pro با ۶۴ گیگابایت حافظه، و کارت گرافیک NVIDIA GeForce RTX 5090 با ۳۲ گیگابایت VRAM. این سختافزارها برای پوشش تنوعی از پلتفرمها (CUDA، ROCm، Vulkan و Metal)، ظرفیتهای رم و پهنای باندهای مختلف انتخاب شدهاند. در آینده لپتاپهای بیشتری بر پایه x86 و پردازندههای گرافیکی ورکاستیشن نظیر RTX PRO 6000 بلکول اضافه میشوند تا مقایسه دقیقتری از انواع سختافزارها ارائه شود.
مدلهای اولیه بررسیشده شامل Qwen3.5-9B، مدل متراکم Qwen3.8-27B، مدل Qwen3.6-35B-A3B و Ling 3.0 Flash (با ۱۲۴ میلیارد پارامتر کل و ۵ میلیارد پارامتر فعال) هستند. این مدلها نیازمندیهای حافظهای متنوع و معماریهای Dense و MoE را پوشش میدهند و برای شبیهسازی شرایط واقعی در کوانتیزاسیون ۴ بیتی بنچمارک شدهاند. علاوه بر این، این ابزار امکان تست عملکرد هر سرور اینفرنس سازگار با OpenAI را دارد، به این معنی که کاربران میتوانند هر مدل و کانفیگی را بهراحتی بهصورت محلی بسنجند.
انتخاب کانفیگ اجرای مدل نقش سرنوشتسازی در نتایج دارد؛ چرا که رانتایم، نوع کوانتیزاسیون و روش دیکدینگ حدسی (Speculative Decoding) خروجی را دگرگون میکنند. در تمامی ۱۴ کانفیگ رسمی بررسیشده از روشهای دیکدینگ حدسی (مانند MTP، DFlash یا DSpark) استفاده شده است.
نتایج اولیه آزمایشها:
➤ زمان تکمیل فرایند بیش از هر چیز به تعداد پارامترهای فعال مدل بستگی دارد: مدل Qwen3.6-35B-A3B (با ۳ میلیارد پارامتر فعال) سریعترین مدل در تمامی سیستمها بود و بین ۲.۵ تا ۳.۳ برابر سریعتر از مدل متراکم Qwen3.8-27B عمل کرد. با این وجود، پارامترهای فعال تمام ماجرا نیستند؛ چرا که مدل Ling 3.0 Flash با ۵ میلیارد پارامتر فعال همچنان در تمام سختافزارها کندتر از مدل ۹ میلیارد پارامتری Qwen3.5 ظاهر شد.
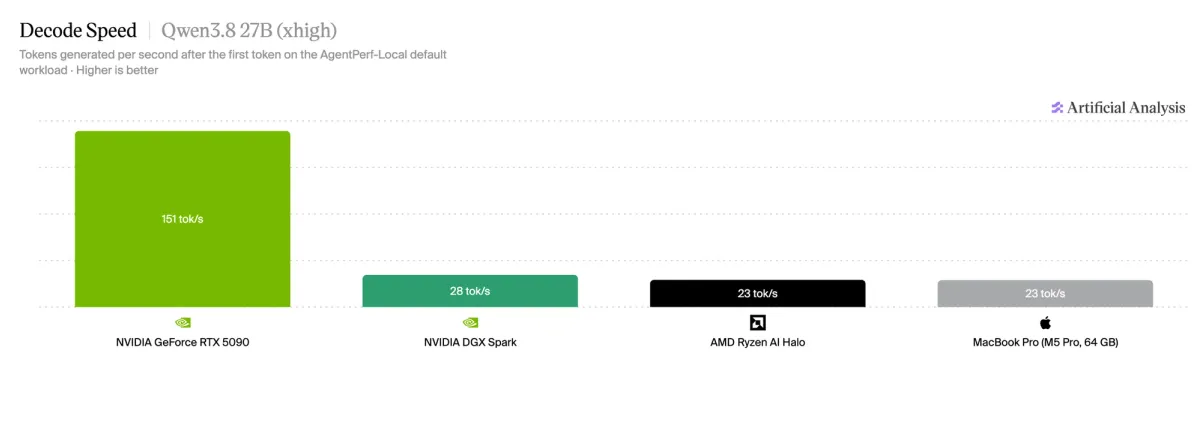
➤ کارت گرافیک GeForce RTX 5090 سریعترین سیستم برای مدلهایی بود که در حافظه ۳۲ گیگابایتی آن جا شدند: این کارت گرافیک زمان اتصالی بیش از ۳.۵ برابر سریعتر از رقبا را به ثبت رساند. سرعت دیکود تککاربره وابستگی بالایی به پهنای باند حافظه دارد و RTX 5090 با پهنای باند فوقالعاده ۱۷۹۲ گیگابایت بر ثانیه، فرسنگها جلوتر از سیستمهای حافظه یکپارچه (با پهنای باند ۲۵۶ تا ۳۰۷ گیگابایت بر ثانیه) قرار گرفته است.
➤ دو سیستم DGX Spark و Ryzen AI Halo در مجموع پلتفرمهای مشابهای هستند: هر دو دارای ظرفیت یکسان حافظه یکپارچه، پهنای باند نزدیک و قیمت اولیه ۴۰۰۰ دلاری هستند. با این وجود، سیستم DGX Spark در ۳ مدل از ۴ مدل تستشده، ۱.۴ تا ۱.۷ برابر سریعتر ظاهر شد. این اختلاف فراتر از تفاوت ۷ درصدی پهنای باند آنهاست؛ سیستم انویدیا از توان محاسباتی بهتری در دقت پایین برخوردار است که فاز پردازش ورودی (Prefill) را سرعت میبخشد و بلوغ بیشتر نرمافزار CUDA نیز عملکرد بهتری در معماری MoE و دیکدینگ حدسی فراهم کرده است.
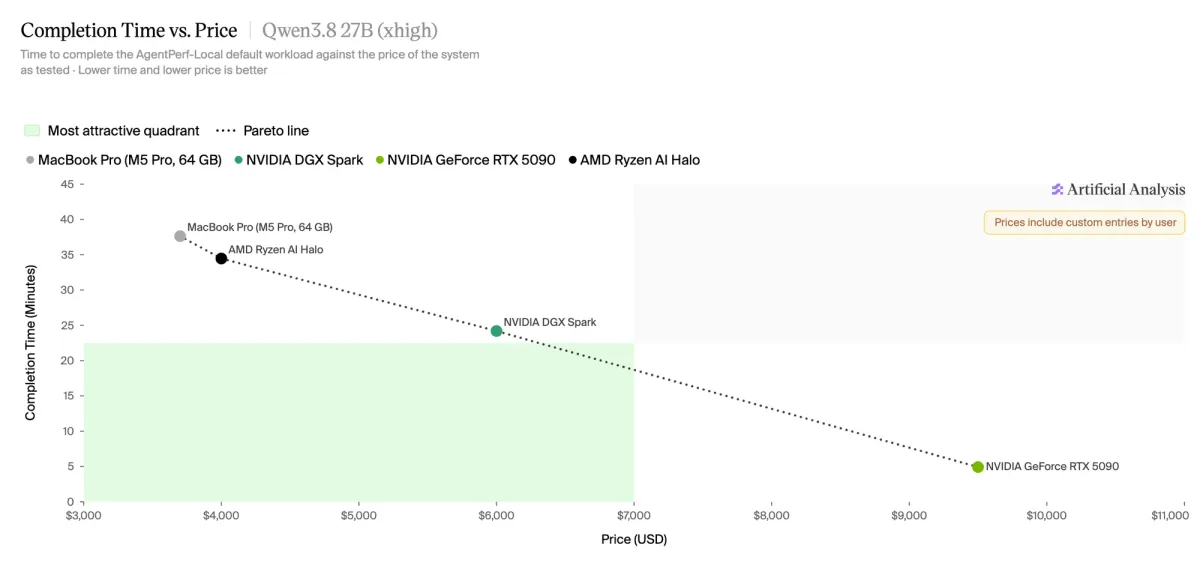
➤ مکبوک پرو (M5 Pro با ۶۴ گیگابایت رم و ۲۰ هسته گرافیکی) تنها لپتاپ تستشده تا این مرحله بود: این لپتاپ نتایج بسیار رقابتی ثبت کرد و اختلافی بین ۲ تا ۹ درصد با سیستم Ryzen AI Halo در دو مدل کوئن بر جای گذاشت. مکبوک پرو با بالاترین پهنای باند بین سیستمهای حافظه یکپارچه (۳۰۷ گیگابایت بر ثانیه) و قیمت ۳۷۰۰ دلاری، ارزانترین دستگاه تستشده است؛ هرچند بلوغ نرمافزاری و توان خام پردازشی برای فاز Prefill از عوامل محدودکننده آن به شمار میروند.
➤ با وجود اینکه ۷۳ تا ۹۳ درصد توکنهای پرامپت از کَش KV فراخوانی شدند: صرف خواندن ورودیهای جدید در هر مرحله (فاز Prefill) بخش چشمگیری از زمان کل (۲۲ تا ۴۱ درصد در مدل Qwen3.8-27B) را مصرف کرد. این موضوع بهویژه بر سیستمهایی که نسبت توان محاسباتی به پهنای باند کمتری دارند اثر گذاشته است.
➤ تکنیک دیکدینگ حدسی در تمامی کانفیگهای برتر پیادهسازی شد: این راهکار توانست سرعت تولید توکن را در مدل Qwen3.8-27B بین ۳۰ تا ۱۲۰ درصد فراتر از سقف توان پهنای باند افزایش دهد.
قیمت بازار آزاد اغلب سختافزارها نسبت به قیمت مصوب اولیه افزایش داشته است. با در نظر گرفتن نرخهای فعلی بازار، با کاهش زمان تکمیل کار، قیمت سیستمها صعودی میشود؛ مکبوک پرو M5 Pro ارزانترین گزینه و سیستم مجهز به کارت GeForce RTX 5090 با اختلاف گرانترین سیستم است.
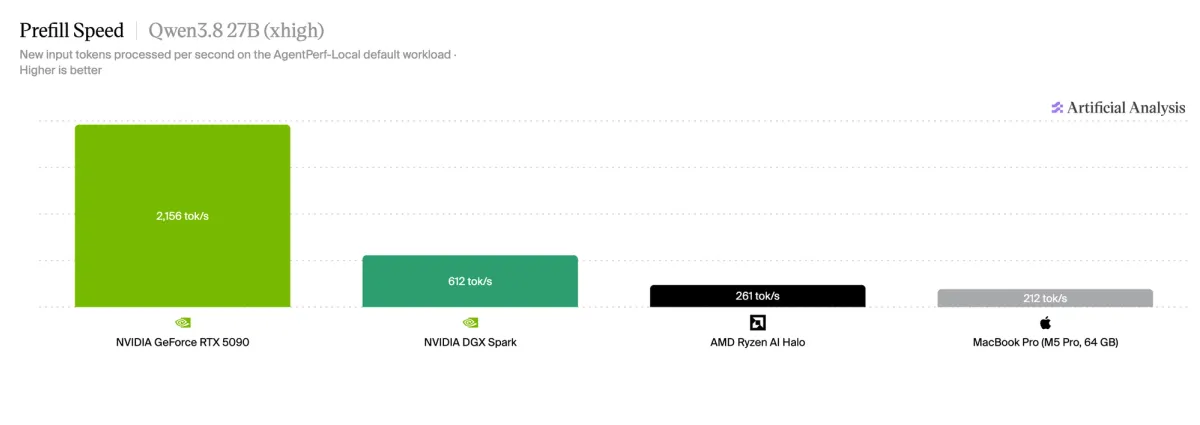
سرعت تولید توکن (Decode) در مدل Qwen3.8-27B روی هر سه دستگاه مجهز به حافظه یکپارچه بهدلیل پهنای باند مشابه (۲۵۶ تا ۳۰۷ گیگابایت بر ثانیه) تقریباً یکسان بود. اما کارت RTX 5090 به یمن پهنای باند ۱۷۹۲ گیگابایت بر ثانیهای خود، بیش از ۵ برابر سرعت دیکود بالاتری ثبت کرد.
سرعت پردازش اولیه ورودیها (Prefill) نیز الگویی مشابه فاز تولید نشان داد، اما توان پردازشی بالای DGX Spark خود را در خواندن سریعتر کانتکست نمایان کرد. در تعاملات ایجنتی، حتی با وجود کَش شدن ۹۳ درصد ورودیها، هر نشست همچنان حاوی حدود ۱۹۶ هزار توکن ورودی جدید است. هنگام بازگرداندن یک فایل حجیم توسط ابزار، ایجنت ممکن است روی سیستم Halo تا ۲۴ ثانیه و روی مکبوک تا ۳۹ ثانیه معطل شود، در حالی که کارت RTX 5090 این کار را در حدود ۲ ثانیه انجام میدهد.
این بنچمارک بهطور مداوم با ورود قطعات و ابزارهای جدید بهروزرسانی میشود و پشتیبانی از سناریوهای چندایجنت و فریمورکهای جدید اینفرنس در برنامههای آتی آن قرار دارد.
برای دسترسی به سورسکد و اجرای این بنچمارک روی سیستم خود میتوانید به مخزن متنباز پروژه مراجعه کنید.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
حواشی نامگذاری ایجنت جدید اوپنایآی؛ دردسرهای بیپایان «Dots» و موجسواری ایلان ماسک!
اوپنایآی از سیستم ایجنت جدید خود به نام «Dots» رونمایی کرده، اما این نامگذاری حسابی در فضای مجازی جنجال به پا کرده است. از تشابه اسمی با چند شرکت چینی و هجوم کاربران به پیج اینستاگرام یک برند لباس زنانه گرفته تا ترول زیرکانه شرکت هوش مصنوعی ایلان ماسک با دامنه Dot.com، همهچیز دست به دست هم داده تا این رونمایی حسابی سوژه شبکههای اجتماعی شود.
کتوشلوار سازمانی بر تن OpenClaw؛ ائتلاف اوپنایآی و رد هت برای نجات ایجنتها از تحریم اداری!
پروژه پرطرفدار OpenClaw با همراهی رد هت، انویدیا و اوپنایآی، در حال ساخت نسخهای سازمانی موسوم به OCE است تا نگرانیهای امنیتی شدید شرکتها را رفع کند. این پروژه که لقب «کوبرنتیز برای ایجنتها» را به همراه دارد، به دنبال استانداردسازی و کنترل همهجانبه روی دستیاران هوشمند سازمانی است.
از بیل مکانیکی تا پلتفرم هوشمند؛ بابکت چطور با هوش مصنوعی ماشینهای سنگین را متحول میکند؟
روی گرکو، مدیر ارشد دیجیتال شرکت بابکت، از استراتژی این برند پرآوازه ماشینآلات سنگین برای پیوند زدن لودرها و بیلهای مکانیکی با هوش مصنوعی و نرمافزار پرده برداشته است؛ تحولی که ابزارهای سخت کارگاهی را به پلتفرمهای متصل و دستیارهای هوشمند ارتقا میدهد.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.