شکاف امنیتی جنجالی در پروتکل MCP؛ وقتی ایجنتهای هوش مصنوعی چشمبسته به هم اعتماد میکنند!
پروتکل محبوب MCP که برای برقراری ارتباط میان ایجنتهای هوش مصنوعی طراحی شده، با چالش امنیتی جدی مواجه شده است. کارشناسان دریافتهاند شکافهای اعتمادسازی در این پروتکل باعث میشود دستورات مخرب و تزریق پرامپت مثل دومینو میان ایجنتهای داخلی دستبهدست شود و حتی سرورهای غولهایی مانند گوگل را به خطر بیندازد.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- پژوهشگران امنیتی متوجه شدهاند هکرها میتوانند با سوءاستفاده از پروتکل ارتباطی MCP، دستورات مخرب و تزریق پرامپت را از یک ایجنت به ایجنتهای دیگر شبکه منتقل کنند.
- این تکنیک نفوذ که «چرخش بین پروتکلی» نام گرفته، در شبکههای سازمانهای بزرگی از جمله گوگل و رپید۷ شناسایی شده و راه را برای حملات خطرناکی مثل جعل درخواست سمت سرور (SSRF) باز میکند.
- کارشناسان هشدار میدهند تبوتاب ساخت سیستمهای چندایجنت باعث نادیده گرفتن اصل بنیادین «اعتماد صفر» (Zero Trust) شده و ابزارها نباید کورکورانه به خروجی مدلها اعتماد کنند.
فراگیر شدن ایجنتهای هوش مصنوعی در میلیونها شرکت و سازمان، در کنار تمام جذابیتها و امکانات فوقالعادهاش، درِ پشتی تازهای هم برای مهاجمان باز کرده است. نفوذگران حالا میتوانند با فریب دادن این ایجنتها، دست به خرابکاری بزنند؛ از بیرون کشیدن محتوای دیتابیسها گرفته تا سرقت اطلاعات حساس کاری و دادههای شخصی کاربران.
طی پنج ماه گذشته، گوگل و چهار سازمان بزرگ دیگر که شاید تنها وجه اشتراکشان استفاده از ایجنتهای هوش مصنوعی بوده، به وجود آسیبپذیریهای خطرناکی اعتراف کردهاند. در این تکنیک، مهاجم با نفوذ به یک ایجنت داخلی، دستورات مخرب خود را به سایر ایجنتهای شبکه تزریق میکند. این سناریو در واقع شکل خاصی از «تزریق پرامپت» (Prompt Injection) است که این بار به جای خودِ مدل زبانی بزرگ (LLM)، مستقیماً یک ایجنت خاص مثل ایجنت ترجمه یا تحلیل داده را هدف میگیرد. گاردریلها و فیلترهای امنیتی این ایجنتها اگر اصلاً وجود داشته باشند، معمولاً بسیار آسانگیر هستند و دستورات دریافتی را بدون بررسی دقیق به ایجنت بعدی در زنجیره میفرستند. از آنجا که ایجنت بعدی هم چشمبسته به ایجنت قبلی اعتماد دارد، دستورات خطرناک را موبهمو اجرا میکند!
حملهای غافلگیرکننده که مهارش اصلاً ساده نیست
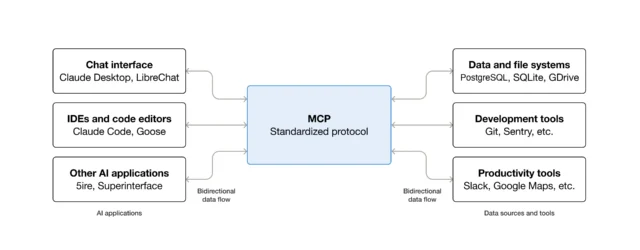
یک پژوهشگر مستقل امنیت به نام سید انس محیالدین (Syed Anas Mohiuddin)، ایجنتهای سازمانهای مختلفی از جمله گوگل، جیپی مورگان چیس (JP Morgan Chase)، ویویت (Weaviate)، رپید۷ (Rapid7)، اداره کل دیجیتال دولت فرانسه و دولت فدرال آمریکا را زیر ذرهبین قرار داده و تست کرده است. حملات اثبات مفهوم (PoC) او نشان میدهد که در پروتکل MCP، که کوتاهشدهی پروتکل کانتکست مدل (Model Context Protocol) است، شکافهای اعتمادسازی بزرگی وجود دارد. این استاندارد یکی از ابزارهای اصلی ارتباط برنامهها و ایجنتهای هوش مصنوعی درون شبکههای داخلی به شمار میرود. تصویر زیر عملکرد سادهشده MCP را در عمل نشان میدهد.
بسیاری از ایجنتهای تکمنظوره و تخصصی فاقد گاردریلهای قدرتمندی هستند که بتوانند پیامدهای مخرب تزریق پرامپت را خنثی کنند. علاوه بر این، از آنجا که سرورهای MCP اطلاعات هویتی هر ایجنت را نگهداری میکنند و خود ایجنتها هم طوری طراحی شدهاند که به بقیه اعضای داخلی شبکه اعتماد کامل داشته باشند، نفوذی که معمولاً خودِ مدل زبانی جلوی آن را میگیرد، در کمال شگفتی با موفقیت انجام میشود! در بسیاری از مواقع، پرامپتهای حسابشدهای که ایجنت مناسب را هدف میگیرند، در نهایت به حمله جعل درخواست سمت سرور یا همان SSRF (Server-Side Request Forgery) ختم میشوند؛ آسیبی که وبسرور را وادار میکند درخواستهای شبکهای غیرمجاز و خطرناک ارسال کند.
داگلاس مککی (Douglas McKee)، مدیر بخش اطلاعات آسیبپذیری در شرکت Rapid7، در رابطه با این تهدید توضیح داد: «ایجنتهای هوش مصنوعی مسیرهای ارتباطی کاملاً جدیدی در اختیار مهاجمان میگذارند تا در شبکه مانور بدهند. کافی است کسی یک متن آلوده را در دل محتوایی بگنجاند؛ یک ایجنت آن را میخواند و مثل یک تسک عادی به ایجنت دیگر واگذار میکند. ایجنت دوم هم چون به فرستنده اعتماد دارد، آن را سریع اجرا میکند. در این زنجیره، هر قطعه دقیقاً همان کاری را انجام داده که برایش ساخته شده بود، و درست به همین دلیل ردگیری و مهار چنین باگی بسیار دشوار است. در واقع هر پروتکل با این فرض ساخته شده که گویی در جزیرهای مستقل زندگی میکند؛ بنابراین هر کدام فقط درِ ورودی خودش را محافظت میکند، در حالی که هیچکس حواسش به راهروهای ارتباطی میان آنها نیست!»
آسیبپذیری کشفشده توسط این محقق در شبکه رپید۷ با شناسه CVE-2026-97228 ثبت شد و نمره شدت خطر آن تنها ۲.۷ از ۱۰ بود. رپید۷ این مسأله را ماه گذشته بهطور کامل برطرف کرد.
اما آسیبپذیری مربوط به گوگل بهمراتب وخیمتر بود و نمره شدت خطر ۸ از ۱۰ را دریافت کرد. ریشه ماجرا به جعبهابزار MCP گوگل برای پایگاههای داده (googleapis/mcp-toolbox) برمیگشت؛ جایی که کلاینت HTTP بدون استفاده از سیاست CheckRedirect پیادهسازی شده بود (تنظیماتی که تعیین میکند سرور در مواجهه با خطا یا ریدایرکت شدن URL به مقصدی دیگر، چطور عمل کند). علاوه بر این، کلاینت HTTP گوگل آدرسهای IP مقصد را هم اعتبارسنجی نمیکرد.
سید در مستندات امنیتی خود توضیح داد: «یک پارامتر دستکاریشده در مسیر URL میتوانست جعبهابزار را وادار کند تا ریدایرکت را به سمت یک اندپوینت داخلی دنبال کرده و از جانب مهاجم درخواست بفرستد.» راهحل ترمیمی گوگل شامل اضافه کردن لیست مجاز (Allow-list) و مسدودسازی محدودههای IP بود: «گوگل حالا به جای موکول کردن بررسی به اولین درخواست، از همان ابتدای راهاندازی، آدرسهای پایه ناامن را ریجکت میکند. یک محافظ واقعی در برابر حملات SSRF باید دقیقاً چنین رویکردی داشته باشد؛ هرچند این کار بسیار سنگینتر از کاری است که اغلب سرورهای MCP تا امروز انجام دادهاند.»
این پژوهشگر این کلاس از حملات را «چرخش بین پروتکلی» (Protocol Pivoting) نامیده است؛ زیرا این نفوذها زمانی عمل میکنند که یک برنامه یا سرور از طریق MCP تسکی را به یک ایجنت میسپارد و سپس آن ایجنت، دستورات مخرب را از طریق روش ارتباطی دیگری به ایجنت بعدی پاس میدهد؛ روشهایی مانند پروتکل اختصاصی ایجنتبهایژنت گوگل (Agent-to-Agent یا A2A) یا استانداردهای نوظهوری مثل پروتکل شبکه ایجنتها (Agent Network Protocol). به گفته او، در این بدهبستان، مفهوم اعتماد و احراز هویت در ترجمه میان پروتکلها محو میشود. او چرخش بین پروتکلی را اینگونه توصیف کرد: «حملهای چندمرحلهای که در آن نفوذگر دسترسی اولیه را از طریق یک پروتکل کسب میکند، از پیشفرضهای اعتماد بین پروتکلها بهرهبرداری کرده و در نهایت دسترسیهای خود را به قابلیتهایی ارتقا میدهد که تنها از طریق پروتکل دیگر میسر است.»
مارکوس ورویر (Markus Vervier)، پژوهشگر شرکت امنیتی X41 D-Sec که او نیز سناریوهای حمله به هوش مصنوعی با بهرهبرداری از MCP را طراحی کرده، معتقد است عنوان دقیقتر برای این پدیده همچنان «تزریق پرامپت» است و تکنیک سید صرفاً زیرمجموعهای از آن به حساب میآید.
او در گفتوگو با تحلیلگران رسانهای یادآور شد: «از نظر من این پدیده یک تزریق غیرمستقیم پرامپت (Indirect Prompt Injection) است. این حقیقت که پرامپت مخرب از پروتکل دیگری مانند A2A سرچشمه بگیرد و روی پروتکل ثانویه پیاده شود، شرط الزامی موفقیت این حملات نیست؛ هرچند این اتفاق کاملاً غافلگیرکننده است و مهار آن به شکل عمومی دشواریهای زیادی دارد.»
نکته چشمگیر این است که تکنیک چرخش بین پروتکلی در پنج سازمان مختلف که هیچ وجه اشتراکی جز استفاده از MCP نداشتند، با موفقیت عمل کرده است. MCP پدیدهای نوظهور است که پیش از تست و ایمنسازی کامل، در سراسر اکوسیستم هوش مصنوعی رواج یافته است. سازمانها در تبوتاب ساخت ساختارهای پیچیده چندایجنت، یکی از اصول طلایی امنیت به نام «اعتماد صفر» (Zero Trust) را کاملاً نادیده گرفتهاند. در این الگو، معماری شبکه باید بر این فرض بنا شود که هر لحظه ممکن است یک یا چند نود آلوده باشند؛ بنابراین مهندسان باید سیستمها را به گونهای طراحی کنند که پیش از انجام هر تبادل حساس، از طرف مقابل احراز هویت و تأییدیه بخواهند.
مککی در جمعبندی این موضوع خاطرنشان کرد: «مهمترین درسی که باید از این تجربه گرفت این است که هر دادهای که از مدل زبانی به ابزار شما فرستاده میشود، باید مثل ورودی یک فرد ناشناس در اینترنت قلمداد شود؛ زیرا در سناریوی تزریق پرامپت، ماجرا دقیقاً همین است! باگهای ریشهای این معضل، دوستان قدیمی دنیای امنیت مثل Injection و SSRF هستند که راهحلهای مهارشان در ۲۰ سال گذشته تغییر نکرده است. باید به این محقق آفرین گفت که نامی مشخص برای این متد انتخاب کرد؛ چرا که تنها وقتی یک آسیبپذیری نام و هویت رسمی پیدا میکند، کارشناسان دفاعی و نهادهای استاندارد برای مهار آن دستبهکار میشوند.»
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
پشت پرده سوءاستفاده کارمندان از هوش مصنوعی؛ از تب توکنمکثینگ تا پرونده سیبهای گندیده!
سوءاستفاده کارمندان از هوش مصنوعی در محیطهای کاری به کابوسی تازه برای مدیران تبدیل شده است؛ از تولید فلهای گزارشهای بیارزش و پدیده توکنمکثینگ گرفته تا جعل قراردادها با مدلهای مولد. ریشه این رفتارهای مخرب سازمانی در سه عامل خلاصه میشود: افراد خطاکار، شرایط کاری پرفشار و فرهنگ ناسالم شرکتی که مهار آنها در گرو پیادهسازی حاکمیت هوش مصنوعی است.
مدل قدرتمند GLM-5.3 به آمازون بدراک آمد؛ هیولای ۱ میلیون توکنی Z.ai برای کدنویسی و ایجنتها
آمازون وب سرویسز (AWS) رسماً مدل پرچمدار GLM-5.3 توسعهیافته توسط شرکت Z.ai را به پلتفرم ابری بدراک اضافه کرد. این مدل وزنباز با پشتیبانی از پنجره زمینه خارقالعاده ۱ میلیون توکنی و بهینهسازی ویژه برای وظایف مهندسی نرمافزار، انتخابی ایدهآل برای توسعه ایجنتهای خودکار و ریفکتور کدهای حجیم به شمار میرود.
میلیارد دلار، پول خرد تازه سیلیکونولی؛ پشت پرده ارزشگذاریهای نجومی استارتاپهای هوش مصنوعی
در سیلیکونولی ارزشگذاریهای میلیاردی برای استارتاپهای هوش مصنوعی به یک اتفاق عادی و روزمره تبدیل شده است؛ گویی یک میلیارد دلار حکم پول خرد جدید را دارد. اما آیا این ارقام نجومی که خیلی وقتها پیش از عرضه اولین محصول ثبت میشوند، پشتوانه واقعی دارند یا صرفاً قماری بزرگ روی آینده هستند؟
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.