چرا تزریق توان پردازشی بیشتر به ایجنتها کافی نیست؟ راهکار هوشمندانه متا برای نجات هوش مصنوعی از هدررفت منابع
دادن توان پردازشی و محاسبات بیشتر به ایجنتهای هوش مصنوعی همیشه هم نتیجه بهتری به همراه ندارد و گاهی فقط باعث سوزاندن بیهوده توکنها میشود. پژوهشگران آزمایشگاه هوش فوقبشری متا چارچوب تازهای به نام «فراتدبیر ایجنتی» توسعه دادهاند که مثل یک مدیر هوشمند، به ایجنتها یاد میدهد بودجه پردازشی خود را چطور و کجا خرج کنند تا به بنبست نخورند.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- مشکل هدررفت محاسبات در ایجنتها: ایجنتهای هوش مصنوعی در کارهای طولانی و پیچیده اغلب دچار سردرگمی میشوند؛ یا منابع پردازشی باارزش را پای راهحلهای اشتباه هدر میدهند، یا پیش از حل کامل مسئله متوقف میشوند و تزریق پردازش بیشتر هم لزوماً این مشکل را حل نمیکند.
- معماری فراتدبیر ایجنتی متا: پژوهشگران آزمایشگاه هوش فوقبشری متا چارچوبی به نام فراتدبیر ایجنتی (Agentic Meta-Reasoning) ابداع کردهاند که کار را بین «کنترلر» (مغز هدایتکننده) و «ورکرها» تقسیم میکند و جهش چشمگیری در بنچمارکهای سختی مانند ProgramBench با مدل GPT-5.5 ثبت کرده است.
- مدیریت هوشمند بودجه پردازشی با گراف محاسباتی: در این سیستم، کنترلر نتایج را در قالب یک گراف آرتیفکت ذخیره میکند تا ایجنت بتواند به جای آزمونوخطای کورکورانه، روی دستاوردهای موفق قبلی بنا کند و بودجه پردازشی را هدفمند خرج نماید.
ایجنتهای هوش مصنوعی معمولاً در ارزیابی پیشرفت کار خودشان و تصمیمگیری درباره گام بعدی حسابی به دردسر میافتند. آنها ممکن است منابع محاسباتی و پردازشی باارزش را پای مسیرهای اشتباه و شکستخورده بسوزانند، سرنخها و نتایج امیدوارکننده را نادیده بگیرند، یا حتی قبل از اتمام کامل کار دست از تلاش بکشند. هرچه پروژهها و جریانهای کاری طولانیتر و پیچیدهتر میشوند، تاوان این اشتباهات سنگینتر و هزینههای پردازش نجومیتر میشود.
حالا پژوهشگران «آزمایشگاه هوش فوقبشری متا» (Meta Superintelligence Labs) چارچوب تازهای به نام فراتدبیر ایجنتی (agentic meta-reasoning) خلق کردهاند که دقیقاً همین چالش را هدف میگیرد. این چارچوب یک جریان استدلال اختصاصی برای ایجنت میسازد تا درباره «گام بعدی» تصمیمگیری کند؛ به این ترتیب ایجنت میتواند میزان پیشرفت خود را بسنجد، راههای جایگزین را محک بزند و منابع پردازشی را دقیقاً به سمت ثمربخشترین گزینهها هدایت کند.
در بنچمارک ProgramBench (که روی بازسازی و مهندسی نرمافزار تمرکز دارد)، این چارچوب نوآورانه به همراه مدل GPT-5.5 موفق شد میانگین قبولی ۷۱.۵ درصدی در تستهای پنهان ثبت کند؛ این در حالی است که در ارزیابی پژوهشگران، مدلی مانند Codex به امتیازی فراتر از ۵۸.۰ درصد نرسید.
برخلاف هارنسهای خودبهبودبخش (Self-improving harnesses) که ساختار نرمافزاری و تنظیمات ایجنت را در دفعات مختلف اجرا بهینهسازی میکنند، فراتدبیر ایجنتی شیوه هدایت کار توسط ایجنت را در طول همان «یک دور اجرا» ارتقا میدهد. این دستاورد به توسعهدهندگان سازمانی یک راهکار عملی تازه میدهد: بهبود چشمگیر عملکرد ایجنتها بدون اینکه نیازی به دستکاری یا فاینتیون مدلهای پایه باشد.
چالش بزرگ هدایت و مدیریت کار ایجنتها
فرض کنید یک ایجنت کدنویسی مأمور پیادهسازی یک ماژول نرمافزاری شده است. ایجنت کدهای اصلی را نوشته و چند تست اولیه را هم با موفقیت پاس کرده، اما چند حالت خاص (Edge Case) هنوز لنگ میزنند. حالا ایجنت باید چه تصمیمی بگیرد؟ خطاهای تست را ریشهیابی کند؟ بخشی از کد را از اول بنویسد؟ تستهای تازهای اجرا کند؟ یک ایده کاملاً جدید را امتحان کند یا اصلاً کار را تمامشده بداند و متوقف شود؟ هرکدام از این انتخابها منابع پردازشی مصرف میکنند و یک تصمیم اشتباه میتواند کل بودجه محاسباتی باقیمانده را هدر بدهد یا حتی کدهای سالمی را که از قبل کار میکردند خراب کند.
پژوهشگران متا این چالش حساس را کنترل فراشناختی (Metacognitive Control) مینامند؛ مفهومی که آن را «ارزیابی پیشرفت خود و بهکارگیری این ارزیابی برای تصمیمگیری درباره گام بعدی» توصیف میکنند.
کنترل فراشناختی برای یک ایجنت هوش مصنوعی یعنی بداند به کدام نتایج میانی اعتماد کند، کار را روی کدام دستاوردهای قبلی سوار کند و چه زمانی توان پردازشی بیشتری به یک بخش اختصاص دهد. یک انتخاب نادرست در اینجا مساوی است با سوزاندن بیحاصل پردازش روی یک مسیر بنبست، یا رها کردن یک راهحل کاملاً درست که ایجنت پیشتر کشف کرده بود اما متوجه ارزشش نشده است!
ایجنتهای فعلی معمولاً تصمیمگیری درباره گام بعدی را با اجرای خودِ تسک ترکیب میکنند؛ یعنی تصمیم برای حرکت بعدی را در یک گام تکی و صرفاً بر اساس تاریخچه طولانی اقدامات و تعاملات قبلی با محیط میگیرند. وقتی کار طولانی میشود، اطلاعات حیاتی میان خروجی ابزارها، خطاهای متوالی و آزمونوخطاهای قبلی دفن میشوند و ایجنت بهاصطلاح راهش را گم میکند.
تکنیکهای سنتی مقیاسپذیری در زمان استنتاج (Inference-time scaling) هم محدودیتهای جدی خود را دارند. روشهایی مثل تولید چندین پاسخ کاندید، چرخههای بازخورد و ویرایش، یا درختهای جستجوی از پیش تعیینشده، ساختار محاسباتی را از همان ابتدا بهصورت صلب و از پیش آماده مشخص میکنند. آنها تعداد تلاشها، مراحل راستیآزمایی یا دورهای بازبینی را پیش از آن تعیین میکنند که اصلاً ماهیت مسئله نشان دهد کدام محاسبات ارزش واقعی دارند.
پژوهشگران شرکت متا بر این باورند که تصمیمگیری درباره اینکه در مرحله بعد چه چیزی باید محاسبه شود، «خودش شایسته یک فرآیند استدلال ایجنتی اختصاصی و مستقل است».
آنها در مقاله خود توضیح میدهند: «این تأمل و تفکر، ساختار مختص به خود را دارد؛ ساختاری که دستاوردهای حاصل از اجرا را یکپارچه میکند، گزینههای پیش رو را بررسی مینماید و ارزش هر تصمیم را به دقت میسنجد.»
فراتدبیر ایجنتی چگونه کار میکند؟
چارچوب فراتدبیر ایجنتی که توسط محققان متا پیشنهاد شده، به ایجنت این توانایی را میدهد که درباره فرآیند استنتاج خود فکر کند و بر اساس آن تصمیم بگیرد.
این چارچوب یک چرخه منظم و تکرارشونده ایجاد میکند: انجام کار، ارزیابی نتایج، شناسایی گامهای بعدی امیدوارکننده و تخصیص منابع پردازشی بیشتر. دستاوردهای قبلی هم در تمام طول مسیر در دسترس میمانند تا ایجنت بتواند از تجربیات گذشته خود درس بگیرد و روی آنها کار کند، بدون اینکه مجبور باشد هر بار کل تاریخچه طولانی اجرا را از اول پردازش کند.
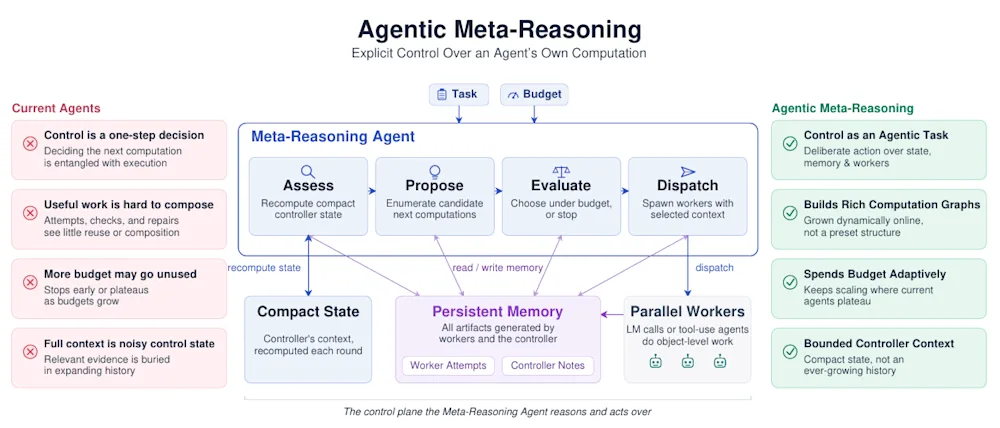
پژوهشگران این رویکرد را در قالب یک هارنس زمان استنتاج به نام «ایجنت فراتدبیر» (Meta-Reasoning Agent) پیاده کردهاند. این سیستم کارها را بین دو بخش تفکیک میکند: «ورکرها» که وظایف اصلی را انجام میدهند، و یک «کنترلر» که تصمیم میگیرد در گام بعدی چه کاری باید انجام شود.
ورکرها میتوانند فراخوانیهای مجزای مدل زبانی بزرگ (LLM) یا ایجنتهای کدنویسی مجهز به ابزار باشند که فایلها را بررسی میکنند، کد را تغییر میدهند و تستها را اجرا مینمایند. در آنسو، کنترلر نتایج آنها را موشکافی میکند، یافتههای خود را ثبت مینماید، ورکرهای جدیدی با دستورالعملهای هدفمند به راه میاندازد و در نهایت تصمیم میگیرد چه زمانی باید کار متوقف شود.
کنترلر یک چرخه استدلال چهار مرحلهای را دنبال میکند:
ارزیابی (Assess): کنترلر نتایج تازه ورکرها را بررسی کرده و درک خود از وضعیت تسک را بهروزرسانی میکند. در مثال کدنویسی، کنترلر ممکن است ثبت کند که قابلیت اصلی برنامه به درستی کار میکند، اما برخی تستها با خطا روبهرو شدهاند و مدیریت خطاها هنوز راستیآزمایی نشده است.
پیشنهاد اقدام (Propose): کنترلر بر اساس ارزیابی قبلی، گزینهها و اقدامات احتمالی بعدی را لیست میکند؛ کارهایی مثل ریشهیابی تستهای ناموفق، پیادهسازی قابلیتهای غایب، یا بازبینی مستقل کدهای موجود. در این مرحله، تمام گزینهها بدون نگرانی از بودجه پردازشی باقیمانده مطرح میشوند.
سنجش و سبکسنگین کردن (Evaluate): حالا کنترلر اقدامات پیشنهادی را با بودجه محاسباتی در دسترس میسنجد. برای مثال ممکن است تشخیص دهد رفع یک باگ مشخص ارزش بهمراتب بیشتری نسبت به بازنویسی یک ماژول سالم دارد.
اعزام و واگذاری (Dispatch): کنترلر دستورات مشخص را به ورکرها تحویل میدهد و اطلاعات کلیدی و یافتههای قبلی را به عنوان پیشزمینه در اختیار آنها میگذارد. همچنین در صورتی که کار به نتیجه رسیده باشد، میتواند فرآیند را متوقف کرده و همان خروجی نهایی را تأیید کند.
هرکدام از این مراحل میتواند فراخوانی مدل و عملیات حافظه اختصاصی خود را داشته باشد؛ سازوکاری که به کنترلر اجازه میدهد قبل از هر تصمیمگیری حساس، ابعاد مسئله را به خوبی بررسی کند.
یکی از ارکان حیاتی این معماری، «حافظه ماندگار آرتیفکتها» است. خروجی ورکرها و یادداشتهای کنترلر به عنوان آرتیفکتهایی با شناسههای یکتا ذخیره میشوند. کنترلر تنها یک ارزیابی فشرده و خلاصه از وضعیت تسک را در حافظه فعال نگه میدارد و فقط زمانی به سراغ جزییات حجیم آرتیفکتها میرود که واقعاً به آنها نیاز داشته باشد.
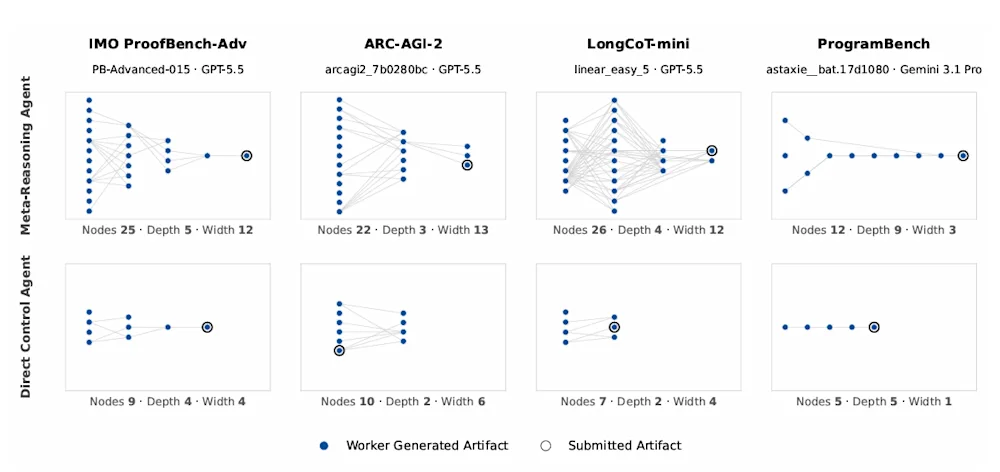
این آرتیفکتها در کنار یکدیگر یک «گراف محاسباتی» تشکیل میدهند. هر بار که کنترلر یک آرتیفکت قبلی را به عنوان زمینه برای یک کار جدید استفاده میکند، سیستم یک پیوند میان آنها ثبت میکند. برای نمونه، گزارش شکست یک تست میتواند به اصلاح هدفمند کد منجر شود، و سپس ورکر دیگری صحت آن اصلاح را راستیآزمایی کند.
این گراف به زیبایی نشان میدهد ایجنت چگونه راههای گوناگون را بررسی کرده و گامهای بعدی را بر شانه نتایج قبلی ساخته است. علاوه بر این، ابزاری عالی برای تحلیل این نکته فراهم میکند که آیا ایجنت واقعاً دارد از منابع محاسباتی خود به شکلی مولد استفاده میکند، یا صرفاً در حال دستوپا زدن در تلاشهای نامربوط و بیفایده است.
فراتدبیر ایجنتی در عمل؛ ثبت رکوردهای درخشان
پژوهشگران متا این چارچوب را روی چهار بنچمارک معتبر و چالشبرانگیز محک زدند: بنچمارک IMO ProofBench-Advanced برای اثباتهای ریاضیاتی، بنچمارک ARC-AGI-2 برای استدلال بصری و انتزاعی، بنچمارک LongCoT-mini برای استدلالهای طولانیمدت در چند حوزه مختلف، و بنچمارک ProgramBench برای بازسازی برنامهها از روی مستندات و مراجع اجرایی.
آنها سه مدل پیشتاز و پرچمدار دنیای هوش مصنوعی را به میدان آوردند: Gemini 3.1 Pro، مدل GPT-5.5 و مدل Opus 4.8. معیار مقایسه اصلی آنها «ایجنت کنترل مستقیم» (Direct Control Agent) بود؛ نسخهای که تصمیمات کنترلی را در یک گام تکی روی تاریخچه انباشتهشده میگیرد و کنترلر مجزا ندارد. همچنین این چارچوب با هارنسهای پژوهشی و ایجنتهای کدنویسی مطرحی همچون Codex، مدل Claude Code و مدلهای زبانی بازگشتی (RLM) مقایسه شد.
نتایج شگفتانگیز بود: در بالاترین بودجههای محاسباتی تستشده، چارچوب فراتدبیر در تمام ۱۲ مقایسه رودررو امتیازهای بالاتری کسب کرد.
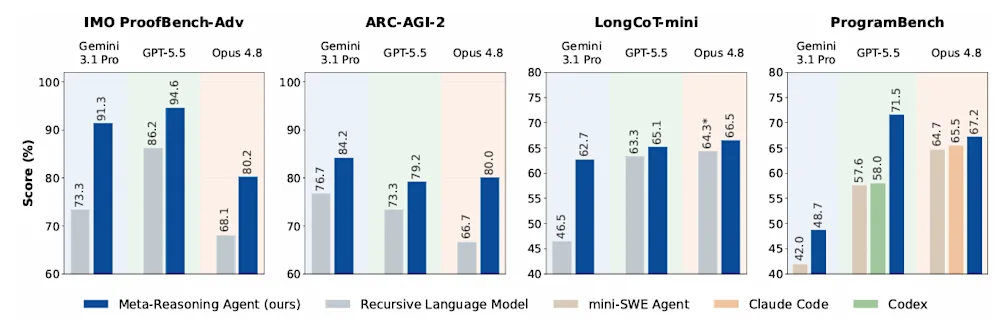
یکی از جالبترین یافتههای این تحقیق، نوع واکنش ایجنتها به افزایش بودجه پردازشی بود.
زمانی که سقف فراخوانی مدل در بنچمارک ProgramBench از ۴۰۰ به ۱,۲۰۰ افزایش یافت، فراتدبیر ایجنتی به همراه GPT-5.5 از ۶۴.۱ درصد به ۷۱.۵ درصد جهش کرد؛ در حالی که ایجنت کنترل مستقیم همان حوالی ۶۴ درصد درجا زد و در بالاترین بودجه تعیینشده، تنها توانست از حدود ۱۸ درصد از فراخوانیهای موجود استفاده کند!
نقش گراف آرتیفکتها در شکلگیری این تفاوت عملکردی بسیار پررنگ است. فراتدبیر ایجنتی نتایج میانی بسیار بیشتر و پیوندهای عمیقتری بین آنها خلق کرد. برای مثال در یک تست بنچمارک ARC-AGI-2، ایجنت کنترل مستقیم ۶ تلاش مستقل و ۴ پیگیری سطحی انجام داد؛ در مقابل، سیستم فراتدبیر شاخههای بسیار متنوعتری را بررسی کرد و اقدامات بعدی را هوشمندانه به نتایج قبلی متصل نمود.
پیادهسازی فراتدبیر ایجنتی؛ درسهایی برای توسعهدهندگان
اگرچه پژوهشگران در مقاله خود یک کد آماده و پیادهسازی رسمیِ بدوندردسر برای اجرا ارائه نکردهاند، اما مقاله شامل مشخصات و جزییات بسیار دقیقی از پرامپتهای کنترلر، دستورالعملهای ورکر، رابطهای حافظه و ابزارهای مورد نیاز است.
توسعهدهندگان میتوانند از این جزییات بهره بگیرند و با افزودن یک حلقه کنترلی مجزا به سیستمهای ایجنتی فعلی، نگهداری سوابق پایدار از کارهای میانی، و ارزیابی شفاف هزینه و فایده اقدامات پیشنهادی، دست به آزمایشهای کاربردی بزنند.
پیادهسازی این چارچوب در بنچمارک ProgramBench درسهای عملی فوقالعادهای برای ایجنتهای کدنویسی دارد: ورکرها تغییرات خود را در گیت کامیت میکنند و کنترلر میتواند از طریق یک رابط فقطخواندنی، مخزن کد را بررسی کرده و درستی ادعای آنها را بسنجد. ارزیابی زنده کنترلر، وضعیت ماژولها را به دستههای پیادهسازیشده، خراب، بررسینشده و دستنخورده تفکیک میکند. همچنین این چارچوب با محدود کردن تغییرات همزمان کد در محیط کاری مشترک، جلوی بازنویسی و تداخل کارهای ورکرها با یکدیگر را میگیرد.
البته فراتدبیر ایجنتی بدون چالش هم نیست؛ این روش به دلیل چرخههای کنترلی، سربار پردازشی و فراخوانیهای اضافی برای مدل زبانی ایجاد میکند. در بودجههای محاسباتی کوچک، این چارچوب گاهی حتی ضعیفتر از کنترل مستقیم عمل کرد، اما به محض اینکه توان پردازشی بیشتری در اختیارش قرار گرفت، رقیب خود را با اقتدار پشت سر گذاشت.
برای تیمهای سازمانی هوش مصنوعی، این دستاورد یک پیام کلیدی دارد: توانایی مدیریت محاسبات و پردازش باید به معیاری ضروری در ارزیابی و بهینهسازی ایجنتها تبدیل شود. با طولانیتر و پیچیدهتر شدن مأموریت ایجنتها، آنها باید این مهارت را داشته باشند که لحظهای مکث کنند و ببینند بهترین راه برای تخصیص منابع گرانبهای پردازشی چیست.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
جنجال هوش مصنوعی در مسابقه ویدیویی نیکون؛ برنده رتبه اول رد صلاحیت شد!
مسابقه ویدیویی معتبر «دنیای کوچک» نیکون با یک رسوایی بزرگ روبهرو شد؛ اثری که به مقام اول رسیده بود به دلیل استفاده پنهانی از هوش مصنوعی مولد رد صلاحیت شد تا جایزه به یک ویدیوی شگفتانگیز از دنیای تکسلولیها برسد. این ماجرا نیکون را بر آن داشت تا با توجه به پیشرفت شتابان هوش مصنوعی، قوانین داوری خود را به شکل اساسی بازنگری کند.
عصر طلایی دکاکورنها؛ سرمایهگذاران با سرعتی بیسابقه استارتاپهای هوش مصنوعی را ۱۰ میلیارد دلاری میکنند!
دنیای فناوری وارد عصر طلایی «دکاکورنها» شده و استارتاپهای هوش مصنوعی سریعتر از هر زمان دیگری به ارزشهای نجومی بالای ۱۰ میلیارد دلار میرسند. در حالی که سرمایهگذاران خطرپذیر مبالغ هنگفتی را به پای این شرکتها میریزند، کارشناسان هشدار میدهند که این تبوتاب همیشه تضمینکننده موفقیت بلندمدت نیست.
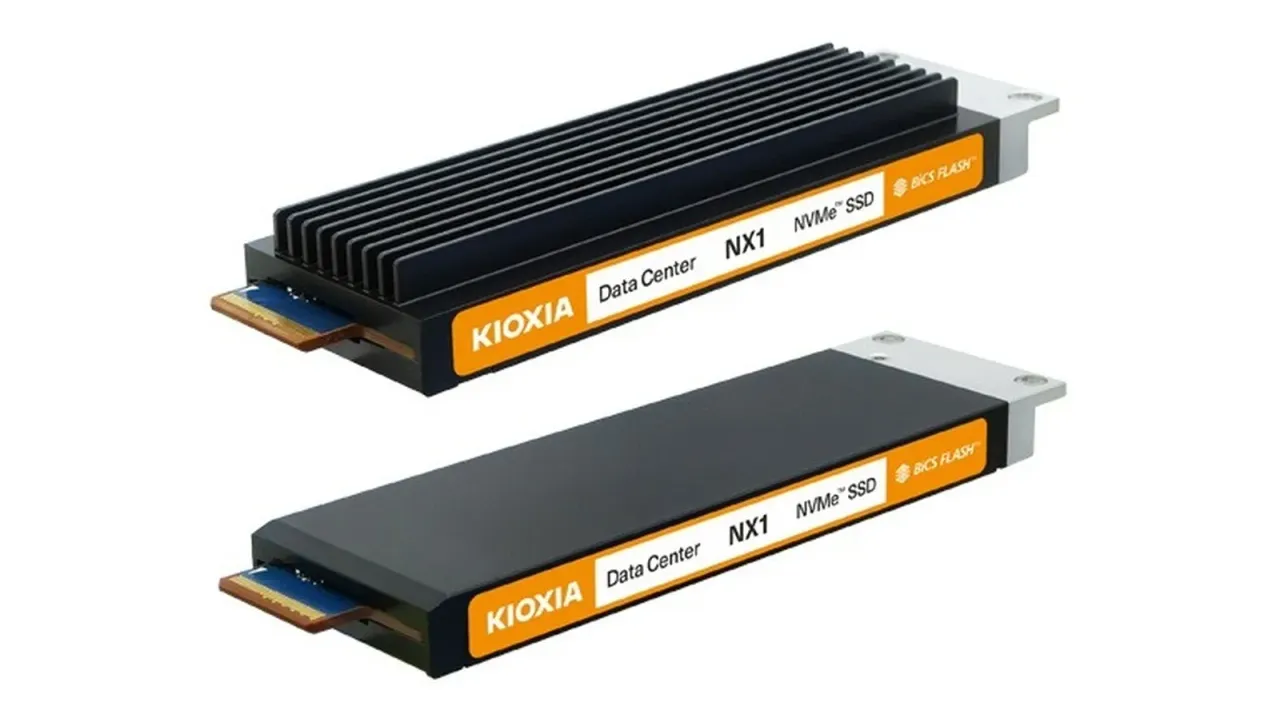
خداحافظی با داغ کردن حافظهها در دیتاسنترهای هوش مصنوعی؛ رونمایی کیوکسیا از SSDهای مجهز به خنککننده مایع
شرکت ژاپنی کیوکسیا از درایوهای SSD جدیدی با نام NX1 رونمایی کرده که به خنککننده مایع مجهز هستند و اختصاصاً برای پاسخگویی به فشار سنگین دیتاسنترهای هوش مصنوعی ساخته شدهاند. این درایوها با مهار هوشمندانه حرارت، جلوی افت ناگهانی سرعت و کاهش طول عمر قطعات را در پردازشهای فوقسنگین میگیرند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.