آموزش بینقص تیمهای هوش مصنوعی؛ فریمورک PROWL-2 خطاهای شبیهساز را خودش حین تمرین تعمیر میکند!
استارتاپ Odyssey با معرفی فریمورک نوآورانه PROWL-2، یکی از بزرگترین چالشهای آموزش چندایجنت در محیطهای شبیهسازیشده را حل کرده است. این فریمورک با تفکیک مسیر آموزش ایجنتها و مدل جهان، خطاهای شبیهساز را در لحظه شناسایی و اصلاح میکند تا هوش مصنوعی بر اساس توهمات محیطی آموزش نبیند. دستاوردی چشمگیر که جهشی خیرهکننده در بازیهای استراتژیک پیچیده و هدایت رباتهای فیزیکی رقم زده است.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- استارتاپ اودیسه (Odyssey) از فریمورک جدید PROWL-2 رونمایی کرده؛ سیستمی بر پایه یادگیری تقویتی که موقع آموزش کار تیمی ایجنتها، خطاهای مدل جهان و شبیهسازش رو خودش شناسایی و تعمیر میکنه.
- نتایج این سیستم فوقالعاده بوده؛ تو نبردهای شبیهسازیشده استارکرفت ۲ عملکرد ایجنتها تا ۹۱ درصد رشد داشته و تو کنترل رباتهای چهارپا هم نرخ موفقیت از حدود ۳۰ درصد به بالای ۷۰ درصد رسیده.
- برخلاف روشهای سنتی که توهمات شبیهساز کل آموزش رو به باد میداد، PROWL-2 یه دروازه ارزیابی داره که وضعیتهای پرخطا رو نگه میداره تا مدل اول تعمیر بشه و بعد آموزش ادامه پیدا کنه.
تعمیر مدلهای جهان همگام با آموزش ایجنتها در PROWL-2
استارتاپ اودیسه (Odyssey) بهتازگی از PROWL-2 رونمایی کرده است؛ یک فریمورک یادگیری تقویتی مدرن که حین آموزش هماهنگ تیمی از ایجنتها، خطاهای مدل جهان (World Model) را که وظیفه شبیهسازی تجربه آنها را بر عهده دارد، شناسایی و تعمیر میکند. در این چارچوب، برنامه آموزشی خطمشیها (Policy Curriculum) سناریوهایی را در اولویت میگذارد که ایجنتها هنوز جا برای پیشرفت دارند، در حالی که یک خطمشی اکتشافی جداگانه در محیط واقعی میگردد تا وضعیتهایی را پیدا کند که مدل جهان در پیشبینی آنها لنگ میزند.
بر اساس مقاله پژوهشی منتشرشده، این متدولوژی جدید در مقایسه با مدل پایه یادگیرنده جهان، در ۹ سناریوی مختلف چالش چندایجنت بازی StarCraft v2 عملکرد خیرهکنندهای ثبت کرده و جهش نسبی آن به ۹۱ درصد رسیده است. در بنچمارکهای هدایت رباتیک چندگانه نیز نرخ موفقیت آزمون Gate-3 از ۲۹.۸ درصد به ۷۰.۴ درصد جهش یافته و سناریوی فوقالعاده دشوار Shepherd-Hard هم از ۷.۳ درصد به ۲۸.۲ درصد ارتقا پیدا کرده است.
یادگیری تقویتی مبتنی بر مدل (Model-based RL) از یک شبیهساز هوشمند یا همان «مدل جهان» استفاده میکند تا تخمین بزند محیط به اقدامات ایجنتها چه واکنشی نشان خواهد داد. به این ترتیب، استراتژیها میتوانند در این دنیاهای ذهنی شبیهسازیشده (که به آنها رولاوتهای تصوری یا Imagined Rollouts میگویند) بدون نیاز به تعامل دائمی با محیط پرهزینه واقعی، به تمرین و مهارتافزایی بپردازند.
با این حال، یک مشکل بزرگ وجود دارد: خطاهای پیشبینی شبیهساز میتوانند کل فرآیند آموزش را به بیراهه بکشانند. در این شرایط، ممکن است ایجنت یاد بگیرد از باگها و شکافهای مدل شبیهساز سوءاستفاده کند؛ رفتاری که در داخل مدل شبیهساز جواب میدهد اما وقتی به دنیای واقعی بازگردانده میشود، با شکست سنگین روبهرو خواهد شد. علاوه بر این، در سناریوهای طولانیتر، خطاهای کوچک بهسرعت بزرگتر میشوند؛ چرا که هر پیشبینی نادرست، خوراک و ورودی مرحله بعدی میشود.
سیستمهای چندایجنت یک چالش سردردآور دیگر هم اضافه میکنند: «انحراف جمعی». از آنجا که حرکت هر ایجنت روی تجربه و شرایط سایر همتیمیهایش تأثیر میگذارد، با پیشرفت تیم، مدل جهان باید تعاملات پیچیده و مداوم میان چند ایجنت را بهطور همزمان ردیابی کند. کافی است مدل جهان درباره حرکت تنها یکی از ایجنتها اشتباه کند تا مسیر شبیهسازیشده کل گروه بهکلی دگرگون شود!
یک چرخه و سه ابزار کنترلی کلیدی
فریمورک PROWL-2 رویکرد «طراحی بدون نظارت محیط» (UED) را گسترش میدهد؛ رویکردی که سناریوهای آموزشی را بر اساس ارزش و پتانسیلی که برای یادگیری دارند، گلچین یا خلق میکند. نقطه شروع هر شبیهسازی ذهنی، یک «وضعیت آغازین» یا همان پیکربندی ذخیرهشده محیطی است. این فریمورک این وضعیتها را از طریق ۳ سازوکار زیر مدیریت و هماهنگ میکند:
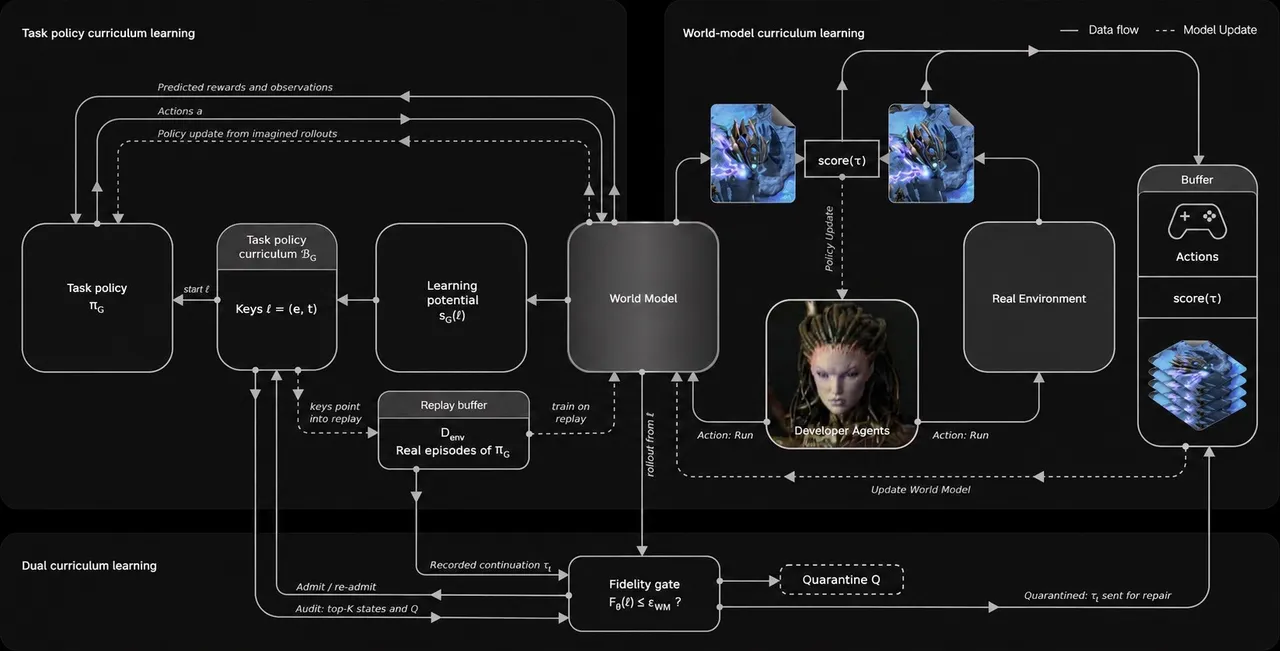
- برنامه آموزشی خطمشی وظایف (Task-policy curriculum): ایجنتهای خطمشی در شبیهسازیهای ذهنی تمرین میکنند که از وضعیتهای آغازین دارای بیشترین پتانسیل یادگیری شروع میشوند. همزمان با رشد مهارت ایجنتها، این برنامه وضعیتهای دشوارتر و چالشبرانگیزتری را جلوی پای آنها قرار میدهد.
- برنامه آموزشی مدل جهان (World-model curriculum): یک ایجنت جداگانه به عنوان «توسعهدهنده»، در محیط واقعی کاوش میکند تا مسیرهایی را بیابد که مدل فعلی در پیشبینی آنها ضعف دارد. این شکستها به دادههای فاینتیونینگ مدل تبدیل میشوند؛ ایدهای که رویکرد معرفیشده در PROWL-1 را توسعه میدهد.
- دروازه ارزیابی وفاداری (Fidelity gate): سیستم اقدامات ثبتشده از وضعیتهای آغازین مهم را در مدل جهان بازپخش میکند و سپس هر مسیر فرضی را با نمونه واقعی متناظرش تطبیق میدهد. اگر خطای پیشبینی از حد مجاز عبور کند، آن سناریو بلافاصله از چرخه آموزش خطمشی خارج شده و وارد صف تعمیر مدل میشود.
تنها زمانی سناریوها دوباره به چرخه آموزش ایجنتها برمیگردند که مدل تعمیرشده بتواند مسیرهای واقعی را با دقت کافی پیشبینی کند. با این شیوه، خطاهای شناختهشده شبیهساز به نمونههایی برای تعمیر و بازآموزی تبدیل میشوند و تا زمانی که اعتبارسنجی آنها تأیید نشود، اجازه ندارند آموزش خطمشی ایجنتها را آلوده کنند.
هرچه هماهنگی سختتر باشد، فاصله عملکرد چشمگیرتر میشود
بنچمارک StarCraft Multi-Agent Challenge v2 نبردها را بهصورت رویهای (Procedural) تولید میکند؛ یعنی ایجنتها نمیتوانند سناریوها را حفظ کنند. این آزمون شامل مبارزات متقارن ۵ به ۵ و ۱۰ به ۱۰ و حتی نبردهای نامتقارن ۱۰ به ۱۱ است که در آنها تیم آموزشدیده در اقلیت عددی قرار دارد. تصویرسازیهای روند بازی در مقاله نشان میدهد که ایجنتهای PROWL-2 بهخوبی آتش خود را متمرکز میکنند، صفوف دفاعی را فشرده نگه میدارند و از تاکتیکهای فریبنده بهره میبرند؛ در حالی که تیمهای مدل پایه معمولاً انسجام خود را از دست داده و حملات متفرق و بیاثری پیاده میکنند.
سناریو | PROWL-2 | مدل پایه (Baseline) |
|---|---|---|
Terran 5v5 | ۸۷.۵٪ | ۷.۵٪ |
Terran 10v11 | ۵۵٪ | ۲.۵٪ |
Protoss 10v11 | ۳۵٪ | ۰٪ |
Zerg 10v10 | ۹۰٪ | ۰٪ |
در این جامعه آماری ۴۰ اجرایی، هر پیروزی معادل ۲.۵ درصد است، بنابراین ارقام گزارششده تخمینهای حاصل از یک جامعه آماری مشخص هستند. جدول بالا ۴ سناریو از مجموع ۹ سناریوی استارکرفت ارائهشده در این مقاله پژوهشی را نشان میدهد.
در سوی دیگر، محیط روباتیک چندایجنت چهارپا (Multi-Agent Quadruped) کنترل پیوسته و هماهنگی فیزیکی ماشینها را به چالش میکشد. در ۶۰۰ هزار گام آموزشی در تست Gate-3، مدل پایه حتی در حل یکی از ۲۰ سناریوی ارزیابی موفق نشد، در حالی که PROWL-2 بیش از ۲۰ درصد سناریوها را حل کرد. با رسیدن به ۱.۵ میلیون گام آموزشی، نمودار یادگیری آنها بهترتیب به حدود ۲۵ درصد و ۷۰ درصد رسید.
ماموریت | PROWL-2 | مدل پایه (Baseline) |
|---|---|---|
Gate-3 | ۷۰.۴٪ | ۲۹.۸٪ |
Shepherd-Hard | ۲۸.۲٪ | ۷.۳٪ |
حضور دادههای واقعی همچنان نقشی حیاتی دارد
دروازه ارزیابی وفاداری برای کشف و رفع خطاهای شبیهساز کاملاً به مسیرهای ثبتشده در دنیای واقعی وابسته است. به بیان دیگر، اگرچه PROWL-2 تعاملات لازم برای آموزش خطمشی ایجنتها را بهشدت کاهش میدهد، اما هزینههای جمعآوری دادهها، ذخیرهسازی مسیرها، اعتبارسنجی و فاینتیونینگ دورهای مدل شبیهساز همچنان پابرجا خواهند بود.
آزمایشهای گزارششده در این پژوهش روی بازیها و بنچمارکهای کنترل پیوسته با وضعیتها، اقدامات و معیارهای موفقیت مشخص انجام شده است. استقرار فیزیکی در دنیای واقعی چالشهایی نظیر نویز سنسورها، عدم مشاهدهپذیری کامل محیط، تنوع سختافزاری و محدودیتهای ایمنی را به همراه دارد. به همین دلیل پیش از پیادهسازی این دستاوردها روی رباتهای فیزیکی یا سیستمهای ازدحامی (Swarm Systems)، اعتبارسنجیهای مستقلی نیاز خواهد بود.
ادغام سیستم بر چهار پایه اصلی استوار است
شرکت اودیسه تأکید دارد که این فریمورک با انواع الگوریتمهای یادگیری خطمشی و معماریهای مدل جهان سازگاری دارد. با این حال، استفاده عملی از آن بستگی به این دارد که آیا سیستم موجود میتواند دادهها و کنترلهای مورد نیاز این برنامه آموزشی دوگانه را تأمین کند یا خیر. پیادهسازی این رویکرد به ۴ مؤلفه نیازمند است:
- مسیرهای ثبتشده: دادههای واقعی از وضعیتها، کنشها و پیامدها برای بازپخش و مقایسه با شبیهساز.
- سنجه ناهمخوانی (Discrepancy Metric): معیاری دقیق برای اندازهگیری میزان خطای رولاوتهای ذهنی و تعیین آستانه وفاداری مدل.
- زمانبند برنامه آموزشی (Curriculum Scheduler): سیستمی برای تعلیق، بازتعریف اولویت و بازگرداندن وضعیتهای آغازین.
- بودجه بازآموزی: منابع پردازشی کافی برای بهروزرسانیهای هدفمند مدل جهان و اعتبارسنجی مکرر آن.
فریمورک PROWL-2 در واقع مانند یک لایه هماهنگکننده روی مدلهای یادگیرنده موجود سوار میشود و کاوش محیطی، آموزش خطمشی، تشخیص خطا و تعمیر شبیهساز را مدیریت میکند. تیمهایی که قصد بهرهگیری از آن را دارند باید بررسی کنند که آیا توان پردازشی مازاد و هزینه تعامل با محیط واقعی، با صرفهجویی حاصل از تمرین در شبیهساز ذهنی همخوانی دارد یا خیر.
از حلقه آموزش تا لایه محصول تجاری
تیم اودیسه شبیهسازهای مبتنی بر یادگیری خود را «ماشینهای تجربه» (Experience Machines) مینامد؛ محیطهایی که ایجنتها میتوانند تجربیات آموزشی ارزندهای را کسب کنند که به دست آوردن مستقیم آنها در دنیای واقعی بسیار پرهزینه یا ناامن است. این شرکت PROWL را به عنوان لایهای برای ارتقای وفاداری و مدیریت آموزش مدلهای بنیادین جهان (مانند Odyssey-3) طراحی کرده است؛ با این هدف بلندمدت که زمینه آموزش سیستمهای چندوجهی (Multimodal) را از طریق تعاملات واقعی و بیپایان فراهم سازد.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
پایان افت کیفیت تصاویر در ادیتهای پیاپی؛ عرضه مدل Ideogram 4.5 در هیگزفیلد
مدل هوش مصنوعی جدید Ideogram 4.5 با هدف حل یکی از بزرگترین چالشهای تولید تصویر، یعنی افت کیفیت و بههمریختگی پیکسلها در ادیتهای پیاپی، به پلتفرم هیگزفیلد آمد. این مدل با تثبیت پیکسلهای دستنخورده، امکان ویرایش متن، تغییر نورپردازی و اصلاح جزئیات عکسها را با بالاترین دقت و بدون افت کیفیت فراهم میکند.
خط و نشان سناتور وارن برای غولهای فناوری: ماجرای تخفیفهای نجومی مالیات به بهانه هوش مصنوعی چیست؟
الیزابت وارن، سناتور سرشناس آمریکایی، با ارسال نامههایی به مدیران ارشد مایکروسافت، آلفابت، متا و آمازون خواستار شفافسازی درباره میلیاردها دلار تخفیف مالیاتی به بهانه سرمایهگذاری در هوش مصنوعی شد. بر اساس گزارشها، غولهای فناوری با اتکا به قانون مالیاتی ۲۰۲۵ مبالغ هنگفتی را به جای مالیات، در دیتاسنترها و سختافزارهای پردازشی خود هزینه کردهاند. این سناتور معتقد است معافیتهای سرسامآور این شرکتها نباید به قیمت فشار مالی بر دوش طبقه متوسط و بودجه عمومی جامعه تمام شود.
ضربه محکم دادگاه به سازندگان هوش مصنوعی: آموزش مدلها با زحمت تحریریهای دیگران «استفاده منصفانه» نیست!
دادگاه تجدیدنظر آمریکا در حکمی سرنوشتساز اعلام کرد آموزش هوش مصنوعی با خلاصهها و یادداشتهای تحریریهای دیگران نقض قانون است و استفاده منصفانه به حساب نمیآید. این تصمیم پیام واضح و تکاندهندهای برای توسعهدهندگان دارد: نمیتوان با دیتایتر و تمیز دیگران، برای خودشان رقیب تجاری ساخت!
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.