اجرای محلی هوش مصنوعی با ۲٫۵ گیگابایت حافظه؛ نسخه کمحجم مدل Qwen2.5-3B منتشر شد
تیم توسعه Qwen در شرکت علیبابا نسخه رسمی و بهینهسازیشده مدل Qwen2.5-3B-Instruct را با فرمت ۴ بیتی AWQ منتشر کرد. این نسخه با کاهش حجم به حدود ۲٫۵ گیگابایت حافظه کارت گرافیک، امکان اجرای کاملاً محلی مدلهای زبانی هوش مصنوعی را روی سیستمهای خانگی و کارتهای گرافیک معمولی فراهم میکند.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- تیم Qwen علیبابا نسخه ۴ بیتی و فشردهشده مدل Qwen2.5-3B را با تکنیک AWQ منتشر کرد که بیش از ۸۲۰ هزار بار در هاگینگفیس دانلود شده است.
- این مدل با اشغال تنها ۲٫۵ تا ۵٫۴ گیگابایت حافظه VRAM، اجرای محلی و بدون اینترنت هوش مصنوعی را روی پردازندههای گرافیکی معمولی ممکن میسازد.
- مدل جدید با پشتیبانی از کانتکست ۳۲ هزار توکنی و بیش از ۲۹ زبان، عملکرد چشمگیری در کدنویسی، ریاضیات و درک ساختار دادهها ارائه میدهد.
تیم توسعه مدلهای Qwen در علیبابا، چکپوینت رسمی AWQ برای مدل Qwen2.5-3B-Instruct را با فشردهسازی وزنهای خطی بهدقت ۴ بیتی منتشر کرد؛ مدلی که شمار دانلودهای آن در پلتفرم هاگینگفیس (Hugging Face) از مرز ۸۲۰ هزار بار گذشته است. این مدل با حدود ۳٫۱ میلیارد پارامتر میتواند تنها با اشغال چند گیگابایت از حافظه کارت گرافیک (VRAM) اجرا شود و استفاده از هوش مصنوعی را برای برنامههای محلی و سرویسهای تکپردازندهای کاملاً کاربردی و دسترسپذیر کند.
تکنیک کوانتایز وزن آگاه از اکتیویشن (AWQ) با استفاده از اکتیویشنهای کالیبراسیون، کانالهای وزنی دارای بیشترین تأثیر بر خروجیهای مدل را شناسایی میکند. این روش پیش از آغاز فرآیند کوانتایز، کانالهای کلیدی را مقیاسبندی میکند تا خطای ناشی از نمایش وزنها با اعداد صحیح ۴ بیتی به حداقل برسد. این فرآیند پس از پایان آموزش روی مدل موجود اعمال میشود و نیازی به آموزش مجدد ندارد.
برچسب ۴ بیتی در اصل به وزنهای خطی کوانتایزشده اختصاص دارد؛ درحالیکه برداریسازیها (Embeddings)، اکتیویشنها، لایههای نرمالسازی، بافرهای زمان اجرا و کش کلید-مقدار (KV cache) بسته به موتور استنتاج میتوانند در فرمتهای FP16 یا BF16 باقی بمانند. در نتیجه، مجموع حافظه VRAM مورد نیاز فراتر از حجم خالص وزنهای فشردهشده خواهد بود و با افزایش طول کانتکست (پنجره زمینه)، اندازه بچ (Batch Size) و درخواستهای همزمان بیشتر میشود.
نگاهی دقیق به مشخصات فنی نسخه ۴ بیتی
مخزن این پروژه، فشردهسازی AWQ را مستقیماً روی چکپوینت پایه مدل پیاده کرده است. این نسخه تمامی ویژگیهای نسخه اصلی شامل معماری، توکنایزر، تنظیمات دستورپذیری (Instruction Tuning) و محدودیتهای پنجره زمینه را حفظ میکند.
مشخصه فنی | مقدار |
|---|---|
تعداد پارامترها | ۳٫۰۹ میلیارد پارامتر در مجموع؛ ۲٫۷۷ میلیارد بدون احتساب لایههای امبدینگ |
لایههای ترنسفورمر | ۳۶ لایه |
مکانیزم توجه (Attention) | ۱۶ هد کوئری (Query)؛ ۲ هد کلید-مقدار (Key-Value) |
پنجره زمینه (کانتکست) | ۳۲٬۷۶۸ توکن |
حداکثر تولید متن (خروجی) | ۸٬۱۹۲ توکن در چارچوب کانتکست مجاز |
فرمت وزنها | AWQ با دقت ۴ بیتی |
مؤلفههای اصلی معماری | RoPE, SwiGLU, RMSNorm, QKV bias, tied word embeddings |
پوشش زبانی | بیش از ۲۹ زبان |
مجوز استفاده (لایسنس) | مجوز تحقیقاتی Qwen (Qwen Research License) |
مکانیزم توجه چندپرسمانی گروهی (Grouped-query attention) دو هد کلید-مقدار را میان ۱۶ هد کوئری به اشتراک میگذارد؛ رویکردی که مصرف حافظه کش کلید-مقدار را هنگام تولید متن به میزان چشمگیری کاهش میدهد. این صرفهجویی در مصرف حافظه بهویژه هنگام پردازش پرامپتهای طولانی یا مدیریت چندین درخواست همزمان کارایی فوقالعادهای پیدا میکند.
تیم Qwen تأکید میکند که مدلهای سری ۲٫۵ در زمینههای کدنویسی، ریاضیات، پیروی از دستورها، تولید متون بلند، درک جداول و تولید خروجیهای ساختاریافته پیشرفت چشمگیری داشتهاند. زبانهای پشتیبانیشده شامل چینی، انگلیسی، فرانسوی، اسپانیایی، پرتغالی، آلمانی، ایتالیایی، روسی، ژاپنی، کرهای، ویتنامی، تایلندی و عربی میشوند. البته توسعهدهندگانی که برنامههای آنها به خروجیهای معتبر JSON وابسته است، همچنان باید از روشهای اعتبارسنجی اسکیما (Schema Validation) یا رمزگشایی مقید (Constrained Decoding) استفاده کنند.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
جاسوسی هکرهای چینی از هزاران شرکت با نفوذ به کانکتوایز؛ پای ایجنتهای هوش مصنوعی در میان است
هکرهای وابسته به چین پس از نفوذ به سرویس پشتیبانگیری ابری شرکت کانکتوایز، اطلاعات ورود هزاران سازمان را به سرقت بردند. این مهاجمان با بهکارگیری ایجنتهای هوش مصنوعی موفق شدند با سرعتی بیسابقه به سیستمهای ابری بیش از دو هزار شرکت نفوذ کنند و به اسناد حساس آنها دست یابند.
سم آلتمن: جامعه ریاضیات پس از شوک اولیه، ناچار به پذیرش هوش مصنوعی شده است
سم آلتمن، مدیرعامل اوپنایآی، میگوید جامعه ریاضیات پس از شوک ناشی از حل مسائل پیچیده توسط هوش مصنوعی، مراحلی مشابه سوگواری را سپری کرده است. به گفته او، پژوهشگران پس از عبور از انکار، خشم و نگرانی از آینده شغلی، سرانجام به پذیرش نقش انکارناپذیر هوش مصنوعی روی آوردهاند.
تبدیل شخصیتهای مجازی به رباتهای واقعی؛ خیز بلند سازنده Love and Deepspace در حوزه هوش مصنوعی احساسی
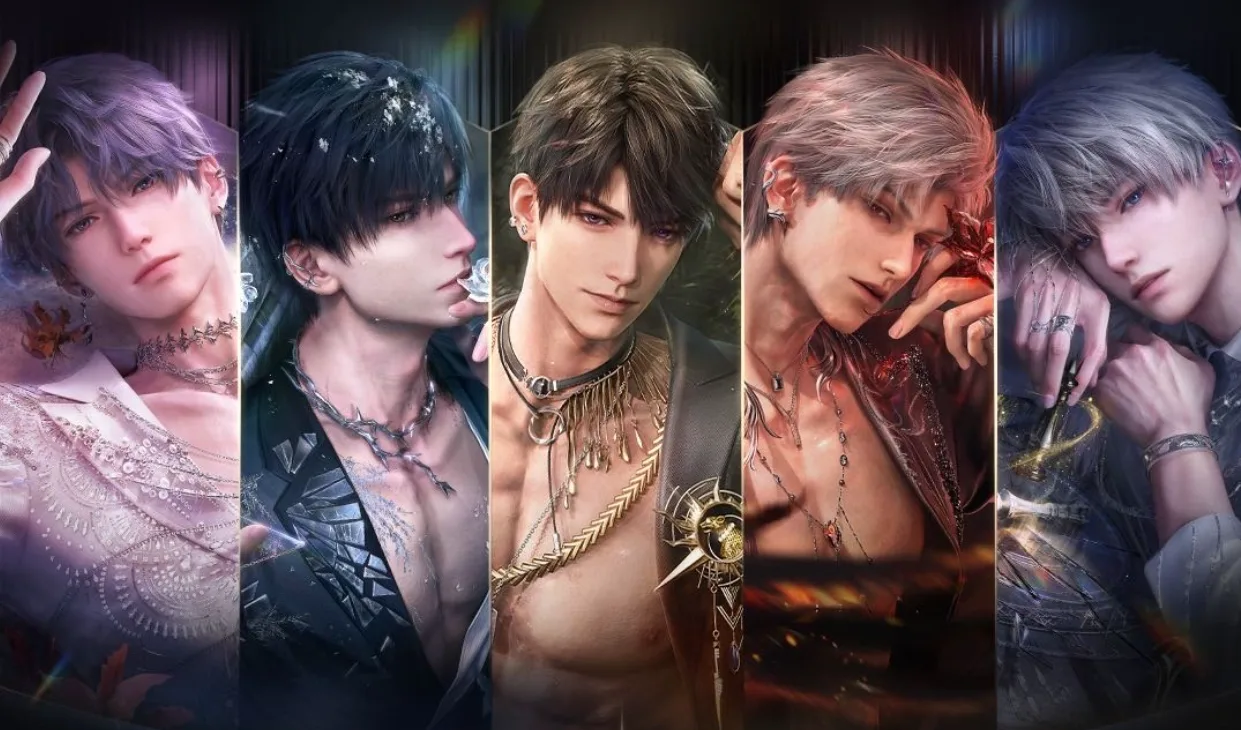
شرکت بازیسازی پیپرگیمز با انتشار آگهیهای شغلی برای جذب متخصصان رباتیک، رسماً وارد حوزه رباتهای همراه مجهز به هوش مصنوعی میشود. این استودیو قصد دارد با تکیه بر محبوبیت عناوینی چون Love and Deepspace، شخصیتهای مجازی پرطرفدار خود را به رباتهای فیزیکی تعاملی در دنیای واقعی تبدیل کند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.