کنترل هوشمند شبکههای ۶G با ایجنت جدید؛ مدیریت بهینه منابع مخابراتی بدون نیاز به سیگنال پاداش
پژوهشگران دانشگاه اکستر با همکاری بریتیش تلکام ایجنت زبانی نوآورانهای توسعه دادهاند که مدیریت منابع شبکههای مخابراتی ۶G را بر اساس بازخوردهای متنی یاد میگیرد. این سیستم بدون نیاز به پاداشهای عددی سنتی و تنها با ۳۰۰ مرحله آموزش، به بازدهی بالاتری نسبت به روشهای مرسوم یادگیری تقویتی دست یافته است.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- ایجنت جدید دانشگاه اکستر بهجای سیگنالهای پاداش عددی، بر اساس نقدهای متنی و بازنگری گذشتهنگر، تصمیمهای خود را در مدیریت شبکه بهینهسازی میکند.
- این روش در شبیهسازی برشبندی شبکه ۶G تنها با یک مسیر آموزشی ۳۰۰ مرحلهای به بالاترین بازدهی رسید؛ درحالیکه روشهای معمول یادگیری تقویتی به ۱۶۰۰ مسیر نیاز دارند.
- معماری سیستم وظایف را تفکیک کرده است؛ مدل Qwen3-4B اقدامات بلادرنگ را انجام میدهد و DeepSeek-R1 با تحلیل روند عملکرد، زمینه تنظیم وزنهای مدل را فراهم میسازد.
پژوهشگران دانشگاه اکستر و شرکت بریتیش تلکام یک ایجنت مبتنیبر مدل زبانی برای کنترل خودکار شبکه توسعه دادهاند که با تکیه بر نقدهای متنی درباره تصمیمهای خود آموزش میبیند. این سیستم در یک شبیهساز اختصاصی و تنها پس از یک مسیر آموزشی ۳۰۰ مرحلهای، به بالاترین سطح مطلوبیت ترکیبی در میان پنج روش مورد آزمایش دست یافت؛ درحالیکه فرآیند معمول یادگیری تقویتی نیازمند ۱۶۰۰ مسیر آموزشی بود. این تفاوت چشمگیر نشاندهنده کاهش قابلتوجه در تعاملات پرهزینه با محیط شبیهسازی است.
در این مقاله پژوهشی، روش مذکور روی برشبندی شبکه دسترسی رادیویی (RAN slicing) پیادهسازی شده است؛ جایی که یک کنترلکننده باید طیف فرکانسی را بهصورت آنی میان سرویسهای رقیب تقسیم کند. مفهوم «بدون پاداش» در اینجا معنای مشخصی دارد: قضاوتهای زبانی و بهینهسازی ترجیحات، فرآیند بهروزرسانی سیاستها را هدایت میکنند، درحالیکه معیارهای عددی و امتیاز مطلوبیت ترکیبی همچنان در بخش ارزیابی عملکرد حفظ شدهاند.
یک امتیاز برای اهداف متضاد
برشبندی شبکه دسترسی رادیویی، بلوکهای فیزیکی منابع (واحدهای زمان-فرکانس تخصیصیافته توسط زمانبند سلولی) را میان برشهای مجازی شبکه توزیع میکند. این آزمایش شامل ترافیک با نرخ بیت تضمینشده (GBR) با تعهدات خدماتی صریح، و ترافیک انعطافپذیر غیرتضمینی (non-GBR) است.
یک کنترلکننده باید میان سه هدف اصلی تعادل برقرار کند:
- بهرهوری از منابع: حفظ بازدهی طیف فرکانسی در دسترس.
- کیفیت خدمات: محدود کردن موارد نقض تعهدات در تمامی کلاسهای ترافیکی.
- پایداری: جلوگیری از تغییرات پیاپی در تخصیص منابع و کاهش بار عملیاتی ناشی از آن.
در یادگیری تقویتی سنتی، تمامی این اهداف در قالب یک عدد اسکالر وزندار خلاصه میشوند. وزندهی نامناسب میتواند به سیاستهایی منجر شود که یک معیار را به قیمت تضعیف معیار دیگر بهبود میبخشند؛ علاوهبراین، با تغییر الگوی ترافیک، تعادل بهینه نیز تغییر میکند. ایجنتهای مبتنیبر پرامپت توانایی استدلال درباره اهداف متنی را دارند، اما تاریخچههای طولانی، پنجره زمینه (کانتکست) را پر میکنند و مدلها ممکن است از اطلاعات نهفته در مراحل ابتدایی غافل شوند. بهروزرسانی مستقیم وزنهای مدل، سازگاری پایدار و ماندگاری را برای ایجنت به ارمغان میآورد.
منتقدی که مینویسد
این معماری، فرآیند انتخاب بلادرنگ اقدامات را از تحلیل و ارزیابی گذشتهنگر جدا میکند. در این چرخه، مدلی به نام Actor بر پایه Qwen3-4B تخصیص منابع را انتخاب میکند، درحالیکه یک مدل بازنگر (Reflector) بر پایه DeepSeek-R1 کل مسیر طیشده را بررسی و تحلیل میکند. این چرخه طی پنج مرحله ادامه مییابد:
مطالب مرتبط و پیشنهادی
مدیر فناوری کپیتال وان: بهترین هوش مصنوعی سازمانی سیستمی است که کارمندان اصلاً متوجه حضورش نشوند
مدیر ارشد فناوری سازمانی در کپیتال وان توضیح میدهد که چرا ابزارهای هوش مصنوعی بهجای تحمیل پرامپتها و رابطهای کاربری پیچیده، باید در پسزمینه محو شوند. بهباور او، هوش مصنوعی زمانی در سازمانها موفق است که اصطکاک کاری را حذف کند و میدان را برای قضاوت تخصصی کارکنان باز بگذارد.
ورود ایجنتهای هوش مصنوعی به بازار ۸۰ تریلیون دلاری؛ نقشه مسترکارت برای تسویه خودکار خریدها
مسترکارت با توسعه ابزارهای تحلیلی و پروتکلهای امنیتی نوین، درصدد است خریدهای بینشرکتی B2B را به ایجنتهای هوش مصنوعی بسپارد. این غول پرداخت با همکاری غولهای فناوری میکوشد ریسک خطاهای مالی نرمافزارها را کاهش دهد و سهم قابلتوجهی از این بازار ۸۰ تریلیون دلاری کسب کند.
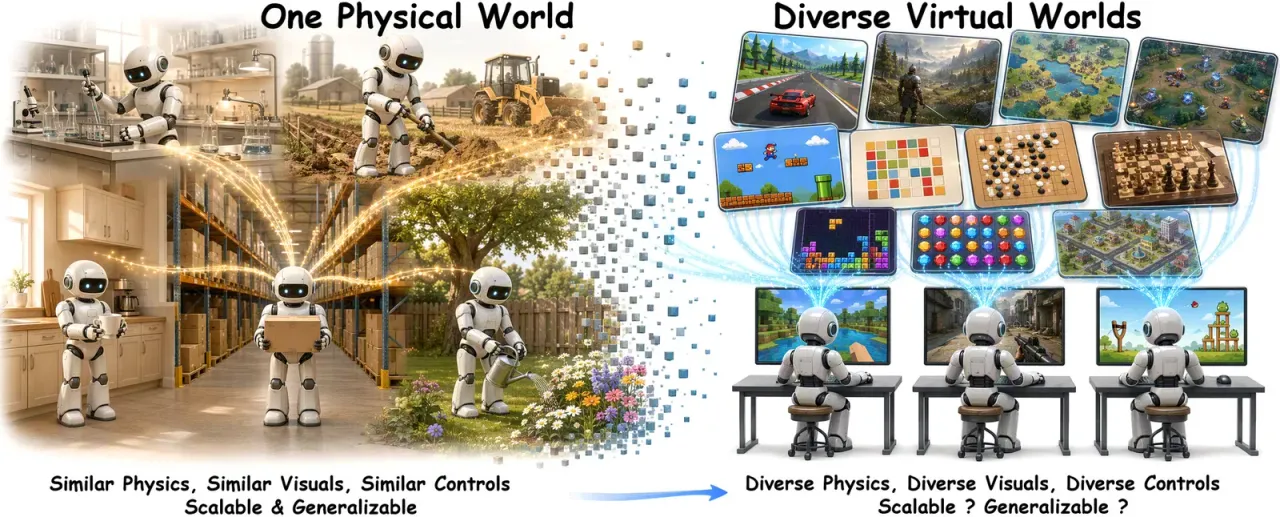
مدلهای هوش مصنوعی GameScaling متنباز شدند؛ کنترل بازیها تنها با ماوس و کیبورد
پژوهشگران هوش مصنوعی شرکت میهویو با همکاری محققان دانشگاهی، خانواده مدلهای GameScaling را بهصورت متنباز منتشر کردند. این مدلها با تحلیل فریمهای بصری بازیها، فرمانهای حرکتی ماوس و کیبورد را شبیهسازی کرده و عناوینی مانند ماینکرفت و دووم را بهطور خودکار اجرا میکنند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.