آموزش اجرای رایگان هوش مصنوعی روی کامپیوتر در ۵ دقیقه؛ بدون نیاز به اینترنت و اشتراک ماهیانه
اجرای محلی مدلهای هوش مصنوعی روی کامپیوتر شخصی دیگر پیچیده نیست و بهلطف ابزارهایی مانند LM Studio در کمتر از ۵ دقیقه انجام میشود. با این روش میتوانید بدون نیاز به اینترنت، پرداخت حق اشتراک دلاری یا نگرانی از نقض حریم خصوصی، از مدلهای پیشرفته استفاده کنید.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- بهلطف نرمافزار رایگان LM Studio، راهاندازی و اجرای آفلاین مدلهای زبانی روی کامپیوتر شخصی تنها حدود ۵ دقیقه زمان میبرد.
- برای مدلهای سبک تا متوسط به کارت گرافیکی با ۸ تا ۱۲ گیگابایت VRAM نیاز است، اما پردازندههای عصبی مدرن نیز قادر به اجرای آنها هستند.
- اجرای محلی هوش مصنوعی حریم خصوصی کامل کاربران را تضمین کرده و آنها را از پرداخت اشتراکهای دلاری و سهمیه توکن بینیاز میکند.
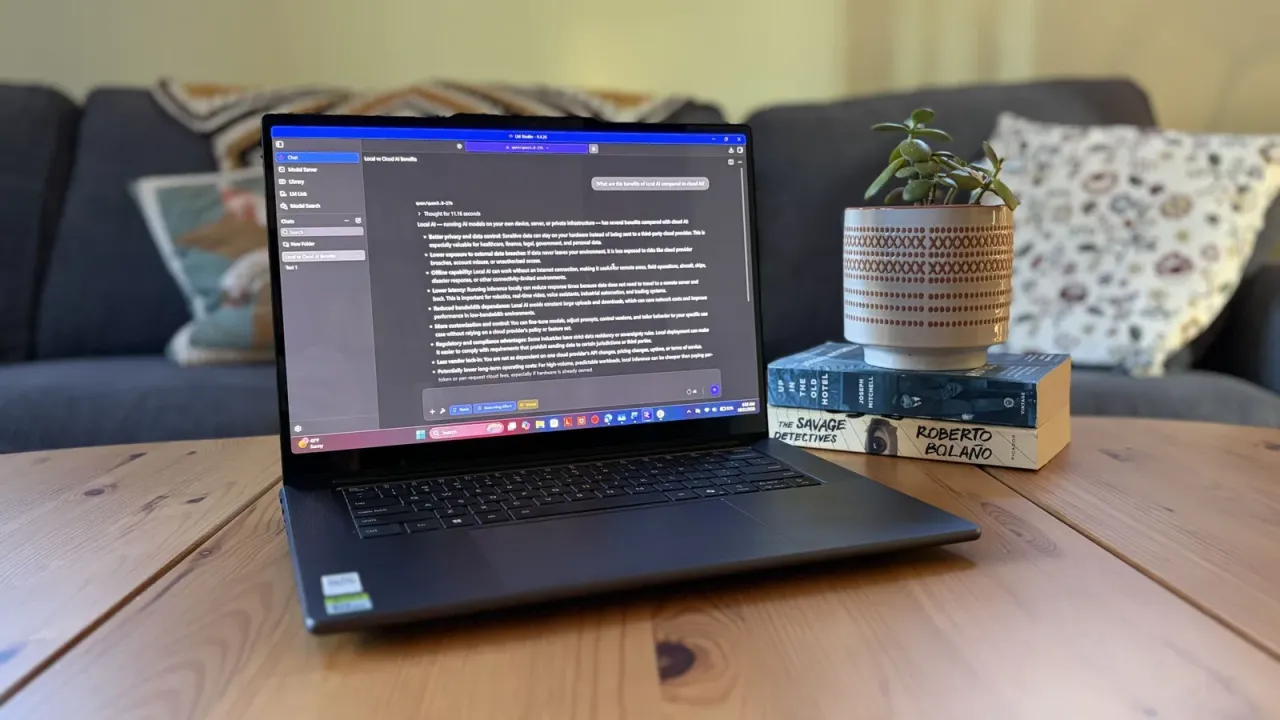
در بررسیهای اخیر، لپتاپ Lenovo Pro 9n مجهز به تراشه جدید NVIDIA RTX Spark مورد استفاده قرار گرفت؛ دستگاهی با پردازنده گرافیکی قدرتمند و حافظه یکپارچه (Unified Memory) که به سیستم اجازه میدهد در صورت نیاز به حافظه ویدیویی (VRAM) در پردازشهای سنگین هوش مصنوعی، از رم اصلی دستگاه کمک بگیرد. این ترکیب سختافزاری فرصت مناسبی فراهم کرد تا راهاندازی یک مدل و ایجنت هوش مصنوعی محلی روی لپتاپ آزمایش شود.
اما چرا باید بهجای سرویسهای ابری به سراغ هوش مصنوعی محلی رفت؟ دلایل متعددی برای این انتخاب وجود دارد، اما مهمترین آنها به مصرف توکنها و هزینههای جانبی، حفظ کامل حریم خصوصی و دسترسی آسان و آفلاین مربوط میشود.
البته برای تجربه هوش مصنوعی محلی لزوماً به تراشههای پرچمداری مانند RTX Spark نیازی نیست. اگر استفاده روزمره شما از هوش مصنوعی به چت کردن، تولید تصویر، خلاصهسازی متون، مطالعه یا انجام کارهای سبک روزمره خلاصه میشود، سیستمهای خانگی و لپتاپهای معمولی نیز بهخوبی از پس اجرای مدلهای سبک برمیآیند.
حتی برای کاربرانی که تجربه چندانی در کار با ابزارهای پیشرفته هوش مصنوعی ندارند، راهاندازی این سیستم فوقالعاده ساده است و کل فرآیند در کمتر از ۵ دقیقه انجام میشود.
پیشنیازها و سختافزار مورد نیاز قبل از شروع
در اجرای محلی هوش مصنوعی، یک پردازنده گرافیکی (GPU) قدرتمند نقشی بهمراتب حیاتیتر از پردازنده مرکزی (CPU) ایفا میکند. قرار گرفتن کامل وزنهای مدل در حافظه ویدیویی گرافیک (VRAM) ضامن بالاترین سرعت و بهترین عملکرد خواهد بود.
برای اجرای مدلهای محلی کوچکتر، یعنی مدلهایی در بازه ۳ تا ۸ میلیارد پارامتر (3B تا 8B)، به پردازنده گرافیکی با دستکم ۸ گیگابایت حافظه VRAM نیاز خواهید داشت. برای مدلهای متوسط بین ۸ تا ۱۴ میلیارد پارامتر نیز داشتن دستکم ۱۲ گیگابایت VRAM توصیه میشود.
در مورد مدلهای بزرگتر با ۳۰ میلیارد پارامتر یا بیشتر، ماجرا به دنیای سرورها و سیستمهای ورکاستیشن فوقحرفهای وارد میشود؛ جایی که برای تأمین VRAM مورد نیاز باید یا به سراغ کارتهای گرافیک بسیار گرانقیمت رفت یا از سیستمهایی با حافظه یکپارچه (مانند لپتاپهای مجهز به RTX Spark) بهره گرفت.
اجرای هوش مصنوعی صرفاً با اتکا به پردازنده اصلی (CPU) چندان توصیه نمیشود، هرچند از نظر فنی امکانپذیر است. بااینحال باید توجه داشت که حتی با داشتن پردازندههای چندهستهای مدرن و قدرتمند، سرعت پاسخگویی و تولید توکنها روی CPU بهمراتب پایینتر خواهد بود.
در این میان، گیمرها بهترین بستر سختافزاری را در اختیار دارند؛ چراکه سیستمهای گیمینگ معمولاً به کارتهای گرافیک قدرتمند با حافظه کافی مجهز هستند.
آموزش گامبهگام نصب هوش مصنوعی رایگان و محلی در ویندوز
در این راهنما نشان میدهیم که اجرای محلی هوش مصنوعی روی کامپیوتر شخصی چقدر ساده و بیفرازونشیب است؛ بهطوریکه از لحظه باز کردن مرورگر برای دریافت نرمافزار تا ارسال نخستین پرامپت، تنها حدود ۵ دقیقه زمان نیاز است.
خلاصه کل مراحل؟ نرمافزار LM Studio را دانلود کنید، مدل دلخواهتان را انتخاب و بارگیری نمایید، آن را در محیط برنامه اجرا کنید و گفتوگو را شروع کنید. در ادامه جزئیات هر مرحله بهدقت بررسی شده است.
۱. نصب برنامه LM Studio؛ رایگان، قدرتمند و فوقالعاده ساده
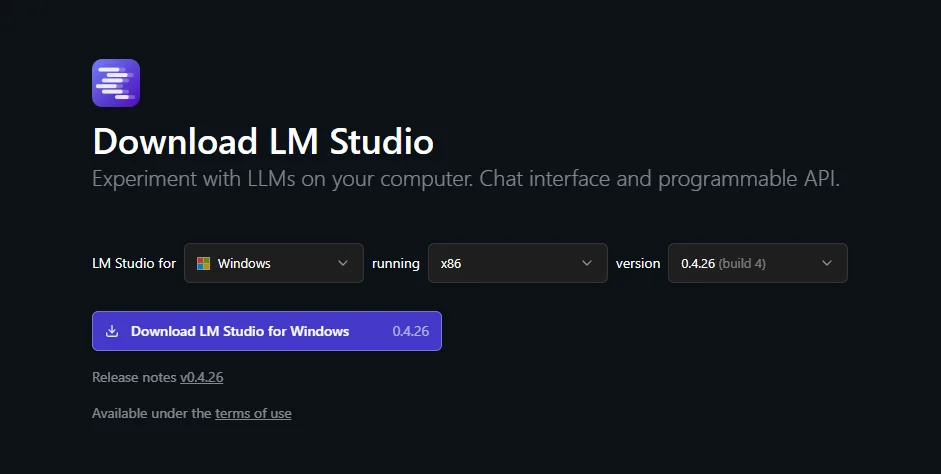
اگرچه ابزارهای دیگری مانند Ollama نیز برای مدیریت مدلهای زبانی بزرگ بهصورت محلی وجود دارند، اما برنامه LM Studio بهدلیل رابط کاربری گرافیکی و سادگی بیمانند خود انتخابی بینقص برای شروع است.
این برنامه کاملاً رایگان است و بهگونهای طراحی شده که تمام فرآیند دانلود، مدیریت و تعامل با مدلهای هوش مصنوعی را در بالاترین حد سادگی ممکن در اختیار کاربر بگذارد. محیط کاربری آن بسیار مدرن، منظم و چابک است و پایداری عملکردی بالایی ارائه میدهد.
میتوانید این برنامه را مستقیماً از وبسایت رسمی LM Studio دانلود کنید. این نرمافزار روی نسخههای مختلف ویندوز (پردازندههای x86 و ARM)، لینوکس و مکاواس (macOS) بهخوبی اجرا میشود.
۲. دانلود مدل هوش مصنوعی متناسب با توان سختافزار
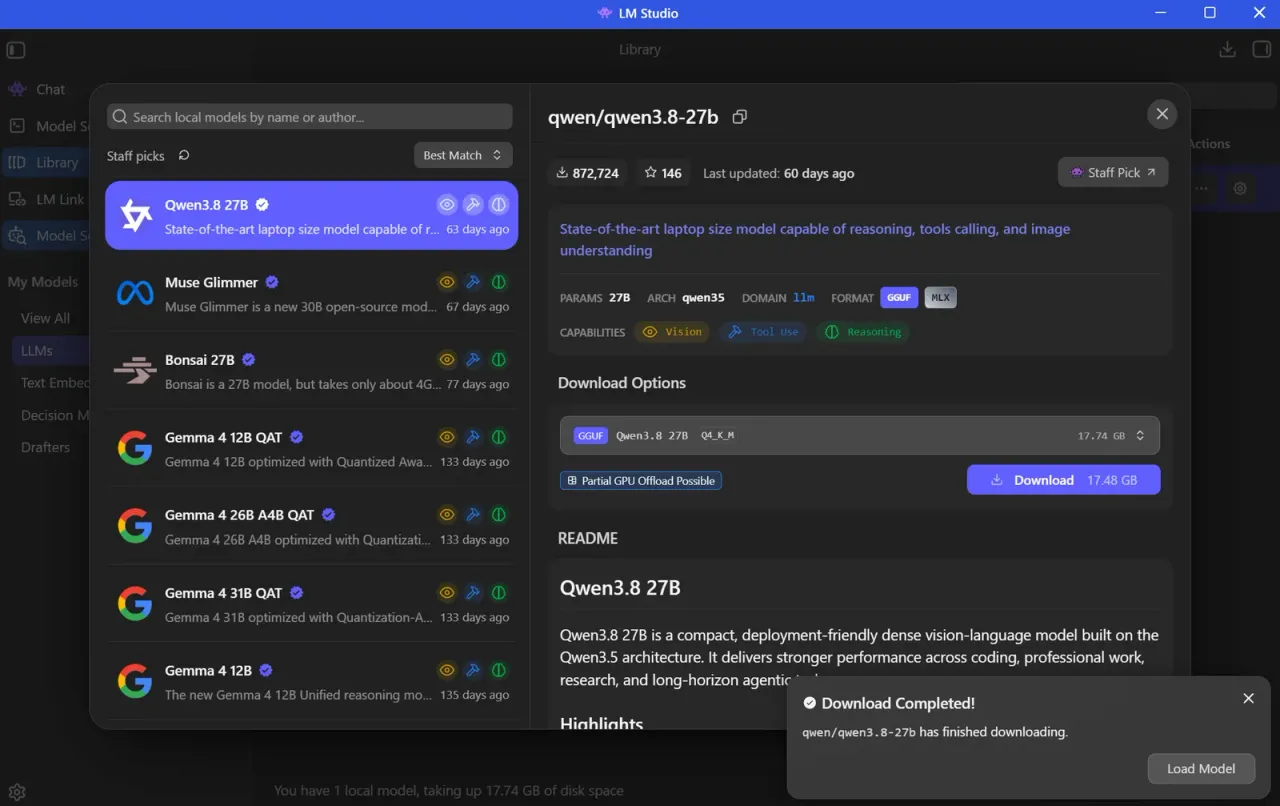
گام بعدی، انتخاب و بارگیری مدل هوش مصنوعی درون خود برنامه LM Studio است. این کار از طریق بخش جستجوی مدل (Model Search) انجام میپذیرد؛ بخشی که بلافاصله پس از ورود، چندین مدل محبوب و استاندارد را پیشنهاد میدهد.
مدل متنباز Qwen3.8 در حال حاضر محبوبیت فراوانی در میان کاربران دارد. بااینحال هنگام انتخاب مدل، یک نکته ظریف فنی وجود دارد که باید به آن دقت کرد.
مدل انتخابی Qwen در این آزمایش دارای ۲۷ میلیارد پارامتر (27B) است؛ اندازهای سنگین که برای سیستمهای معمولی مناسب نیست و بیشتر برای آزمایش لپتاپهای قدرتمند مجهز به حافظه یکپارچه مانند RTX Spark به کار میرود.
اکثر کاربران عادی بازدهی بسیار بهتری با مدلهای کمحجمتر و با تعداد پارامتر کمتر خواهند داشت. مزیت بزرگ LM Studio این است که سیستم جستجوی داخلی آن وضعیت سازگاری و میزان مصرف منابع هر مدل را با برچسبهای شفاف نمایش میدهد. علاوه بر این، وبسایتهایی مانند ابزار انتخاب مدل Codersera نیز به کاربران در یافتن دقیقترین مدل سازگار با قطعات کامپیوترشان کمک میکنند.
اگر مدلی پیدا کردید که کنار آن برچسب «امکان بارگذاری کامل روی کارت گرافیک» (Full GPU Offload Possible) خورده باشد، میتوانید مطمئن باشید که آن مدل بهطور کامل روی کارت گرافیک شما مستقر شده و بالاترین سرعت ممکن را ارائه خواهد داد.
تنها کافی است دکمه دانلود (Download) مدل مورد نظر خود را بزنید و منتظر بمانید تا فرآیند بارگیری تکمیل شود.
۳. بارگذاری مدل و شروع گفتوگو
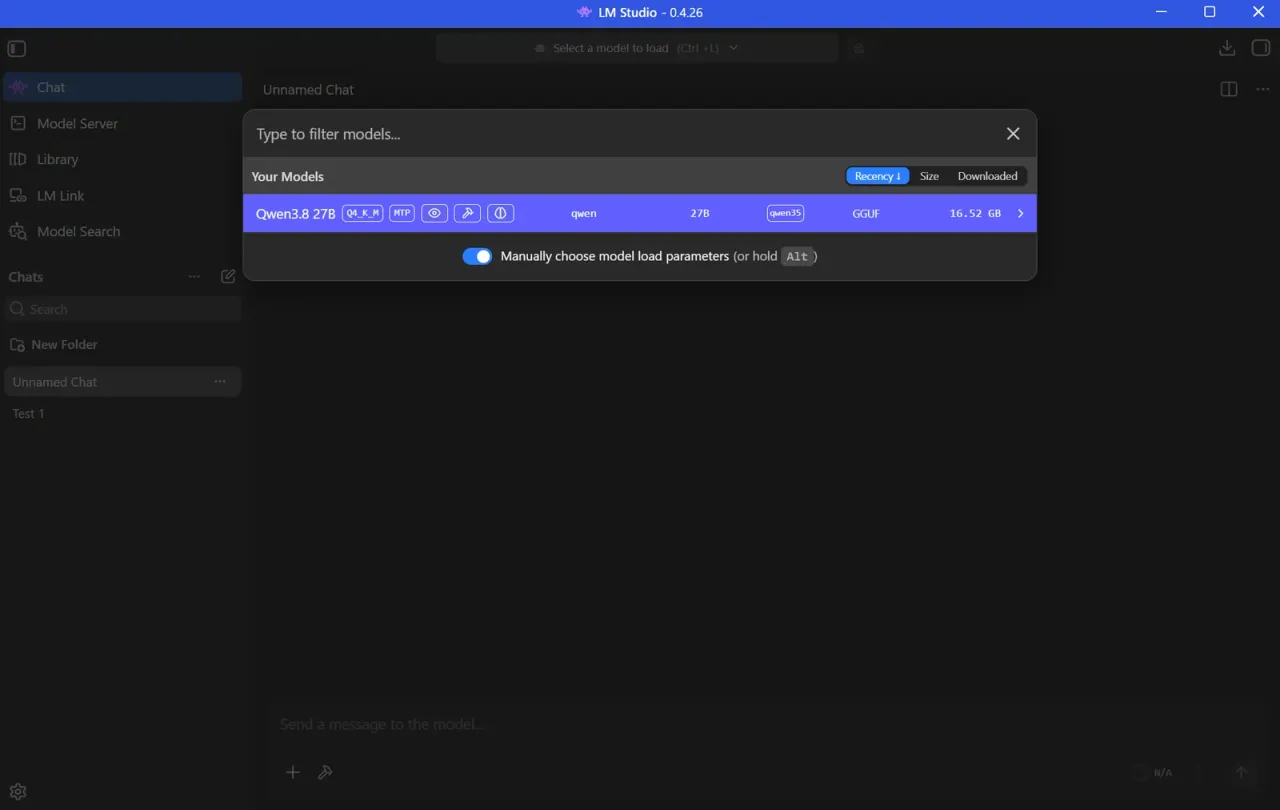
پس از پایان دانلود، زمان بارگذاری مدل زبانی در محیط نرمافزار فرا میرسد؛ فرآیندی که به چند شیوه ساده در دسترس است.
سادهترین روش این است که روی آیکون چت (Chat) در گوشه بالا سمت چپ برنامه کلیک کنید و سپس دکمه «انتخاب مدل برای بارگذاری» (Select a model to load) را در بخش میانی بالای پنجره انتخاب نمایید.
سپس روی مدل مورد نظرتان کلیک کنید تا فرآیند بارگذاری در حافظه انجام شود. این مرحله بسته به حجم مدل، تنها چند لحظه طول میکشد.
به محض تکمیل بارگذاری در رم یا حافظه ویدیویی، سیستم آماده پاسخگویی است و میتوانید بدون نیاز به اینترنت، گفتوگو با ایجنت هوش مصنوعی اختصاصی خود را شروع کنید.
هوش مصنوعی محلی دیگر مختص کاربران حرفهای نیست
راهاندازی یک مدل زبانی محلی امروزه تفاوتی با دانلود و نصب یک نرمافزار ساده ندارد. اگر به کار با ابزارهای هوش مصنوعی علاقهمندید اما حریم خصوصی، امکان استفاده کاملاً آفلاین و رهایی از هزینههای اشتراک یا سهمیه توکن برایتان اولویت دارد، استفاده از سیستمهای محلی بهترین و سرراستترین راهکار موجود است.
اگر به کامپیوتری مدرن دسترسی دارید، میتوانید تنها در مدتزمانی که برای خواندن این راهنما صرف شد، ایجنت هوش مصنوعی خود را بهصورت کاملاً محلی و رایگان فعال کنید.
پاسخ به سؤالات متداول درباره هوش مصنوعی محلی
هوش مصنوعی محلی چیست و چه مزیتی دارد؟
هوش مصنوعی محلی به این معناست که مدلهای زبانی بهجای میزبانی در سرورهای ابری شرکتهای بزرگ، مستقیماً روی حافظه و سختافزار کامپیوتر شخصی شما اجرا میشوند. در این حالت پردازشها توسط قطعات سیستم خودتان انجام میپذیرد؛ بنابراین نیازی به اتصال اینترنت ندارید و مکالمات و دادههای شخصی شما هرگز به فضای ابری ارسال نمیشوند.
چرا بهجای هوش مصنوعی ابری باید از نسخههای محلی استفاده کرد؟
سرویسهای ابری مانند Claude، ChatGPT و Copilot دسترسی آسانی دارند، اما بسیاری از کاربران تمایلی ندارند که مکالمات، اسناد و اطلاعات محرمانه آنها به سرورهای ناشناخته اینترنتی مخابره شود.
علاوه بر این، پرداخت حق اشتراکهای ماهیانه دلاری یا خرید توکنهای اضافی نیز از دیگر دغدغههایی است که با استفاده از مدلهای محلی بهطور کامل برطرف میگردد.
محدودیتهای هوش مصنوعی محلی در مقایسه با سرویسهای ابری چیست؟
طبیعتاً اجرای محلی بدون محدودیت نیست.
مدلهای قابل اجرا روی کامپیوترهای شخصی معمولاً توان پردازشی کمتری در مقایسه با مدلهای عظیم ابری دارند. این سطح از توانایی برای نیازهای روزمره و عمومی کاربران کاملاً کافی است، اما کارشناسان و برنامهنویسان فوقحرفهای در برخی پروژههای بسیار سنگین همچنان به نسخههای ابری پیشرفته نیاز خواهند داشت.
علاوه بر این، دستیابی بهسرعت مطلوب نیازمند سختافزاری قدرتمند و کارت گرافیک مناسب است. هرچند فرآیند نصب بسیار آسان است، اما کیفیت تجربه کاربری کاملاً به توان قطعات سیستم شما بستگی دارد.
آیا برای کار با برنامه LM Studio به اینترنت نیاز است؟
اینترنت تنها برای یک بار دانلود برنامه LM Studio و دریافت فایل مدل هوش مصنوعی مورد نیاز است. پس از آن، تمامی عملیات پردازش و گفتوگو بهصورت صددرصد آفلاین انجام خواهد شد.
آیا مدلهای زبانی محلی روی واحد پردازش عصبی (NPU) لپتاپها نیز اجرا میشوند؟
واحدهای پردازش عصبی (NPU) با رونمایی از کامپیوترهای سری کوپایلوت پلاس (Copilot+ PC) توجه زیادی جلب کردند و بهطور ویژه برای تسریع وظایف هوش مصنوعی طراحی شدهاند.
اگرچه NPUهای نسلهای ابتدایی قدرت چندانی برای مدلهای بزرگ ندارند، اما تراشههای نوین مانند سری Snapdragon X2 با توان ۸۰ تابس (TOPS) توانایی اجرای مدلهای زبانی سبک را دارند.
آیا کوپایلوت ویندوز، یک هوش مصنوعی محلی به حساب میآید؟
اپلیکیشن پیشفرض Copilot در ویندوز ۱۱ برای پاسخگویی به کاربران کاملاً به سرورهای ابری متکی است و بدون اتصال فعال به اینترنت کار نمیکند.
بااینحال، قابلیتهای اختصاصی کوپایلوت پلاس در ویندوز ۱۱، نظیر ابزارهای Recall و Studio Effects، از NPU داخلی دستگاه برای پردازش محلی بهره میبرند و هیچ دادهای را به فضای ابری ارسال نمیکنند.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
جاسوسی هکرهای چینی از هزاران شرکت با نفوذ به کانکتوایز؛ پای ایجنتهای هوش مصنوعی در میان است
هکرهای وابسته به چین پس از نفوذ به سرویس پشتیبانگیری ابری شرکت کانکتوایز، اطلاعات ورود هزاران سازمان را به سرقت بردند. این مهاجمان با بهکارگیری ایجنتهای هوش مصنوعی موفق شدند با سرعتی بیسابقه به سیستمهای ابری بیش از دو هزار شرکت نفوذ کنند و به اسناد حساس آنها دست یابند.
سم آلتمن: جامعه ریاضیات پس از شوک اولیه، ناچار به پذیرش هوش مصنوعی شده است
سم آلتمن، مدیرعامل اوپنایآی، میگوید جامعه ریاضیات پس از شوک ناشی از حل مسائل پیچیده توسط هوش مصنوعی، مراحلی مشابه سوگواری را سپری کرده است. به گفته او، پژوهشگران پس از عبور از انکار، خشم و نگرانی از آینده شغلی، سرانجام به پذیرش نقش انکارناپذیر هوش مصنوعی روی آوردهاند.
تبدیل شخصیتهای مجازی به رباتهای واقعی؛ خیز بلند سازنده Love and Deepspace در حوزه هوش مصنوعی احساسی
شرکت بازیسازی پیپرگیمز با انتشار آگهیهای شغلی برای جذب متخصصان رباتیک، رسماً وارد حوزه رباتهای همراه مجهز به هوش مصنوعی میشود. این استودیو قصد دارد با تکیه بر محبوبیت عناوینی چون Love and Deepspace، شخصیتهای مجازی پرطرفدار خود را به رباتهای فیزیکی تعاملی در دنیای واقعی تبدیل کند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.