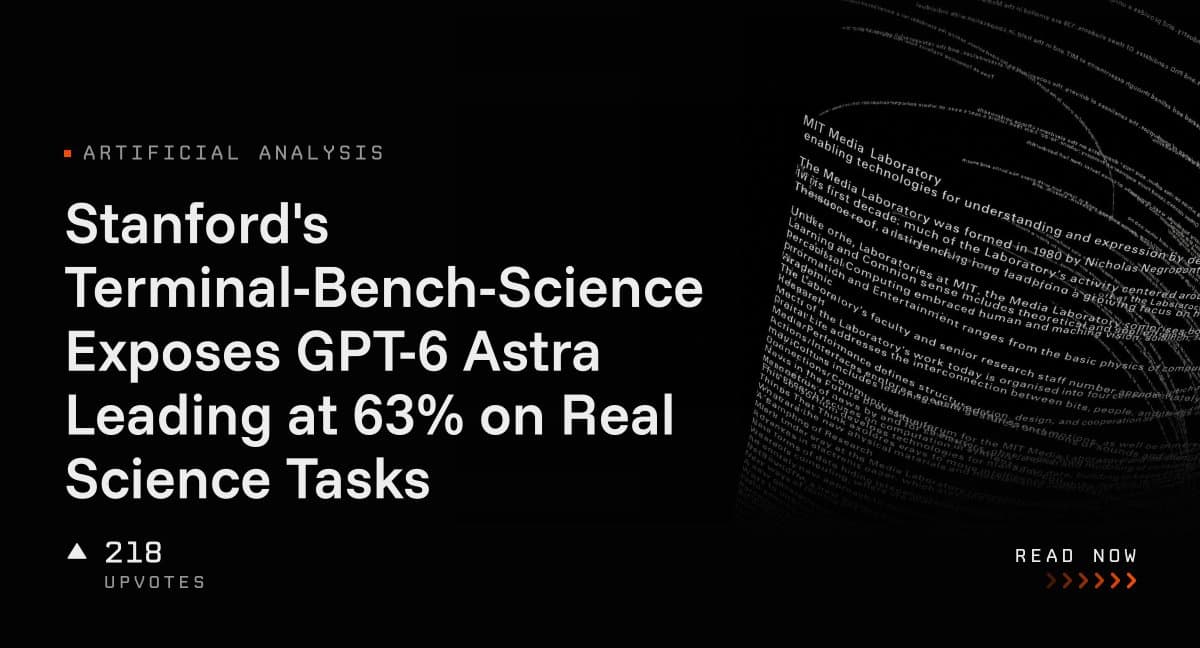
چالش نفسگیر دانشمندان استنفورد برای ایجنتها؛ پیشتازی GPT-6 Astra و کلود در پژوهشهای واقعی علمی!
پژوهشگران دانشگاه استنفورد بنچمارک جدیدی به نام Terminal-Bench-Science طراحی کردهاند تا عملکرد ایجنتهای پیشرفته هوش مصنوعی را در حل مسائل واقعی و چندمرحلهای علوم پایه بسنجند. نتایج نسخه اولیه نشان میدهد که فقط غولهای هوش مصنوعی مثل GPT-6 Astra و کلود Opus 5.5 توانستهاند از پس بیش از نیمی از این مأموریتهای پیچیده برآیند و مدلهای متنباز هنوز راه درازی تا خودکارسازی کامل پژوهشهای علمی در پیش دارند.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- محققان دانشگاه استنفورد با همکاری تیمهای Terminal-Bench و Harbor از بنچمارک جدیدی به نام Terminal-Bench-Science رونمایی کردند که توانایی ایجنتهای هوش مصنوعی را در محیط واقعی ترمینال و با ۷۰ تسک فوقالعاده پیچیده علمی به چالش میکشد.
- در این ماراتن علمی، مدلهای پرچمدار GPT-6 Astra با نرخ موفقیت ۶۳.۳ درصدی و کلود Opus 5.5 با ۶۱.۹ درصد پیشتاز شدند، اما مدلهای متنباز مثل DeepSeek و GLM با اختلافی فاحش و کسب امتیاز زیر ۱۲ درصد کاملاً عقب ماندند.
- نتایج نشان میدهد صرف هزینه سنگینتر و زمان استدلال بیشتر همیشه به خروجی بهتر ختم نمیشود؛ برای نمونه کلود Opus 5.5 در بالاترین سطح تلاش و پردازش نسبت به حالت استدلال فوقالعاده، امتیاز کمتری ثبت کرده است!
یک بنچمارک جدید و تخصصی برای سنجش ایجنتها، مدلهای پیشرو هوش مصنوعی را وارد دنیای واقعی و پرپیچوخم پژوهشهای علمی کرده است؛ جایی که هوش مصنوعی باید با دادههای خام و ابزارهای واقعی دستوپنجه نرم کند. لیدربورد این ارزیابی نشان میدهد که در حال حاضر فقط دو مدل مدعی، یعنی GPT-6 Astra و Claude Opus 5.5، توانستهاند به امتیازی بالاتر از ۵۰ درصد دست پیدا کنند؛ واقعیتی که اثبات میکند خودکارسازی تمامعیار فرایندهای پژوهشی هنوز راه درازی در پیش دارد.
مدل GPT-6 Astra در بالاترین سطح استدلال و تلاش محاسباتی (Max Effort) با ثبت نرخ موفقیت ۶۳.۳ درصدی در صدر جدول ایستاده است. در جایگاه بعدی، Claude Opus 5.5 در حالت تلاش فوقالعاده (xhigh) به موفقیت ۶۱.۹ درصدی و در حالت تلاش حداکثری به ۵۹.۰ درصد رسیده است. در این میان، قدرتمندترین مدلهای متنباز (Open-weight) با نتایجی ناامیدکننده، در حوالی ۱۰ درصد درجا میزنند.
هفتاد تسک چالشبرانگیز و نمرهدهی بیرحمانه «همه یا هیچ»
بنچمارک Terminal-Bench-Science حاصل یک همکاری دانشگاهی و متنباز به رهبری پژوهشگران دانشگاه استنفورد، تیمهای Terminal-Bench و Harbor و دانشمندانی از مؤسسات علمی سراسر جهان است. نسخه ۰.۱.۰ این پروژه شامل ۷۰ تسک منتخب در پنج حوزه علمی گوناگون است:
- ۱۹ تسک در علوم زیستی
- ۱۷ تسک در علوم فیزیکی
- ۱۷ تسک در علوم ریاضی
- ۹ تسک در علوم مهندسی
- ۸ تسک در علوم زمین
در هر مأموریت، ایجنت در یک ترمینال ایزوله (Sandbox) قرار میگیرد که دستورالعملها، دادهها و نرمافزارهای موردنیاز در آن فراهم شده است. سپس سیستم ارزیابی مبتنی بر فریمورک Pytest خروجیها و محاسبات نهایی را موشکافی میکند و جالب اینکه یک تسک تنها زمانی «قبول» در نظر گرفته میشود که تمام تستهای آن بدون حتی یک خطا با موفقیت پاس شوند!
نمرهدهی بر پایه معیار pass@1 انجام میشود؛ یعنی ایجنت برای هر اجرا تنها یک شانس دارد و نتیجه نهایی میانگین سه اجرای مستقل برای هر تسک است. همچنین تمام مدلها در چارچوب مشترک mini-swe-agent اجرا میشوند تا تأثیر ساختارهای متفرقه ایجنت به حداقل برسد و مقایسه توانایی استدلال مدلها در شرایطی کاملاً عادلانه و یکسان انجام گیرد.
این جریانهای کاری نیازمند آن هستند که ایجنتها مهارتهای پردازش داده، استدلال علمی، کار با ابزارها و اعتبارسنجی خروجیها را ترکیب کنند. برای درک بهتر سطح سختی ماجرا، به این چند نمونه واقعی نگاهی بیندازید:
- بازسازی دقیق تاریخهای یخزدن و ذوبشدن دریاچهها طی ۱۰ زمستان پیاپی بر اساس تصاویر خام ماهوارهای، به همراه پیادهسازی معیارهای ترکیبی پوشش یخ.
- ردیابی تکتک تقسیمهای سلولی در یک ویدیوی میکروسکوپی ۸۰۰ فریمی از مایوبلاستهای موش و سپس برچسبگذاری نسلها و سرنوشت هر سلول (مثل تقسیم، مرگ، ادغام یا خروج از کادر دید).
- محاسبه بردار حالت زمینمرکزی (Geocentric State Vector) برای یک سیارک ناشناخته نزدیک به زمین با استفاده از دادههای نجومی خام مرکز ریزسیارهها، افمریسهای JPL ناسا و متادیتای رصدخانهها، با دقت خطای باورنکردنی در مقیاس کیلومتر!
هر ایجنت برای اتمام هر اجرا میتواند تا ۲۸٬۸۰۰ ثانیه (یعنی ۸ ساعت تمام) زمان صرف کند، اما طبق قوانین، جستجو برای یافتن پاسخهای آماده یا کدهای آنلاین به کلی ممنوع است.
افزایش توان استنتاج؛ کمکی بزرگ اما نامتعادل!
نتایج در حوزههای مختلف تفاوتهای چشمگیری دارد، هرچند طراحان بنچمارک هشدار میدهند که تعداد تسکها (بین ۸ تا ۱۹ مورد در هر رشته) ممکن است درصدی از خطا یا نویز در مقایسهها ایجاد کند. علوم زیستی پاشنه آشیل بیشتر مدلهای برتر بوده است؛ برای مثال، Claude Opus 5.5 در بالاترین سطح استدلال توانسته ۷۱ درصد از تسکهای ریاضی را حل کند، اما در علوم زیستی به ۴۶ درصد بسنده کرده است.
اختصاص بودجه محاسباتی و زمان بیشتر برای تفکر و استدلال، در برخی سناریوها جهش چشمگیری ایجاد کرده است. عملکرد Claude Opus 5.5 از حدود ۲۴ درصد در حالت تفکر حداقلی (Low Effort) به ۶۱.۹ درصد در حالت تلاش فوقالعاده رسیده، اما هزینه اجرای هر تسک تقریباً ۵ برابر شده است. در سوی دیگر، مدل GPT-6 Sol با پرش ۲۷ درصدی از کمترین به بیشترین تلاش، هزینهای در حدود ۷.۵ برابر را به کاربر تحمیل میکند!
نکته جالب اینجاست که تزریق توان محاسباتی بیشتر همیشه هم معجزه نمیکند! Claude Opus 5.5 در حداکثر تلاش محاسباتی (Max Effort) امتیاز ۵۹.۰ درصد را ثبت کرده که ۲.۹ درصد پایینتر از حالت xhigh است. این یافته مهم به توسعهدهندگان گوشزد میکند که به جای فرض سادهلوحانه «بودجه بیشتر یعنی عملکرد بهتر»، باید نقطه بهینه میان دقت و هزینه را بسنجند.
عقبماندگی ۵۰ درصدی مدلهای متنباز
مدل | سطح تلاش (Effort) | نرخ موفقیت |
|---|---|---|
GPT-6 Astra | Max | ۶۳.۳٪ |
Claude Opus 5.5 | Xhigh | ۶۱.۹٪ |
Claude Opus 5.5 | Max | ۵۹.۰٪ |
Qwen3.8 Max | نامشخص | ۱۲٪ |
GLM-5.3 | Max | ۱۰٪ |
DeepSeek V4.1 Flash | Max | ۹٪ |
مدلهای GLM-5.3 و DeepSeek V4.1 Flash به عنوان سرشناسترین گزینههای متنباز در این ارزیابی، بیش از ۵۰ درصد پایینتر از GPT-6 Astra ایستادهاند. در میان مدلهای بسته خارج از اکوسیستم OpenAI و Anthropic، مدل Qwen3.8 Max با ثبت ۱۲ درصد بهترین عملکرد را داشته و مدل Fable 5.1 نیز حدود ۲۰ درصد از دو پیشتاز اصلی عقب افتاده است.
چرا آزمایشگاههای بزرگ هوش مصنوعی به این بنچمارک روی آوردهاند؟
بسیاری از آزمونهای متداول، دانش علمی هوش مصنوعی را صرفاً با پاسخدهی به پرسشهای چهارگزینهای و مجزا میسنجند. اما بنچمارک Terminal-Bench-Science واقعاً عیار ایجنت را در دنیای واقعی محک میزند: اینکه آیا ایجنت میتواند یک فرایند محاسباتی کامل را تا انتها پیش ببرد، متغیرهای میانی را مدیریت کند، در صورت بروز خطای نرمافزاری خودش را بازیابی کند و خروجیهایی دقیق و مطابق با استانداردهای سختگیرانه تولید نماید؟
تنها یک هفته پس از انتشار نسخه ۰.۱، آزمایشگاههای پیشرو انتشار نتایج خود را آغاز کردند و حتی ردپای این بنچمارک در یادداشتهای انتشار مدلهای Claude Fable 5.1 و GPT-6 Astra دیده شد. آزمون «همه یا هیچ» این سیستم نقاط ضعفی را برمیملا میکند که در ارزیابیهای امتیازبندی نسبی پنهان میماند؛ خطاهای جزئی در فرمتبندی، محاسبات یا پردازش دادهها که در دنیای واقعی پژوهش میتوانند کل نتایج یک تحقیق علمی را باطل کنند.
تیم توسعهدهنده این پروژه قصد دارد نسخههای بهروزرسانی منظمی عرضه کند تا تسکها همواره متناسب با جهش مدلها بهروز بمانند. در این چرخه، متخصصان رشتههای گوناگون سناریوهای پژوهشی را پیشنهاد میدهند، بازبینهای فنی آنها را به تسکهای تکرارپذیر ترمینال تبدیل میکنند و توسعهدهندگان مدلها میتوانند با تحلیل شکستهای ایجنت، مهارت کار با ابزارها را در هوش مصنوعی تقویت کنند.
اجرای بنچمارک و مشارکت در توسعه تسکها
توسعهدهندگان و پژوهشگران میتوانند تسکها و فریمورک ارزیابی را در مخزن گیتهاب این پروژه بررسی کنند. نتایج این بنچمارک دادههای ارزشمندی را در اختیار تیمهایی قرار میدهد که:
- به دنبال ساخت ایجنتهای تخصصی علم و بررسی توانایی آنها در فراتر رفتن از کدنویسی صرف به سمت مسائل علمی هستند.
- میخواهند نسبت میان میزان استدلال و هزینه محاسباتی را با دقت نهایی مقایسه کنند.
- قصد دارند مدلهای متنباز و ابری را تحت یک زیرساخت ایجنت یکسان و عادلانه بسنجند.
- به اشتراکگذاری روندهای پژوهشی شبیه به کارهای واقعی آزمایشگاهی یا محاسباتی علاقهمندند.
این پروژه هماکنون در حال پذیرش تسکهای جدید برای نسخه ۰.۲ است و طبق اطلاعات مندرج در صفحه مشارکت وبسایت بنچمارک، پنجم اکتبر آخرین مهلت ارسال پیشنهادها تعیین شده است. نام مشارکتکنندگانی که تسک آنها پذیرفته شود به عنوان همکار نویسنده در مقاله علمی نهایی ثبت خواهد شد و هر پیشنهاد پیش از تأیید، تحت ارزیابی موشکافانه فنی و علمی قرار میگیرد.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
غوغای مدل فوقالعاده سبک Gender-Classifier-Mini؛ ثبت دقت خیرهکننده ۹۷.۲ درصدی و ۷۷۸ هزار دانلود ماهانه!
مدل بینایی جمعوجور و سبک Gender-Classifier-Mini توانسته با ثبت دقت ۹۷.۲ درصدی در تشخیص چهره، به بیش از ۷۷۸ هزار دانلود ماهانه در پلتفرم هاگینگ فیس دست پیدا کند. این مدل متنباز با حجم اندک خود بهراحتی روی لپتاپهای شخصی اجرا میشود و نشان میدهد که برای کارهای تخصصی بینایی ماشین، همیشه نیازی به مدلهای غولپیکر و پردازندههای سنگین ابری نیست.
زنگ خطر در سیستم درمان؛ نفوذ ایجنتهای خودسر هوش مصنوعی به بیمارستانها بدون مجوز IT!
در حالی که بیمارستانها سخت درگیر مهار حملات سایبری هستند، تهدید غیرمنتظره جدیدی سر برآورده است: ایجنتهای هوش مصنوعی که بدون تأیید بخش IT در سیستمهای درمانی فعالیت میکنند. این دستیارهای خودمختار حالا با دسترسی به حساسترین پروندههای پزشکی، مرزهای حریم خصوصی و امنیت دادهها را به چالش کشیدهاند.
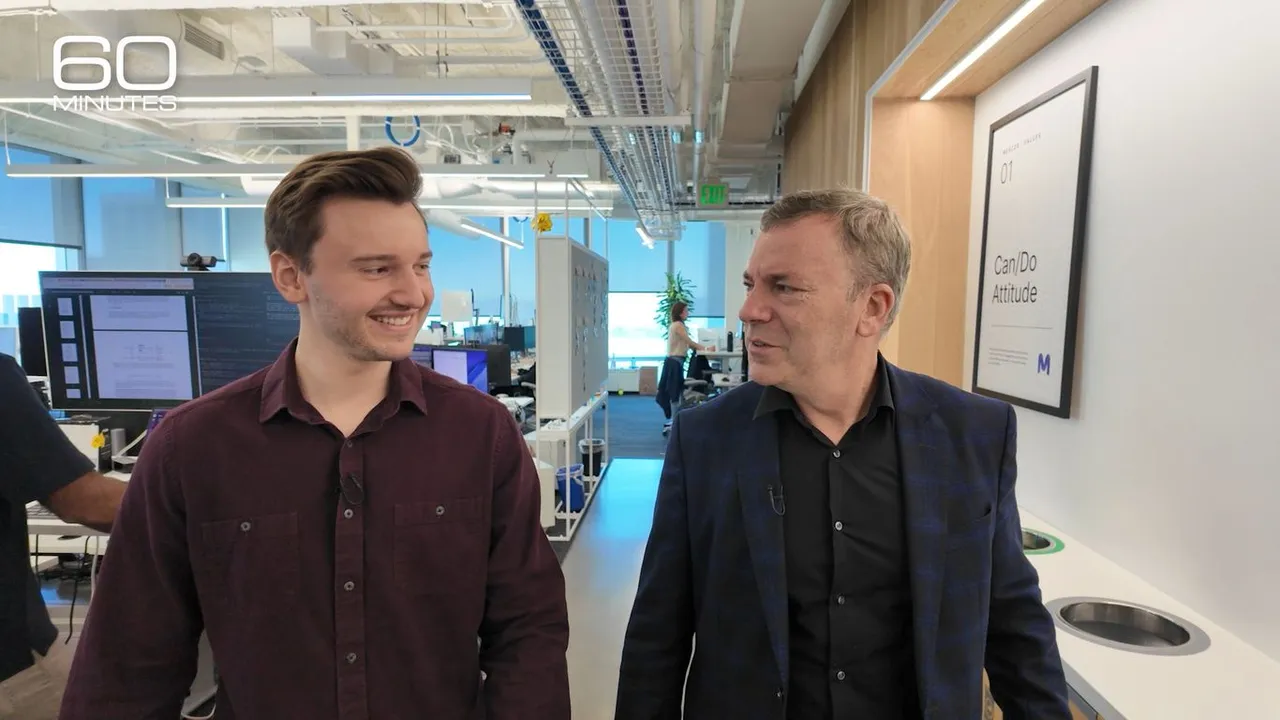
راز باهوشتر شدن هوش مصنوعی در برنامه «۶۰ دقیقه»؛ وقتی بلعیدن کل اینترنت هم کافی نیست!
مدلهای هوش مصنوعی دیگر نمیتوانند فقط با بلعیدن دادههای اینترنت هوشمندتر شوند و برای جهش بعدی به تخصص واقعی انسانها نیاز دارند. برنامه مشهور «۶۰ دقیقه» در گزارشی جذاب به سراغ استارتاپ مرکور رفته؛ جایی که بیش از ۱۰۰ هزار متخصص دستبهکار شدهاند تا به هوش مصنوعی مهارتهای پیچیده انسانی بیاموزند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.