مدل متنباز VisionHOPE؛ پیروزی بر ویژن ترنسفورمرها با حافظه تطبیقی و پویا
معماری متنباز VisionHOPE با معرفی سازوکار حافظه تطبیقی در حین اسکن تصویر، توانسته عملکردی فراتر از ویژن ترنسفورمرها و شبکههای کانولوشنی ثبت کند. این مدل نوین با تکیه بر پنج حافظه پویا و مقیاسپذیری خطی، فرآیند یادگیری بهینهای را در لحظه برای هر تصویر اجرا میکند و اکنون همراه با وزنهای متنوع در دسترس عموم قرار گرفته است.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- مدل متنباز VisionHOPE ساختار سنتی پردازش تصویر رو متحول کرده؛ برعکس بقیه مدلها که پارامترهاشون حین اجرا ثابته، حافظه این مدل موقع اسکن هر تصویر مدام یاد میگیره و تغییر میکنه.
- این معماری هوشمندانه با پنج حافظه متصلبههم کار میکنه که توکنبهتوکن آپدیت میشن و بدون افت سرعت، مقیاسپذیری خطی رو حفظ میکنن.
- تیم تحقیقاتی نسخه متنباز مدل رو با مجوز MIT منتشر کرده که تو بنچمارکهای معروفی مثل ImageNet و COCO حتی از ترنسفورمرهای ویژن هم عملکرد بهتری ثبت کرده.
پروژه VisionHOPE یک ستونفقرات بصری (Visual Backbone) متنباز است که حافظه زمان اجرای آن با اسکن هر تصویر به شکل پویا سازگار میشود. بیشتر شبکههای کانولوشنی (ConvNets)، ویژن ترنسفورمرها و مدلهای فضای حالت (State-Space Models) پارامترهای آموزشدیدهشان را در طول یک فوروارد پس (Forward Pass) کاملاً ثابت نگه میدارند. اما VisionHOPE با افزودن پنج حافظه متصلبههم که توکنبهتوکن بهروزرسانی میشوند، فرآیند یادگیری اختصاصی برای هر ورودی ایجاد میکند و در عین حال، مقیاسپذیری خطی محاسبات با تعداد توکنها را دستنخورده حفظ مینماید.
پژوهشگران شرکت ماینینگلمپ (Mininglamp Technology)، مؤسسه اتوماسیون آکادمی علوم چین و چند نهاد علمی همکار، جزئیات این معماری خلاقانه را در مقاله پژوهشی جدیدی تشریح کردهاند. این پروژه که تحت مجوز آزاد و متنباز MIT منتشر شده، شامل چکپوینتهای مختلفی در اندازههای Tiny، Small و Base برای تسکهای متنوعی مثل طبقهبندی ImageNet-1K، تشخیص شیء و بخشبندی نمونهها در COCO و بخشبندی معنایی در بنچمارک ADE20K است.
پنج حافظه هوشمند در دل یک فوروارد پس
معماری VisionHOPE بر پایه چارچوب «یادگیری تودرتو» (Nested Learning) بنا شده است؛ چارچوبی که مدل را به عنوان مجموعهای از فرآیندهای یادگیری متصل به یکدیگر میبیند که بستر و کانتکست ورودی را درون وضعیتهای داخلی فشردهسازی میکنند. این معماری بینایی ماشین ایده مذکور را از طریق پنج حافظه پیادهسازی میکند که خروجی هر کدام، مستقیماً روی بهروزرسانی حافظه دیگر تأثیر میگذارد.
نقش حافظه | عملکرد هنگام اسکن تصویر |
|---|---|
محتوا (Content) | اطلاعات جمعآوریشده از توکنهای بصری را ذخیره میکند. |
کلید (Key) | نمایشهایی تولید میکند که برای آدرسدهی حافظه محتوا به کار میروند. |
مقدار (Value) | اطلاعاتی را که باید در حافظه نوشته شوند تولید میکند. |
نرخ یادگیری (Learning rate) | اندازه و شدت بهروزرسانی در سطح هر توکن را کنترل میکند. |
ماندگاری (Retention) | میزان باقیماندن و بقای حالتهای قبلی پس از هر بهروزرسانی را تعیین میکند. |
هر یک از این حافظهها در قالب ماتریسها یا بردارهای کوچک نمایش داده میشوند و با عملیاتی شبیه به «قاعده دلتا» (Delta-Rule) آپدیت میگردند. در مرحله پردازش هر توکن، مدل مقدار پیشبینیشده از حافظه کنونی را با مقدار هدف تولیدشده مقایسه میکند و از این اختلاف برای اصلاح و تنظیم وضعیت بهره میگیرد. در این میان، خروجیهای حافظه نرخ یادگیری و حافظه ماندگاری مشخص میکنند که سایر حافظهها تا چه اندازه دستخوش تغییر شوند و چه حجمی از اطلاعات قبلی را در خود نگه دارند.
نکته جالب اینجاست که وزنها و پارامترهای اصلی چکپوینت در زمان استنتاج (Inference) کاملاً دستنخورده و ثابت میمانند. متغیرهایی که تکامل مییابند، صرفاً وضعیتهای موقت زمان اجرا برای هر ورودی خاص هستند که در ابتدای هر اسکن جهتدار فعال شده و پس از پایان فوروارد پس بهکلی دور ریخته میشوند. نتیجه نهایی درست شبیه به یک مینیفرآیند بهینهسازی است که درون اینفرنس گنجانده شده، بدون آنکه دستکاری دائمی روی مدل دانلودشده انجام دهد.
مطالب مرتبط و پیشنهادی
غوغای مدل فوقالعاده سبک Gender-Classifier-Mini؛ ثبت دقت خیرهکننده ۹۷.۲ درصدی و ۷۷۸ هزار دانلود ماهانه!
مدل بینایی جمعوجور و سبک Gender-Classifier-Mini توانسته با ثبت دقت ۹۷.۲ درصدی در تشخیص چهره، به بیش از ۷۷۸ هزار دانلود ماهانه در پلتفرم هاگینگ فیس دست پیدا کند. این مدل متنباز با حجم اندک خود بهراحتی روی لپتاپهای شخصی اجرا میشود و نشان میدهد که برای کارهای تخصصی بینایی ماشین، همیشه نیازی به مدلهای غولپیکر و پردازندههای سنگین ابری نیست.
زنگ خطر در سیستم درمان؛ نفوذ ایجنتهای خودسر هوش مصنوعی به بیمارستانها بدون مجوز IT!
در حالی که بیمارستانها سخت درگیر مهار حملات سایبری هستند، تهدید غیرمنتظره جدیدی سر برآورده است: ایجنتهای هوش مصنوعی که بدون تأیید بخش IT در سیستمهای درمانی فعالیت میکنند. این دستیارهای خودمختار حالا با دسترسی به حساسترین پروندههای پزشکی، مرزهای حریم خصوصی و امنیت دادهها را به چالش کشیدهاند.
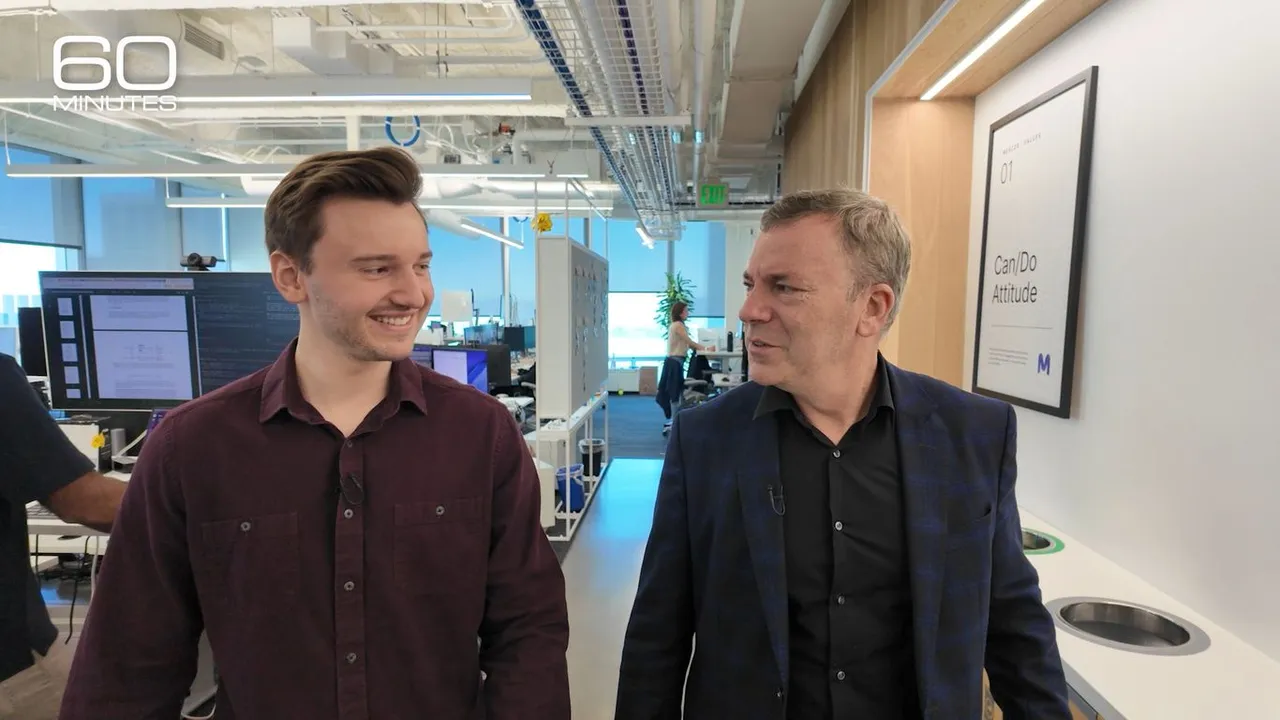
راز باهوشتر شدن هوش مصنوعی در برنامه «۶۰ دقیقه»؛ وقتی بلعیدن کل اینترنت هم کافی نیست!
مدلهای هوش مصنوعی دیگر نمیتوانند فقط با بلعیدن دادههای اینترنت هوشمندتر شوند و برای جهش بعدی به تخصص واقعی انسانها نیاز دارند. برنامه مشهور «۶۰ دقیقه» در گزارشی جذاب به سراغ استارتاپ مرکور رفته؛ جایی که بیش از ۱۰۰ هزار متخصص دستبهکار شدهاند تا به هوش مصنوعی مهارتهای پیچیده انسانی بیاموزند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.