رسیدن کارایی vLLM به موتور اختصاصی DeepSeek؛ جهش ۸ برابری سرعت در سرورهای ۷۲ پردازندهای
موتور متنباز vLLM با ثبت عملکردی نزدیک به موتور اختصاصی DeepInfer، امکان اجرای مدل DeepSeek-V4.1-Flash را با بازدهی بالا فراهم کرد. این فریمورک توانسته است در رکهای مجهز به ۷۲ پردازنده گرافیکی NVIDIA، سرعت پردازش را تا ۷٫۹ برابر افزایش دهد و نیاز تیمهای فنی به موتورهای اجرایی جداگانه را برطرف کند.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- موتور vLLM در پردازش مدل DeepSeek-V4.1-Flash به فاصلهای کمتر از ۶ درصد نسبت به موتور اختصاصی DeepInfer رسید و کارایی مشابهی به ثبت رساند.
- با گسترش مقیاس پردازش روی سامane رکاسکیل NVIDIA GB300 مجهز به ۷۲ پردازنده گرافیکی، نرخ تولید توکن نسبت به یک سرور تکی تا ۷٫۹ برابر افزایش مییابد.
- با تفکیک فازهای پیشپردازش و تولید توکن در کنار بهینهسازی ارتباطات، تیمهای توسعه میتوانند مدلهای بزرگ را بدون نیاز به رانتایم اختصاصی مستقر کنند.
بر اساس بنچمارک منتشرشده برای مدل DeepSeek-V4.1-Flash، سرعت رمزگشایی در موتور vLLM در اندازههای دسته از ۸ تا ۲۵۶، به فاصله کمتر از ۶ درصدی موتور DeepInfer رسیده است. همچنین عملکرد این فریمورک در مرحله پیشپردازش ورودی کاملاً منطبق بر منحنی بازدهی DeepInfer حرکت میکند.
دستیابی یک موتور چندمنظوره به چنین سطحی از کارایی، مسیر روشنی پیش روی تیمهای فنی قرار میدهد تا بتوانند بدون نیاز به نگهداری یک محیط اجرایی جداگانه، این مدل را در محیط عملیاتی مستقر کنند. موتور DeepInfer که توسط تیم DeepSeek بر پایه vLLM توسعه یافته است، این مدل را برای سناریوهای آفلاین هدف قرار میدهد؛ در حالی که نسخه اصلی vLLM قابلیتهایی نظیر زمانبندی آنلاین، پشتیبانی از چند مدل، تفکیک فازهای پیشپردازش و تولید توکن، و موازیسازی خبرهها در مقیاس رک را به آن اضافه کرده است.
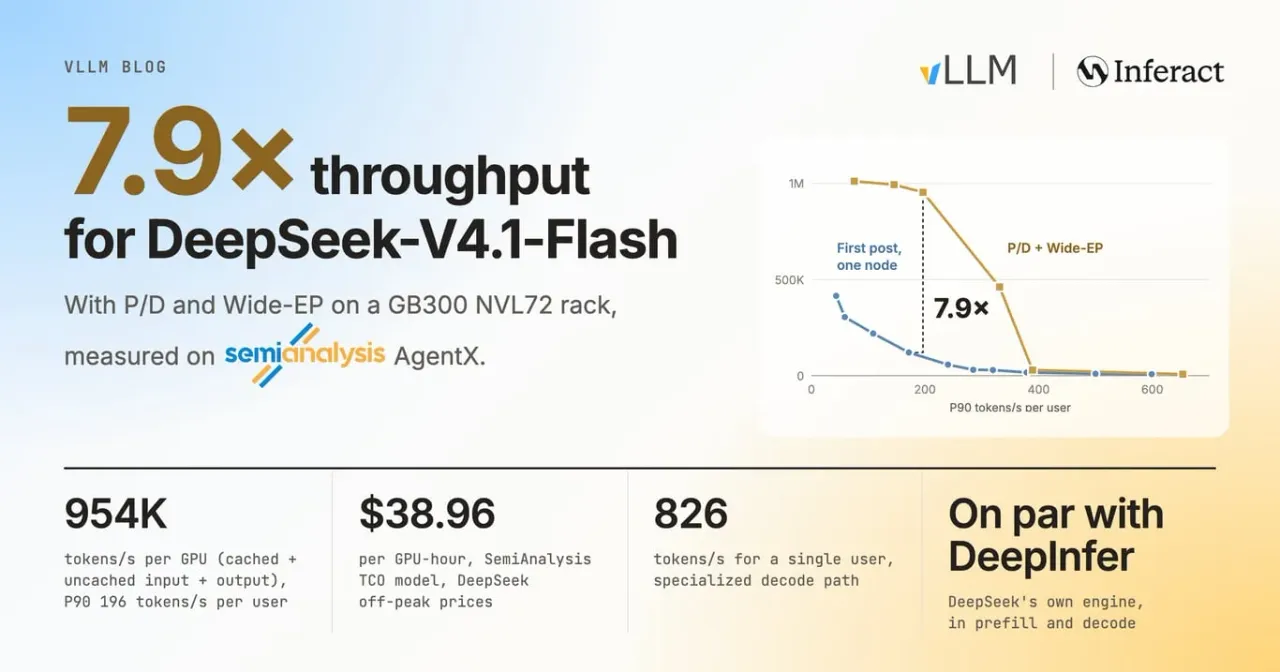
عملکرد تقریباً برابر در یک سرور و جهش ۷٫۹ برابری در مقیاس رک
نتایج منتشرشده، مقایسههای سطح موتور را از ارزیابیهای مربوط به استقرار آنلاین روی سامانه NVIDIA GB300 NVL72 تفکیک کردهاند؛ سامانهای در مقیاس رک که ۷۲ پردازنده گرافیکی را از طریق فناوری NVLink به یکدیگر متصل میکند.
آزمون | نتیجه | معیار سنجش |
|---|---|---|
مقایسه مرحله رمزگشایی | فاصله کمتر از ۶ درصد با DeepInfer | اندازههای دسته از ۸ تا ۲۵۶ |
مقایسه مرحله پیشپردازش | منطبق بر منحنی DeepInfer | توان پردازش پرامپتهای ورودی |
بنچمارک AgentX در مقیاس رک | ۹۵۴ هزار توکن در ثانیه به ازای هر GPU | ارائه آنلاین همراه با تفکیک فازها و معماری Wide-EP |
نرخ پاسخدهی به ازای هر کاربر | ۱۹۶ توکن در ثانیه برای ۹۰ درصد کاربران | توان پردازشی گزارششده در سطح کاربر در بنچمارک AgentX |
مسیر تککاربره | ۸۲۶ توکن در ثانیه | پیکربندی بهینهشده برای کمترین تأخیر ممکن |
مقیاسپذیری | ۷٫۹ برابر خروجی تکسرور | افزایش توان پردازشی ناشی از گسترش بار روی کل رک |
معادل ارزش API | ۳۸٫۹۶ دلار به ازای هر ساعت مصرف GPU | محاسبه ارزش توان پردازشی بر اساس نرخهای ساعات خلوت API در DeepSeek |
بنچمارک SemiAnalysis AgentX الگوی ترافیک عوامل هوشمند را با زمینههای متنی طولانی و رو به رشد شبیهسازی میکند. این بار پردازشی علاوه بر سنجش سرعت خام کرنلها، مواردی چون زمانبندی درخواستها، جابهجایی کش کلید-مقدار، مسیریابی خبرهها و رمزگشایی همزمان را به چالش میکشد.
موتور DeepInfer در ابتدا بر پایه vLLM شکل گرفت و از سوی دیگر، vLLM نیز ادغام روتینهای سطح پایین پردازنده گرافیکی DeepSeek از جمله MegaAttn ،MegaMoE و Mega-mHC را دنبال کرد. در نتیجه، هر دو موتور بسیاری از عملیاتهای بهینهسازیشده توجه و ساختار ترکیبی از خبرهها (MoE) را بهشکل یکسان اجرا میکنند.
لایه سرویسدهی vLLM این کرنلها را در دو استخر مجزا برای پیشپردازش و رمزگشایی به کار میگیرد. فاز پیشپردازش به تحلیل پرامپت ورودی و ساخت کش کلید-مقدار میپردازد و فاز رمزگشایی، توکنهای بعدی را با استفاده از همان کش تولید میکند. اختصاص هر فاز به استخر پردازشی مستقل، امکان بهینهسازی جداگانه محاسبات، حافظه، دستهبندی دادهها و کاهش تأخیر را فراهم میسازد.
موازیسازی گسترده خبرهها (Wide-EP) تخصصها و خبرههای مدل MoE را در میان تعداد زیادی پردازنده گرافیکی توزیع میکند. از آنجا که هر توکن تنها زیرمجموعهای از این خبرهها را فعال میسازد، توزیع گستردهتر سبب میشود تا در هر گام از مرحله تولید توکن، حجم کمتری از وزنهای مدل توسط هر واحد پردازشی خوانده شود.
محاسبات حافظه؛ تعیینکننده الگوی موازیسازی
مدل DeepSeek-V4.1-Flash به دلیل ترکیب اشتراکگذاری لایهای کش کلید-مقدار با فشردهسازی FP4، به ازای هر توکن تنها به ۸۹۰ بایت در کش سراسری نیاز دارد. این ردپای بسیار کوچک حافظه، فضای فراوانی را برای مدیریت زمینههای متنی طولانی و پردازش دستهای درخواستها آزاد نگه میدارد.
بخش عمده زمان رمزگشایی به فراخوانی و خواندن وزنهای شبکه خبرهها اختصاص دارد، در حالی که لایه توجه سهم بهمراتب کمتری در این فرآیند ایفا میکند. افزایش حجم متن ورودی نیز تأثیر اندکی بر زمان هر گام پردازشی دارد؛ بهطوری که گسترش زمینه متنی از ۱۲۸ هزار به ۸۵۵ هزار توکن (افزایش ۶٫۷ برابری)، تنها ۰٫۶ میلیثانیه یا ۷ درصد به تأخیر رمزگشایی مدل افزوده است.
تصمیم مهندسی | شواهد و دادهها | نتیجه و اثر عملی |
|---|---|---|
استفاده از DEP2 برای فاز پیشپردازش | پیکربندی DEP4 به ۵۳٫۳ هزار توکن رسید که معادل ۸۳ درصد بازدهی ۶۴٫۴ هزار توکنی در DEP2 بود | کاهش واحدهای پردازشی، عدم تعادل بار را کم میکند و همزمان ظرفیت حافظه کش را در حد کافی نگه میدارد |
گسترش فاز رمزگشایی به DEP32 | زمان اجرای MoE از ۱۳٫۴ میلیثانیه در DEP4 به ۶٫۰ میلیثانیه در DEP32 کاهش یافت | افزایش تعداد پردازندهها حجم خواندن وزنهای خبره را در هر واحد پردازشی به حداقل میرساند |
سادهسازی آزمونهای فاز رمزگشایی | تغییر زمان گامها در بازه ۱۲۸ هزار تا ۸۵۵ هزار توکن بسیار ناچیز بود | امکان حذف اجرای مجدد ردگیریهای کامل در تمام پیکربندیهای بنچمارک فراهم شد |
رویکرد معماری DEP ترکیب همزمان موازیسازی دادهها در لایه توجه با موازیسازی خبرهها را فراهم میکند و عدد قرارگرفته در کنار آن، تعداد پردازندههای گرافیکی فعال را مشخص میسازد. به این ترتیب، پیکربندی DEP2 در فاز پیشپردازش روی دو GPU اجرا میشود و نسخه DEP32 در فاز رمزگشایی، ۳۲ پردازنده گرافیکی را به خدمت میگیرد.
سه بهینهسازی همافزا در فاز پیشپردازش
در فرآیند پردازش ۳۲ هزار توکن تازه، اعمال سه تغییر فنی با کاهش پردازشهای تکراری ایندکسگذار و حذف بار اضافی ترجمه آدرسهای حافظه، توان پردازش ورودی را بهشکل چشمگیری ارتقا داد:
- گسترش بازپخش محدود تا لایه ۲۰: ایندکسگذار محاسبات مربوط به تمامی توکنها به جز ۱۲۸ توکن نهایی را نادیده میگیرد که این اقدام توان پردازشی را ۱۹٫۹ درصد بهبود میبخشد.
- نگاشت جداول اشتراکی میزبان با صفحات حافظه ۲ مگابایتی در پردازنده گرافیکی: استفاده از صفحات بزرگتر خطاهای کش ترجمه آدرس مجازی را کاهش داده و ۲٫۸ درصد به کارایی میافزاید.
- بهکارگیری الگوریتم DeepSelect top-k در ایندکسگذار پیشپردازش: انتخاب سریعتر توکنهای نامزد، بازدهی سیستم را ۱۵٫۶ درصد دیگر افزایش میدهد.
مجموع این بهینهسازیها، سرعت پیشپردازش توکنهای جدید را در سناریوهایی که ۴ هزار تا ۶۴ هزار توکن به یک پیشوند متنی ۱۲۸ هزار توکنیِ کششده اضافه میشود، بین ۳۵٫۶ تا ۴۳٫۹ درصد افزایش میدهد. بهعنوان مثال، توان پردازشی در یک پیشپردازش ۶۴ هزار توکنی از ۷۱٫۲ هزار به ۱۰۲٫۵ هزار توکن در ثانیه به ازای هر پردازنده گرافیکی جهش مییابد.
تعادل بار خبرهها و آشکار شدن گلوگاه پردازنده مرکزی
سیستم متعادلکننده بار خبرهها در vLLM موسوم به EPLB، چینش خبرهها را بر اساس تقاضای لحظهای بهطور دورهای بازآرایی میکند. در مقیاسی که عدد ۱ نشاندهنده توزیع کاملاً یکنواخت بار میان تمام واحدها است، ابزار EPLB شاخص تعادل را برای مدل هدف از ۰٫۳۵ به ۰٫۹۴ و برای مدل پیشنویس از ۰٫۲۱ به ۰٫۸۹ رسانده است.
در روش رمزگشایی حدسی، یک مدل پیشنویس کوچکتر توکنهای احتمالی را پیشنهاد میدهد و مدل اصلی صحت آنها را تأیید میکند. توزیع بهتر خبرهها حدود ۹۷ درصد از فاصله مدل هدف و ۹۳ درصد از فاصله مدل پیشنویس تا نقطه تعادل کامل را جبران مینماید. علاوه بر این، یک بکاند ارتباطی جدید بر بستر NVLink میتواند تعادل بار را در یک پیکربندی DEP32 ظرف کمتر از یک ثانیه و بدون کوچکترین توقف در تولید توکن بازتنظیم کند.
با کوتاهتر شدن زمان گامهای پردازشی روی کارت گرافیک، زمانبندی و هماهنگسازی در سمت پردازنده مرکزی به مانع بعدی تبدیل شد. در یک پیکربندی تنظیمنشده DEP32، اجرای هر گام ۱۷٫۵۷ میلیثانیه زمان میبرد، در حالی که این زمان در پیکربندی DEP16 برابر با ۱۳٫۸۴ میلیثانیه بود؛ آن هم با وجود اینکه پردازش در سطح GPU در پیکربندی DEP32 حدود ۱٫۱ میلیثانیه سریعتر انجام میشد. در واقع، بار کاری پردازنده مرکزی دستاوردهای سختافزاری را خنثی میکرد.
- انتقال کش کلید-مقدار: بهرهگیری از یک رابط ارتباطی اختصاصی NIXL، نرخ انتقال دادهها را از ۱۴۱ هزار به ۴۴۰ هزار توکن در ثانیه به ازای هر GPU ارتقا داد.
- هماهنگسازی پردازندهها: الگوریتم بازگشتی همگامسازی در پردازنده مرکزی جایگزین کتابخانه Gloo شد.
- مدیریت پذیرش در کش: در هر گام محاسباتی، حداکثر چهار بارگذاری جدید در کش کلید-مقدار پذیرفته میشود تا از جهش ناگهانی بار کاری میزبان جلوگیری شود.
- مدیریت پذیرش درخواستها: زمان پردازش برای یک پرامپت با طول ۸۵۵ هزار توکن از ۳۸٫۸ میلیثانیه به ۶٫۰ میلیثانیه کاهش پیدا کرد.
چشمانداز استقرار عملیاتی و محدودیتهای آن
تیمهای ارائهدهنده سرویس بر پایه مدل DeepSeek-V4.1-Flash اکنون میتوانند از نسخه رسمی پروژه vLLM برای استقرار آنلاین در مقیاس رک بهره ببرند و همزمان کارایی بسیار نزدیکی به موتور آفلاین DeepInfer تجربه کنند. همین نسخه استاندارد تمامی قابلیتهای مورد نیاز شامل زمانبندی، تفکیک فازهای پردازشی، پشتیبانی از چندین مدل و معماری Wide-EP را در سرتاسر یک رک NVL72 تأمین میکند.
این راهکارها بیشترین بازدهی را برای مدلهای بزرگ با معماری MoE بههمراه دارند؛ مدلهایی که زمان رمزگشایی در آنها وابسته به خواندن وزنهای خبرهها است. دستیابی به این ارقام در عمل به عواملی چون معماری مدل، میزان عدم تقارن در مسیریابی، الگوی توزیع پرامپتها، میزان همروندی، پهنای باند شبکه ارتباطی و توان پردازنده مرکزی بستگی خواهد داشت؛ بنابراین ارزیابی در محیط تولید باید شرایط بار کاری واقعی و اهداف تعیینشده برای تأخیر پاسخدهی را بهدقت بازتولید کند.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
بسته تکفایلی FLUX.1-dev برای ComfyUI از مرز یک میلیون دانلود گذشت
بسته تکفایلی مدل تصویری FLUX.1-dev که توسط تیم Comfy-Org توسعه یافته، در پلتفرم Hugging Face به بیش از یک میلیون دانلود رسید. این بسته با ادغام اجزای مختلف مدل در قالب یک فایل واحد، راهاندازی و اجرای این تصویرساز قدرتمند را در ComfyUI بسیار آسانتر کرده است.
پروژه متنباز Co-op Anything؛ تبدیل بازیهای تکنفره به چندنفره با ایجنتهای هوش مصنوعی
پروژه متنباز Co-op Anything با ترکیب دستورالعملهای مهندسی معکوس و پروتکل MCP، به ایجنتهای هوش مصنوعی آموزش میدهد تا قابلیت بازی چندنفره را به بازیهای تکنفره اضافه کنند. این ابزار به توسعهدهندگان کمک میکند مادهای ناتمام جامعه گیمینگ را احیا کرده یا حالت همکاری دونفره را از پایه توسعه دهند.
هوش مصنوعی مکانی چگونه نقاط آسیبپذیر شهرها را پیش از وقوع طوفان و سیل شناسایی میکند؟
هوش مصنوعی مکانی با بررسی مستمر سازههای فیزیکی و مسیرهای شهری، نقاط در معرض خطر سیل و فرسودگی را پیش از رسیدن طوفانهای سهمگین شناسایی میکند. این فناوری با جایگزینی نظارت پیشگیرانه بهجای تعمیرات پرهزینه پس از فاجعه، به مدیران شهری کمک میکند تا امکانات امدادی را هدفمند توزیع کنند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.