مدیران ارشد دنیای فناوری: هوش مصنوعی صوتی هنوز به «لحظه شگفتانگیز ChatGPT» نرسیده است!
با وجود سرمایهگذاریهای میلیاردی روی هوش مصنوعی صوتی و معرفی مدلهای مکالمه دوطرفه، مدیران ارشد شرکتهای PolyAI و Otter معتقدند این فناوری هنوز به نقطه عطف و «لحظه ChatGPT» خود نرسیده است. به باور آنها، کندی استدلال در لحظه، خطاهای بازشناسی گفتار و نبود حس انسانی واقعی همچنان موانع اصلی اعتماد کاربران به دستیارهای صوتی به شمار میروند.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- با وجود سرازیر شدن میلیاردها دلار سرمایه به استارتاپهای هوش مصنوعی صوتی، مدیران برجسته این حوزه معتقدند مکالمات صوتی هوش مصنوعی در دنیای واقعی هنوز تا صحبت طبیعی مثل یک انسان فاصله زیادی دارد.
- شان ون (CTO شرکت PolyAI) میگوید تولید مدلهای دوطرفه همزمان گام بزرگی بوده، اما چالش اصلی بعدی سرعت استدلال است تا مدلها بتوانند در کسری از ثانیه پاسخ دهند و گفتوگو طبیعی حس شود.
- الکس گی (مدیر ارشد بازاریابی Otter) معتقد است اشتباهات سیستمهای تشخیص گفتار (ASR) باعث خطای زنجیرهای ایجنتها میشود و تا احساسات انسانی بازآفرینی نشود، این ابزارها چیزی فراتر از یک چتبات ساده نخواهند بود.
این ایده که «صدا» رابط کاربری بزرگ بعدی در دنیای فناوری خواهد بود، این روزها حسابی سر زبانها افتاده است؛ تا جایی که سرمایهگذاران میلیاردها دلار سرمایه را به پای استارتاپهای هوش مصنوعی صوتی ریختهاند. این استارتاپها روی حوزههای گوناگونی فعالیت میکنند؛ از سازندگان مدلهای پایه صوتی گرفته تا ارائهدهندگان خدمات پشتیبانی مشتریان سازمانی، و از ابزارهای یادداشتبرداری هوشمند جلسات تا سرویسهای تایپ صوتی مبتنی بر هوش مصنوعی.
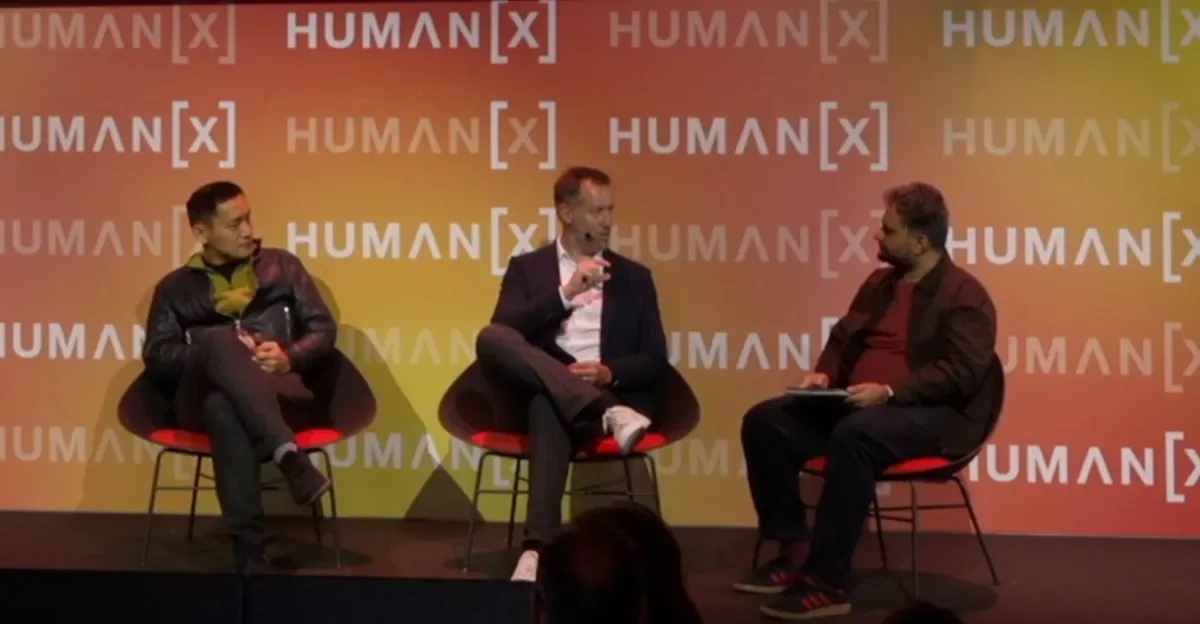
هر هفته شاهد معرفی ابزار یا مدل جدیدی هستیم که ادعا میکند صدایش مو نمیزند با انسان و درست شبیه یک آدم واقعی گفتوگو میکند؛ اما واقعیت ماجرا ممکن است کاملاً متفاوت باشد. شان ون (Shawn Wen)، مدیر ارشد فناوری پلتفرم صوتی سازمانی PolyAI، معتقد است علیرغم عرضه مدلهای تمامدوطرفه همزمان (Full-Duplex) — یعنی مدلهایی که میتوانند حین گوش دادن به شما همزمان صحبت کنند — هوش مصنوعی صوتی هنوز به «لحظه ChatGPT» خودش نرسیده است.
او در جریان گفتوگو روی صحنه در کنفرانس HumanX توضیح داد: «ما به نقطه عطف توسعه مدلهای تمامدوطرفه دست پیدا کردهایم. حالا چالش بزرگ بعدی، بسیار سریعتر کردن فرآیند استدلال است؛ به طوری که مدلها بتوانند پاسخها را در کسری از ثانیه پیدا کنند و مکالمه کاملاً روان و طبیعی به نظر برسد.»
ون همچنین تأکید کرد که ایجنتهای هوش مصنوعی در بخش خدمات مشتریان نباید لحنی خشک و رباتگونه داشته باشند، بلکه باید حس اطمینان و اعتمادی در مخاطب ایجاد کنند که مطمئن شود این سیستم واقعاً توانایی حل مشکلش را دارد.
او در ادامه افزود: «فکر میکنم مرحله بعدی کمی متفاوت خواهد بود؛ زیرا به محض اینکه کیفیت صدا به حد کافی خوب شود و مشتری در دو سه نوبت اول تمایل به صحبت و تعامل پیدا کند، اعتماد او جلب میشود. با گذشت زمان، کاربر احساس خواهد کرد که اگر ایجنت هوش مصنوعی کارش را راه میاندازد، دیگر نیازی به صحبت با یک اپراتور انسانی نخواهد داشت.»
الکس گی (Alex Gay)، مدیر ارشد بازاریابی ابزار یادداشتبرداری جلسات Otter، دیدگاه خود را اینطور مطرح کرد که تشخیص گوینده، درک قصد و نیت کاربر و پیوند دادن آن با دانش سازمانی، گامی حیاتی برای خودکارسازی فرآیندها به شمار میرود. شرکت Otter همچنین در حال توسعه «دوقلوهای دیجیتال» (Digital Twins) است تا شاید در آینده بتوانند به عنوان نماینده افراد در جلسات شرکت کنند. او معتقد است برای چنین فناوری حساسی، فوقالعاده حیاتی است که صدای خروجی دقیقاً همان بار احساسی و لحن زندهای را منتقل کند که در گفتوگوی واقعی میان انسانها در یک جلسه شکل میگیرد.
گی در اینباره خاطرنشان کرد: «اگر به جلساتی که همین الان در آنها شرکت میکنید فکر کنید، بهترین گفتوگوها آنهایی هستند که در آن بحث و تبادل نظر شکل میگیرد، تصمیمگیریهای استراتژیک انجام میشود و حس میکنید یک ارتباط انسانی عمیق پشت صحبتها وجود دارد. اگر نتوانید چنین تجربهای را با یک آواتار داشته باشید، این ابزار صرفاً در حد یک چتبات پرسش و پاسخ معمولی باقی میماند.»
چالشهای درک زبان و شفافیت در هوش مصنوعی صوتی
با اینکه مدلهای هوش مصنوعی صوتی پیشرفت چشمگیری داشتهاند، دستیارهای هوشمند هنوز هم در بسیاری از مواقع منظور کاربر را متوجه نمیشوند، یا ابزار یادداشتبرداری جلسه متن پیادهشده و خلاصهای کاملاً اشتباه تحویل میدهد.
به عقیده شان ون، مدلهای تشخیص خودکار گفتار (ASR) معمولاً کلمات کلیدی مهم را از دست میدهند و همین موضوع باعث میشود درک کل بستر و سیاق گفتوگو با اختلال مواجه شود.
الکس گی از شرکت Otter نیز این نکته را تأیید کرده و یادآور شد که این شرکت بهطور مداوم روی ارتقای کیفیت رونویسی صوتی کار میکند. او همچنین زبان را یکی از حوزههایی دانست که مدلهای صوتی هنوز به پیشرفت چشمگیری در آن نیاز دارند.
او گفت: «برای Otter، رونویسی متن هیچوقت مقصد نهایی نبوده است؛ بلکه صرفاً لایه اولیهای بود که میتوانستیم به کمک آن بهرهوری را افزایش دهیم. اما اگر متن رونویسی اولیه دقت لازم را نداشته باشد، تمام اقدامات بعدی شما دچار ایراد و خطا میشود. از لحظهای که سیستم دست به اقدام اشتباه بزند، کاربر اعتمادش را به کل پلتفرم از دست میدهد؛ بنابراین بهبود مداوم مدلهای ASR برای ما حیاتی است، چرا که تبعات و تأثیرات اشتباهات آن روی تمامی مراحل بعدی زنجیره بسیار سنگین خواهد بود.»
در کنار مسائل فنی، ابزارهای صوتی جدید با چالش مهم «شفافیت» هم روبهرو هستند. این ابزارها باید به مشتریان اعلام کنند که صدایشان در حال ضبط است یا دارند با یک هوش مصنوعی صحبت میکنند. مسئولان Otter میگویند قصد دارند حس اعتماد را در افراد حاضر در جلسه تقویت کنند؛ بنابراین حتی در جلساتی که بات مستقیماً حضور ندارد، میخواهند راهکارهایی مثل ارسال پیام هشدار در چت برای اعلام ضبط شدن جلسه را پیادهسازی کنند. شان ون از PolyAI نیز تأکید کرد که در تماسهای سازمانی، بسیار مهم است که مخاطبان بدانند در حال صحبت با یک سیستم هوش مصنوعی هستند.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
اجرای هوش مصنوعی ویدیویی Wan 2.1 علیبابا روی کارتهای ۶ گیگابایتی با لانچر متنباز WanGP
استارتاپها و کاربران خانگی همیشه با مشکل حافظه کم کارت گرافیک برای اجرای مدلهای ویدیویی سنگین دستوپنجه نرم میکنند. حالا ابزار متنباز WanGP با بهینهسازی هوشمند و جابهجایی بار پردازشی میان VRAM و رم سیستم، امکان اجرای مدل ویدیویی پرطرفدار Wan 2.1 علیبابا را حتی روی کارتهای گرافیک ۶ و ۸ گیگابایتی فراهم کرده است.
شگفتی مدل ۳۰ مگابایتی Antalia-2 Mini: شکست غولهای چند میلیاردی در تبدیل متن به گفتار ترکی!
تیم هوش مصنوعی PatientDesk با معرفی مدل Antalia-2 Mini نشان داد که برای دستیابی به خروجی صوتی باکیفیت همیشه نیازی به مدلهای سنگین نیست؛ این مدل متنباز ترکی با حجم باورنکردنی ۳۰ مگابایت حتی روی پردازندههای معمولی (CPU) اجرا میشود. نتایج بررسیها نشان میدهد که این مدل فوقالعاده سبک با کنار زدن مدلهای چند میلیارد پارامتری، دقت شگفتانگیزی را در تبدیل متن به گفتار به نمایش گذاشته است.
به پاسخهای هوش مصنوعی گوگل اعتمادی نیست؟ با این ۶ ترفند کاربردی مهارش کنید!
بخش خلاصه هوش مصنوعی گوگل (AI Overviews) چه بخواهیم و چه نخواهیم آمده است که بماند. اما بهجای کنار گذاشتن آن یا کلافه شدن از خطاهایش، با یادگیری چند ترفند ساده پرامپتنویسی میتوانید این ابزار را مهار کرده و دقیقترین اطلاعات را از دل جستوجو بیرون بکشید.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.