افت فاحش عملکرد هوش مصنوعی در راستیآزمایی ۱۰ زبان آفریقایی؛ بنچمارک AfrIFact چه میگوید؟
پژوهشگران با معرفی بنچمارک جدید AfrIFact، توانایی هوش مصنوعی را در بازیابی اطلاعات و راستیآزمایی بیش از ۱۸ هزار ادعا در ۱۰ زبان آفریقایی سنجیدند؛ ارزیابی موشکافانهای که افت شدید دقت مدلهای باز در پردازش میانزبانی را آشکار کرد.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- بنچمارک جدید AfrIFact با بیش از ۱۸ هزار ادعای مستند، عملکرد مدلهای هوش مصنوعی را در ۱۰ زبان آفریقایی و انگلیسی ارزیابی میکند.
- نتایج نشان میدهد دقت مدلهای باز در راستیآزمایی زیروشات (بدون نمونه قبلی) گاهی تا حد حدس و شانس تصادفی سقوط میکند.
- این بنچمارک با تفکیک فرآیند به سه گام بازیابی، استخراج شواهد و راستیآزمایی، ریشه اصلی خطاهای هوش مصنوعی را مشخص میسازد.
راستیآزمایی آنلاین زمانی از نظر فنی به کلافی پیچیده تبدیل میشود که برای مثال ادعایی درباره شیوع یک بیماری به زبان ولوف (Wolof) مطرح شده باشد، اما معتبرترین منبع برای سنجش صحت آن، به زبان انگلیسی یا زبان آفریقایی دیگری در دسترس باشد. بنچمارک AfrIFact دقیقاً همین زنجیره چندزبانه را ارزیابی میکند؛ سنجشی که از افت فاحش دقت در بازیابی اطلاعات میانزبانی و سقوط عملکرد راستیآزمایی در حالت زیروشات (Zero-shot) تا سطح شانس و حدس تصادفی در بسیاری از مدلهای باز پرده برمیدارد.
تیم پژوهشگران شبکه Masakhane NLP با همکاری محققانی از دانشگاههای سارلند، مکگیل، واترلو و چندین مؤسسه پژوهشی دیگر، مجموعهدادهای با بیش از ۱۸ هزار ادعای نوشتهشده توسط انسان را همراه با اسناد منبع و شواهد متنی مستندسازی کردهاند. این مجموعه علاوه بر زبان انگلیسی، ۱۰ زبان بومی قاره آفریقا شامل امهری، هوسا، ایگبو، اورومو، شونا، سواحیلی، تویی، ولوف، یوروبا و زولو (isiZulu) را در بر میگیرد.
سه مأموریت مجزا در دل یک فرآیند یکپارچه
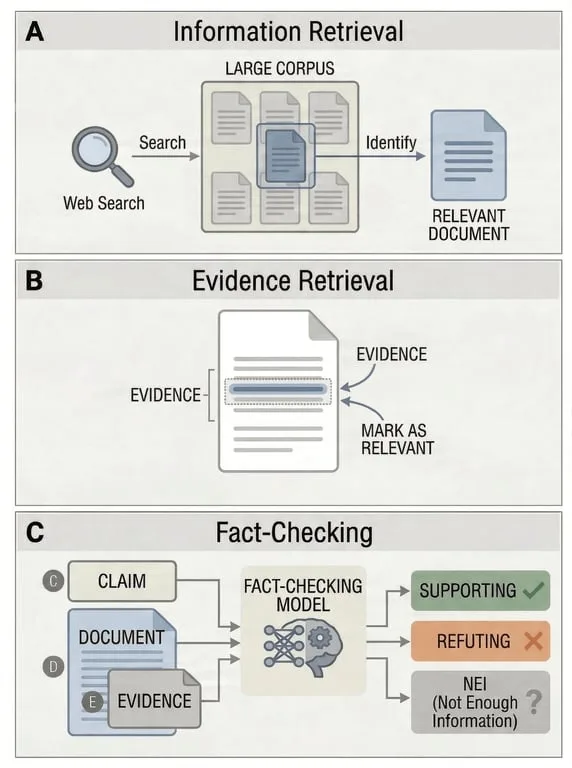
بنچمارک AfrIFact بهجای خلاصه کردن کل فرآیند در یک نمره آماری کلی، راستیآزمایی خودکار را به سه مرحله مشخص تفکیک میکند تا پژوهشگران بتوانند نقاط دقیق نقص و خطای مدلها را شناسایی کنند:
- بازیابی اطلاعات (Information Retrieval): جستوجو و یافتن اسناد منبع مرتبط با ادعا در دل یک بانک اطلاعاتی چندزبانه و عظیم.
- استخراج شواهد (Evidence Extraction): انتخاب دقیق جملاتی که ادعای مطرحشده را تأیید یا نقض میکنند.
- راستیآزمایی ادعا (Claim Verification): اختصاص یکی از سه برچسب «تأییدشده» (
SUPPORTS)، «ردشده» (REFUTES) یا «شواهد ناکافی» (NOT_ENOUGH_INFORMATION). برچسب سوم زمانی به کار میرود که دادههای موجود برای قضاوت نهایی درباره ادعا کفایت نکند.
این بنچمارک دو حوزه موضوعی مختلف را با روشهای منبعیابی تفکیکشده پوشش میدهد. بخش نخست، AfrIFact-Health، از مقالات سازمان جهانی بهداشت (WHO) که از انگلیسی ترجمه شدهاند بهره میگیرد و ادعاها و برچسبهای توضیحی آن میان نسخههای زبانی گوناگون انتقال یافتهاند. بخش دوم، AfrIFact-Culture-News، بر مقالات ویکیپدیا به زبانهای بومی پیرامون رهبران سیاسی، غذاها، سنتها و مذاهب، رویدادهای ورزشی و واحدهای پولی متمرکز است و با مقالات خبری پایگاه XL-Sum تکمیل میشود.
مطالب مرتبط و پیشنهادی
اوبر تمام ۳۰ هزار کارمند خود را به ایجنت سازمانی ChatGPT Work مجهز کرد
شرکت اوبر پس از یک دوره آزمایشی موفق، دسترسی به ایجنت هوش مصنوعی ChatGPT Work را برای تمام ۳۰ هزار کارمند خود در سراسر جهان فراهم کرد. این همکاری گسترده با اوپنایآی نشاندهنده شتاب روزافزون غولهای فناوری در خودکارسازی فرآیندهای سازمانی و ورود هوش مصنوعی به محیطهای کاری واقعی است.
رونق نامتوازن صنعت آمریکا؛ جهش سرمایهگذاری هوش مصنوعی چگونه کارخانههای سنتی را جا گذاشت؟
رونق دوباره تولید در آمریکا مسیری کاملاً نامتوازن را در پیش گرفته است؛ صنایعی که در صف نخست تأمین زیرساختهای هوش مصنوعی و انرژی قرار دارند، از هجوم سرمایهگذاریها سود میبرند، درحالیکه کارخانههای سنتی همچنان درگیر رکود و افزایش هزینهها هستند.
چگونه با هوش مصنوعی تقویم شلوغ خانواده را مدیریت کنیم؟ بررسی کاربردها و خطرات امنیتی
اتصال هوش مصنوعی به جیمیل و تقویم دیجیتال، مدیریت برنامههای ورزشی و تحصیلی فرزندان را برای خانوادههای پرمشغله بهشدت آسان میکند. با این حال، تزریق دستورات مخرب به دعوتنامهها و افزایش کلاهبرداریهای سایبری، ضرورت رعایت احتیاط و نظارت دقیق انسانی را دوچندان کرده است.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.