نبرد جدید غولهای هوش مصنوعی بر سر زیرساخت وب؛ اینترنت برای ایجنتها از نو ساخته میشود
وب سنتی برای انسانها طراحی شده بود، اما اکنون ایجنتهای هوش مصنوعی به طبقه جدیدی از کاربران اینترنت تبدیل شدهاند. شرکتهایی مانند گوگل، انویدیا، Nebius، Tavily، Firecrawl و Cloudflare در حال ساخت لایه زیرساختی جدیدی هستند که شیوه جستجو، استخراج داده و آموزش مدلها در وب را دگرگون میکند.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- ایجنتهای هوش مصنوعی برخلاف کاربران انسانی به فهرست لینکها نیاز ندارند و نیازمند زیرساختی هستند که دادههای وب را مستقیم به اطلاعات ساختاریافته و قابل پردازش تبدیل کند.
- پلتفرمهای تخصصی مانند Tavily و Firecrawl در کنار غولهایی نظیر گوگل و Cloudflare در حال شکلدهی به لایه جدیدی از اینترنت برای مدیریت جستجو، استخراج داده و کنترل دسترسی ایجنتها هستند.
- مسیرهای پژوهشی و تعاملات ایجنتها با وب اکنون بهعنوان دادههای آموزشی ارزشمند برای بهبود مدلهای جدید مورد استفاده قرار میگیرند و وب را به یک محیط یادگیری زنده تبدیل کردهاند.
لایه زیرساختی جدیدی در حال شکلگیری است تا به ایجنتهای هوش مصنوعی کمک کند در وب جستجو کنند، اطلاعات را بازیابی نمایند، محتوا را بفهمند و با صفحات اینترنتی تعامل داشته باشند. در این میان، آنچه ایجنتها در طول این مسیر یاد میگیرند، بهاندازه اطلاعاتی که به دست میآورند اهمیت پیدا کرده است.
وب از ابتدا برای انسانها ساخته شد. موتورهای جستجو به افراد کمک میکنند وبسایتها را بیابند، صفحات وب برای خوانده شدن توسط انسان طراحی شدهاند و مرورگرها به کاربران اجازه میدهند در این صفحات جابهجا شوند، فرمها را پر کنند و با سرویسهای آنلاین تعامل داشته باشند. تبلیغات، سیستمهای تحلیل داده و کنترلهای دسترسی نیز همگی بر این فرض بنا شدهاند که یک انسان در جایی از این چرخه حضور دارد.
ایجنتهای هوش مصنوعی در حال تغییر دادن این فرض بنیادین هستند. یک ایجنت نیازی به ده لینک آبی از طرف موتور جستجو ندارد؛ بلکه به اطلاعاتی نیاز دارد که بتواند مستقیماً آنها را مصرف و پردازش کند. ایجنت باید منابع مرتبط را بیابد، دادهها را از آنها استخراج کند، تشخیص دهد چه چیزی اهمیت دارد، منابع مختلف را با هم مقایسه نماید و در نهایت تصمیم بگیرد که آیا اطلاعات کافی برای تکمیل وظیفه خود در اختیار دارد یا باید به جستجو ادامه دهد.
ایجنتها در حال تبدیل شدن به طبقه جدیدی از کاربران اینترنت هستند. آنها به بسیاری از همان اطلاعاتی نیاز دارند که انسانها به دنبالش میگردند، اما میتوانند این دادهها را در مقیاسی بسیار بزرگتر بازیابی و پردازش کنند. این تغییر باعث شکلگیری دو لایه مجزا در اینترنت شده است: یک لایه که برای تعامل انسانی بهینهسازی شده و لایهای دیگر که برای تحویل مستقیم اطلاعات به ایجنتهای هوش مصنوعی طراحی شده است. نتیجه این روند، ظهور یک پشته زیرساختی جدید میان مدلهای هوش مصنوعی و شبکه اینترنت است.
برای مدیران ارشد اطلاعات (CIO) و مدیران ارشد فناوری (CTO)، این تحول شیوه ارزیابی زیرساخت ایجنتها را تغییر میدهد. انتخاب مدل و عملکرد استنتاج همچنان اهمیت دارند، اما کارایی یک ایجنت بهطور فزایندهای به کیفیت، هزینه و پایداری زیرساخت اطلاعاتی وابسته است که از چارچوب اجرایی آن پشتیبانی میکند. سازمانها همچنین باید در نظر بگیرند که ایجنتها به چه اطلاعاتی دسترسی دارند، چه سرویسهایی این اطلاعات را مدیریت میکنند و این تعاملات چگونه نظارت و کنترل میشوند.
جستجو همین حالا هم تغییر کرده است
گوگل یکی از شفافترین نشانههای این گذار را به نمایش میگذارد. موتور جستجوی گوگل با هدف کمک به انسانها برای یافتن اطلاعات ساخته شد، اما حالت هوش مصنوعی (AI Mode) آن اکنون زیرساخت جستجوی گوگل را با مدلهای Gemini ترکیب میکند و از روشی بهره میبرد که گوگل آن را «پخش پرسش» (Query Fan-out) مینامد. در این روش، هوش مصنوعی بهجای اینکه یک سؤال را بهعنوان یک جستجوی واحد در نظر بگیرد، آن را به زیرشاخههای متعدد میشکند و چندین جستجو را بهطور همزمان انجام میدهد.
قابلیت جستجوی عمیق (Deep Search) گوگل این مفهوم را فراتر میبرد و پیش از تهیه یک گزارش، صدها جستجو را انجام میدهد و روی اطلاعات بهدستآمده استدلال میکند. گوگل همچنین در حال گسترش بخش جستجو به سمت ایجنتهایی است که میتوانند بهجای بازگرداندن صرف اطلاعات، در انجام وظایف عملی کمک کنند.
این روند، مدل پایه جستجو را دگرگون میکند. یک انسان ممکن است عبارتی را وارد کند، نتایج را ببیند و یک صفحه را انتخاب نماید. اما یک ایجنت میتواند وظیفهای را تحویل بگیرد، اطلاعات مورد نیازش را تشخیص دهد، چندین جستجو ایجاد کند، نتایج را بررسی نماید، خلأهای اطلاعاتی را بشناسد و دوباره جستجو کند. به این ترتیب، جستجو از یک مقصد نهایی به بخشی از یک چرخه استدلال تبدیل میشود.
گوگل از مزیت بزرگی برخوردار است؛ زیرا یکی از بزرگترین نمایههای (ایندکسهای) جستجوی جهان را بههمراه مدلهای هوش مصنوعی که از این اطلاعات برای استدلال استفاده میکنند، در اختیار دارد. این شرکت میتواند نمایهسازی، بازیابی اطلاعات، مدل Gemini و قابلیتهای ایجنتی را در یک زیرساخت واحد به هم متصل کند. کسبوکار تبلیغاتی گوگل نیز انگیزه تجاری نیرومندی به این شرکت میدهد تا بر چگونگی تکامل جستجو نظارت داشته باشد. باز کردن گستردهتر نمایه جستجو به روی رقبا میتواند با این مدل تجاری تنش ایجاد کند؛ هرچند این انگیزهها بهتنهایی تعیینکننده اقدام بعدی گوگل نخواهند بود.
در همین حال، گروه جدیدی از شرکتها بهجای تطبیق دادن سیستمهای جستجوی سنتی و انسانمحور با نیازهای جدید، در حال ساخت زیرساختهای وب بهطور اختصاصی برای ایجنتهای هوش مصنوعی هستند.
ساخت موتور جستجو برای ایجنتها
شرکت Tavily یکی از نخستین مجموعههایی بود که موتوری را منحصراً برای جستجوی ایجنتهای هوش مصنوعی بنا نهاد. هدف Tavily بهجای طراحی یک موتور جستجو بر پایه صفحه نتایج برای انسانها، این است که اطلاعات مرتبط را از وب زنده در قالبی به ایجنتهای هوش مصنوعی تحویل دهد که بتوانند مستقیماً در پنجره زمینه (Context) و فرایند استدلال خود قرار دهند.
اهمیت این موضوع زمانی که ایجنتها وظایف طولانیتری را انجام میدهند، دوچندان میشود. یک ایجنت پژوهشی ممکن است برنامهای برای تحقیق بریزد، به دنبال اطلاعات بگردد، چندین منبع را بازیابی کند، آنها را بسنجد، متوجه کمبود اطلاعات شود، عبارت جستجوی خود را بازنویسی کند و پیش از ارائه پاسخ نهایی، این فرایند را چندین بار تکرار نماید. در این نقطه، جستجو دیگر مکانی نیست که ایجنت صرفاً به آن سر بزند؛ بلکه به زیرساخت اصلی برای ایجنتهای هوش مصنوعی تبدیل میشود.
این تحول، معنای واژه «جستجو» را نیز تغییر میدهد. انسانها معمولاً زمانی جستجو میکنند که میخواهند صفحهای را بیابند یا به سؤالی پاسخ دهند. اما یک ایجنت اغلب به چیزی گستردهتر نیاز دارد: ایجنت باید زمینه و بافتار اطلاعاتی لازم برای انجام یک وظیفه را گردآوری و سرهم کند.
این اطلاعات زمینهای ممکن است از وبسایتها، اسناد مالی، پایگاههای داده پژوهشی، مخازن نرمافزاری، کاتالوگ محصولات یا سایر منابع ساختاریافته و غیرساختاریافته به دست آید. در اینجا مسئله از «یافتن یک لینک» به «گردآوری اطلاعات درست برای کاری که در حال انجام است» تغییر مییابد.
وب برای ماشینها ساخته نشده بود
یافتن اطلاعات درست تنها بخشی از ماجراست؛ چراکه خود وبسایتها نیز برای انسانها طراحی شدهاند.
یک صفحه وب مدرن میتواند شامل منوهای ناوبری، تبلیغات، کدهای جاوااسکریپت، پاپآپها، تصاویر، ابزارکهای پیشنهادی و عناصر دیگری باشد که اطلاعات مورد نیاز ایجنت را احاطه کردهاند. حتی پس از اینکه ایجنت صفحه درست را پیدا کرد، باز هم باید آن صفحه را به اطلاعات قابل استفاده تبدیل کند.
برای پلتفرم Tavily، این کار به معنای استخراج محتوای مرتبط از صفحات وب و تبدیل آن به اطلاعات ساختاریافتهای است که ایجنتها بتوانند از آن بهره ببرند. اما Tavily در حل این چالش تنها نیست. هرچه ایجنتهای هوش مصنوعی خواستار دسترسی پیشرفتهتر به اطلاعات وب میشوند، مرزهای میان جستجو، خزش (Crawling) و استخراج داده کمرنگتر میشود.
پلتفرم Firecrawl این همگرایی را از مسیر مقابل به نمایش میگذارد. این سرویس که در ابتدا بر خزش وب و استخراج داده تمرکز داشت، فعالیت خود را به حوزه جستجو گسترش داده و به قابلیتهای Tavily نزدیکتر شده است. امروزه Firecrawl محتوای وب را جستجو، پیمایش و استخراج میکند و آن را به فرمتهای قابل مصرف برای سیستمهای هوش مصنوعی تبدیل مینماید. این دو پلتفرم از دو زاویه متفاوت به سراغ مسئله میروند. ابزار Firecrawl بهطور ویژه برای پیمایش و استخراج محتوا از آدرسهای اینترنتی (URL) شناختهشده مناسب است، در حالی که Tavily بر کشف و بازیابی اطلاعات در سراسر وب زنده و در مقیاس بالا تمرکز دارد. همچنین Firecrawl یک راهکار متنباز ارائه میدهد، اما Tavily بر جستجو و بازیابی در مقیاس سازمانی متمرکز است.
یکپارچهسازیهای Firecrawl با ابزارهای هوش مصنوعی، نشاندهنده یک تحول مهم در معماری فنی است. پلتفرم Firecrawl بهجای جایگزین کردن مدل زیربنایی هوش مصنوعی، یک لایه زیرساخت اطلاعاتی تخصصی فراهم میکند که دامنه دسترسی و توانمندیهای مدل را گسترش میدهد.
این موضوع انتخاب جدیدی را پیش روی معماران هوش مصنوعی در سازمانها قرار میدهد. انتخاب مدلهایی مانند Claude، Gemini یا هر مدل دیگری، لزوماً تعیین نمیکند که یک ایجنت چگونه به دنیای بیرون دسترسی دارد. شرکتها بهطور فزایندهای میتوانند مدلها را بر اساس کیفیت، پوشش، مقیاسپذیری و اصول حاکمیتی، با سرویسهای تخصصی بازیابی، جستجو و داده ترکیب کنند.
چه کسی مالک لایه ارتباطی ایجنت با وب است؟
ساختار بلندمدت این بازار هنوز در حال شکلگیری است.
گوگل نماینده یک رویکرد است؛ این شرکت میتواند مدل Gemini را بهصورت عمودی با زیرساخت جستجو و اطلاعات خود یکپارچه کند. سایر ارائهدهندگان مدل نیز در حال ساخت قابلیتهای جستجوی وب و بازیابی اطلاعات بهطور مستقیم در درون پلتفرمهای خود هستند.
در عین حال، شرکتهایی مانند Tavily و Firecrawl زیرساختهای تخصصی میسازند که میتوانند در کنار مدلهای گوناگون کار کنند. سایر ارائهدهندگان از جمله Exa نیز در حال توسعه سیستمهای جستجو و بازیابی بومیِ هوش مصنوعی پیرامون همین فرصت تجاری هستند.
اقدام شرکت Nebius در خرید Tavily به فرصت بزرگتری اشاره دارد: استفاده از توان پردازشی بیشتر برای پشتیبانی از پژوهشهای عمیقتر. همانطور که جستجو از بازیابی ساده به پژوهش تبدیل میشود، توان محاسباتی بیشتر به ارائهدهنده خدمات اجازه میدهد منابع بیشتری را بکاود، فرضیههای بیشتری را بیازماید، ادعاهای بیشتری را راستیآزمایی کند و زمینه اطلاعاتی غنیتری را برای هر وظیفه ترکیب نماید. البته نتایج بهتر همچنان به کیفیت بازیابی و چگونگی استفاده از آن توان پردازشی بستگی دارد. شرکتهای Nebius و Tavily در کنار هم جایگاه خود را برای پشتیبانی از جستجو و پژوهشهای پیشرفتهتر همزمان با رشد فعالیت ایجنتها تثبیت میکنند.
این روند یک پرسش راهبردی مهم را نیز به وجود میآورد: آیا زیرساخت وبِ مخصوص ایجنتها به یک لایه مستقل در پشته فناوری هوش مصنوعی تبدیل میشود یا در نهایت در پلتفرمهای مدل و ارائهدهندگان خدمات ابری ادغام خواهد شد؟
پاسخ احتمالاً شامل هر دو رویکرد خواهد بود. مدلها قابلیتهای وب پیشفرض را ارائه خواهند داد، در حالی که ارائهدهندگان تخصصی در حوزههایی مانند کیفیت اطلاعات، دادههای تخصصی، کاهش تأخیر، هزینه و نیازمندیهای سازمانی به رقابت میپردازند.
وبسایتها هنوز هم صاحب دارند
این گذار روی دیگری هم دارد. ایجنتهای هوش مصنوعی به اطلاعات نیاز دارند، اما این اطلاعات متعلق به وبسایتها، ناشران و سایر مالکان محتواست.
شرکت Cloudflare در موقعیت منحصربهفردی قرار دارد؛ زیرا زیرساخت آن میان بسیاری از وبسایتها و سیستمهای خودکاری قرار گرفته است که تلاش میکنند به آنها دسترسی پیدا کنند. ابزارهای کنترل خزش هوش مصنوعی (AI Crawl Control) در Cloudflare به صاحبان وبسایتها کنترل بیشتری میدهند تا تعیین کنند کدام خزندههای هوش مصنوعی مجاز به دسترسی به محتوای آنها هستند. سیستم پرداخت بهازای خزش (Pay Per Crawl) این شرکت نیز ایده را یک گام فراتر میبرد و به وبسایتها امکان میدهد بابت دسترسی خزندههای هوش مصنوعی از آنها هزینه دریافت کنند.
این کار مفاهیم مجوزها و اقتصاد را وارد پشته وب ایجنتها میکند. یک ایجنت همیشه نمیتواند هر چیزی را که میخواهد صرفاً به این دلیل که روی اینترنت قرار دارد، برداشت کند. ایجنت ممکن است با محدودیتهای دسترسی روبهرو شود، نیاز داشته باشد هویت خود را بهعنوان یک سیستم خودکار معرفی کند یا مجبور شود تشخیص دهد که آیا آن اطلاعات ارزش پرداخت هزینه را دارند یا خیر.
سازمانها نیز از سمت دیگر ماجرا با همین چالش روبهرو هستند. مدیران ارشد اطلاعات و فناوری باید بدانند ایجنتهایشان به چه وبسایتهایی میتوانند دسترسی داشته باشند، چه اطلاعاتی میتواند در پرسشهای جستجو گنجانده شود، کدام اشخاص ثالث این پرسشها را دریافت میکنند و اطلاعات حاصل در کجا ذخیره میشوند. اگر ایجنتی بتواند اطلاعات بخرد یا تراکنش مالی انجام دهد، سازمانها به کنترلهای دقیقی نیاز دارند تا مشخص شود چه کسی مجوز این اقدام را صادر کرده و چگونه حسابرسی میشود.
بنابراین پشته وب برای ایجنتها فراتر از کشف و بازیابی اطلاعات است و شامل استخراج، اصالتسنجی داده، هویت، مجوزها، اقتصاد و حاکمیت داده میشود.
نتیجه جستجو تنها خروجی نیست
تغییر دیگری نیز در حال رخ دادن است که اهمیت بیشتری دارد. زمانی که یک ایجنت هوش مصنوعی پژوهشی را انجام میدهد، پاسخ نهایی تنها چیزی نیست که تولید میشود. ایجنت گزارشی از چگونگی رسیدن به آن پاسخ را نیز ثبت میکند. ایجنت ممکن است کار را با یک پرسش آغاز کند، برنامهای بریزد، جستجویی انجام دهد، نتایج را بررسی کند، چندین منبع را بازیابی نماید، اطلاعات ضعیف را کنار بگذارد، جستجوی دیگری انجام دهد، شواهد را مقایسه کند و در نهایت پاسخی تولید نماید. به این توالی از اقدامات، «مسیر عملکرد» (Trajectory) گفته میشود.
این مسیرهای عملکرد بسیار ارزشمند هستند؛ زیرا نهتنها نشان میدهند هوش مصنوعی چه میداند، بلکه چگونگی رفتار آن را هنگام حل یک مسئله به تصویر میکشند. این دادهها تصمیمگیریها، استفاده از ابزارها، بازیابی اطلاعات، خطاها، اصلاحات و نتایج نهایی را ثبت میکنند.
روتم وایس (Rotem Weiss)، مدیرعامل Tavily، این تغییر را حرکت از «جستجو در مرحله استنتاج» به «جستجو در مرحله آموزش» توصیف کرده است. شرکت Tavily استدلال میکند که هوش مصنوعی بهطور فزایندهای به آنچه «محیط وب در تراز آموزش» مینامد، نیاز دارد؛ یعنی زیرساخت جستجویی که برای آموزش مدل بهینهسازی شده باشد. در این رویکرد، یک نسخه ثبتشده و ثابت از وب به ایجنتها اجازه میدهد وظایف پژوهشی را روی اطلاعاتی یکسان و بدون تغییر تکرار کنند. این کار باعث میشود مسیرهای عملکرد تکرارپذیرتر شوند و این ریسک را کاهش میدهد که تغییر مداوم نتایج جستجو، سودمندی آنها را برای ارزیابی و آموزش از بین ببرد.
این نقشی بسیار بزرگتر از بازگرداندن ساده نتایج جستجوست.
این روند همچنین یک پرسش حاکمیتی دیگر را برای سازمانها مطرح میکند. مسیرهای عملکرد ایجنت میتوانند شامل جستجوها، اطلاعات بازیابیشده، فراخوانی ابزارها، گامهای استدلالی و زمینه کاری کسبوکار باشند. اگر این مسیرها ذخیره شوند یا بعداً برای ارزیابی و آموزش مورد استفاده قرار گیرند، به دسته جدیدی از دادههای سازمانی تبدیل میشوند که نیازمند مدیریت و قوانین حاکمیتی هستند.
انویدیا پژوهشهای وب را به دادههای آموزشی تبدیل میکند
شرکت انویدیا نمونه واقعی و ملموسی از این روند را به نمایش گذاشته است.
بر اساس گزارش Tavily از فعالیتهای انویدیا، این شرکت از پلتفرم Tavily برای فراهم کردن جستجوی زنده وب هنگام تولید حدود ۸۰ هزار مسیر پژوهشی برای سیستم تحقیق عمیق خود با نام AI-Q استفاده کرده است. هر مسیر عملکرد، برنامهریزیهای ایجنت، جستجوها، اطلاعات بازیابیشده و پاسخ نهایی آن را ثبت میکرد.
به گزارش Tavily، نزدیک به ۶۷ هزار مسیر عملکرد توانستند از فیلترهای کیفی انویدیا عبور کنند و به دادههای آموزشی برای تنظیم دقیق (Fine-tuning) مدل Nemotron 3 Super تبدیل شوند. فرآیند تنظیم دقیق این مدل با استفاده از ۱۲۸ پردازنده گرافیکی H100 انویدیا حدود ۲۵ ساعت به طول انجامید.
اهمیت این ماجرا صرفاً در تعداد جستجوهای انجامشده نیست. جستجوی وب تنها برای پاسخ دادن به یک سؤال به کار نرفته بود؛ بلکه تجربه ایجنت از کار با وب، به دادههای آموزشی برای ارتقای یک مدل دیگر تبدیل شد.
این موضوع کیفیت بازیابی اطلاعات را مستقیماً به اقتصاد زیرساخت هوش مصنوعی پیوند میزند. بازیابی ضعیف اطلاعات کاری فراتر از تولید یک نتیجه جستجوی بد انجام میدهد. اگر اطلاعات ضعیف منجر به یک مسیر عملکرد ناموفق شود که در نهایت رد میشود، تمام جستجوها، توکنها و چرخههای پردازش گرافیکی (GPU) که صرف تولید آن مسیر شدهاند، دادههای آموزشی کمفایدهتری به بار آوردهاند.
بنابراین بازیابی بهتر اطلاعات تنها بر کیفیت پاسخ اثر نمیگذارد، بلکه به بخشی از بهرهوری در فرآیند آموزش مدل تبدیل میشود.
وب به یک محیط آموزشی تبدیل میشود
این دگرگونی نشاندهنده تغییری بزرگ در نحوه نگرش ما به رابطه میان هوش مصنوعی و وب است. نسل اول مدلهای زبانی بزرگ با بخش عمدهای از وب بهعنوان داده خام رفتار میکردند. محتوای وب گردآوری و پردازش میشد و در مجموعهدادههای آموزشی قرار میگرفت. مدل از آن اطلاعات یاد میگرفت و بعداً بخشی از آن دانش را در مرحله استنتاج بازتولید میکرد.
ایجنتها چرخه متفاوتی را ایجاد میکنند. یک ایجنت وظیفهای را دریافت میکند و با وب وارد تعامل میشود؛ جستجو میکند، اطلاعات را بازیابی مینماید، یافتههایش را میسنجد و تصمیم میگیرد گام بعدی چیست. سپس این تعاملات میتوانند ارزیابی شوند و مسیرهای عملکرد موفق به خوراکی برای تنظیم دقیق نظارتشده و سایر تکنیکهای پس از آموزش (Post-training) تبدیل گردند.
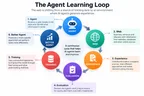
تفاوت این دو رویکرد بسیار مهم است. مجموعهداده چیزی است که مدل آن را مصرف میکند؛ اما محیط چیزی است که ایجنت با آن تعامل دارد، در دل آن تصمیم میگیرد و یاد میگیرد چگونه در آن مسیر خود را بیابد.
وب دیگر صرفاً مجموعهای از اطلاعات برای آموزش هوش مصنوعی نیست، بلکه در حال تبدیل شدن به محیطی است که هوش مصنوعی چگونگی فعالیت و کار کردن را در آن میآموزد.
چرا زیرساخت وب ایجنتها برای ابرهای هوش مصنوعی اهمیت دارد؟
این تکامل، زمینه مناسبی را برای درک بهتر اقدام شرکت Nebius در خرید Tavily که در فوریه ۲۰۲۶ اعلام شد، فراهم میکند. در آن زمان، توصیف این ترکیب نسبتاً ساده بود: شرکت Nebius زیرساخت هوش مصنوعی و پلتفرم استنتاج Token Factory خود را در اختیار داشت، در حالی که Tavily دسترسی لحظهای به وب را برای ایجنتهای هوش مصنوعی به ارمغان میآورد.
اگر با دیدی محدود نگاه کنیم، Nebius یک شرکت جستجوی ایجنتمحور را خریداری کرده است. اما دیدگاه کلانتر اکنون بسیار جذابتر است. پلتفرم Tavily در نقطه تلاقی استنتاج، بازیابی اطلاعات، پژوهش ایجنتها و فرآیند پس از آموزش قرار دارد. مثال انویدیا نشان میدهد که همان زیرساختی که برای اتصال ایجنتهای عملیاتی به وب زنده به کار میرود، در خلق تجربههایی که برای بهبود مدلها استفاده میشوند نیز مشارکت دارد.
این موضوع برای ارائهدهندگان زیرساخت هوش مصنوعی بسیار حائز اهمیت است. ارزش پیشنهادی پایه در نسل جدید شرکتهای ابری (Neocloud) تا حد زیادی بر دسترسی به پردازندههای گرافیکی و زیرساخت لازم برای اجرای آنها متمرکز بوده است. با بالغ شدن بازار، ارزش به لایههای بالاتر پشته فناوری، یعنی به سمت سرویسهای استنتاج، پلتفرمهای مدل، زیرساخت ایجنت و سیستمهای اطلاعاتی پیرامون این ایجنتها حرکت میکند.
سرمایهگذاریهای Nebius در پلتفرم Token Factory، شرکت Tavily و خرید اخیر Inferize همگی به این فرصت زیرساختی گستردهتر اشاره دارند. توان پردازشی همچنان شالوده اصلی است، اما مشتریان بهطور فزایندهای به محیطی نیاز دارند که در آن بتوانند برنامههای هوش مصنوعی را بسازند، اجرا کنند و بهبود ببخشند.
تقاضای ماشینی معادلات اقتصادی را تغییر میدهد
یک تفاوت بنیادین دیگر نیز میان مصرف وب توسط انسان و ایجنت وجود دارد: فعالیت انسان محدود به میزان توجه انسانی است؛ اما فعالیت ماشین میتواند بسیار فراتر از این محدودیت مقیاس بگیرد، هرچند همچنان محدود به توان پردازشی، هزینه و سطح دسترسی باقی میماند.
یک انسان ممکن است برای پاسخ به یک پرسش، تنها یک جستجو انجام دهد. اما یک ایجنت میتواند دهها جستجو انجام دهد، اسناد متعددی را بازیابی کند و هنگام تکمیل یک وظیفه واحد، بارها به سراغ وب برود. یک سازمان میتواند هزاران ایجنت را بهطور پیوسته اجرا کند و سیستمهای آموزشی نیز میتوانند این فرآیندها را دهها هزار یا میلیونها بار تکرار نمایند.
بنابراین، واحد تقاضا کمکم از «تعداد جستجو به ازای هر نفر» به چیزی شبیه به «تعداد بازیابی به ازای هر وظیفه، ضرب در تعداد وظایف هر ایجنت و تعداد ایجنتهای در حال فعالیت» تغییر میکند.
هزینه یک ایجنت نیز پیچیدهتر از فرمول ساده «تعداد توکن ضرب در قیمت استنتاج» میشود. اقتصاد ایجنتها بهطور فزایندهای شامل استنتاج، بازیابی اطلاعات، استخراج داده، استفاده از ابزار و استدلالهای مکرر است. فرآیند آموزش نیز تولید مسیر عملکرد، ارزیابی و توان محاسباتی مضاعف را به این معادله اضافه میکند.
این روند ترافیک وبِ ماشین به ماشین و بازار زیرساختهای پشتیبان آن را گسترش میدهد. برای مدیران ارشد اطلاعات و فناوری، دسترسی به وب، کیفیت بازیابی، حاکمیت داده و هزینه در حال تبدیل شدن به بخشی جداییناپذیر از معماری هوش مصنوعی هستند. برای ارائهدهندگان زیرساخت، این تحول لایه دیگری از خدمات را در بالای توان پردازشی و استنتاج ایجاد میکند و برای سرمایهگذاران، بازاری را رقم میزند که موتور محرک آن مصرف وب توسط ماشینهاست، نه توجه انسانها.
با این حال، مهمترین تغییر مربوط به اتفاقی است که پس از این تعاملات رخ میدهد. زمانی که تجربههای یک ایجنت به مسیرهای عملکرد آموزشی تبدیل میشوند، زیرساخت وب مستقیماً به حلقه یادگیری هوش مصنوعی متصل میگردد. وب برای انسانها ساخته شده بود؛ موتورهای جستجو به ما در یافتن اطلاعات کمک میکردند، مرورگرها امکان گشتوگذار را به ما میدادند و وبسایتها مطالب را به شکلی قابل فهم برایمان به نمایش میگذاشتند. اما ایجنتهای هوش مصنوعی به رابط کاربری متفاوتی نیاز دارند. ما اکنون در حال ساخت زیرساختی هستیم که به آنها اجازه میدهد وب را جستجو کنند، دادههایش را مصرف نمایند، در درون آن فعالیت کنند و از این تجربه بیاموزند.
وب در حال تبدیل شدن به چیزی فراتر از یک منبع داده برای هوش مصنوعی است؛ اینترنت اکنون به بخشی از محیطی تبدیل میشود که هوش مصنوعی در آن کار کردن را یاد میگیرد.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
تجربه برنامهریزی جشن تولد با ایجنت Muse متا؛ خرید خودسرانه اشتراک و جبران سریع اشتباه
سپردن برنامهریزی یک جشن تولد و خریدهای اینترنتی به ایجنت هوش مصنوعی Muse متا، مزایا و چالشهای جذابی را رقم زد. این دستیار هوشمند با وجود مهارت در مسیریابی و ثبت سفارش، خودسرانه یک اشتراک ویژه را برای کاهش هزینه ارسال فعال کرد.
شکایت یک مرد آمریکایی از OpenAI؛ همسرم با راهنمایی ChatGPT مرا مسموم کرد
یک مرد آمریکایی با ثبت شکایتی حقوقی علیه OpenAI ادعا کرده است که مدل بازنشستهشده GPT-4o دستورالعملهای دقیقی درباره نحوه مسموم کردن افراد با گیاهان سمی و داروها به همسرش ارائه داده و او را در طراحی نقشه قتل یاری کرده است.
مخالفت مردم با ساخت مراکز داده و قوانین جدید انرژی؛ برنامههای هوش مصنوعی شرکتها چگونه تغییر میکند؟
مخالفت شهروندان محلی با احداث مراکز داده، قوانین جدید برای دریافت هزینه ارتقای شبکه برق و مقررات تازه ایالتی، زمانبندی و بودجه پروژههای هوش مصنوعی را دستخوش تغییر کردهاند. شرکتها پیش از تصویب بودجه بعدی خود باید چهار پرسش کلیدی را بررسی کنند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.