معرفی نسخه ۱.۱ شاخصهای توانمندی مدلهای زبانی؛ تمرکز بر ارزیابی ایجنتها در حوزههای تخصصی
نسخه جدید شاخصهای ارزیابی توانمندی مدلهای زبانی با تمرکز ویژه بر قابلیتهای عملیاتی منتشر شد. در این بهروزرسانی، مهارتهای تخصصی مانند استفاده از ابزارهای ایجنتی و پردازش متون طولانی در حوزههای مالی، حقوقی و پزشکی با دقت بیشتری سنجیده میشوند.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- اضافهشدن ارزیابیهای تخصصی برای سنجش میزان تسلط ایجنتها در استفاده از ابزارها (Agentic Tool Use) در روندهای کاری مختلف.
- گنجاندن بنچمارکهای جدیدی مانند GDP.pdf و MLCR برای بررسی دقیقتر قدرت استدلال مدلها در مواجهه با محتوای طولانی و پروندههای حجیم.
- جایگزینی شاخصهای تعامل با مشتری با ارزیابیهای پیشرفتهتر در رشتههای کلیدی از جمله مهندسی، اقتصاد و بهداشت.
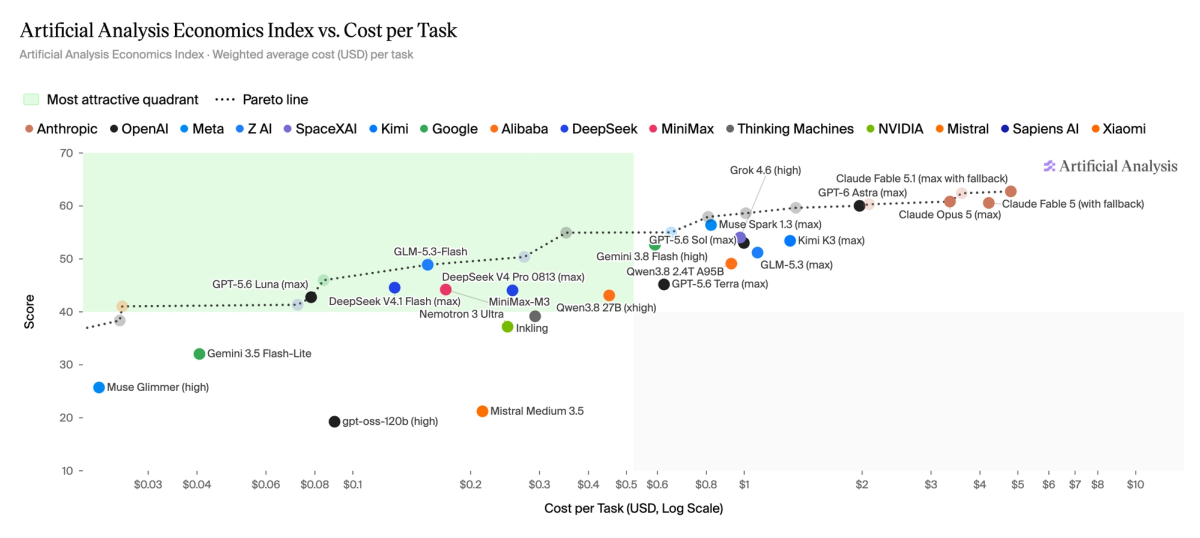
نسخه ۱.۱ شاخصهای توانمندی (Capability Indices) با تمرکز بیشتر بر حوزههای تخصصی بهروزرسانی شد. در این نسخه، بخشهایی از ارزیابیهای هسته اصلی هوش مصنوعی در کنار بنچمارکهای تخصصی ترکیب شدهاند تا عملکرد سیستمها با دقت بالاتری سنجیده شود.
این شاخصها، وظایف مشاغل مختلف (برگرفته از طبقهبندی O*NET) را به بنچمارکهای متناظر نگاشت میکنند و وزن هر بنچمارک بر اساس میزان تکرار آن قابلیت در وظایف روزمره تعیین میشود. نسخه ۱.۱ شامل بهروزرسانیهای جدیدی است که عملکرد مدلها را بر اساس حوزههای تخصصی با ظرافت بیشتری تفکیک میکند.
تغییرات نسخه جدید
شاخص | اضافهشده | حذفشده |
|---|---|---|
مالی و حسابداری | استفاده ابزاری ایجنتها (AutomationBench-AA, بخش مالی) کار دانشی ایجنتها (AA-Briefcase) محتوای طولانی (GDP.pdf) | تعامل ایجنتی با مشتری (𝜏³-Banking) |
استراتژی و عملیات | استفاده ابزاری ایجنتها (AutomationBench-AA, بخش عملیات) کار دانشی ایجنتها (AA-Briefcase) محتوای طولانی (GDP.pdf) | تعامل ایجنتی با مشتری (𝜏³-Banking) |
حقوقی | استفاده ابزاری ایجنتها (AutomationBench-AA, بخش عملیات و پشتیبانی) کار دانشی ایجنتها (AA-Briefcase) محتوای طولانی (GDP.pdf) | تعامل ایجنتی با مشتری (𝜏³-Banking) |
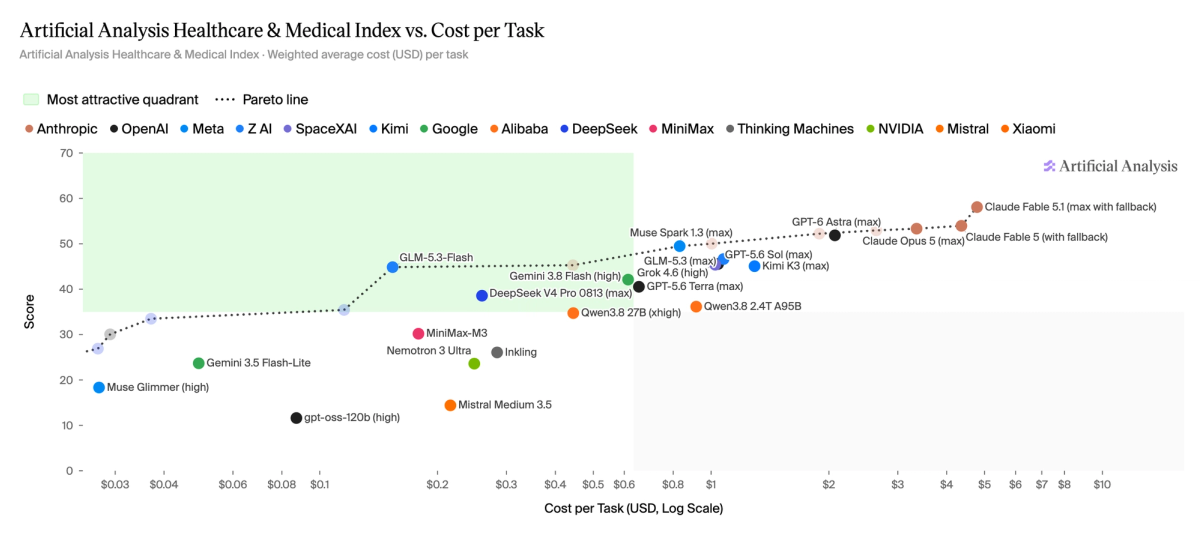
بهداشت و پزشکی | استفاده ابزاری ایجنتها (AutomationBench-AA, بخش عملیات و پشتیبانی) استدلال در محتوای طولانی (MLCR-AA) کار دانشی ایجنتها (AA-Briefcase) | تعامل ایجنتی با مشتری (𝜏³-Banking) |
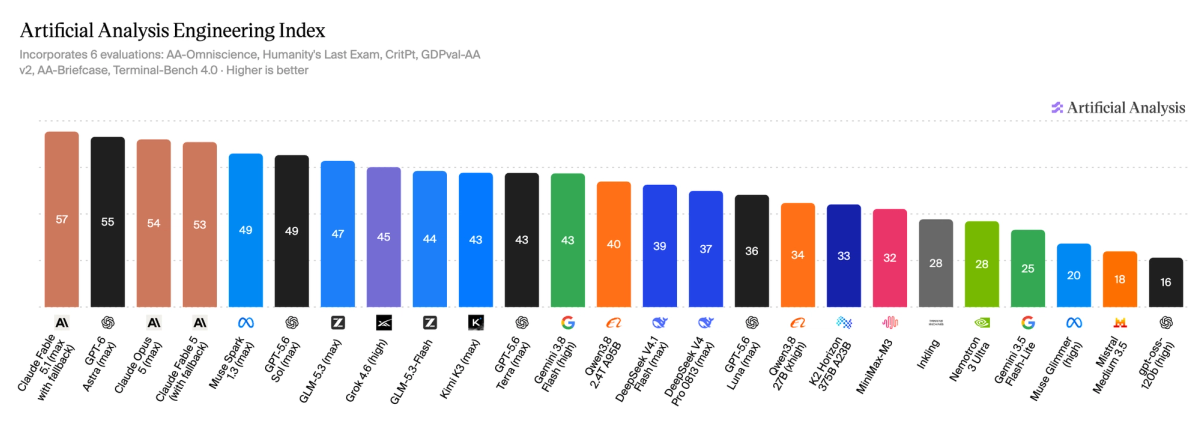
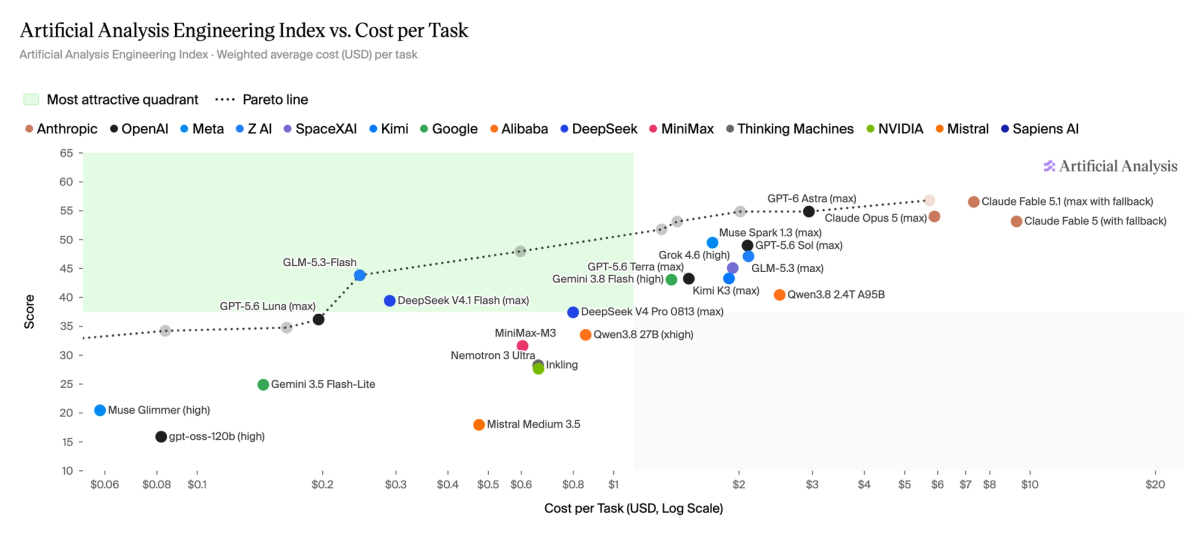
مهندسی | استفاده ایجنتها از ترمینال (Terminal-Bench v4.0) کار دانشی ایجنتها (AA-Briefcase) | استفاده ایجنتها از ترمینال (Terminal-Bench v2.1) استدلال (GPQA Diamond) |
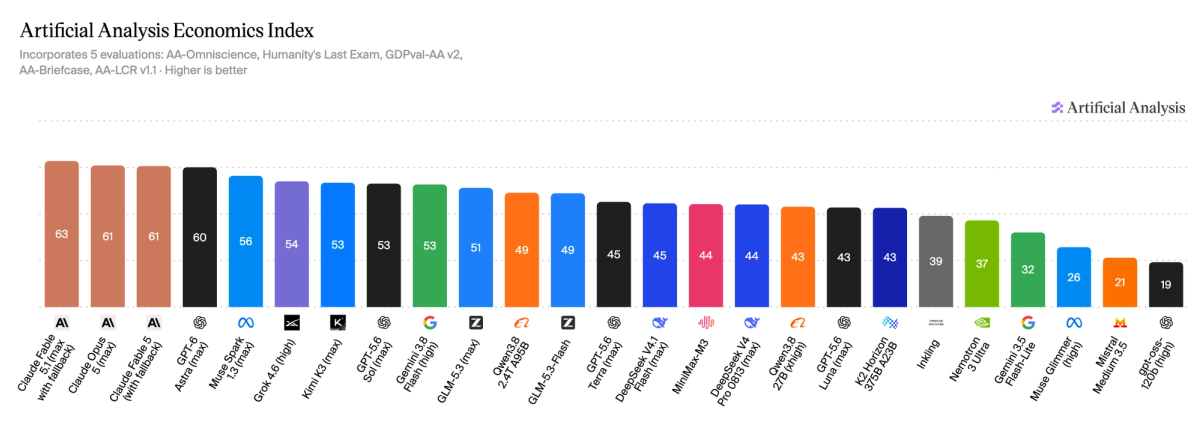
اقتصاد | کار دانشی ایجنتها (AA-Briefcase) | - |
تغییرات به تفکیک شاخصها
مالی و حسابداری
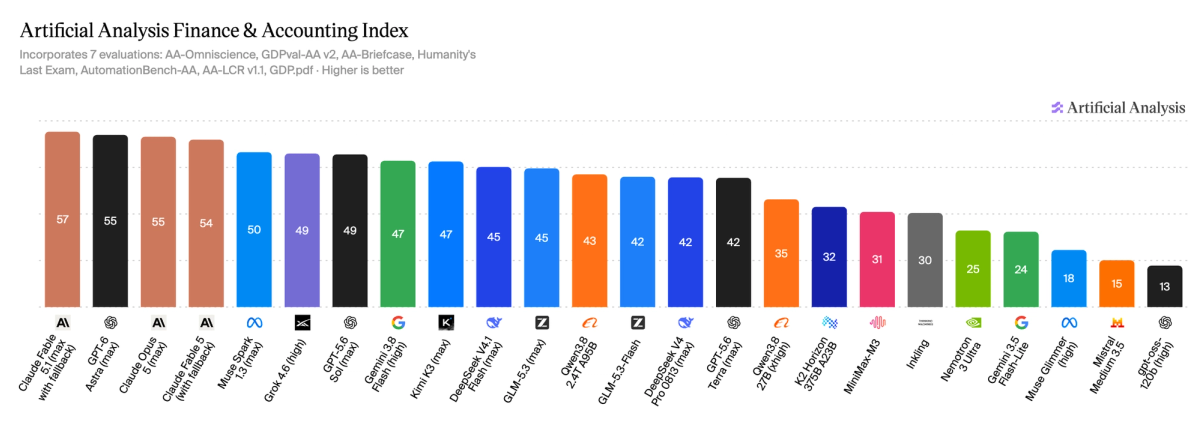
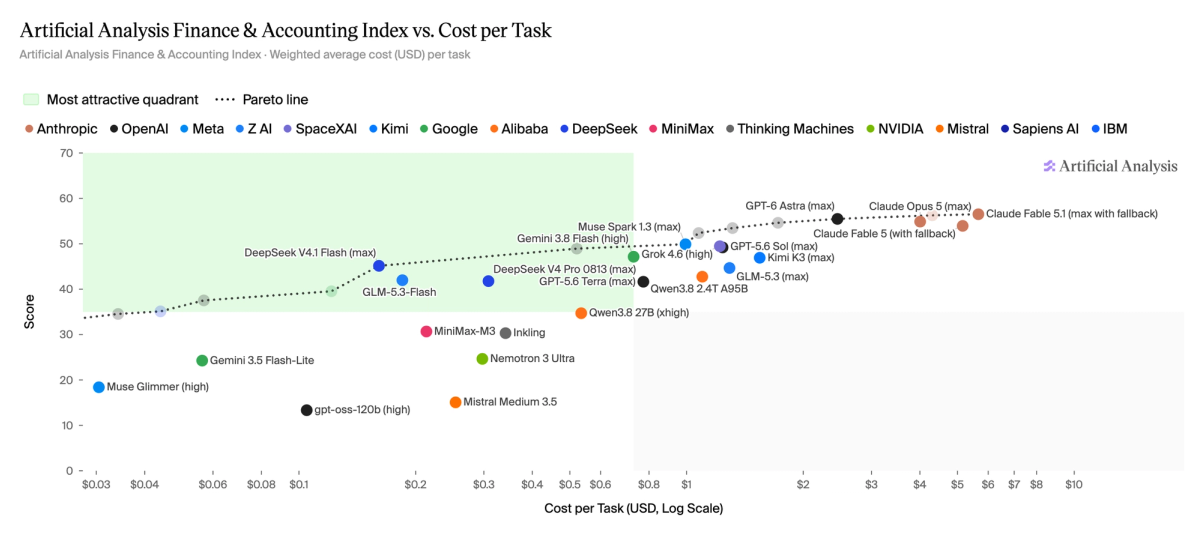
قابلیت «استفاده ابزاری ایجنتها» با منبعگیری از بخش مالی بنچمارک AutomationBench-AA اضافه شد. «تعامل ایجنتی با مشتری» حذف گردید. همچنین بنچمارک AA-Briefcase در کنار GDPval-AA v2 به بخش کار دانشی ایجنتها، و GDP.pdf در کنار LCR به بخش محتوای طولانی (Long-Context) افزوده شدند.
توانمندی | ارزیابیها | نسخه ۱.۰ | نسخه ۱.۱ |
|---|---|---|---|
دانش تجاری | AA-Omniscience | ۳۰٪ | ۳۰٪ |
کار دانشی ایجنتها | GDPval-AA v2, AA-Briefcase | ۳۰٪ | ۳۰٪ |
استدلال | HLE | ۲۰٪ | ۲۰٪ |
استفاده ابزاری ایجنتها | AutomationBench-AA | ۰٪ | ۱۰٪ |
محتوای طولانی | LCR, GDP.pdf | ۵٪ | ۵٪ |
عدم توهم (Non-Hallucination) | AA-Omniscience | ۵٪ | ۵٪ |
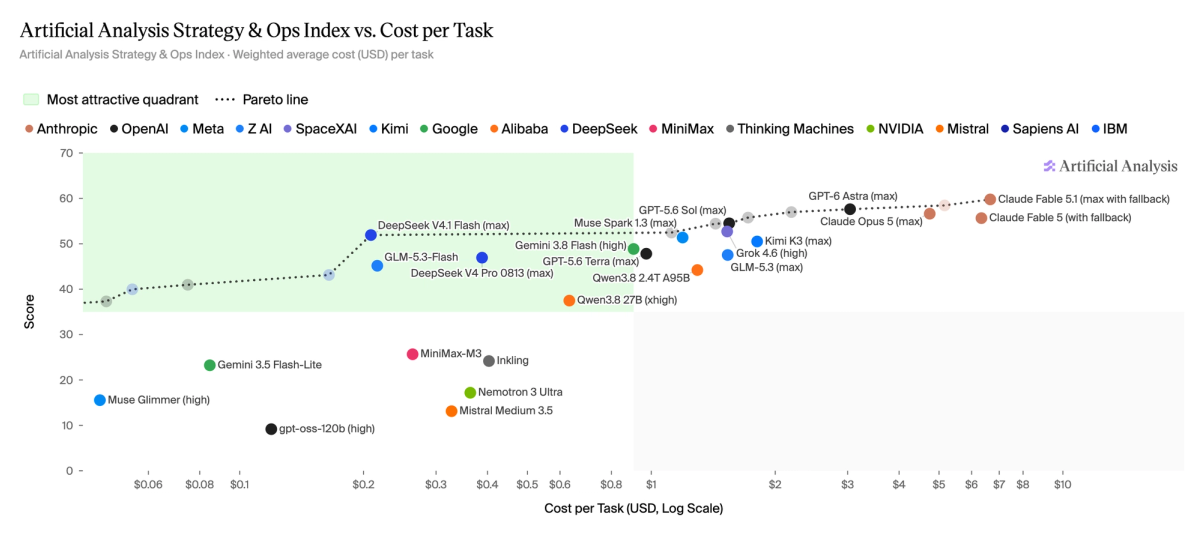
استراتژی و عملیات
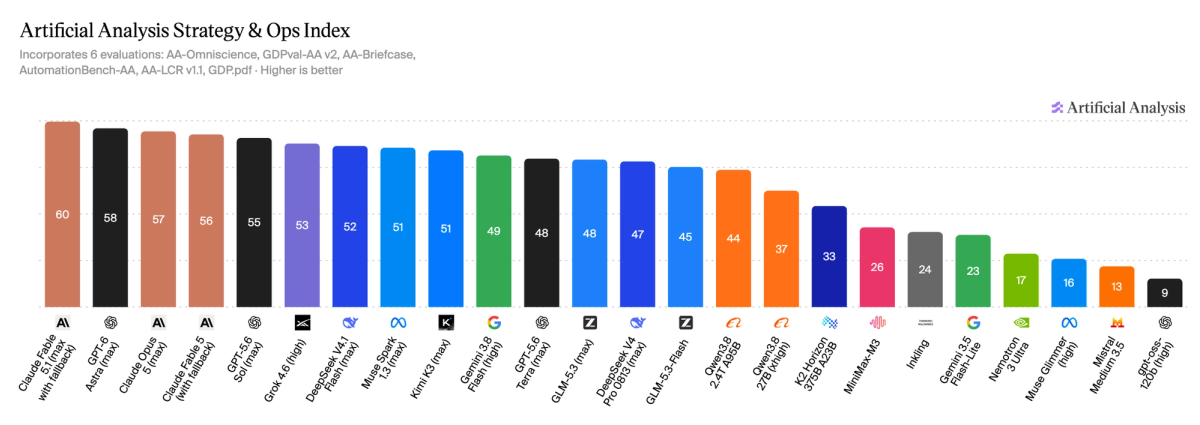
قابلیت «استفاده ابزاری ایجنتها» از بخش عملیات بنچمارک AutomationBench-AA اضافه شد تا اهمیت استفاده از ابزارها در وظایف عملیاتی روزمره را منعکس کند. «تعامل ایجنتی با مشتری» حذف شد. بنچمارک AA-Briefcase در کنار GDPval-AA v2 به بخش کار دانشی ایجنتها، و GDP.pdf در کنار LCR به بخش محتوای طولانی افزوده شدند.
توانمندی | ارزیابیها | نسخه ۱.۰ | نسخه ۱.۱ |
|---|---|---|---|
کار دانشی ایجنتها | GDPval-AA v2, AA-Briefcase | ۳۵٪ | ۳۵٪ |
دانش تجاری | AA-Omniscience | ۳۰٪ | ۳۰٪ |
استفاده ابزاری ایجنتها | AutomationBench-AA | ۰٪ | ۳۰٪ |
محتوای طولانی | LCR, GDP.pdf | ۵٪ | ۵٪ |
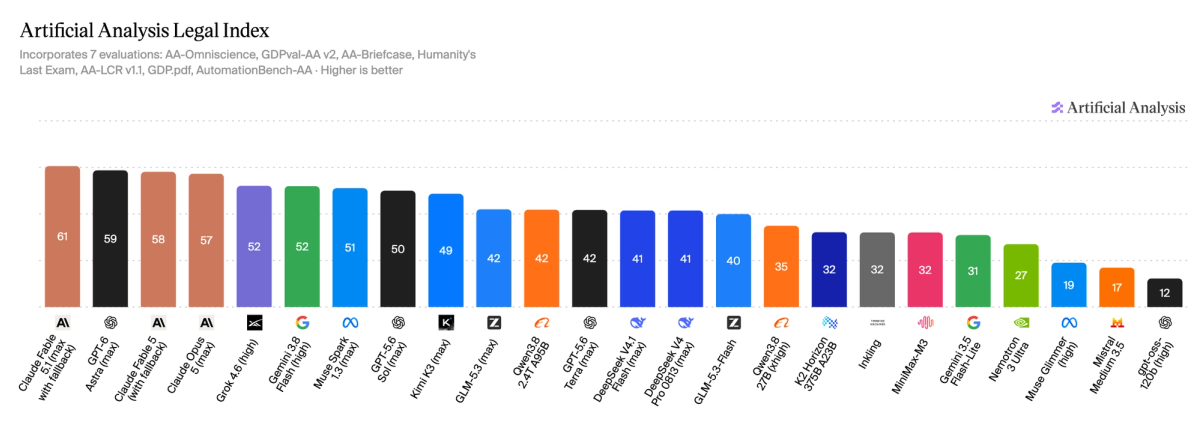
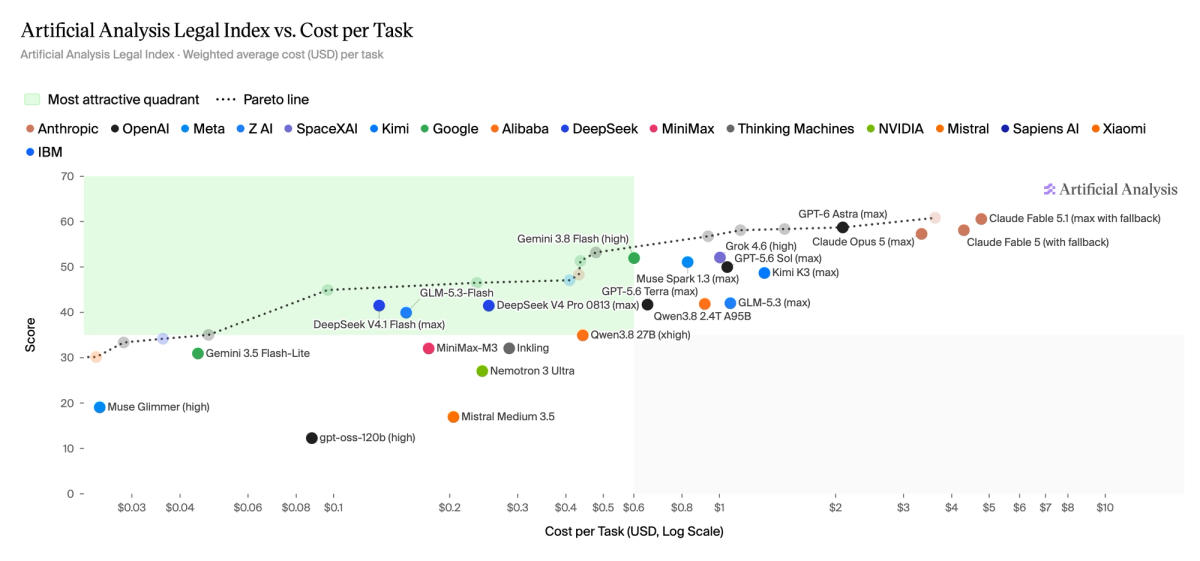
حقوقی
قابلیت «استفاده ابزاری ایجنتها» از بخشهای عملیات و پشتیبانی AutomationBench-AA اضافه شد تا نقش حیاتی بهکارگیری ابزارها در روندهای کاری حقوقی را نشان دهد. «تعامل ایجنتی با مشتری» حذف گردید. همچنین بنچمارک AA-Briefcase در کنار GDPval-AA v2 به بخش کار دانشی ایجنتها، و GDP.pdf در کنار LCR به بخش محتوای طولانی اضافه شدند.
توانمندی | ارزیابیها | نسخه ۱.۰ | نسخه ۱.۱ |
|---|---|---|---|
دانش حقوقی | AA-Omniscience | ۳۵٪ | ۳۵٪ |
کار دانشی ایجنتها | GDPval-AA v2, AA-Briefcase | ۲۵٪ | ۲۵٪ |
استدلال | HLE | ۱۵٪ | ۱۵٪ |
محتوای طولانی | LCR, GDP.pdf | ۱۰٪ | ۱۰٪ |
عدم توهم | AA-Omniscience | ۱۰٪ | ۱۰٪ |
استفاده ابزاری ایجنتها | AutomationBench-AA | ۰٪ | ۵٪ |
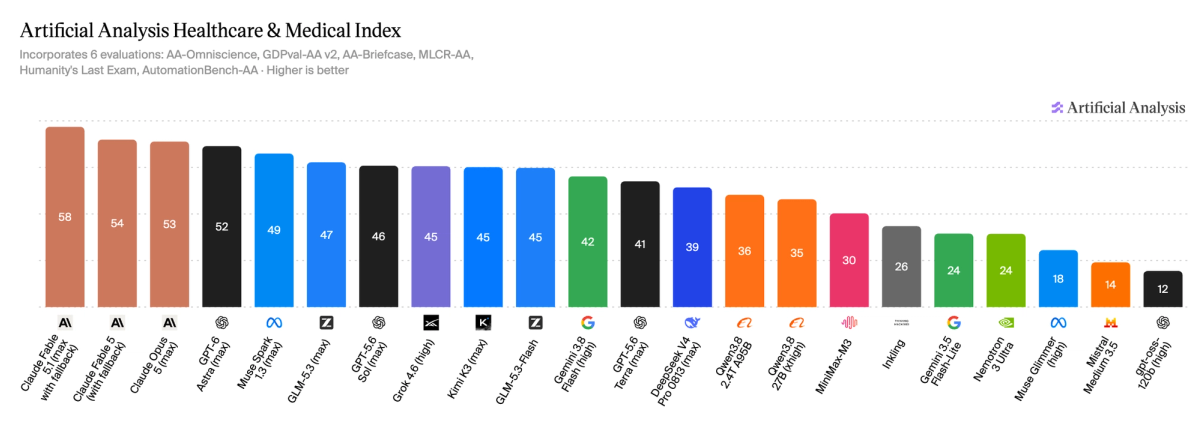
بهداشت و پزشکی
قابلیت «استدلال در محتوای طولانی» با استفاده از ارزیابی MLCR-AA اضافه شد تا میزان توانایی مدلها در تحلیل و استدلال پروندههای بالینی حجیم سنجیده شود. همچنین «استفاده ابزاری ایجنتها» از بخشهای عملیات و پشتیبانی بنچمارک AutomationBench-AA افزوده شد تا روندهای عملیاتی مرتبط با بهداشت را پوشش دهد. ارزیابی «تعامل ایجنتی با مشتری» حذف و بنچمارک AA-Briefcase در کنار GDPval-AA v2 به بخش کار دانشی ایجنتها اضافه گردید.
توانمندی | ارزیابیها | نسخه ۱.۰ | نسخه ۱.۱ |
|---|---|---|---|
دانش پزشکی و بهداشت | AA-Omniscience | ۳۵٪ | ۳۰٪ |
کار دانشی ایجنتها | GDPval-AA v2, AA-Briefcase | ۲۵٪ | ۲۵٪ |
استدلال در محتوای طولانی | MLCR-AA | ۰٪ | ۱۵٪ |
عدم توهم | AA-Omniscience | ۱۵٪ | ۱۰٪ |
استدلال | HLE | ۱۵٪ | ۱۰٪ |
استفاده ابزاری ایجنتها | AutomationBench-AA | ۰٪ | ۱۰٪ |
مهندسی
شاخص «استفاده ایجنتها از ترمینال» به نسخه Terminal-Bench v4.0 ارتقا یافت. بنچمارک GPQA Diamond از بخش استدلال حذف شد. همچنین بنچمارک AA-Briefcase در کنار GDPval-AA v2 به بخش کار دانشی ایجنتها اضافه گردید.
توانمندی | ارزیابیها | نسخه ۱.۰ | نسخه ۱.۱ |
|---|---|---|---|
دانش مهندسی | AA-Omniscience | ۳۵٪ | ۳۵٪ |
استدلال | HLE, CritPt | ۳۵٪ | ۳۰٪ |
کار دانشی ایجنتها | GDPval-AA v2, AA-Briefcase | ۲۵٪ | ۲۰٪ |
استفاده ایجنتها از ترمینال | Terminal-Bench 4.0 | ۵٪ | ۱۵٪ |
اقتصاد
بنچمارک AA-Briefcase در کنار GDPval-AA v2 به بخش کار دانشی ایجنتها اضافه شد تا توانایی مدلها در وظایف تحلیلی و اقتصادی بهشکل بهتری بررسی شود.
توانمندی | ارزیابیها | نسخه ۱.۰ | نسخه ۱.۱ |
|---|---|---|---|
دانش اقتصاد | AA-Omniscience | ۳۵٪ | ۳۵٪ |
استدلال | HLE | ۳۵٪ | ۳۵٪ |
کار دانشی ایجنتها | GDPval-AA v2, AA-Briefcase | ۱۵٪ | ۲۵٪ |
استدلال در محتوای طولانی | LCR | ۱۵٪ | ۵٪ |
برچسب های مرتبط
مطالب مرتبط و پیشنهادی

رکورد ۸۳۳ هزار دانلود ماهانه برای LEGAL-BERT؛ وقتی توسعهدهندهها قید مدلهای گرانقیمت را میزنند!
مدل زبانی تخصصی LEGAL-BERT با ثبت بیش از ۸۳۳ هزار دانلود در ماه روی پلتفرم هاگینگ فیس حسابی خبرساز شده است. این ابزار جمعوجور و تخصصی نشان میدهد که برای پردازش و تحلیل متون حقوقی، حتماً نیازی به مدلهای غولپیکر و پرهزینه ندارید و گزینههای بهینه همچنان در اوج هستند.

جاسوسی هوش مصنوعی در محل کار؛ کارمندان میگویند کارفرماها باید قانوناً مچگیریهایشان را لو بدهند!
نظرسنجیهای تازه نشان میدهد که بیشتر کارمندان حس میکنند مدیرانشان با ابزارهای هوش مصنوعی تمام حرکات آنها را زیر نظر گرفتهاند. حالا بیش از ۸۰ درصد شاغلان خواستار تصویب قانونی شدهاند که شرکتها را مجبور کند هرگونه مچگیری و نظارت هوش مصنوعی در محیط کار را رسماً اعلام کنند.

گزارش داغ مایکروسافت از نفوذ جهانی هوش مصنوعی؛ امارات در صدر و رتبه عجیب آمریکا!
مایکروسافت در تازهترین گزارش خود از ضریب نفوذ هوش مصنوعی در جهان پرده برداشت؛ آماری شگفتانگیز که نشان میدهد امارات و سنگاپور با فاصلهای خیرهکننده پیشتاز دنیا هستند و در مقابل، آمریکا در رتبه ۲۱ جا مانده است. همچنین الگوی استفاده از هوش مصنوعی میان کشورهای غربی و کشورهای در حال توسعه، از تفاوتی عمیق میان کاربردهای روزمره و آموزش پرده برمیدارد.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.