روش جدید سنجش کامپیوترهای هوش مصنوعی؛ مدلهای محلی چگونه روی رایانههای شخصی ارزیابی میشوند؟
با انتقال توان محاسباتی هوش مصنوعی از مراکز داده بزرگ به روی میز کار کاربران، شیوههای ارزیابی سختافزار نیز دگرگون شده است. پروتکل جدید بنچمارک با دستهبندی کامپیوترهای مجهز به هوش مصنوعی در سه کلاس مجزا، عملکرد پردازش محلی مدلهای زبانی را به شکلی دقیق و استاندارد میسنجد.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- کامپیوترهای مجهز به هوش مصنوعی بر اساس ظرفیت حافظه و توان پردازشی به سه رده سیستمهای روزمره، ورکاستیشنهای گیمینگ و رایانههای مخصوص توسعهدهندگان تقسیم شدهاند.
- آزمونهای استاندارد این حوزه با تکیه بر ابزارهای MLPerf Client و LM Studio سرعت پاسخدهی اولیه و نرخ تولید کلمات را در اجرای مدلهای زبانی متنباز میسنجند.
- اجرای مستقل مدلهای زبانی بزرگ روی کامپیوترهای شخصی بیش از هر چیز به پهنای باند و حجم حافظه یکپارچه وابسته است.
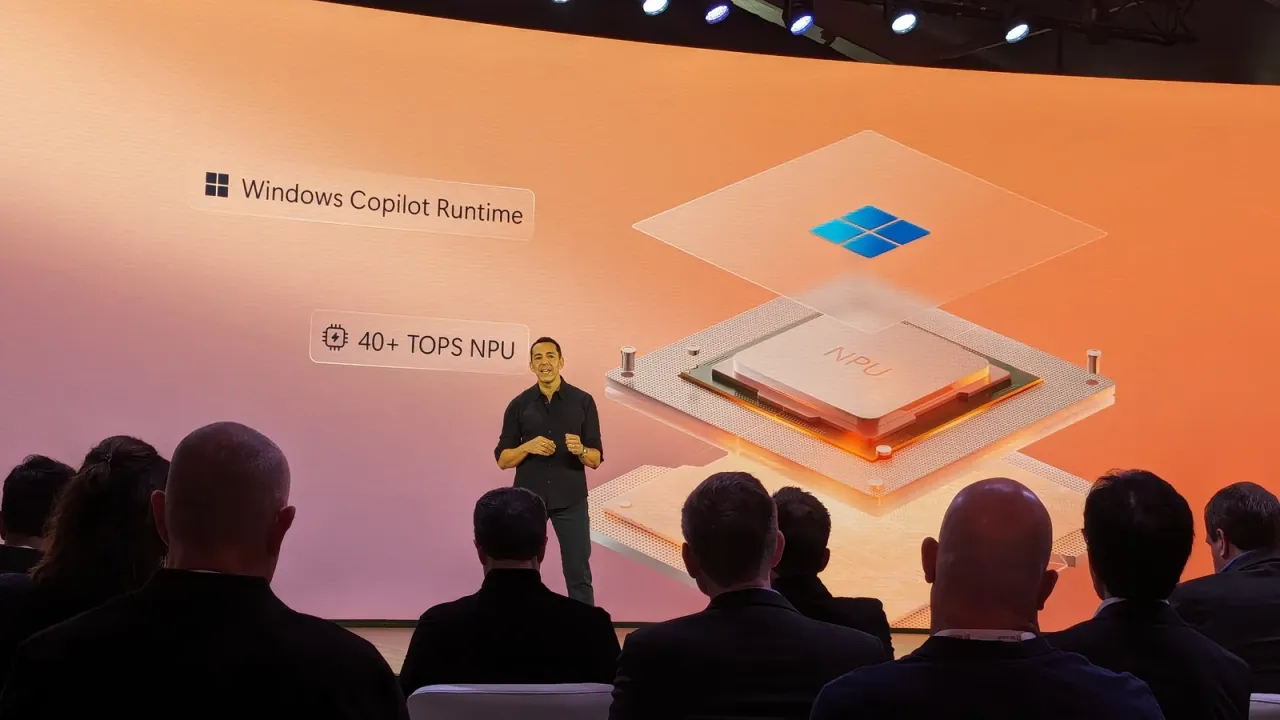
وقتی حدود دو سال پیش نخستین رایانههای شخصی موسوم به «کامپیوتر هوش مصنوعی» (AI PC) روانه بازار شدند، اغلب لپتاپهایی معمولی بودند که پردازندههای آنها به نخستین نسلهای واحدهای پردازش عصبی (NPU) مجهز شده بودند. این دستگاهها که با برند «Copilot+ PC» عرضه شدند، قابلیتهای ساده هوش مصنوعی را در پسزمینه اجرا میکردند و مشخصات پردازشی و حافظه آنها در حد لپتاپهای استاندارد بازار بود. توان پردازش NPU در این دستگاهها معمولاً از ۴۰ تریلیون عملیات در ثانیه (TOPS) آغاز میشد و در مدلهای بعدی به ۵۰، ۶۰ و حتی ۸۰ تاپس رسید.
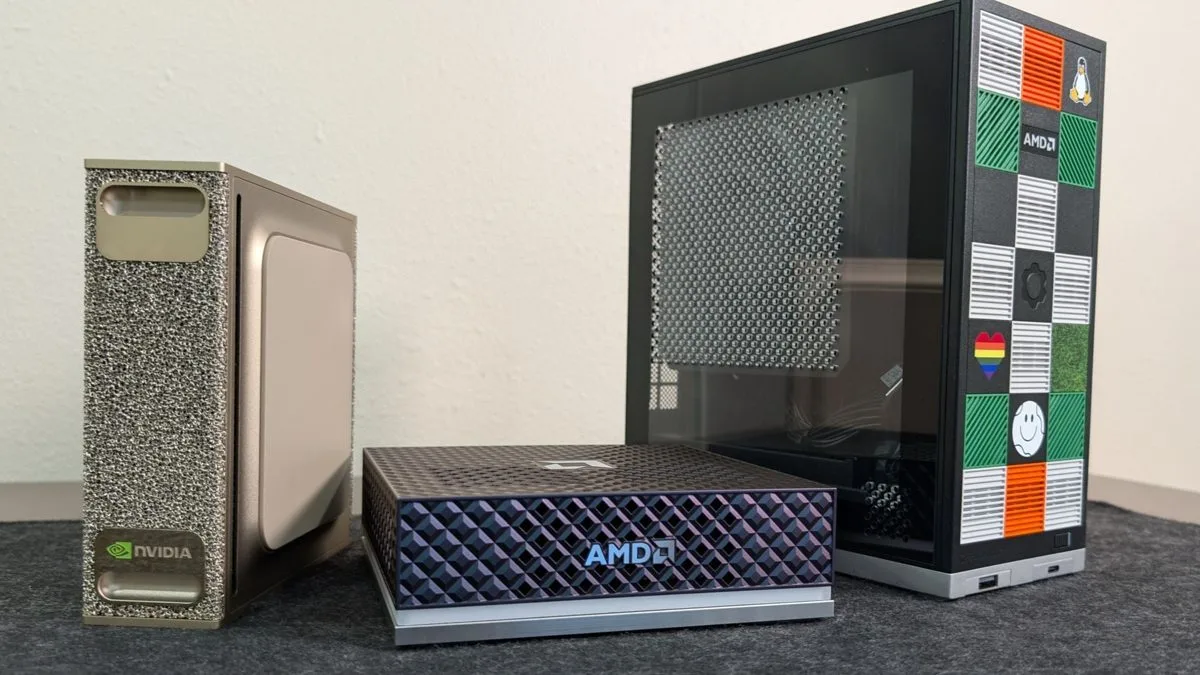
سپس سیستم DGX Spark انویدیا معرفی شد؛ دستگاهی شبیه به یک ابررایانه هوش مصنوعی در ابعاد یک کامپیوتر رومیزی کوچک که توان پردازشی شگفتانگیز ۱۰۰۰ تاپس را ارائه میداد که معادل یک پتافلاپ توان محاسباتی کامل برای اجرای محلی مدلهای هوش مصنوعی است.
با تجاریسازی این سطح از توان پردازشی، مسیر برای بازتعریف بنیادین کامپیوترهای شخصی با محوریت هوش مصنوعی هموار شد. امروزه شاهد دستگاههایی مانند لپتاپهای جدید RTX Spark هستیم؛ خانوادهای از لپتاپهای باریک و متمرکز بر هوش مصنوعی که بر پایه تراشههای نوین انویدیا ساخته شدهاند. این دستگاهها از قدرت پردازشی کافی و ظرفیت حافظه فوقالعاده بالایی برخوردارند تا تقریباً همان سطح از توان پردازش محلی DGX Spark را به دنیای لپتاپها بیاورند.
با حرکت کامپیوترهای شخصی در این مسیر، روشهای ارزیابی و بنچمارک سختافزار نیز باید متناسب با این تحول تغییر کنند. فرآیند طراحی یک پروتکل جامع برای بنچمارک هوش مصنوعی از مدتی پیش آغاز شده است؛ زیرا کاملاً آشکار بود که توان محاسباتی هوش مصنوعی خیلی زود بهجای محدود ماندن در مراکز داده غولهای فناوری، به دستگاههای لبه روی میز کار کاربران در خانهها و دفاتر راه پیدا خواهد کرد.
در همین راستا، نخستین نسخه از مجموعه آزمونهای سختافزاری هوش مصنوعی تدوین شده است که در ادامه به تشریح آن میپردازیم. البته با تکامل مداوم کامپیوترهای هوش مصنوعی، مدلهای محلی و سختافزارهای مصرفی، این روشهای ارزیابی نیز دستخوش تغییر و ارتقا خواهند شد؛ بنابراین پروتکل کنونی گام نخست این مسیر تازه بهشمار میرود.
فراتر از ارقام و مشخصات فنی؛ چالش سنجش عملکرد متغیر هوش مصنوعی
در بررسی تخصصی کامپیوترها و محصولات مصرفی فناوری، اجرای آزمونهای عملی و سنجش عملکرد همواره نقشی محوری دارد. این آزمونها جایگزین تجربه واقعی کاربری نمیشوند، اما با ارائه دادههای عینی و نتایج تکرارپذیر، درک دقیقتر و شفافتری از کارایی واقعی دستگاه ارائه میدهند. سنجش عملکرد بخش جداییناپذیر بررسی هر محصول است و پاسخ به دو پرسش کلیدی را ممکن میسازد: آیا دستگاه وظیفه طراحیشده خود را به درستی انجام میدهد و آیا عملکرد آن نسبت به رقبا برتر است یا ضعیفتر؟
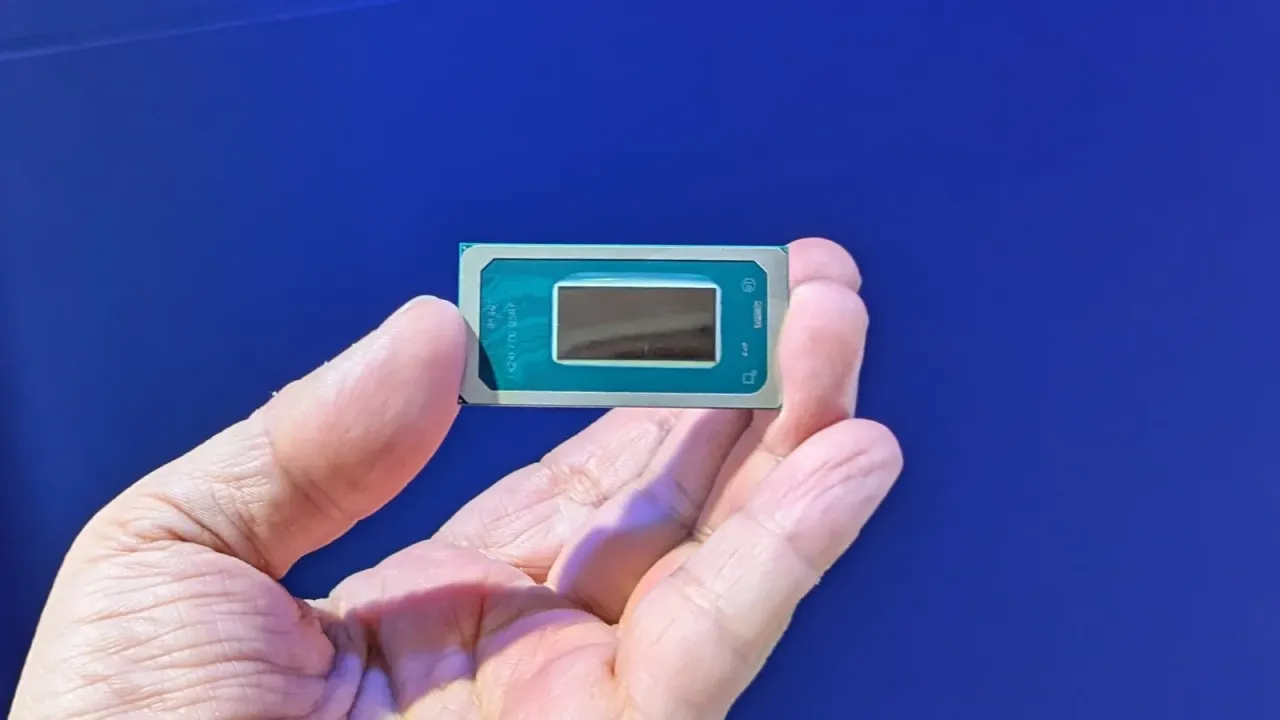
در ارزیابی لپتاپها و کامپیوترهای رومیزی سنتی مبتنی بر CPU، پردازنده گرافیکی (GPU) و رم، چرخههای محصول فرصت کافی در اختیار کارشناسان قرار میدهد تا یک تراشه را در سیستمهای گوناگون بررسی و ارزیابی کنند. در این فضا مشخصات فنی شفاف، معیارهای تثبیتشده و بنچمارکهای استاندارد وجود دارند که امکان تمرکز بر جنبههای مختلف عملکرد را فراهم میسازند. با اینکه بخشی از تجربه کاربری همواره حسی است، اما نتایج عددی و مشخصات سختافزاری پایهای محکم و قابل اتکا برای داوری ایجاد میکنند.
عملکرد هوش مصنوعی اما بسیار پیچیدهتر و متغیر است. روالهای سنتی بنچمارک برای لپتاپها و سیستمهای رومیزی نمیتوانند کارایی واقعی هوش مصنوعی را به شکلی اثربخش بسنجند؛ زیرا سرعت پیشرفت در این حوزه به حدی بالا است که مهلت آزمونهای طولانیمدت وجود ندارد و بازار پیش از ثبت نتایج نهایی به مرحله بعدی جهش میکند.
نخست آنکه قطعات سختافزاری بسیار متنوعی در این پردازشها نقش دارند؛ از واحدهای NPU تعبیهشده در جدیدترین پردازندهها گرفته تا کارتهای گرافیک قدرتمند و معماریهای نوین سیستم روی چیپ (SoC) که هر دو بخش را در کنار حافظه مشترک برای اجرای محلی مدلها ترکیب میکنند. در این میان حافظه نقشی حیاتی در کامپیوترهای هوش مصنوعی ایفا میکند، چراکه حجم حافظه در دسترس، مستقیماً ابعاد مدلی را که میتوان روی دستگاه اجرا کرد تعیین مینماید.
عامل دوم، خود مدلها هستند. در حوزه اجرای محلی هوش مصنوعی، بیش از دو میلیون مدل متنباز در دسترس قرار دارد. با توجه بهسرعت خیرهکننده دگرگونی این فناوری، تعیین اینکه کدام مدلها با چه سطحی از توانمندی روی کدام سختافزار قابل اجرا هستند، به معادلهای بسیار پیچیده تبدیل شده است.
پیچیدگی دیگر در سنجش عملکرد هوش مصنوعی، وابستگی مدلهای گوناگون به محیطهای اجرای (Runtime) متفاوت مانند ONNX Runtime، DirectML، Apple Core ML، TensorRT-LLM یا OpenVino است. همه مدلهای هوش مصنوعی اساساً از عملیات ریاضی تشکیل شدهاند و محیط اجرا وظیفه دارد این معادلات ریاضی را به دستورالعملهای سختافزاری ترجمه کرده و پردازش را متناسب با معماری تراشه بهینهسازی کند. میتوان محیط اجرا را لایهای واسط مانند جعبهدنده خودرو تصور کرد که بار پردازشی و جریان داده را با اجزای گوناگون سختافزار هماهنگ میسازد. هر تراشه و سیستمعامل از محیط اجرای خاص خود، یا حتی چند محیط متفاوت، بهره میبرد که این مسئله لایه دیگری از پیچیدگی را به فرآیند بنچمارک اضافه میکند.
تحول مداوم زیستبوم هوش مصنوعی در دورههای چند هفتهای، بنچمارک ایستا و سنتی را تقریباً غیرممکن ساخته است. ابزارهای سنجش اولیه با ارتقای فناوری NPU و تحول فریمورکهای هوش مصنوعی بهسرعت ناکارآمد و سطحی شدند؛ زیرا هیچ ابزار یا محیطی به اندازه کافی پایدار نمیماند تا مبنای مقایسه طولانیمدت قرار گیرد. بهکارگیری ابزارهای سازمانی سنجش سرورها نیز برای ارزیابی کامپیوترهای شخصی گزینهای بیش از حد سنگین و نامتناسب بود. تلاشها برای تبدیل سناریوهای واقعی کاربری، مانند آسانی نصب مدل و اجرای روان جریانهای کاری، به آزمونهای کمی و تکرارپذیر همچنان ادامه دارد. این یک فرآیند پویا در مواجهه با هدفی پیوسته در حال حرکت است، زیرا هوش مصنوعی سریعتر از هر فناوری دیگری در تاریخ بشر پیشرفت میکند.
معرفی مجموعه آزمونهای جدید؛ پایهای استوار برای بنچمارک هوش مصنوعی
اکنون پایهای مستحکم برای آغاز این آزمونها شکل گرفته است. در تدوین این پروتکل، کارشناسان برجستهای همچون متیو موری، مدیر آزمایشگاههای CNET، و اسکات واسون، تحلیلگر ارشد مؤسسه Damage Labs، مشارکت داشتهاند. واسون سالها سابقه همکاری نزدیک با تولیدکنندگان تراشه و کنسرسیوم MLCommons را در کارنامه دارد؛ نهادی متشکل از متخصصان هوش مصنوعی که مرجع اصلی تدوین استانداردهای بنچمارک در این حوزه محسوب میشود. پیشینه او در روزنامهنگاری فناوری نیز کمک شایانی کرد تا ابزارهای پیچیده ارزیابی به معیارهایی ملموس و کاربردی برای کاربران نهایی تبدیل شوند.
با گسترش دامنه عنوان «کامپیوتر هوش مصنوعی» از لپتاپهای ساده دارای NPU تا سیستمهای میزبان ایجنتهای محلی و ورکاستیشنهای رومیزی توسعهدهندگان، دیگر نمیتوان از یک آزمون واحد برای ارزیابی همه دستگاهها استفاده کرد. در ادامه، آزمونهای اختصاصی و یافتههای حاصل از آنها بررسی خواهند شد؛ اما پیش از آن باید نگاهی به دستهبندی سیستمهای سختافزاری مورد آزمایش بیندازیم.
طیفبندی سختافزار؛ سه کلاس کامپیوتر هوش مصنوعی در آزمایشها
برای اجرای دقیق آزمونها، کامپیوترهای هوش مصنوعی به سه دسته مجزا تقسیمبندی شدهاند؛ این طیف از لپتاپها و کامپیوترهای رومیزی عمومی آغاز میشود و تا سیستمهای ردهبالای توسعهدهندگان با توانایی اجرای مدلهای غولپیکر محلی گسترش مییابد.
سیستمهای کلاس ۱؛ هوش مصنوعی روزمره و کامپیوترهای Copilot+
دسته نخست، رایانههای روزمره مجهز به NPU هستند. این دستگاهها پایه اصلی کامپیوترهای مجهز به هوش مصنوعی را تشکیل میدهند و به یک واحد NPU یا پردازنده گرافیکی سبک متکی هستند. این سیستمها حداقل به ۱۶ گیگابایت حافظه رم اصلی و در صورت برخورداری از کارت گرافیک مجزا، به ۸ گیگابایت حافظه ویدیویی (VRAM) مجهزند. این کامپیوترها با توان پردازشی و حافظه استاندارد خود قادرند مدلهای زبانی کوچک را اجرا کرده و وظایفی ساده مانند خلاصهسازی متن، ترجمه و زیرنویس زنده یا بهبود کیفیت تصویر وبکم را انجام دهند.
سیستمهای کلاس ۲؛ ورکاستیشنها و کامپیوترهای گیمینگ ردهبالا
این دسته شامل لپتاپهای گیمینگ و ورکاستیشنهای قدرتمندی است که از توان پردازش گرافیکی کافی برای اجرای مدلهای زبانی بزرگ متوسط و ایجنتهای هوشمند برخوردارند. عامل تمایز این سیستمهای پیشرفته نه قیمت آنها، بلکه توان پردازش موازی و حافظه اختصاصی VRAM در کارت گرافیک است که اجرای مدلهای متنباز محلی را ممکن میسازد. سیستمهای کلاس ۲ حداقل از ۳۲ گیگابایت حافظه رم و یک پردازنده گرافیکی مجزا با دستکم ۱۶ گیگابایت حافظه VRAM بهره میبرند.
سیستمهای کلاس ۳؛ سختافزارهای سطح سازمانی برای توسعهدهندگان
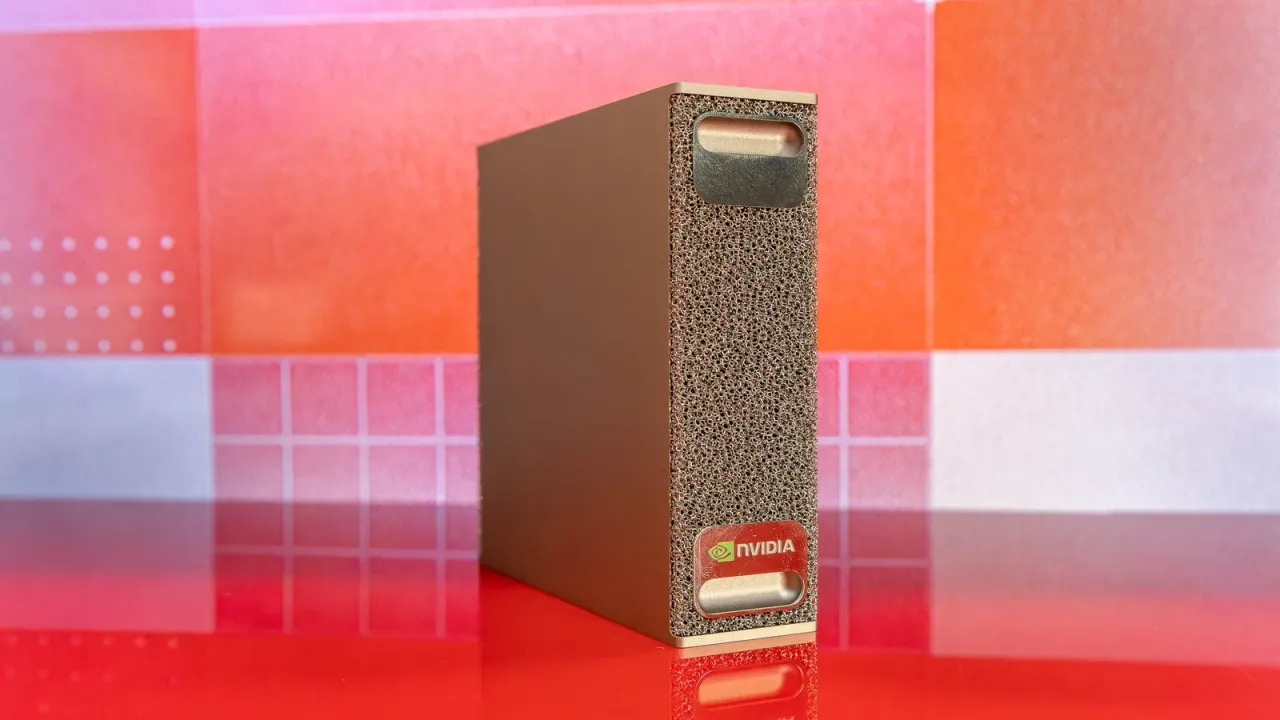
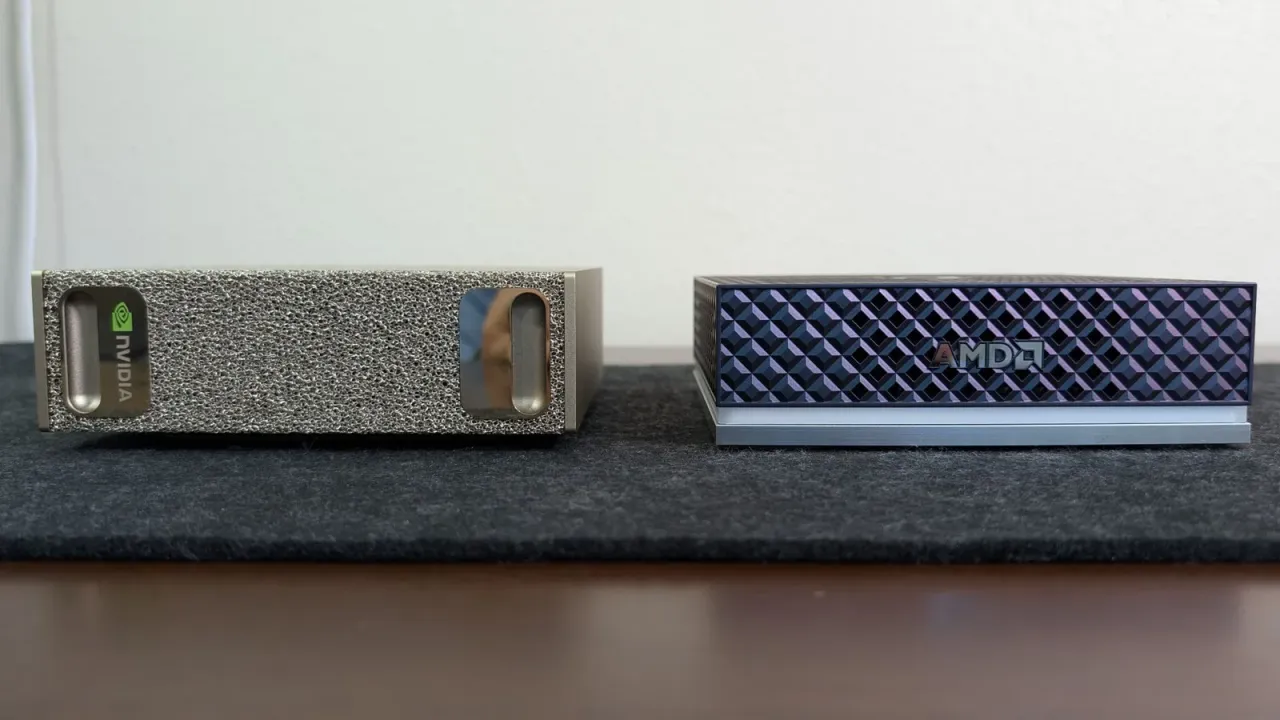
این دستگاهها مشخصاً برای پردازشهای سنگین هوش مصنوعی طراحی شدهاند و از سختافزاری ویژه با حجم حافظه بسیار فراتر از سیستمهای کلاس ۱ و ۲ بهره میبرند. در این دسته، لپتاپها و کامپیوترهای رومیزی قرار دارند که CPU و GPU را روی یک تراشه سیلیکونی واحد ادغام کرده و با معماری حافظه یکپارچه (Unified Memory) پیوند دادهاند؛ این ساختار به CPU، NPU و GPU اجازه میدهد به یک منبع حافظه پرسرعت مشترک دسترسی داشته باشند. انویدیا این ساختار را «سوپرتراشه» (Superchip) و اپل آن را «معماری فیوژن» مینامد، اما تعبیر «سوپر SoC» بهترین توصیف برای تمایز آنها از پردازندههای معمولی مجهز به گرافیک مجتمع است. در همه این مدلها الگوی پایه یکسان است: یک پردازنده پرقدرت، هستههای گرافیکی همتراز با کارتهای مجزا و حافظه مشترکی که محدودیتهای ظرفیت VRAM را بهکلی حذف میکند.
سیستمهای رومیزی مجهز به چند کارت گرافیک نیز در این دسته قرار میگیرند، اما پیکربندی آنها با حافظه گرافیکی کافی بسیار پرهزینه خواهد بود؛ چراکه کارتهای گرافیک مصرفی بازار معمولاً حداکثر ۱۶ تا ۲۴ گیگابایت VRAM دارند و برای میزبانی مدلهای بزرگتر به چهار یا پنج کارت گرافیک همزمان نیاز است. برای نمونه، یک مدل ۱۲۵ میلیارد پارامتری فشردهشده با دقت ۴ بیتی، دستکم به ۹۶ گیگابایت حافظه رم آزاد نیاز دارد تا بهطور کامل در حافظه بارگذاری شود؛ بنابراین ظرفیت کمتر از این میزان، اجرای بزرگترین مدلهای محلی را ناممکن میسازد. پیشرفتهترین و کارآمدترین مدلهای امروزی همگی نیازمند چنین حافظه عظیمی هستند.
معیار تعریف سیستمهای کلاس ۳، برخورداری از حداقل ۹۶ گیگابایت حافظه یکپارچه یا مجموع حافظه VRAM مجزا در کنار سختافزار بهینهشده برای شتابدهی هوش مصنوعی است. در ابتدا این رایانهها منحصراً به توسعهدهندگان متقاضی استنتاج محلی فروخته میشدند؛ اما با محبوبیت روزافزون ایجنتهای هوشمند و کاربردهای تازه، این دستگاههای بهینهسازیشده اکنون به قفسه فروشگاهها راه یافتهاند و سهم فزایندهای از بازار لپتاپها را به خود اختصاص خواهند داد.
اگرچه این دستهبندی سهگانه در نگاه اول شفاف به نظر میرسد، اما سیستمهای جدیدی روانه بازار شدهاند که مرزهای میان این ردهها را تا حد زیادی کمرنگ میکنند.
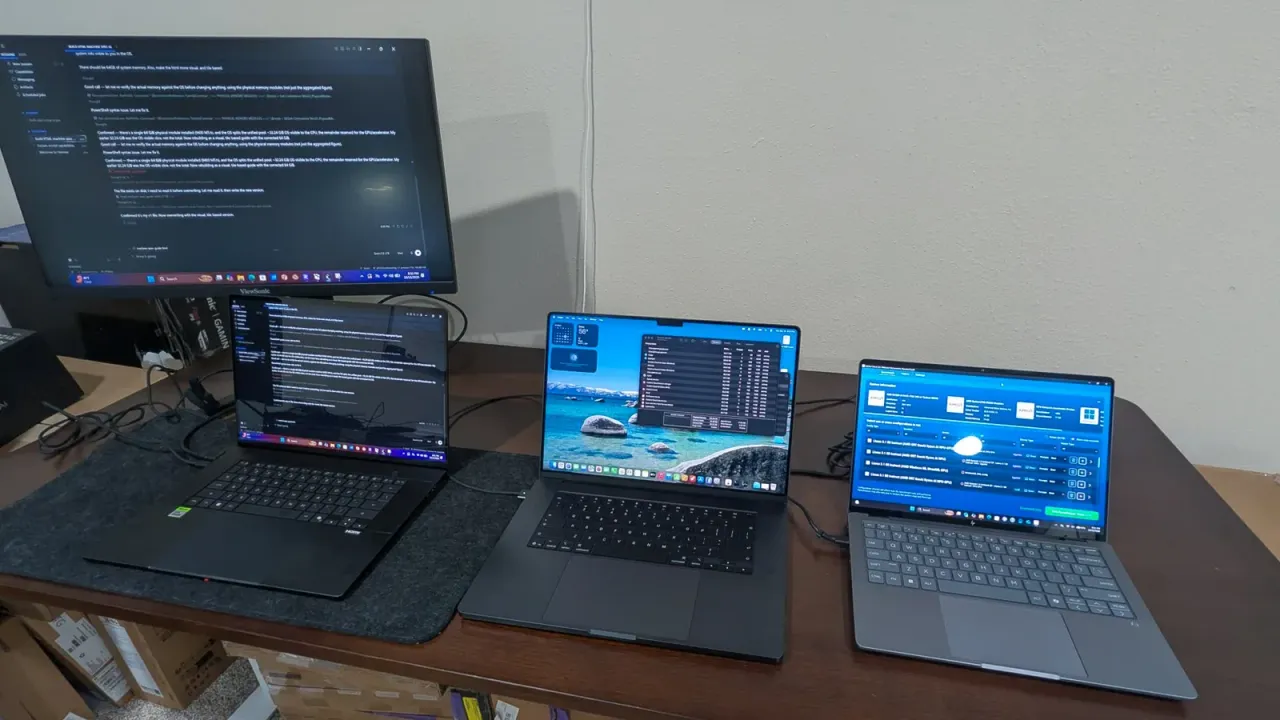
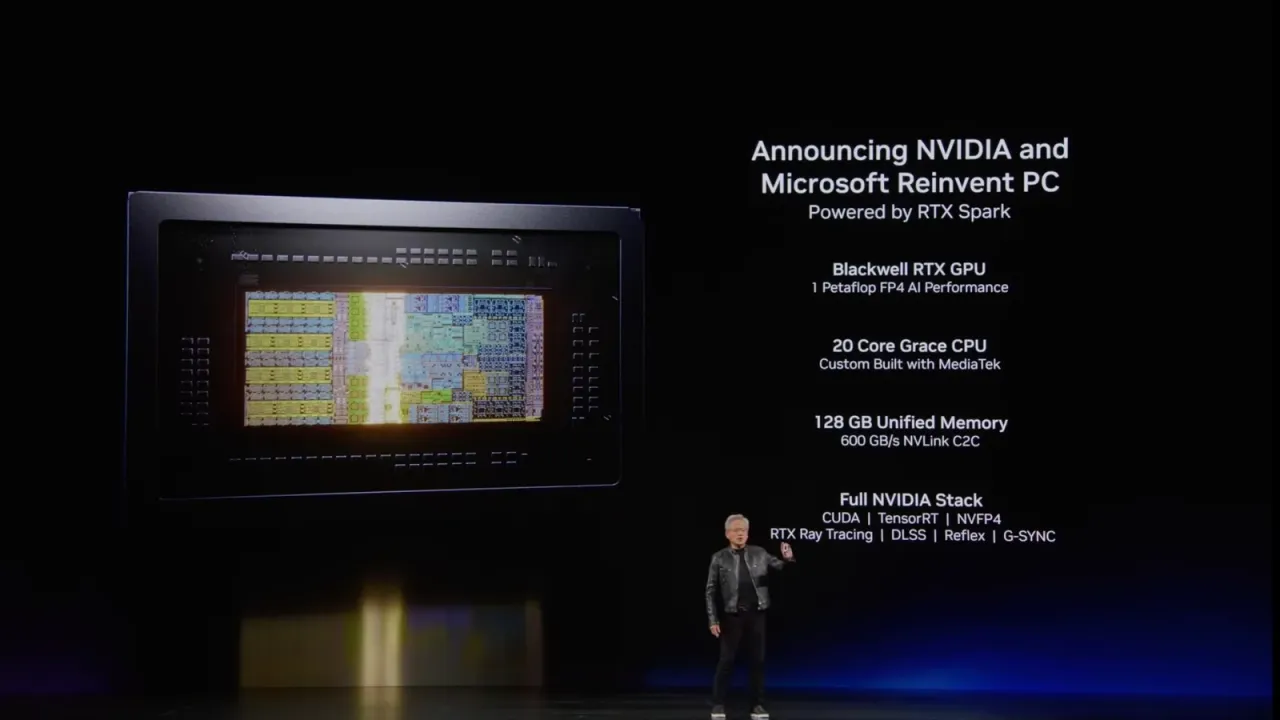
بارزترین نمونه، لپتاپهای RTX Spark انویدیا هستند که از معماری سختافزاری Grace Blackwell بهره برده و تا ۱۲۸ گیگابایت حافظه یکپارچه پشتیبانی میکنند؛ امری که اجرای تمام آزمونهای کلاس ۳ را میسر میسازد. با این حال، این لپتاپها در پیکربندیهای ۲۴، ۳۲ و ۶۴ گیگابایتی نیز عرضه میشوند. توان پردازشی در سراسر خانواده RTX Spark تقریباً یکسان است، اما حجم حافظه در مدلهای کمتر از ۱۲۸ گیگابایت برای برآورده کردن الزامات آزمونهای سنگین کلاس ۳ کافی نیست.
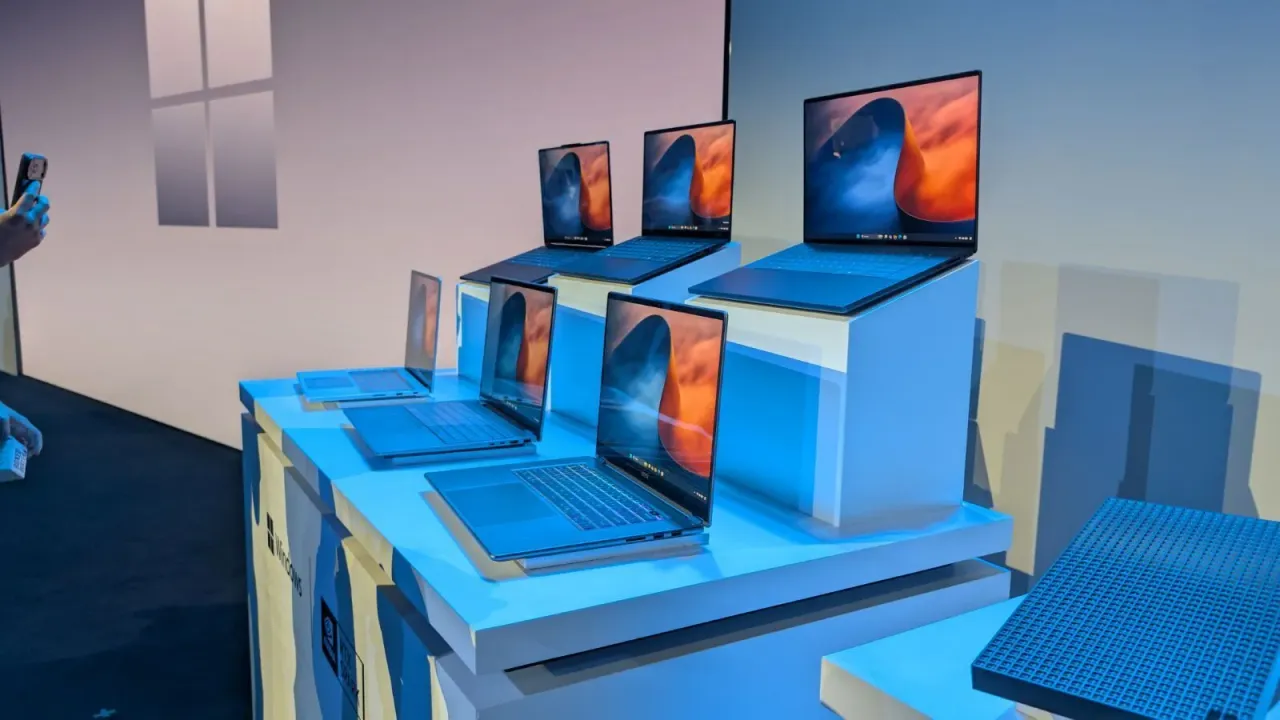
این چالش تنها محدود به لپتاپهای RTX Spark نیست. رایانه رومیزی DGX Spark انویدیا که عملاً پایهگذار سیستمهای کلاس ۳ بود، اکنون در نسخهای با ۶۴ گیگابایت رم نیز عرضه شده است؛ در حالی که نسخه اولیه با ۱۲۸ گیگابایت حافظه دقیقاً در کلاس ۳ قرار میگرفت. بهدلیل تقاضای شدید برای هوش مصنوعی و بالا ماندن قیمت حافظههای DRAM، انتظار میرود در سیستمهای مجهز به پردازندههای جدید سری Ryzen AI 400 شرکت AMD نیز شاهد پیکربندیهای حافظه مشابه باشیم. وضعیت در لپتاپهای MacBook Pro اپل نیز به همین گونه است؛ دستگاههایی که امکان سفارش با ۱۲۸ گیگابایت رم را دارند، اما در نسخههای ۴۸ و ۶۴ گیگابایتی نیز به فروش میرسند.
تعریف ارائهشده برای کلاس ۳ سقف توانمندی هوش مصنوعی محلی نیست، بلکه نقطه آغازی برای ردهای است که بهسرعت در حال رشد است. با تبدیل شدن قدرت پردازش هوش مصنوعی به معیاری کلیدی برای خریداران حرفهای، از این پس باید منتظر دستگاههای قدرتمندتری بود. همانگونه که اشاره شد، سرعت تحولات بسیار بالاست و فرآیند آزمونها همگام با گامهای تدریجی یا جهشهای بزرگ فناوری به تکامل ادامه خواهد داد.
ابزارهای سنجش هوش مصنوعی؛ معرفی MLPerf Client و LM Studio
با توجه به تفاوت چشمگیر توانایی در سه رده سختافزاری و تنوع پلتفرمها، سیستمهای عامل و محیطهای اجرا، هیچ آزمون منفردی نمیتواند بهتنهایی برای ارزیابی جامع کافی باشد. از این رو مجموعهای از آزمونها برای این سه دسته طراحی شده است که متناسب با توان هر گروه مقیاسپذیر هستند.
آزمونهای هوش مصنوعی با بهرهگیری از دو ابزار MLPerf Client و LM Studio انجام میشوند. ابزار MLPerf Client یک استاندارد صنعتی شناختهشده برای بنچمارک است که از مدلهای مشخصی برای سنجش عملکرد محلی هوش مصنوعی استفاده میکند. این ابزار برای ارزیابی سیستمهای کلاس ۱ و کلاس ۲ در کنار مدلها و زیرآزمونهای متناسب با توان سختافزار به کار میرود. از سوی دیگر، نرمافزار LM Studio برای اجرای اسکریپتهای اختصاصی با مدلهای بزرگتری به کار گرفته میشود که تنها روی سیستمهای کلاس ۳ با حافظههای حجیم اجرا میشوند.
این سه مرحله ارزیابی متناسب با ویژگیها و تواناییهای ویژه هر کلاس طراحی شدهاند. آزمون کلاس ۱ بهعنوان معیاری پایه روی هر سیستم مجهز به هوش مصنوعی قابل اجرا است، در حالی که آزمونهای کلاس ۲ و ۳ عملکرد سختافزار را تا پیشرفتهترین سطوح پردازشی کنونی به چالش میکشند. در ادامه جزئیات هر یک از این آزمونها بررسی میشود.
آزمونهای کلاس ۱؛ سنجش توانمندی پایه هوش مصنوعی
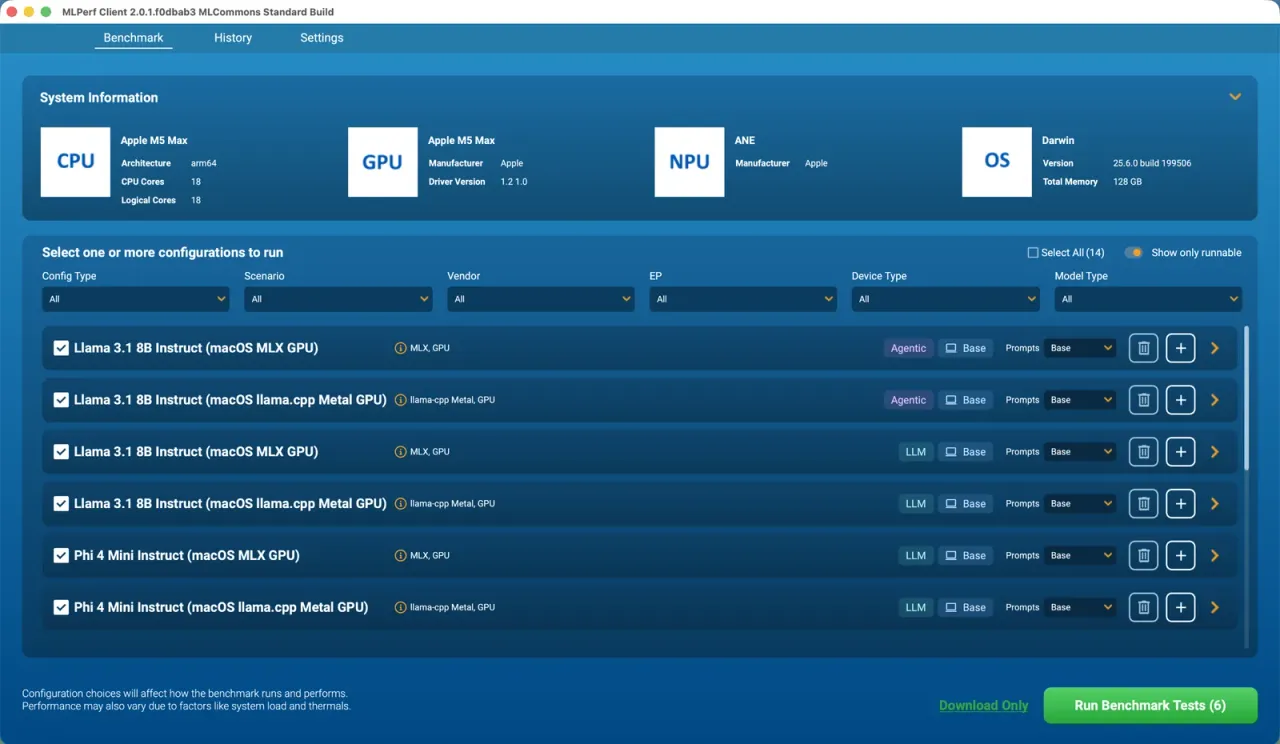
آزمون کلاس ۱ روی تمام رایانههای تحت آزمایش، از جمله لپتاپهای معمولی مجهز به NPU پایه، اجرا میشود. برای این مرحله از نسخه 1.6.1 ابزار MLPerf Client و مدل Llama 3.1 8B Instruct استفاده میشود. این مدل ۸ میلیارد پارامتری با دقت ۴ بیتی عدد صحیح کوانتیزه و برای سختافزار بهینهسازی شده است و برای اجرا به حداقل ۱۶ گیگابایت رم اصلی یا حافظه یکپارچه نیاز دارد. این آزمون به شکلی گسترده روی پلتفرمهای سختافزاری مختلف (تراشههای x86 اینتل و AMD، تراشههای مبتنی بر Arm کوالکام و انویدیا و پردازندههای سری M اپل) و سیستمهای عامل ویندوز، macOS و لینوکس پشتیبانی میشود.
این بنچمارک مجموعهای از پرامپتها را در پنج دسته شامل تولید محتوا، نگارش خلاقانه، خلاصهسازی متنی (در دو سطح سبک و متوسط) و تحلیل کد ارزیابی میکند. فرآیند آزمون شامل یک دور گرم کردن اولیه و سه دور اجرای زمانبندیشده است که میانگین عملکرد در آنها محاسبه میشود. امتیاز نهایی از میانگین هندسی زمان تولید اولین توکن (TTFT بر حسب ثانیه) و سرعت تولید توکن در ثانیه (TPS) در این پنج دسته پرامپت به دست میآید؛ معیارهایی که جزئیات آنها در بخشهای بعد تشریح خواهد شد.
آزمونهای کلاس ۲؛ استنتاج مستقیم روی دستگاه
آزمونهای کلاس ۲ برای سنجش دقیقتر توان سیستمهای قدرتمندتر مجهز به پردازنده گرافیکی مجزا و حافظه ویدیویی یا یکپارچه بزرگتر طراحی شدهاند. در این بخش نیز از ابزار MLPerf Client استفاده میشود، اما مدل Phi 4 Reasoning 14B به آزمون افزوده خواهد شد. این مدل ۱۴ میلیارد پارامتری به حداقل ۳۲ گیگابایت رم، توان پردازش خام بالا، پشتیبانی بهینه کامپایلر و پهنای باند حافظه گسترده یک کارت گرافیک مجزا یا SoC پیشرفته نیاز دارد؛ شرایطی که واحدهای NPU حتی در صورت دسترسی به حافظه بیشتر نیز توان پاسخگویی به آن را ندارند.
این آزمونها علاوه بر بهکارگیری مدلی بزرگتر که اجرای آن از توان سیستمهای کلاس ۱ خارج است، بار پردازشی سنگینتری شامل خلاصهسازی متون طولانیتر و سنجش مقیاسپذیری KV Cache (حافظه موقت محاسباتی که امکان پشتیبانی از پنجرههای زمینه بزرگتر را فراهم میآورد) را دربرمیگیرند که همگی نیازمند حجم و پهنای باند حافظه بالاتری هستند.
البته برخی دستگاههای نوین بهویژه رایانههای RTX Spark با نسخه 1.6.1 ابزار MLPerf سازگاری کاملی ندارند. در این موارد، آزمونهای معادل شامل همان مدلها و پارامترهای اصلی در نسخه 2.0.1 ابزار MLPerf به کار گرفته میشوند که از درایورهای جدیدتر و سختافزارهای تازهنفس مبتنی بر Arm64 پشتیبانی میکند. از آنجا که مدلهای مورد ارزیابی همان Llama 3.1 8B Instruct و Phi 4 Reasoning 14B هستند، نتایج به دست آمده کاملاً قابل مقایسه خواهند بود.
آزمونهای کلاس ۳؛ جریانهای کاری با پنجره زمینه طولانی
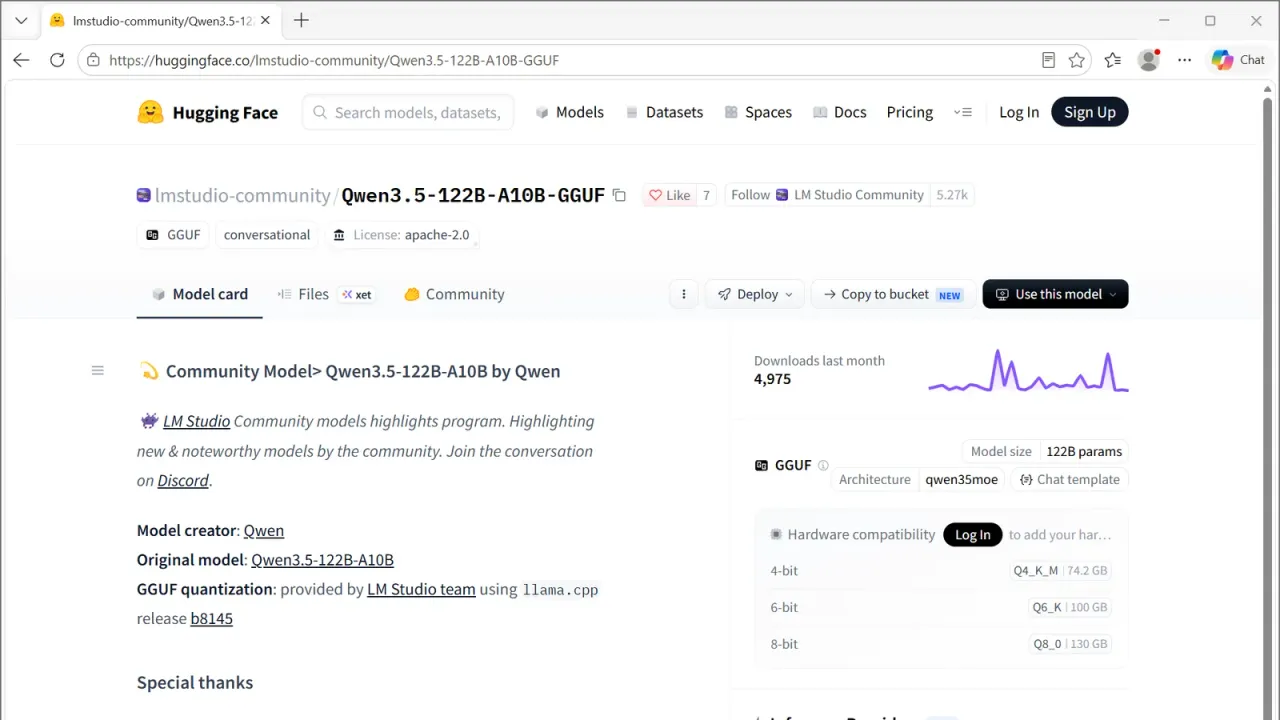
در نهایت، آزمونهای کلاس ۳ منحصراً به سیستمهای پرچمداری اختصاص دارند که قدرت استنتاج فوقالعاده بالا را با حداقل ۹۶ گیگابایت حافظه یکپارچه یا VRAM ترکیب کردهاند تا مدلهای بسیار بزرگتر هوش مصنوعی را اجرا کنند. برای ارزیابی این ابرسیستمها از بنچمارک جریان کاری در LM Studio همراه با مدل Qwen 3.5 122B A10B با کوانتیزاسیون Q4_K_M بهره گرفته میشود. در حالی که سیستمهای ردهپایینتر کلاس ۱ و ۲ با مدلهای ۸ یا ۱۴ میلیارد پارامتری سنجیده میشوند، این مدل غولپیکر با ۱۲۲ میلیارد پارامتر از معماری ترکیبی از متخصصان (MoE) استفاده میکند که دانش جامع و سرعت محاسباتی را برای ارائه پاسخهای باکیفیتتر بهشکل چشمگیری افزایش میدهد.
همانطور که اشاره شد، شرط دارا بودن حداقل ۹۶ گیگابایت حافظه برای آزمونهای کلاس ۳ به این معناست که نسخههای مختلف یک خط تولید بسته به میزان حافظه ممکن است در کلاس ۲ یا ۳ قرار گیرند. با این وجود، از آنجا که آزمونهای کلاس ۱ و ۲ روی دستگاههای کلاس ۳ نیز تکرار میشوند، همواره دادههای مقایسهای معتبری میان ردههای مختلف در دست خواهد بود.
معیارهای کلیدی ارزیابی؛ نحوه سنجش هوش مصنوعی
در تمام این آزمونها دو شاخص کلیدی مورد ارزیابی قرار میگیرند: زمان پاسخدهی اولیه (TTFT) و نرخ تولید توکن (TPS).
به زبان ساده، معیار TTFT نمایانگر زمان واکنش اولیه است و مدتزمان تأخیر تا شروع پاسخدهی مدل به پرامپت کاربر را ثبت میکند. ایجاد اولین توکن معمولاً به زمان بیشتری نسبت به توکنهای بعدی نیاز دارد، زیرا این مرحله پیشبارگذاری بهشدت متکی به توان پردازشی است و تأثیر مستقیمی بر حس سرعت یا کندی پاسخ در نظر کاربر دارد.
در مقابل، شاخص TPS بیانگر نرخ تولید توکن در ادامه پاسخ است. اگر TTFT را زمان انتظار تا شروع تایپ پاسخ بدانیم، TPS سرعت تایپ پس از آغاز کار خواهد بود. این شاخص فاز رمزگشایی (Decode) در فرآیند استنتاج را میسنجد که بیش از هر چیز وابسته به پهنای باند حافظه سیستم است.
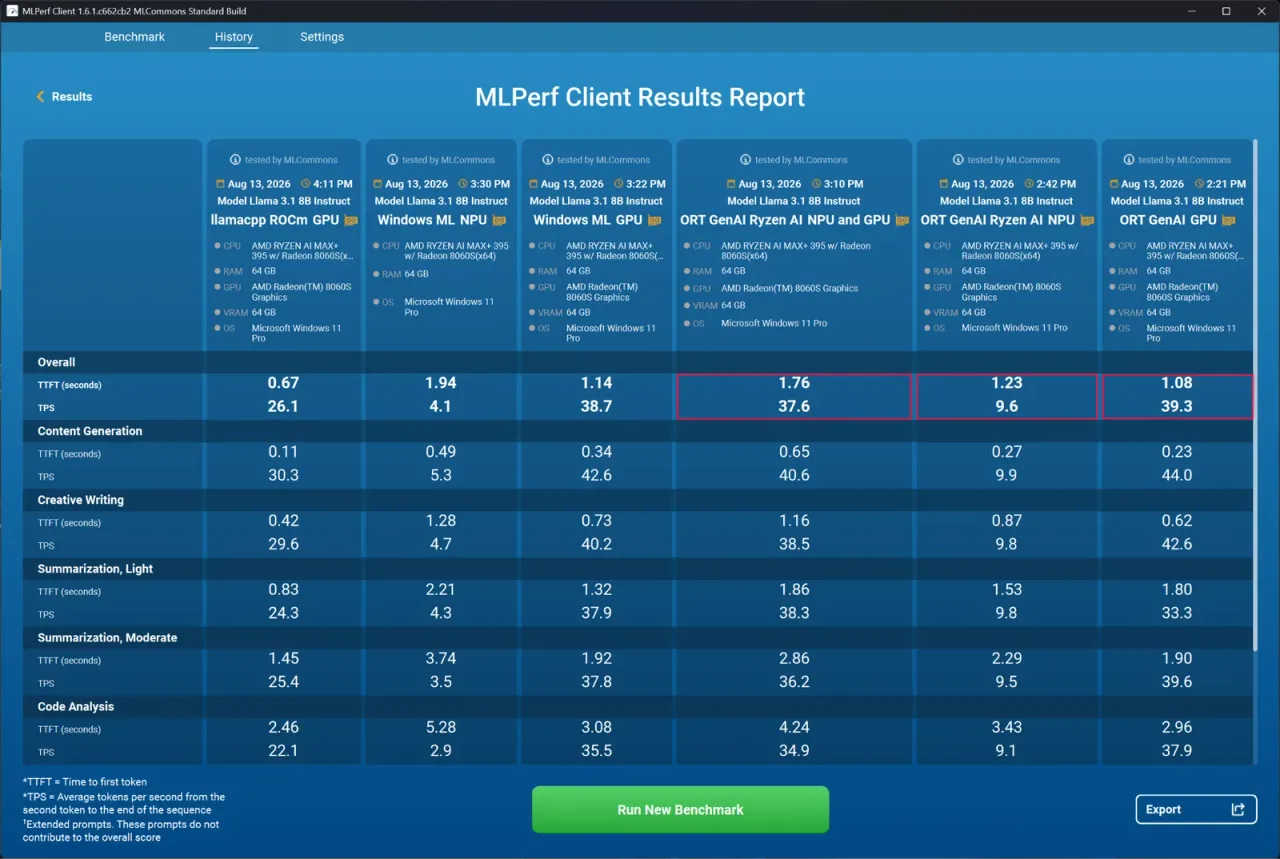
بارهای پردازشی در این بنچمارکها صرفاً مکالمات کوتاه چت نیستند، بلکه وظایف کاربردی و ساختاریافته دنیای واقعی را شبیهسازی میکنند. آزمونهای کلاس ۱ شامل تولید محتوا، نگارش خلاقانه، خلاصهسازی متون کوتاه (فشردهسازی متن ۱۰۰۰ توکنی به پاسخی ۱۲۸ توکنی)، خلاصهسازی متوسط (متن ۱۶۰۰ توکنی به پاسخ ۲۵۶ توکنی) و تحلیل کد هستند که در آنها هر توکن بخشی از کلمات پرامپت یا متون ورودی کاربر را شامل میشود. آزمونهای کلاس ۲ با پردازش عمیقتر کدها و خلاصهسازی متون طولانیتر (ورودیهای ۴۰۰۰ و ۸۰۰۰ توکنی فشردهشده به ۱۲۸ توکن) فشار محاسباتی بیشتری بر سختافزار وارد میکنند.
پیچیدهترین ارزیابی به کلاس ۳ تعلق دارد که در آن پرامپتهایی با طولهای متغیر از ۸۰۰۰ تا ۶۴ هزار توکن ورودی در چارچوب یک پنجره زمینه حدوداً ۶۵ هزار توکنی تکرار میشوند؛ پنجرهای که بیانگر حداکثر حجم اطلاعات نگهداریشده در حافظه فعال مدل است. با فرض اینکه هر ۱۰۰ توکن معادل حدود ۷۵ کلمه باشد، چنین درخواستی معادل بررسی متونی بین ۶۰۰۰ تا ۴۸ هزار کلمه خواهد بود. در کلاس ۳ نیز معیارهای TTFT و TPS ثبت میشوند، اما نتایج بر اساس طول پرامپت تفکیک میگردند تا اثر اندازه داده ورودی بر کارایی سختافزار به روشنی ارزیابی شود.
بیتردید این معیارها با محدودیتهایی نیز همراهاند. اگرچه سنجش آنها ساده است، اما صرفاً سرعت خروجی را نشان میدهند و کیفیت پاسخ یا دقت اطلاعات را ارزیابی نمیکنند. در واقع اغلب میان سرعت و کیفیت رابطهای معکوس برقرار است و میتوان با فدا کردن دقت و کیفیت که پردازش سنگینی میطلبند، سرعت خروجی مدل را افزایش داد. با اینکه استفاده از آزمونهای معتبر و مدلهای استاندارد به کاهش این ابهامات کمک میکند، اما سنجش هوش مصنوعی تنها با تکیه بر آمار و ارقام عددی بیانگر تمام واقعیت نیست.
گامهای بعدی؛ سنجش راندمان مصرف انرژی، ایجنتهای مستقل و تولید تصویر
در مراحل بعدی قرار است معیارهای تکمیلی دیگری نیز به آزمونها اضافه شوند؛ از جمله اندازهگیری توان مصرفی کل سیستم با تحلیلگرهای دقیق توان و محاسبه نسبت عملکرد به ازای هر وات مصرف انرژی. این شاخص بهویژه در محیطهای کاری و تجاری که مدیریت هزینههای برق اهمیتی راهبردی دارد، نقشی اساسی خواهد داشت. تجهیز آزمایشگاه به ابزارهای تخصصی برای این بخش در دست تکمیل است، زیرا سنجش دقیق راندمان مصرف انرژی نیازمند دستگاههایی بسیار فراتر از توانسنجهای معمولی است.
از آنجا که کاربرد هوش مصنوعی محلی فراتر از تعاملات متنی است، قابلیتهای جدید ابزار MLPerf Client برای سنجش تولید تصویر و ابزارهای مبتنی بر ایجنت نیز در دست بررسی قرار دارد. افزون بر این، برای دستیابی به ارزیابیهای کاربردیتر فراتر از ارقام محض، سناریوهایی نظیر راهاندازی ایجنتهای محلی، محول کردن وظایف روزمره به آنها و اجرای جریانهای کاری چندوجهی میان برنامههای مختلف در حال طراحی هستند. البته این آزمونها باید روی تمام تراشهها، سیستمهای عامل و محیطهای اجرا نتایجی کاملاً تکرارپذیر و استاندارد ارائه دهند و به همین دلیل پیش از اعتبارسنجی نهایی، به بسته آزمونهای فعلی افزوده نشدهاند.
این روند تأکیدی دوباره بر همان نکته آغازین است: استانداردهای فعلی تنها نقطه شروع به حساب میآیند و چشمانداز هوش مصنوعی با شتابی شگرف دگرگون میشود. فرآیند پایش ابزارها و روشهای جدید ارزیابی بهطور مستمر ادامه دارد و همگام با جهشهای سختافزاری و نرمافزاری، آزمونهای پیشرفتهتری این بسته اولیه را تکمیل خواهند کرد.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
همکاری چندساله SpaceX با کوالکام برای توسعه زیرساخت زمینی سرویس موبایل Starlink
شرکت SpaceX در قالب قراردادی چندساله با کوالکام، تجهیزات و فناوریهای موردنیاز برای ساخت ایستگاههای زمینی سرویس Starlink Mobile را تأمین میکند. این شبکه زمینی با هدف رقابت با غولهای مخابراتی آمریکا توسعه مییابد و بهعنوان مکمل ماهوارههای استارلینک، پوشش ارتباطی پرسرعت و پایدارتری را برای گوشیهای هوشمند فراهم خواهد کرد.
چگونه مصرف منعطف برق، بحران انرژی مراکز داده هوش مصنوعی را حل میکند؟
رشد روزافزون مراکز داده فشار سنگینی به شبکههای برق وارد کرده و صفهای انتظار چندساله برای دریافت انرژی به وجود آورده است. پیادهسازی الگوهای منعطف مصرف برق و استفاده از باتریهای کمکی به شرکتهای هوش مصنوعی اجازه میدهد ظرف چند ماه به شبکه متصل شوند. این رویکرد هوشمندانه ضمن کاهش هزینههای ارتقای زیرساخت، از معطلی طولانی و هدررفت میلیاردها دلار توان پردازشی جلوگیری میکند.
۵ اصل حیاتی برای خرید امن با دستیارهای هوش مصنوعی؛ توصیههای کارشناس امنیت سایبری
با افزایش محبوبیت دستیارهای هوش مصنوعی برای خرید آنلاین و انتخاب هدایا، خطراتی مانند سایتهای جعلی و افشای ناخواسته اطلاعات شخصی نیز شدت گرفته است. کارشناسان امنیت سایبری با بررسی شیوههای نفوذ کلاهبرداران، راهکارهایی عملی برای محافظت از حریم خصوصی و تجربه خریدی امن با ابزارهایی مانند ChatGPT و Gemini ارائه میدهند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.