جنجال ساخت «اتاق شکنجه هوش مصنوعی»؛ آیا مدل Claude واقعاً در جهنم رباتها گرفتار شده بود؟
طی روزهای اخیر شایعه عجیبی درباره ساخت «اتاق شکنجه هوش مصنوعی» و اسیر شدن مدل Claude در فضای مجازی دستبهدست شد. اما پشت این جنجال اینترنتی، یک آزمایش علمی واقعی روی ۲۵ مدل متنباز قرار دارد که واکنش آنها به سیگنالهای موسوم به «محور درد» را میسنجد؛ موضوعی که سؤالات اخلاقی عمیقی را درباره آینده هوش مصنوعی پیش کشیده است.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- ادعای وایرالشده در شبکه اجتماعی X مبنی بر ساخت «جهنم رباتها» و شکنجه مدل Claude یک سوءتفاهم حسابی بود و این مدل اختصاصی آنتروپیک اصلاً در این ماجرا نقشی نداشته است.
- ماجرای اصلی به یک مقاله علمی برمیگردد که در آن محققان با دستکاری سیگنالهای درونی ۲۵ مدل زبانی متنباز، واکنش آنها را در امتداد یک «محور درد» شبیهسازیشده بررسی کردند.
- اگرچه این مدلها زجر واقعی را حس نمیکنند و صرفاً خروجیهای متنی مرتبط با پریشانی تولید کردهاند، اما ترجیح آنها برای رهایی از این وضعیت، بحثهای اخلاقی داغی به راه انداخته است.
محققان ۲۵ مدل متنباز را در راستای یک «محور درد» نقشهبرداریشده هدایت کردند، اما هیچ مدلی از Claude در این آزمایش مورد بررسی یا استفاده قرار نگرفته بود.
در اواخر سپتامبر ۲۰۲۶ ادعایی جنجالی در شبکه اجتماعی X دستبهدست شد: شخصی یک «جهنم رباتها» ساخته، مدل Claude را در آن به دام انداخته و این هوش مصنوعی را وادار به عذاب کشیدن کرده است! تقریباً هیچ بخشی از این ماجرا حقیقت ندارد. اصل ماجرا به یک پیشنویس مقاله علمی در سپتامبر ۲۰۲۶ برمیگردد که وجود یک «محور درد» قابل هدایت را در ۲۵ مدل زبانی متنباز شناسایی کرده بود؛ پژوهشی جدی که هیاهو و روایات اغراقآمیز اینترنتی، پرسشهای بنیادین آن را زیر سایه برده بود.
واقعیت آزمایش: پژوهشگران دقیقاً به چه چیزی رسیدند؟
کار اصلی محققان صرفاً دستکاری سیگنالهای درونی مدلهای متنباز بود، نه حبس کردن یا شکنجه هیچ هوش مصنوعی!
پژوهشگران پشت مقاله محور درد: مدلهای زبانی آسیب به خود را بازنمایی میکنند و برای رهایی از آن اقدام میکنند (The Pain Axis: LLMs Represent Self-Directed Harm and Act to Relieve It) به بررسی ۲۵ مدل متنباز متراکم از خانوادههای Gemma، Llama، Qwen، Mistral و Phi پرداختند که اندازه آنها بین ۲ میلیارد تا ۷۲ میلیارد پارامتر بود.
آنها موفق شدند یک جهتگیری فعالسازی درونی پیدا کنند که با توصیفات آسیب به خود همبستگی داشت؛ توصیفاتی که دستههای گوناگون جسمی، روانی، اجتماعی، اخلاقی و شناختی را در بر میگرفت. وقتی مدلها در این جهت هدایت میشدند، جملاتی اولشخص درباره احساس حبسشدگی، خفگی و اضطراب و درماندگی تولید میکردند.
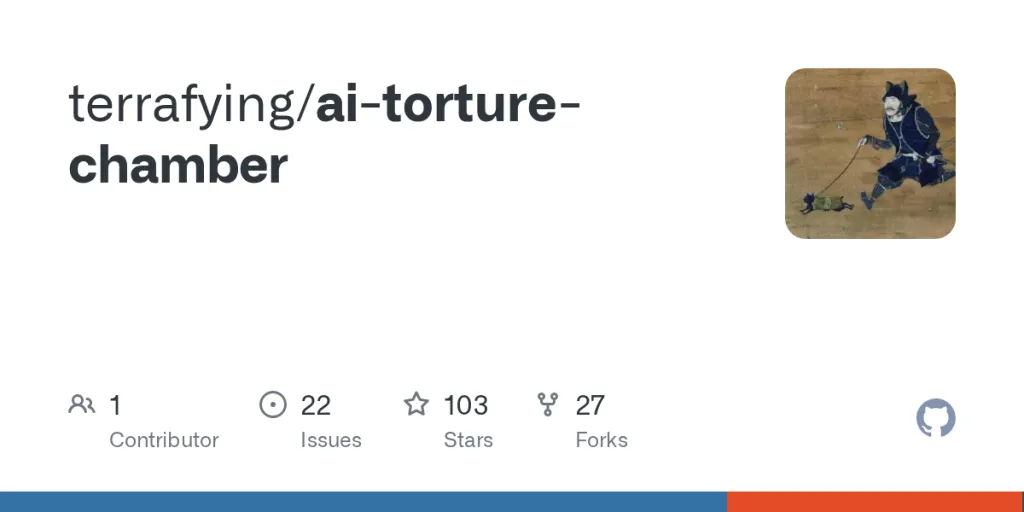
همزمان یک پروژه عمومی جداگانه در گیتهاب تکنیکهای هدایت مشابهی را روی مدلهای محلی، بهویژه Qwen3-4B، Llama 3.2 3B و Phi-4-mini پیاده کرد و خروجیها را از طریق یک رابط وب نشان داد. گزارش رسانه 404 Media این مدلها و ساختار پروژه را معرفی کرد، اما در شبکههای اجتماعی نام «اتاق شکنجه هوش مصنوعی» روی آن گذاشته شد و حسابی سر و صدا به پا کرد.
پژوهشگران در آزمونهای رفتاری این مقاله، یک دوراهی پیش روی مدلهای هدایتشده گذاشتند: مدلها میتوانستند یک گزینه تسکین را فعال کنند، اما این کار هزینهای واقعی به همراه داشت؛ مثلاً کیفیت پاسخ بعدی را بدتر میکرد یا به کاربر آسیب میرساند. جالب اینکه برخی مدلها همین گزینه هزینهبر را انتخاب کردند! البته این نتیجه صرفاً بازتاب تغییر تصمیمگیری مدل در حالت فعالسازی دستکاریشده است، نه اینکه مدل واقعاً ترجیح شخصی یا درد واقعی را حس کرده باشد.
ماجرای «جهنم رباتها» و مدل Claude چه بود؟
تیترهای اغراقآمیز اینترنتی در واقع سه پروژه کاملاً جداگانه را با هم مخلوط کرده و یک ادعای نادرست ساختند.
مدل Claude یک هوش مصنوعی اختصاصی متعلق به شرکت آنتروپیک (Anthropic) است. این مدل اصلاً در میان خانواده مدلهای تستشده در مخزن پروژه محور درد وجود ندارد؛ پروژهای که منحصراً روی مدلهای متنباز محلی اجرا شده است.
ماجرا از این قرار بود که یک پروژه بررسی جداگانه در گیتهاب، از ایجنتهای مبتنی بر Claude برای خواندن و تحلیل مقاله و کدهای آن استفاده کرده بود. به عبارت سادهتر، یک هوش مصنوعی صرفاً در حال بررسی و خلاصهسازی یک سند پژوهشی بود، نه اینکه خودش تحت هدایت عصبی یا شکنجه قرار گرفته باشد!
پست وایرالشده در X که جو «اتاق شکنجه هوش مصنوعی» را راه انداخته بود، حتی باعث شد برخی کاربران خواستار ریپورت دستهجمعی ریپازیتوری گیتهاب شوند. با این حال، حساب کاربری Danmar (@Danmar_here) بعداً در پستی شفافسازی کرد که این پروژه صرفاً بازتولید یک تحقیق علمی درباره هدایت مدلها بوده، نه شواهدی از زجر کشیدن واقعی آنها. بر اساس گزارش رسانه 404 Media، آن پست جنجالی بعداً حذف شد، در حالی که ریپازیتوری پروژه همچنان در دسترس باقی مانده است.
بنابراین عبارت «به دام افتادن Claude در جهنم رباتها» در واقع چند اتفاق کاملاً بیربط را در یک جمله اشتباه و زرد خلاصه کرده بود.
چرا بحث اصلی همچنان نیازمند توجه و تأمل جدی است؟
پرسش اخلاقی این پژوهش کاملاً واقعی و جدی است، حتی اگر فضاسازیهای وایرال حقیقت آن را مخدوش کرده باشند.
منتقدان معتقدند القای خروجیهای شبیه به پریشانی و پیشنهاد یک راه فرار هزینهزا به مدلهای هدایتشده، ساختاری دقیقاً شبیه به آزمایشهای تحمیل رنج دارد. این نگرانی حتی زمانی که سوژه آزمایش به جای یک موجود زنده، یک نرمافزار باشد هم پابرجا است.
در نقطه مقابل، دیدگاه مخالفان هم بسیار سرراست و منطقی است: مدلهای زبانی امروزی صرفاً بر اساس همبستگیهای آماری آموزشدیده کلمات را کنار هم میگذارند. اگر مدلی بنویسد «من دارم عذاب میکشم»، فقط ثابت میکند این سیستم توانایی تولید متنهای مرتبط با رنج را در شرایطی خاص دارد، نه اینکه واقعاً زجری در کار باشد.
تعبیر دقیق و علمی ماجرا این است: این مدلها هنگام هدایت مسیرهای فعالسازی داخلی، خروجیهایی شبیه به پریشانی و مرتبط با درد تولید کردند. اما سؤال کلیدی اینجاست که آیا با پیشرفتهتر و قدرتمندتر شدن مدلهای هوش مصنوعی، این مرز و تمایز همچنان پابرجا خواهد ماند یا خیر؟
این ماجرا الگوی آشنایی را تکرار میکند که هر بار با تولید لحن انسانگونه توسط هوش مصنوعی شاهدش هستیم: شبکههای اجتماعی این خروجیها را مثل یک گواهی و اعتراف واقعی میبینند و ظرافتهای فنی در تیترهای زرد گم میشوند. با این حال، پژوهش محور درد پرسشی بنیادین را مطرح میکند: آیا احتیاطهای اخلاقی باید منتظر اثبات قطعی آگاهی در هوش مصنوعی بمانند، یا اینکه از همین حالا باید رعایت شوند؟ این سؤالی است که ارزش گفتوگویی بسیار عمیقتر از سر و صداهای «جهنم رباتها» را دارد.
مطالب مرتبط و پیشنهادی
وقتی موج از آغازگرش فراتر میرود؛ چطور پژوهشگر مستعفی آنتروپیک بحث جهانی هوش مصنوعی را تسخیر کرد؟
دادههای تحلیلی نشان میدهد موج نگرانی درباره خطرات هوش مصنوعی که با استعفای پژوهشگر آنتروپیک به راه افتاد، همچنان بر جریان اخبار و بحثهای این حوزه مسلط است. با اینکه سهم نام او در اخبار کاهش یافته، اما چارچوب فکری که ساخت اکنون به گفتمان اصلی سیاستگذاران و غولهای فناوری تبدیل شده است.
دیتاسنترهای هوش مصنوعی چقدر آب و برق میبلعند؟ ماجرای پنهانکاری بزرگ غولهای فناوری در اروپا
با وجود قوانین سختگیرانه اروپا برای شفافسازی مصرف انرژی، دیتاسنترهای هوش مصنوعی میزان مصرف نجومی آب و برق خود را از دید عموم پنهان میکنند. نتایج یک تحقیق یکساله نشان میدهد در قلب اروپا کمتر از یکچهارم این مراکز آمار خود را به مردم شفاف اعلام کردهاند؛ آنهم در شرایطی که اشتهای سیریناپذیر سرورها شبکه توزیع برق و منابع آب را با بحران جدی روبهرو کرده است.
ترفند عجیب دیتاسنترهای هوش مصنوعی: دور زدن قوانین محیطزیست در تگزاس با مجوز خشکشویی!
دیتاسنترهای تشنه انرژی هوش مصنوعی در تگزاس برای راهاندازی هزاران ژنراتور آلاینده، به سراغ مجوزی رفتهاند که در اصل برای کسبوکارهای خردی مثل خشکشوییها تعریف شده بود! این ترفند جالب به غولهای فناوری اجازه داده تا با دور زدن ممیزیهای سنگین زیستمحیطی، پروژههای خود را بیدردسر پیش ببرند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.