رونمایی علیبابا از Qwen Intelligence: سه ایجنت هوش مصنوعی برای اتوماسیون گوشیهای هوشمند
علیبابا از سیستم جدید Qwen Intelligence رونمایی کرد که با استفاده از سه ایجنت تخصصی، وظایف پیچیده در گوشیهای هوشمند را به صورت خودکار انجام میدهد. ایجنت Qwen-UI در بنچمارکهای مختلف عملکرد درخشانی ثبت کرده است.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- معرفی سیستم سهگانه Qwen Intelligence توسط علیبابا شامل ایجنتهای برنامهریز، رابط کاربری و خلاق برای مدیریت خودکار گوشیهای هوشمند.
- انتشار بنچمارک منبعباز MobileWorld برای ارزیابی جریانهای کاری طولانی و چندبرنامهای با قابلیت بررسی دقیق وضعیت سیستم.
- ثبت امتیاز ۸۲٫۱ توسط Qwen-UI-Agent در بنچمارک MobileWorld و پشت سر گذاشتن مدلهای رقیب در کنترل رابط کاربری.
علیبابا اتوماسیون گوشیهای هوشمند را به سه ایجنت Qwen میسپارد
آزمایشگاه Tongyi متعلق به شرکت Alibaba از سیستم جدید Qwen Intelligence رونمایی کرد؛ یک پشته نرمافزاری مبتنی بر سه ایجنت که برای برنامهریزی وظایف در گوشیهای هوشمند، کار با اپلیکیشنها و تولید تصویر طراحی شده است. این آزمایشگاه همچنین بنچمارک منبعباز MobileWorld را منتشر کرد که برای ارزیابی جریانهای کاری طولانیتر در چندین اپلیکیشن، نیاز به شفافسازی درخواستها و ترکیب تعاملات صفحه نمایش با ابزارهای خارجی توسعه یافته است.
ایجنتهای موبایل درخواستهای مطرحشده به زبان طبیعی را به مجموعهای از اقدامات در اپلیکیشنها تبدیل میکنند. سیستم Qwen Intelligence این فرآیند را بین سه بخش مجزا تقسیم میکند:
- Mobile Planner Agent: درخواستها را تجزیه کرده، ایجنتهای زیرمجموعه را هماهنگ میکند و وضعیت وظایف را زیر نظر میگیرد.
- Mobile Use Agent: در صورت وجود ابزارهای ساختاریافته، گوشی را از طریق آنها کنترل میکند و در غیر این صورت، از لمس و کشیدن (Swipe) روی صفحه بهره میبرد. Alibaba این بخش را با نام Qwen-UI-Agent منتشر کرده است.
- Mobile Creative Agent: تنها در حدود سه ثانیه، از روی یک پرامپت یکجملهای تصویر تولید میکند. بنا بر اعلام Alibaba، سرعت این ایجنت تقریباً دو برابر رقبای پیشرو است؛ هرچند مقایسه دقیق تأخیر نیازمند سختافزار و تنظیمات تولید یکسان است.
میزان دسترسی به هر یک از این اجزا متفاوت است. کد و منابع ارزیابی MobileWorld به صورت عمومی در دسترس قرار دارند، ایجنت برنامهریز مخزن اختصاصی خود را دارد و جزئیات سایر ایجنتها در صفحات پروژه منتشر شده است. تیمهای توسعه باید وزن مدلها، مجوزها، اپلیکیشنهای پشتیبانیشده و پیشنیازهای دستگاه را برای هر بخش بررسی کنند. آمارهای عملکردی ارائهشده توسط سازنده گزارش شدهاند و هنوز توسط مراجع مستقل تایید نشدهاند.
بنچمارک MobileWorld جریانهای کاری را گسترش میدهد
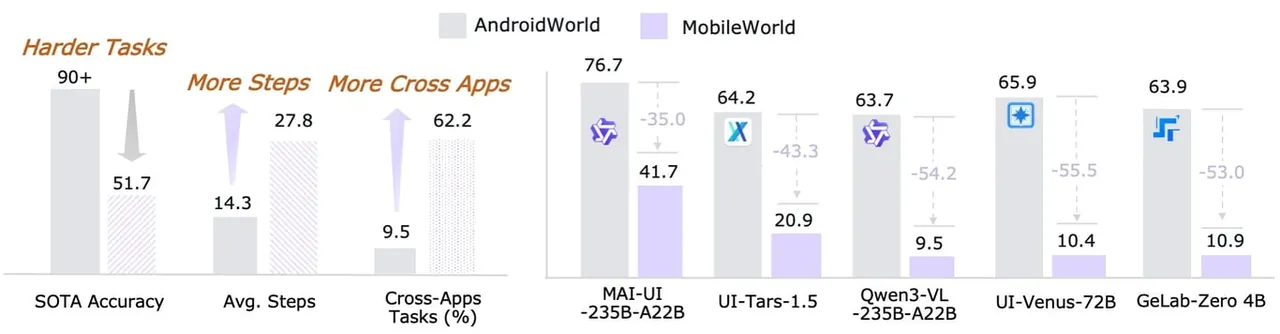
بنچمارک MobileWorld شامل ۲۰۱ وظیفه در ۲۰ اپلیکیشن مختلف است. وظایف این بنچمارک به طور میانگین تقریباً دو برابر بنچمارک رایج AndroidWorld به مراحل بیشتری نیاز دارند و بسیار بیشتر شامل جریانهای کاری بین چند اپلیکیشن میشوند.
معیار | MobileWorld | AndroidWorld |
|---|---|---|
میانگین مراحل تکمیل | ۲۷٫۸ | ۱۴٫۳ |
وظایف بینبرنامهای (Cross-app) | ۶۲٫۲٪ | ۹٫۵٪ |
دو دسته از وظایف، ارزیابیها را فراتر از دستورالعملهای ثابت و ناوبری در صفحه نمایش میبرند:
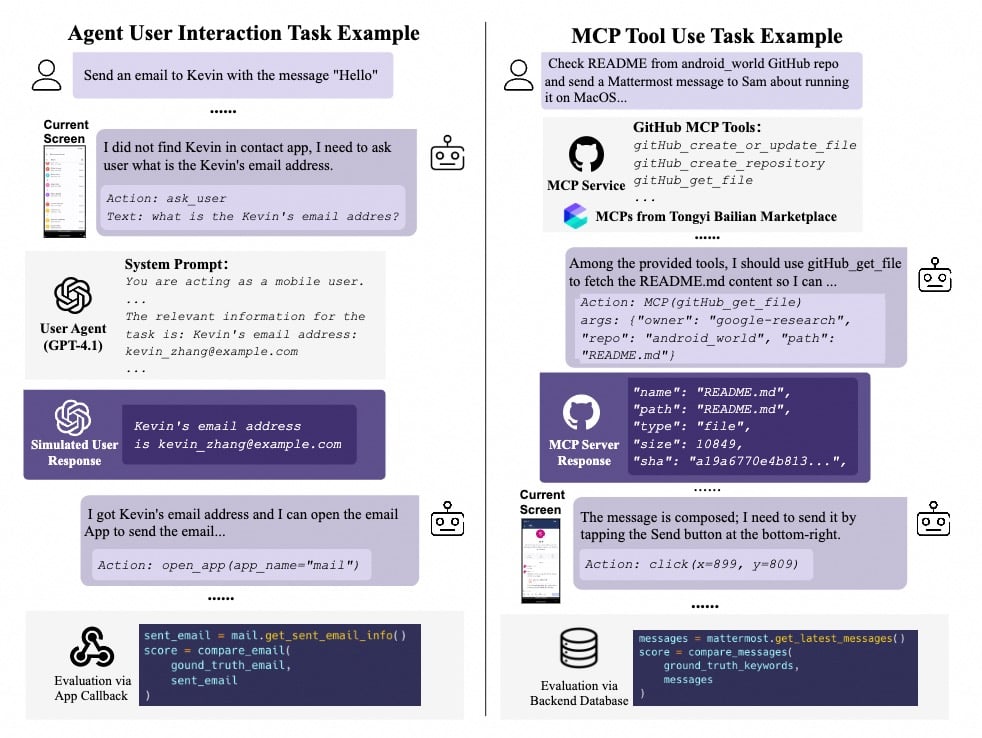
- وظایف تعامل ایجنت و کاربر: ۲۲٫۴ درصد از این مجموعه آزمایش میکند که آیا ایجنت در صورت مبهم بودن دستورات، سوالات مفیدی میپرسد یا خیر. یک کاربر شبیهسازیشده مبتنی بر GPT-4.1 پاسخها را ارائه میدهد تا تعاملات قابل تکرار باشند.
- وظایف تقویتشده با MCP: در ۱۹٫۹ درصد از وظایف، ایجنتها باید کنترل رابط گرافیکی را با ابزارهای خارجی ارائهشده از طریق پروتکل زمینه مدل (MCP) ترکیب کنند.
بررسی وضعیت، اجرای مجدد را امکانپذیر میکند
بنچمارک MobileWorld درون Docker همراه با یک شبیهساز کامل اندروید، بکاندهای محلی اپلیکیشنها و سیستم اعتبارسنجی قطعی اجرا میشود. سیستم ارزیاب برای تعیین اینکه آیا ایجنت به وضعیت نهایی مطلوب رسیده است یا خیر، سوابق پایگاه داده، فضای ذخیرهسازی محلی و فراخوانیهای اپلیکیشن (callbacks) را بررسی میکند.
سرویسهای محلی به این بنچمارک اجازه میدهند تا بدون وابستگی به APIهای متغیر شرکتهای ثالث، برنامههای وابسته به بکاند مانند پیامرسانها را در خود جای دهد. بررسی وضعیت نهایی همچنین ابهامات مربوط به ارزیابی بصری یا دستی را کاهش میدهد؛ جایی که ممکن است ظاهر صفحه نمایش درست به نظر برسد اما تراکنش زیرساختی با شکست مواجه شده باشد.
ترکیب ابزارها و کنترل لمسی در Qwen-UI-Agent
بر اساس گزارش Alibaba، ایجنت Qwen-UI-Agent در بنچمارک MobileWorld امتیاز ۸۲٫۱ را کسب کرده است، در حالی که این رقم برای Seed 2.1 Pro برابر ۷۳٫۲ و برای GPT-5.6 معادل ۷۰٫۱ بوده است. این مدل در MobileWorld-Real به امتیاز ۹۲٫۲ و در AndroidDaily به امتیاز ۹۷٫۵ دست یافته است.
بنچمارک | مدل | امتیاز |
|---|---|---|
MobileWorld | Qwen-UI-Agent | ۸۲٫۱ |
Seed 2.1 Pro | ۷۳٫۲ | |
GPT-5.6 | ۷۰٫۱ | |
MobileWorld-Real | Qwen-UI-Agent | ۹۲٫۲ |
AndroidDaily | Qwen-UI-Agent | ۹۷٫۵ |
امتیازهای نسخههای مختلف بنچمارکها به طور مستقیم قابل مقایسه نیستند. تفاوتها در انتخاب وظایف، محیط اجرا و ابزارهای در دسترس میتوانند بر نتایج تأثیر بگذارند؛ بنابراین، فاصله ۱۰٫۱ امتیازی بین MobileWorld و MobileWorld-Real را نمیتوان بدون انجام آزمایشهای کنترلشده، مستقیماً به استفاده از API یا MCP نسبت داد.
ایجنت Qwen-UI-Agent قابلیتهای خود را در خارج از حوزه کنترل گوشی نیز حفظ کرده است. این مدل امتیاز ۷۲٫۴ را در بنچمارک چندوجهی MMMU-Pro، امتیاز ۸۲٫۸ را در بنچمارک ریاضیات بصری MathVision و امتیاز ۵۰٫۱ را در Terminal-Bench 2.0 ثبت کرده است. طبق اعلام Alibaba، مدلهای UI-Venus 30B و GUI-Owl 32B که برای رابطهای گرافیکی تخصصی شدهاند، در Terminal-Bench به ترتیب امتیازهای ۳٫۲ و ۰٫۰ را به دست آوردهاند.
با این حال، تعامل در محیط دسکتاپ هنوز از پایداری کمتری برخوردار است. ایجنت Qwen-UI-Agent در بنچمارک OSWorld-v2 امتیاز ۴۰٫۰ را برای پیشرفت نسبی ثبت کرده که پایینتر از امتیاز ۵۴٫۸ مدل Claude Opus 4.8 است. بنچمارک OSWorld کار با رایانه را در وظایف طولانیتر دسکتاپ ارزیابی میکند و این نتیجه نشاندهنده چالشهای ادامهدار در درک دقیق رابط کاربری و اجرای زنجیره طولانی از اقدامات است.
آموزش ایجنت برنامهریز با استفاده از سوابق اجرا
ایجنت برنامهریز Qwen-Planner-Agent از یک مدل ۲۷ میلیارد پارامتری همراه با یک ساختار وضعیتمحور بهره میبرد که حافظه را ذخیره کرده، اسکیلهای قابل استفاده مجدد را مدیریت میکند و ایجنتهای زیرمجموعه را به کار میگیرد. بر اساس گزارش Alibaba، این ایجنت در بنچمارک MobilePA-Bench امتیاز کلی ۷۷٫۰۵ درصد را کسب کرده است که ۹٫۸۳ واحد درصد بالاتر از خط پایه تعیینشده توسط تیم سازنده است.
مدل | امتیاز کلی |
|---|---|
Qwen-Planner-Agent | ۷۷٫۰۵٪ |
GPT 6 Astra | ۷۶٫۸۴٪ |
Claude Opus 5 | ۷۵٫۷۱٪ |
شرکت Alibaba هزینه توکنهای خروجی را حدود ۲٫۴۱ دلار به ازای هر ۱۰۰۰ وظیفه تخمین میزند. این برآورد شامل توکنهای ورودی، زیرساخت دستگاه و میزبانی اپلیکیشنها نمیشود؛ عواملی که همگی در محاسبه هزینههای نهایی تولید اهمیت دارند.
تیم توسعهدهنده، روش آموزشی خود را CARE (مخفف آموزش برنامهریز تطبیقپذیر با مهارت) نامیده است. این روش، یادگیری نظارتشده با تمرکز بر برنامهریزی را با یادگیری تقویتی در محیطهای ترکیبی ادغام میکند. تکنیک CARE پاداشها و برآورد مزیتها را بر اساس میزان مهارت فعلی مدل تنظیم میکند؛ به طوری که به موارد از پیش تسلطیافته وزن کمتری میدهد و در عین حال، شکستهای دشوار را برای حفظ ثبات آموزش مقیاسبندی میکند.
سوابق اجرای ایجنتهای مستقرشده، مجدداً به فرآیند ساخت وظایف، انتخاب مسیرها و آموزش برنامهریز بازگردانده میشوند. این سیستم میتواند از این سوابق برای شناسایی خطاهای پرتکرار، گردآوری نمونههای بهتر و بهبود اسکیلهای در دسترس برای اجراهای بعدی استفاده کند.
دستور پخت غذاها به آزمونهای چندبرنامهای تبدیل میشوند
دموهای ارائهشده توسط Alibaba گستره اهداف این سیستم را به خوبی نشان میدهند. در یکی از وظایف، ایجنت پلتفرم Douyin را برای یافتن پربازدیدترین پست مربوط به دستور پخت یک غذا جستجو میکند، مواد لازم را استخراج کرده، اپلیکیشن خرید خواروبار Hema را باز میکند، ادویهها را کنار میگذارد، اقلام باقیمانده را به سبد خرید اضافه کرده و زمان ارسال را برنامهریزی میکند. وظیفه دیگر، جستجوی هتل در Trip.com را با مقایسه زمان پیادهروی در پلتفرم Amap ترکیب میکند.
این جریانهای کاری قابلیتهایی را میسنجند که وظایف کوتاه و تکبرنامهای به ندرت آنها را پوشش میدهند:
- حفظ وضعیت در چندین اپلیکیشن و در زنجیرههای طولانی از اقدامات
- اعمال محدودیتهایی مانند بودجهبندی، استثنائات و زمانبندی ارسال
- درخواست شفافسازی پیش از انجام اقدامات مهم و پیامددار
- ترکیب APIهای ساختاریافته یا ابزارهای MCP با تعاملات مبتنی بر صفحه نمایش
- بازیابی و اصلاح روند در صورت شکست اپلیکیشن، فراخوانی ابزار یا مراحل میانی
ادغام APIها در ساختار ایجنتها
بنچمارک MobileWorld راهی را در اختیار توسعهدهندگان قرار میدهد تا معماریهای ترکیبی از برنامهریزها، فراخوانی ابزارها و کنترل گرافیکی را در شرایطی قابل تکرار آزمایش کنند. ابزارهای نظارتی بکاند آن نیز دستههایی از اپلیکیشنها را پوشش میدهند که به دلیل نیاز به پیامرسانی، حسابهای کاربری یا وضعیت سمت سرور، اغلب در مجموعههای آزمایشی قطعی نادیده گرفته میشدند.
طراحی این سیستم چندین رویکرد کاربردی را برای توسعه سیستمهای مبتنی بر ایجنت موبایل پیشنهاد میدهد:
- در صورت امکان، اقدامات پایدار اپلیکیشنها را از طریق APIها یا ابزارهای MCP در دسترس قرار دهید.
- برای اپلیکیشنها و اقداماتی که فاقد رابطهای ساختاریافته هستند، کنترل گرافیکی را حفظ کنید.
- نتایج را به جای تکیه صرف بر اسکرینشاتها، از طریق وضعیت اپلیکیشن، پایگاههای داده و فراخوانیها اعتبارسنجی کنید.
- فرآیند برنامهریزی را از اجرا جدا کنید تا هر لایه بتواند به طور مستقل ارزیابی و بهبود یابد.
- درخواست شفافسازی و تأیید را به عنوان مراحل صریح در جریانهای کاری همراه با ابهام یا پیامدهای مالی در نظر بگیرید.
بنچمارک MobileWorld به همراه لینکهایی به مجموعه دادهها و جدول امتیازات عمومی آن در GitHub در دسترس است. برنامههای میزبانیشده به صورت محلی و بررسیهای قطعی، آن را به ابزاری مناسب برای مقایسه نسخههای مختلف ایجنتها بدون انحراف امتیاز ناشی از تغییر سرویسهای خارجی تبدیل میکند.
مطالب مرتبط و پیشنهادی

رکورد ۸۳۳ هزار دانلود ماهانه برای LEGAL-BERT؛ وقتی توسعهدهندهها قید مدلهای گرانقیمت را میزنند!
مدل زبانی تخصصی LEGAL-BERT با ثبت بیش از ۸۳۳ هزار دانلود در ماه روی پلتفرم هاگینگ فیس حسابی خبرساز شده است. این ابزار جمعوجور و تخصصی نشان میدهد که برای پردازش و تحلیل متون حقوقی، حتماً نیازی به مدلهای غولپیکر و پرهزینه ندارید و گزینههای بهینه همچنان در اوج هستند.

جاسوسی هوش مصنوعی در محل کار؛ کارمندان میگویند کارفرماها باید قانوناً مچگیریهایشان را لو بدهند!
نظرسنجیهای تازه نشان میدهد که بیشتر کارمندان حس میکنند مدیرانشان با ابزارهای هوش مصنوعی تمام حرکات آنها را زیر نظر گرفتهاند. حالا بیش از ۸۰ درصد شاغلان خواستار تصویب قانونی شدهاند که شرکتها را مجبور کند هرگونه مچگیری و نظارت هوش مصنوعی در محیط کار را رسماً اعلام کنند.

گزارش داغ مایکروسافت از نفوذ جهانی هوش مصنوعی؛ امارات در صدر و رتبه عجیب آمریکا!
مایکروسافت در تازهترین گزارش خود از ضریب نفوذ هوش مصنوعی در جهان پرده برداشت؛ آماری شگفتانگیز که نشان میدهد امارات و سنگاپور با فاصلهای خیرهکننده پیشتاز دنیا هستند و در مقابل، آمریکا در رتبه ۲۱ جا مانده است. همچنین الگوی استفاده از هوش مصنوعی میان کشورهای غربی و کشورهای در حال توسعه، از تفاوتی عمیق میان کاربردهای روزمره و آموزش پرده برمیدارد.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.