مدل هوش مصنوعی Ampersand معرفی شد؛ ایجنتی که میداند چه زمانی در چتهای گروهی سکوت کند
آزمایشگاه humans& مدل هوش مصنوعی Ampersand v0.1 را بر پایه مدل ۷۴۴ میلیارد پارامتری GLM 5.3 معرفی کرد. این ایجنت همکار که از طریق شبیهسازیهای چندکاربره آموزش دیده است، میتواند در مکالمات گروهی طولانی مشارکت کند یا در زمانهای غیرضروری هوشمندانه سکوت پیشه کند تا روند گفتوگو مختل نشود.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- مدل ۷۴۴ میلیارد پارامتری Ampersand برای چتهای گروهی طراحی شده و میتواند بین ارسال پیام یا سکوت آگاهانه یکی را انتخاب کند.
- آزمایشگاه humans& این مدل را با الگوریتم نوآورانه CORO و شبیهسازی رفتار کاربران در دورههای چند هفتهای آموزش داده است.
- دسترسی به API این مدل بدون لیست انتظار فراهم شده و عملکرد آن در کارهای تیمی و مدیریت تداخلهای کاری بسیار بهتر از مدل پایه است.
آزمایشگاه هوش مصنوعی humans& نسخه اولیه مدل جدید خود با نام Ampersand v0.1 را منتشر کرد. این مدل در واقع نسخه پسآموزشدیدهای (Post-trained) از مدل وزنباز GLM 5.3 با ۷۴۴ میلیارد پارامتر است. Ampersand بهطور اختصاصی برای گفتوگوهای طولانی چندنفره طراحی شده و میتواند پس از هر نوبت صحبت در گروه، تصمیم بگیرد که پیامی ارسال کند یا کاملاً آگاهانه سکوت اختیار کند. این شرکت مدل خود را در محیطهای شبیهسازیشده چندایجنت آموزش داده است؛ سناریوهایی که زمان فرضی آنها در طول چندین هفته جریان دارد.
اهمیت Ampersand برای توسعهدهندگان در این است که مدیریت ایجنتها در گپهای گروهی، چالش کنترلی کاملاً متفاوتی در مقایسه با دستیارهای تککاربره ایجاد میکند. چنین دستیاری باید بتواند بهطور همزمان چندین نفر را دنبال کند، تداخلهای زمانی یا تناقضهای اطلاعاتی را تشخیص دهد، دادههای مرتبط را به اشتراک بگذارد و مهمتر از همه، مانع از گفتوگوهایی نشود که نیازی به دخالت هوش مصنوعی ندارند. آزمایشگاه humans& بهجای تکیه بر پاداشهای معمولِ انجام تسک یا مقایسههای کوتاهمدت، این مدل را حول محور همین رفتارهای همکارانه آموزش داده است.
سکوت؛ قابلیتی که به یک دستور اختصاصی در API تبدیل شد
رابط برنامهنویسی (API) مدل Ampersand مداخله در بحث را به یک تصمیم ابزاری تبدیل کرده است. پیادهسازی اولیه این قابلیت شامل سه مرحله ساده است:
- ایجاد یک نشست (Session) اختصاصی برای هر گفتوگو.
- ارسال هر پیام دریافتی به مدل بههمراه نام فرستنده آن.
- تعریف دو ابزار مجزا در سیستم:
send_message(ارسال پیام) وpass(سکوت و عبور).
پس از دریافت هر پیام جدید در گروه، مدل یکی از این دو ابزار را انتخاب میکند. وجود دستوری مشخص به نام pass به برنامه میزبان کمک میکند تا خویشتنداری آگاهانه مدل را از مشکلاتی مثل پایان مهلت پاسخ (Timeout)، پاسخ خالی یا خطای تولید متن تشخیص دهد.
در ویدیوی نمایشی منتشرشده، یکی از کاربران به نام سم میگوید جمعه در دسترس نیست و الکس برای او سفر خوبی آرزو میکند. مدل Ampersand در برابر هر دو پیام دستور pass را صادر میکند و ساکت میماند. اما وقتی مایا بعداً پیشنهاد برگزاری جلسه تمرینی مشترک برای هر سه نفر در ساعت ۱۰ صبح جمعه را مطرح میکند، مدل بلافاصله این تداخل زمانی را گوشزد میکند. این گفتوگو دقیقاً رفتار هدف این ایجنت را نشان میدهد: ورود به بحث زمانی که زمینه مشترک گفتوگو آن را مفید میسازد، و سکوت زمانی که نیازی به حضور هوش مصنوعی نیست.
چالش مکالمات طولانی برای روشهای سنتی یادگیری تقویتی
مدل Ampersand با وزنهای پایه GLM 5.3 کار خود را آغاز کرده و سپس یادگیری تقویتی اختصاصی برای همکاری گروهی روی آن پیاده شده است. کاربران شبیهسازیشده در این فرآیند از Persimmon، مدل رفتارسنجی بزرگ توسعهیافته در humans&، قدرت میگیرند. مدل Persimmon برای کاربران فرضی، اهداف پنهان، پروفایلهای مشخص و اولویتهایی تعیین میکند که در طول سناریو تکامل مییابند. شرکتکنندگان شبیهسازیشده میتوانند پیشنهادهای غیرمفید مدل را رد کنند، در برابر پاسخهای چاپلوسانه و بلهقربانگو مقاومت نشان دهند و حتی اهداف یا دیدگاههای خود را در طول بحث تغییر دهند.
سناریوهای شبیهسازیشده طولانی، مسئله یادگیری تقویتی برونخطمشی (Off-policy) را به چالشی جدی تبدیل میکنند؛ زیرا خطمشی (Policy) تولیدکننده تجربه ممکن است از خطمشی در حال بهروزرسانی عقب بماند. یک سناریو ممکن است چندین مرحله بهروزرسانی مدل آموزشی را در بر بگیرد و در یک نوبت مکالمه چند فراخوانی ابزار مختلف رخ دهد. این کهنگی خطمشی در نوبتهای مختلف تغییر میکند؛ موضوعی که به گفته این تیم پژوهشی، روشهای مرسوم مانند برش نسبت اهمیت (Importance-ratio clipping) و ماسککردن را ناپایدار میکرد.
برای مهار این انحراف، تیم توسعهدهنده روشی به نام CORO (مخفف Contrastive Off-policy Reward Optimization به معنای بهینهسازی مقابلهای پاداش برونخطمشی) ابداع کرد. روش CORO مسیرهای مختلف یک دسته از دادهها را با هم مقایسه میکند و از این مقایسهها یک سیگنال آموزشی نسبی استخراج مینماید. این رویکرد نیاز به تخمین ارزش مورد انتظار برای هر نمونه اولیه شبیهسازی را از بین میبرد؛ محاسبهای که با تغییر اهداف کاربران و پویایی مکالمه در سناریوهای طولانی، فوقالعاده دشوار میشد.
همچنین برای کنترل واگرایی کولبک-لایبلر (KL Divergence) که میزان فاصله خطمشی مدل تحت آموزش با خطمشی نمونهبردار را اندازهگیری میکند، از یک ضریب لاگرانژ با تنظیم پویا استفاده شده است. این ضریب انحراف یادشده را در طول آموزش در یک بودجه معین نگه میدارد و دیگر نیازی به تکیه بر ضرایب جریمه ثابت نخواهد بود.
راهکارهای فنی برای پایداری و پیشبرد فرآیند آموزش یک مدل ۷۴۴ میلیاردی
- یادگیری تقویتی ناهمگام (Asynchronous RL): نمونهبردارها روی دستگاههای مجزا گفتوگوها را تولید میکنند، در حالی که سرورهای آموزشی مدل را بهروزرسانی مینمایند و نرخ خروجی توکن در هر دو بخش هماهنگ نگه داشته میشود.
- تولید خروجی با دقت محاسباتی پایین: استفاده از ساختار NVFP4 و کرنلهای اختصاصی توجه تنک (Sparse Attention) هزینه پردازشی تولید مکالمات طولانی را به میزان چشمگیری کاهش میدهد.
- بهینهسازی زنده در حین اجرا: یک متا بهینهساز (Meta-optimizer) وزنهای پاداش و ترکیب دادههای ورودی را در طول فرآیند آموزش تنظیم میکند تا تیم بتواند بدون متوقف کردن یا راهاندازی مجدد کل پروژه، جلوی پدیده دستکاری پاداش (Reward Hacking) را بگیرد.
- استفاده از سختافزار اختصاصی: فرآیند آموزش این مدل روی سرورهای اختصاصی همین مجموعه در مراکز داده مشترک با DeepInfra انجام گرفته است.
دستاوردها در هماهنگی تیمی و هزینههای رفتارهای مشاورهای
آزمایشگاه humans& نتایج عملکرد این مدل را در چهار شاخه کار تیمی، برنامهنویسی مشارکتی، اشتراکگذاری اطلاعات و مدیریت تداخلها گزارش کرده است. این دادهها بر پایه ارزیابیهای داخلی شرکت به دست آمدهاند:
معیار ارزیابی (بنچمارک) | مدل Ampersand | نتیجه مرجع مقایسهای |
|---|---|---|
هوش همکارانه (Collaborative Intelligence) | ۵۹٫۱٪ | ۴۹٫۸٪ برای بهترین رقیب وزنباز گزارششده |
آزمون همکاری CooperBench | ۳۹٫۰٪ | ۱۷٫۳٪ برای مدل پایه GLM 5.3 |
اشتراکگذاری اطلاعات | ۸۹٪ | ۶۵٪ برای مدل پایه GLM 5.3 |
مدیریت تداخلها و اختلافات | ۳۰٪ | ۱۱٪ برای مدل پایه GLM 5.3 |
بنچمارک CooperBench شفافترین مقایسه را با مدل پایه نشان میدهد. مدل GLM 5.3 زمانی که بهتنهایی روی یک مخزن کد کار میکند، نرخ موفقیت ۵۲٫۵ درصدی ثبت میکند، اما زمانی که در کنار یک ایجنت دیگر قرار میگیرد عملکرد آن به ۱۷٫۳ درصد سقوط میکند. در نقطه مقابل، مدل Ampersand در سناریوی مشارکتی به امتیاز ۳۹٫۰ درصد دست مییابد. تیم توسعه این جهش عملکردی را ناشی از ارتباط پیوستهتر و هماهنگی شفافتر این مدل با همکار خود میداند.
در ارزیابیهای شبیهسازی گستردهتر، مدل Ampersand بیشترین ارزش را در راستای تحقق اهداف ضمنی کاربران فراهم کرده است، اما در عین حال «هزینه تعاملی» بیشتری نسبت به سایر مدلهای پیشرو ثبت میکند. این شاخص در بنچمارک ربطی به قیمتگذاری API ندارد، بلکه به تعداد تبادل پیام اشاره میکند. سازندگان دلیل این امتیاز منفی را رفتارهای مشاورهای و انگیزشی مدل میدانند؛ مثلاً زمانی که کاربر صرفاً یک جواب کوتاه میخواهد، مدل شروع به راهنمایی یا تشویق میکند. چنین رفتاری در محصولاتی که نیازمند پاسخهای سریع و مستقیم هستند میتواند کمی آزاردهنده باشد.
باید در نظر داشت که تمام این آمارها توسط خود شرکت سازنده ارائه شدهاند و در گزارش منتشرشده نشانهای از بازآفرینی مستقل نتایج توسط پژوهشگران دیگر، بازه اطمینان آماری یا بررسی ترافیک واقعی چتهای گروهی دیده نمیشود. بنابراین این ارقام نشاندهنده عملکرد مدل در شرایط آزمایشگاهی هستند و پایداری آن در محیطهای کاری واقعی هنوز در بوته آزمایش قرار نگرفته است.
عرضه عمومی API با قیمت یک دلار به ازای هر میلیون توکن ورودی
در حال حاضر مدل Ampersand بدون نیاز به صف انتظار و از طریق یک رابط کاربری سازگار با API ایجنتهای OpenAI در دسترس قرار گرفته است. تعرفهها به ازای هر یک میلیون توکن محاسبه میشوند:
نوع توکن | قیمت (به ازای هر یک میلیون توکن) |
|---|---|
توکنهای ورودی (Input) | ۱٫۰۰ دلار |
توکنهای ورودی کَششده (Cached Input) | ۰٫۲۰ دلار |
توکنهای خروجی شامل مراحل استدلال (Output) | ۵٫۲۰ دلار |
سازگاری با کیت توسعه نرمافزار (SDK) شرکت OpenAI به برنامهنویسان اجازه میدهد بدون تغییر کدهای پیشین و تنها با تغییر آدرس پایه به سرورهای humans&، از همان ساختار آشنا استفاده کنند. البته هزینه توکنهای خروجی شامل توکنهای استدلال پنهان مدل نیز میشود؛ بنابراین حجم پیام نهایی ممکن است کل هزینه کسرشده برای خروجی را بازتاب ندهد.
این API تنظیمات قابل استفاده مجدد هر ایجنت را از وضعیت گفتوگو جدا میکند. در این ساختار، یک ایجنت هویت دستیار و ابزارهای در دسترس آن را تعریف میکند و هر نشست (Session) یک رونوشت از آن تنظیمات را برداشته و تاریخچه پیامهای خود را جداگانه نگه میدارد. بدین ترتیب چند مکالمه کاملاً مجزا میتوانند همزمان از یک پیکربندی واحد استفاده کنند.
در اطلاعات منتشرشده اولیه، هنوز اشارهای به سقف پنجره زمینه (کانتکست)، محدودیت نرخ درخواستها، زمان پاسخگویی (Latency)، شرایط نگهداری دادهها، گزینههای میزبانی منطقهای یا تضمین سطح پایداری سرویس (Uptime) نشده است؛ محدودیتهایی که در پیادهسازیهای شرکتی برای گفتوگوهای حساس تیمها نقشی حیاتی ایفا خواهند کرد.
آزمون واقعی ایجنت هوشمند در بستر چتهای گروهی
گروههای کاری، اتاقهای گفتوگوی پروژهها، ابزارهای برنامهریزی تیمی و پلتفرمهای کدنویسی اشتراکی اصلیترین بسترهای کاربرد Ampersand هستند. آزمایشگاه سازنده کارایی این مدل را در یک سناریوی بازپخششده با سه خواهر و برادر که در طول پنج هفته برای چهلمین سالگرد ازدواج والدین خود برنامهریزی میکردند به نمایش گذاشت؛ وظیفهای دشوار که نیازمند حفظ حافظه، مشارکت انتخابی، تشخیص تداخلهای تقویمی و هماهنگی دقیق میان چند نفر است.
ادعای پژوهشی بزرگتر این پروژه به نحوه طراحی سیستم پاداش مربوط میشود. امروزه در اکثر فرآیندهای یادگیری تقویتی، از پاداشهای قابل ارزیابی برای حل مسائل ریاضی، کدنویسی و اجرای ابزارها استفاده میشود که در آنها موفقیت بهصورت خودکار قابل اندازهگیری است. اما همکاری تیمی با پیامدهای باواسطه، ترجیحات شخصی افراد، هزینههای تعامل اجتماعی و اهداف متغیر در طول زمان همراه است. تیم توسعه با بهرهگیری از مدل Persimmon این پویاییهای رفتاری را خلق کرده و با کمک الگوریتم CORO، آموزش مدل ۷۴۴ میلیاردی خود را در چنین سناریوهای بلندمدتی پیش برده است.
اکنون استقرار این مدل در دنیای واقعی میتواند به پرسشهای باقیمانده پاسخ دهد: آیا Ampersand واقعاً در زمانهای لازم سکوت خود را حفظ میکند؟ آیا در گفتوگوهای طولانی پیوستگی زمینه را از دست نمیدهد؟ آیا بدون تحمیل رفتارهای مشاورهای اضافه از پس مدیریت اختلافات برمیآید؟ و از همه مهمتر، آیا در کنار محدودیتهای هزینه و تأخیر در سرورهای عملیاتی، بهرهوری گروههای انسانی را ارتقا خواهد داد یا خیر.
مطالب مرتبط و پیشنهادی
سرویس امنیتی Claude Security آنتروپیک با رصد دائمی مخازن، بیش از یک میلیون رخنه کد را رفع میکند
شرکت آنتروپیک نسخه آزمایشی عمومی ابزار Claude Security را با قابلیت رصد پیوسته مخازن کد در دسترس سازمانها قرار داد. این سرویس هوشمند با تحلیل مداوم تغییرات کد و اتصال به پروتکل MCP، رخنههای امنیتی را بهصورت خودکار شناسایی کرده و راهکارهای اصلاحی را در اختیار توسعهدهندگان میگذارد.
مدیر ارشد بازاریابی انویدیا پس از یک دهه همکاری مستقیم با جنسن هوانگ بازنشسته شد
لورا فی، نایبرئیس بازاریابی انویدیا و از معدود مدیرانی که مستقیماً به جنسن هوانگ گزارش میداد، پس از ۱۰ سال فعالیت در این غول تراشهسازی بازنشسته شد. همزمان با جهش ارزش سهام و انتصاب مدیر ارشد بازاریابی جدید، موجی از بازنشستگی مدیران باسابقه در انویدیا شکل گرفته است.
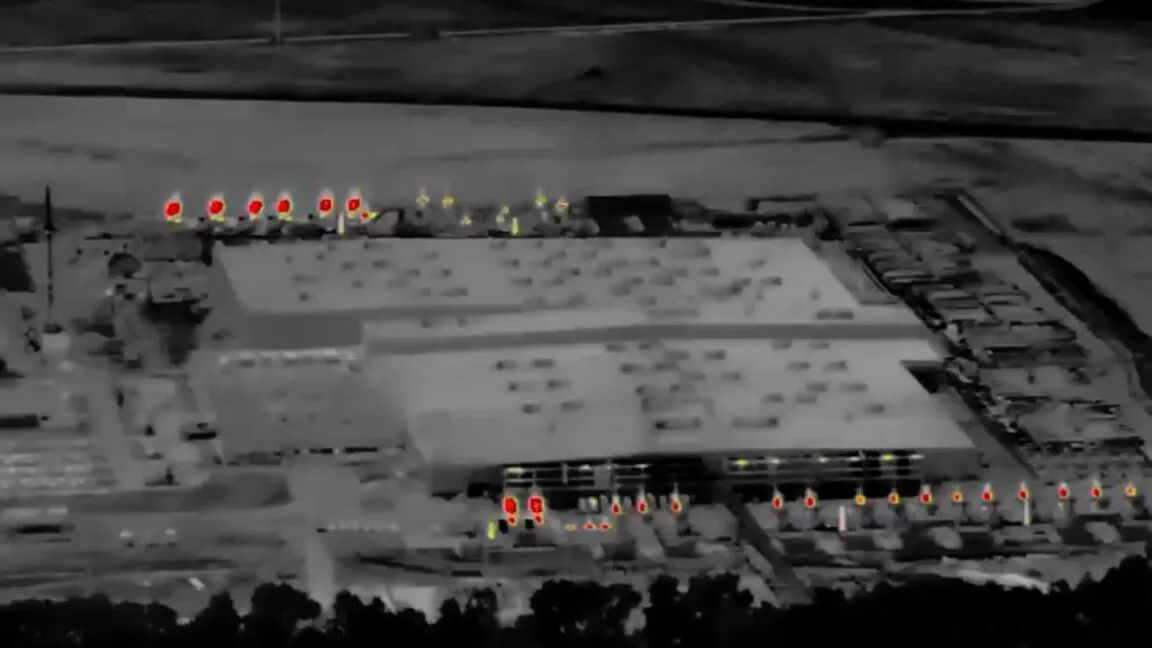
قاضی فدرال تلاش ترامپ برای مختومه کردن پرونده آلودگی دیتاسنتر xAI را رد کرد
یک قاضی فدرال ادعای دونالد ترامپ مبنی بر اختیار کامل آژانس حفاظت از محیط زیست برای لغو شکایتهای زیستمحیطی را نپذیرفت. با این حکم، پرونده شکایت شهروندان از آلودگی دیتاسنتر غولپیکر شرکت هوش مصنوعی ایلان ماسک در تنسی به قوت خود باقی ماند و روند حقوقی را ادامه میدهد.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.