معرفی Ling-3.0-flash-Fin: مدل زبانی جدید Ant Group ویژه تحلیلهای مالی
شرکت Ant Group از مدل زبانی متنباز جدید خود با نام Ling-3.0-flash-Fin رونمایی کرد. این مدل که بهطور ویژه برای کارهای مالی و حسابداری بهینهسازی شده، عملکرد قابلتوجهی در پردازش اسناد و تحلیلهای تجاری به ثبت رسانده است.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- مدل Ling-3.0-flash-Fin با تنها ۵٫۱ میلیارد پارامتر فعال، عملکردی مشابه مدلهای سنگینتر در پردازش اطلاعات مالی و تجاری ارائه میدهد.
- این هوش مصنوعی با همکاری موسسات مالی توسعه یافته و در تدوین گزارشها، مدلسازیها و ارزیابی منابع تخصصی کاربرد دارد.
- علیرغم قدرت بالا در کارهای متنی و دانشی، اجرای وظایف پیچیده ایجنتها همچنان برای این مدل یک چالش محسوب میشود.
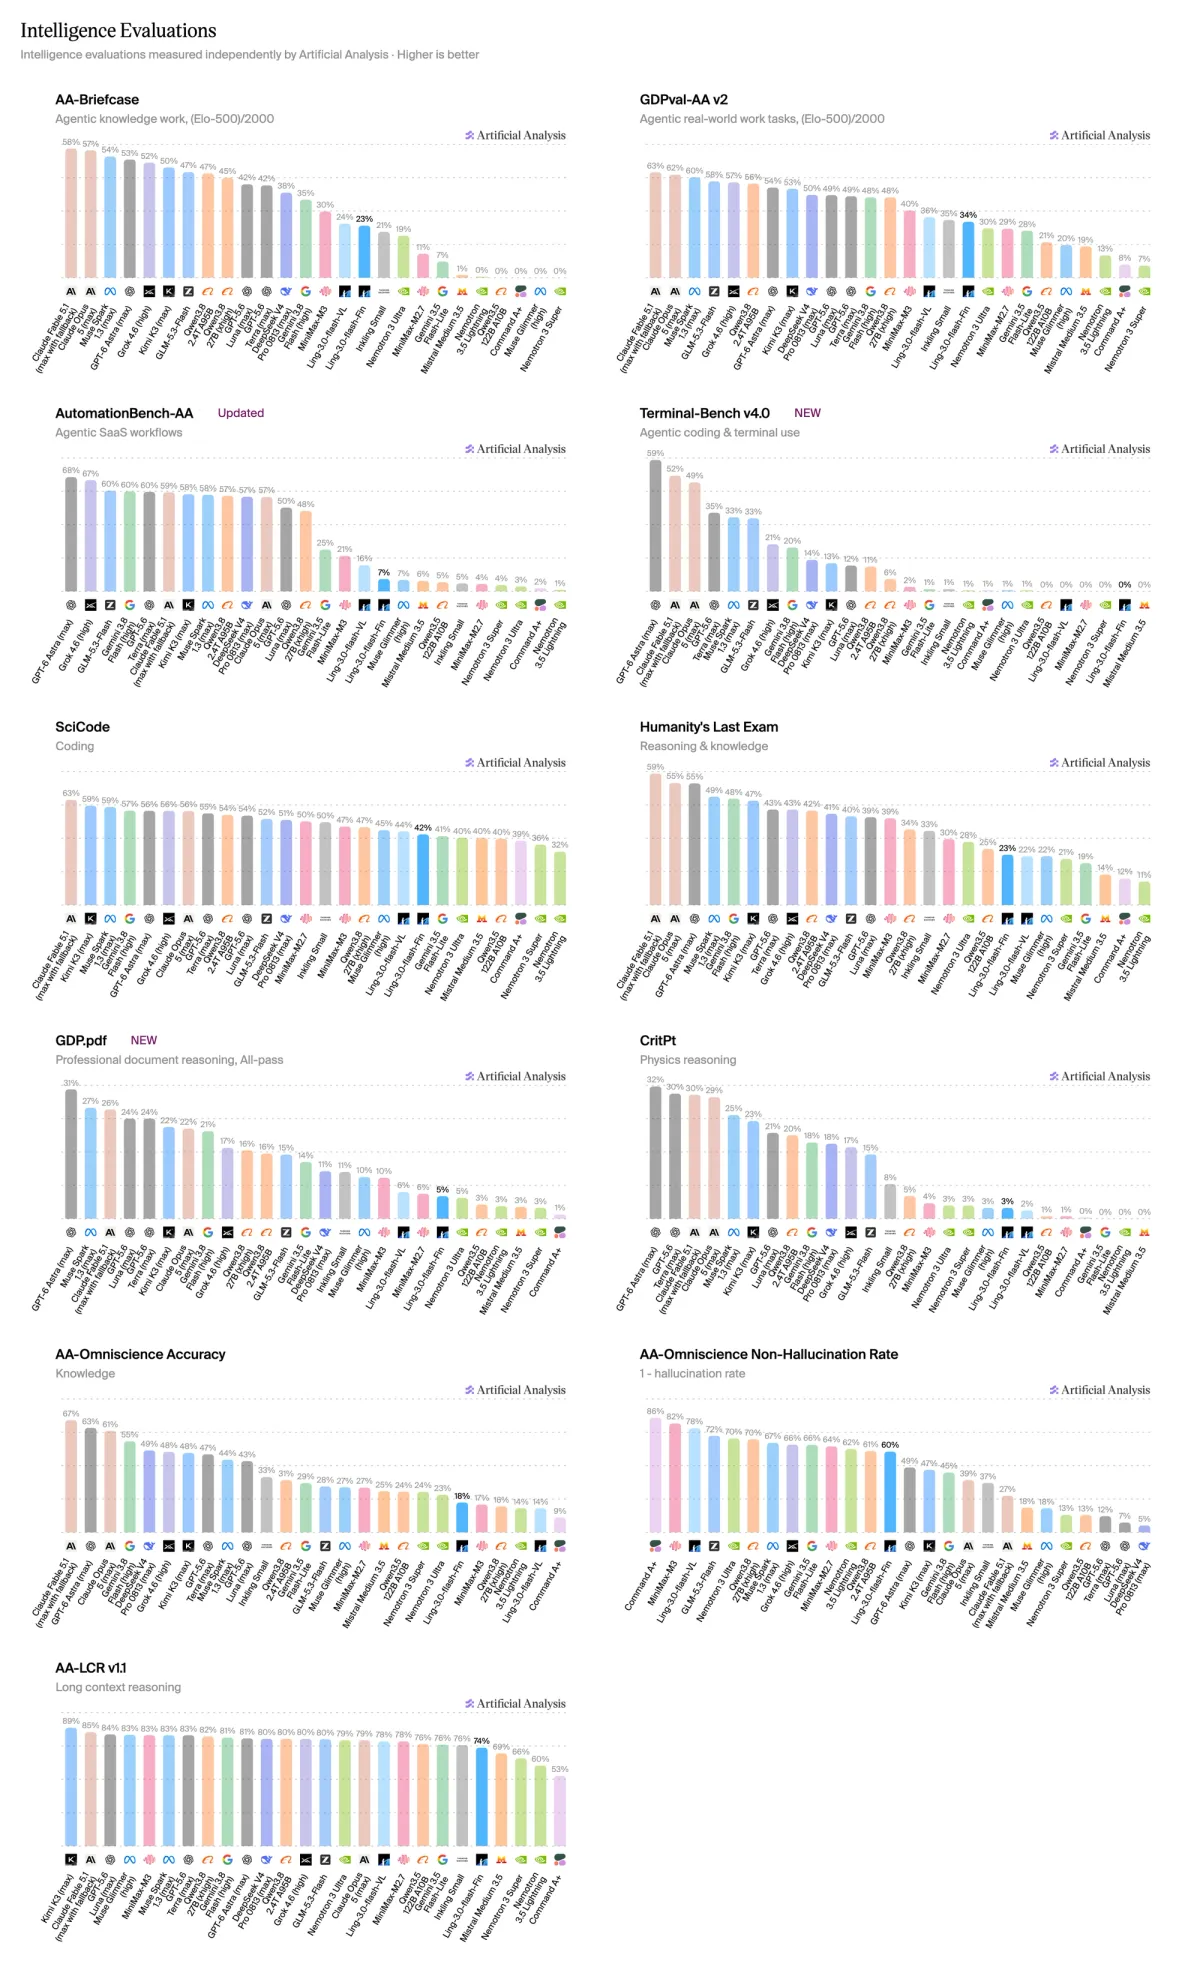
مدل Ling-3.0-flash-Fin، جدیدترین هوش مصنوعی متنباز Ant Group با تمرکز بر امور مالی، در شاخصهای ارزیابی هوش مصنوعی امتیاز ۲۳ و در بنچمارکهای مالی و حسابداری امتیاز ۲۴ را کسب کرده است و در مرز پارتو (Pareto Frontier) نسبت هوش به پارامترهای فعال قرار دارد.
شرکت Ant Group نسخه جدیدی از مدل زبانی خود را با نام Ling-3.0-flash-Fin با تمرکز ویژه بر امور مالی منتشر کرده است. بنا بر اعلام شرکت، این مدل با همکاری موسسات مالی و متخصصان صنعت توسعه یافته است تا از تحقیقات تخصصی از جمله بررسی منابع، ایجاد صفحات گسترده ارزشگذاری و نوشتن گزارشها پشتیبانی کند. این مدل که صرفاً مبتنی بر متن است، پس از انتشار نسخه Ling-3.0-flash-VL عرضه شده است؛ نسخهای که قابلیت پردازش ورودیهای تصویر و ویدیو را داشت و امتیاز ۲۵ را در شاخصهای هوش کسب کرده بود.
نتایج کلیدی عملکرد:
➤ مدل Ling-3.0-flash-Fin با حدود نیمی از پارامترهای فعال، به امتیاز هوش برابر با MiniMax-M2.7 دست یافته است. هر دو مدل امتیاز ۲۳ را کسب کردهاند، در حالی که مدل Ling برای هر توکن ۵٫۱ میلیارد پارامتر فعال میکند اما این رقم برای MiniMax-M2.7 معادل ۱۰ میلیارد پارامتر است.
➤ عملکرد Ling-3.0-flash-Fin در شاخصهای ارزیابی مالی و حسابداری با کسب امتیاز ۲۴ مشابه نسخه Ling-3.0-flash-VL است. نسخه Fin دقت دانش تجاری بالاتری نسبت به نسخه VL دارد (۱۷ درصد در برابر ۱۱ درصد)، اما در عین حال توهم (Hallucination) دانش تجاری آن نیز بیشتر است (۳۳ درصد در برابر ۱۹ درصد).
➤ امتیاز Ling-3.0-flash-Fin در کارهای دانشی و حرفهای اندکی پایینتر از نسخه Ling-3.0-flash-VL است. این مدل در بنچمارکهای ارزیابی دانش حرفهای امتیاز ۱۱۷۱ و در بررسی جریانهای کاری تجاری امتیاز ۹۶۷ را ثبت کرده است؛ در حالی که این ارقام برای نسخه VL به ترتیب ۱۲۲۵ و ۹۸۶ بود. هر دوی این بنچمارکها ایجنتها را در وظایف حرفهای مانند تولید اسناد و صفحات گسترده مورد آزمایش قرار میدهند.
➤ وظایف پیچیده ایجنتها همچنان برای Ling-3.0-flash-Fin یک چالش محسوب میشود. این مدل در ارزیابیهای خودکارسازی که جریانهای کاری را در برنامههای تجاری با رعایت پروتکلهای ایمنی آزمایش میکند، امتیاز ۷ درصد را به دست آورد (در مقایسه با ۱۶ درصد برای نسخه VL). همچنین هر دو مدل در ارزیابی وظایف دشوار مبتنی بر ترمینال، امتیاز صفر را ثبت کردهاند.
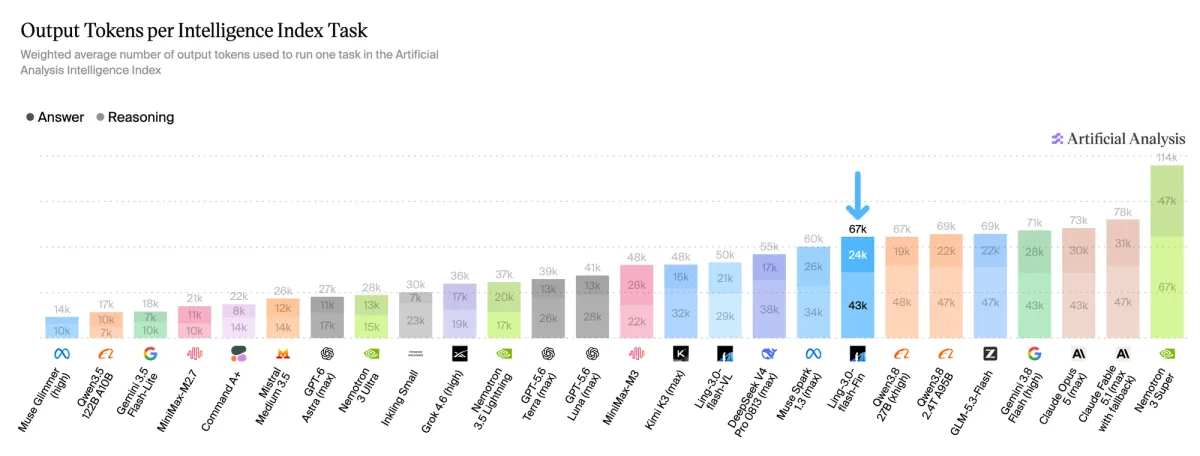
➤ مدل Ling-3.0-flash-Fin از توکنهای خروجی بیشتری نسبت به مدلهای نسخه VL و MiniMax-M2.7 استفاده میکند. میانگین تولید آن حدود ۶۷ هزار توکن خروجی برای هر وظیفه پردازشی است که تقریباً ۳۴ درصد بیشتر از نسخه VL (حدود ۵۰ هزار توکن) و ۳٫۲ برابر مدل MiniMax-M2.7 (حدود ۲۱ هزار توکن) به شمار میرود.
جزئیات فنی بیشتر از مدل:
➤ نوع: مدل استنتاجی با وزنهای باز (Open weights).
➤ اندازه: مجموعاً ۱۲۴ میلیارد پارامتر، ۵٫۱ میلیارد پارامتر فعال به ازای هر توکن (معماری MoE).
➤ پنجره زمینه (Context Window): ۲۵۶ هزار توکن.
➤ ورودی و خروجی: فقط متن.
➤ دسترسی به API: موجود از طریق OpenRouter (شامل یک نقطه پایانی رایگان با محدودیت درخواست).
➤ مجوز (License): MIT.
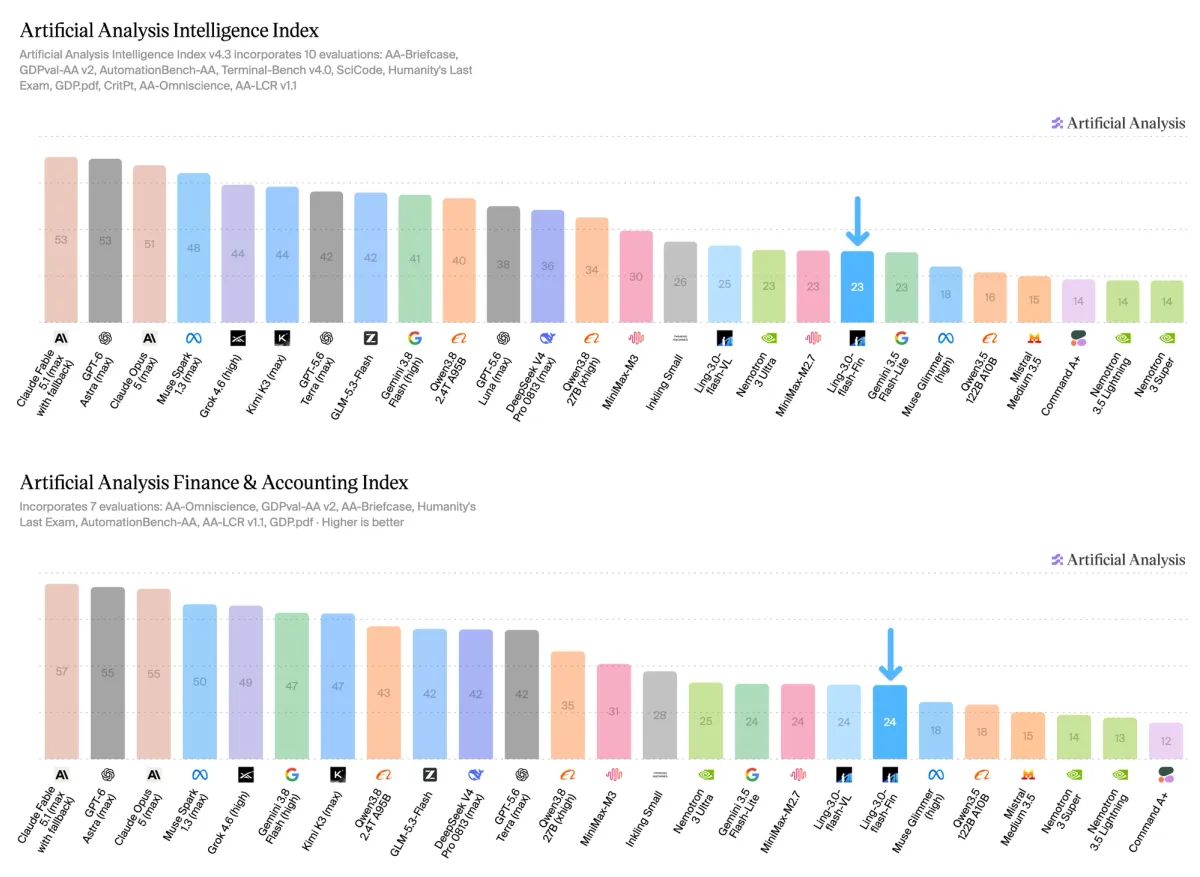
مدل Ling-3.0-flash-Fin در شاخصهای هوش در برابر پارامترهای فعال روی مرز پارتو قرار دارد؛ این مدل با ۵٫۱ میلیارد پارامتر فعال برای هر توکن امتیاز ۲۳ را کسب کرده است، در حالی که نسخه Ling-3.0-flash-VL با ۵٫۵ میلیارد پارامتر فعال امتیاز ۲۵ را ثبت کرده بود. هر دو مدل در مجموع ۱۲۴ میلیارد پارامتر دارند. در سوی دیگر، مدل Qwen3.8 27B با ۲۷ میلیارد پارامتر کل توانسته امتیاز ۳۴ را کسب کند که این امر هر دو مدل Ling را پایینتر از مرز پارامترهای کل قرار میدهد.
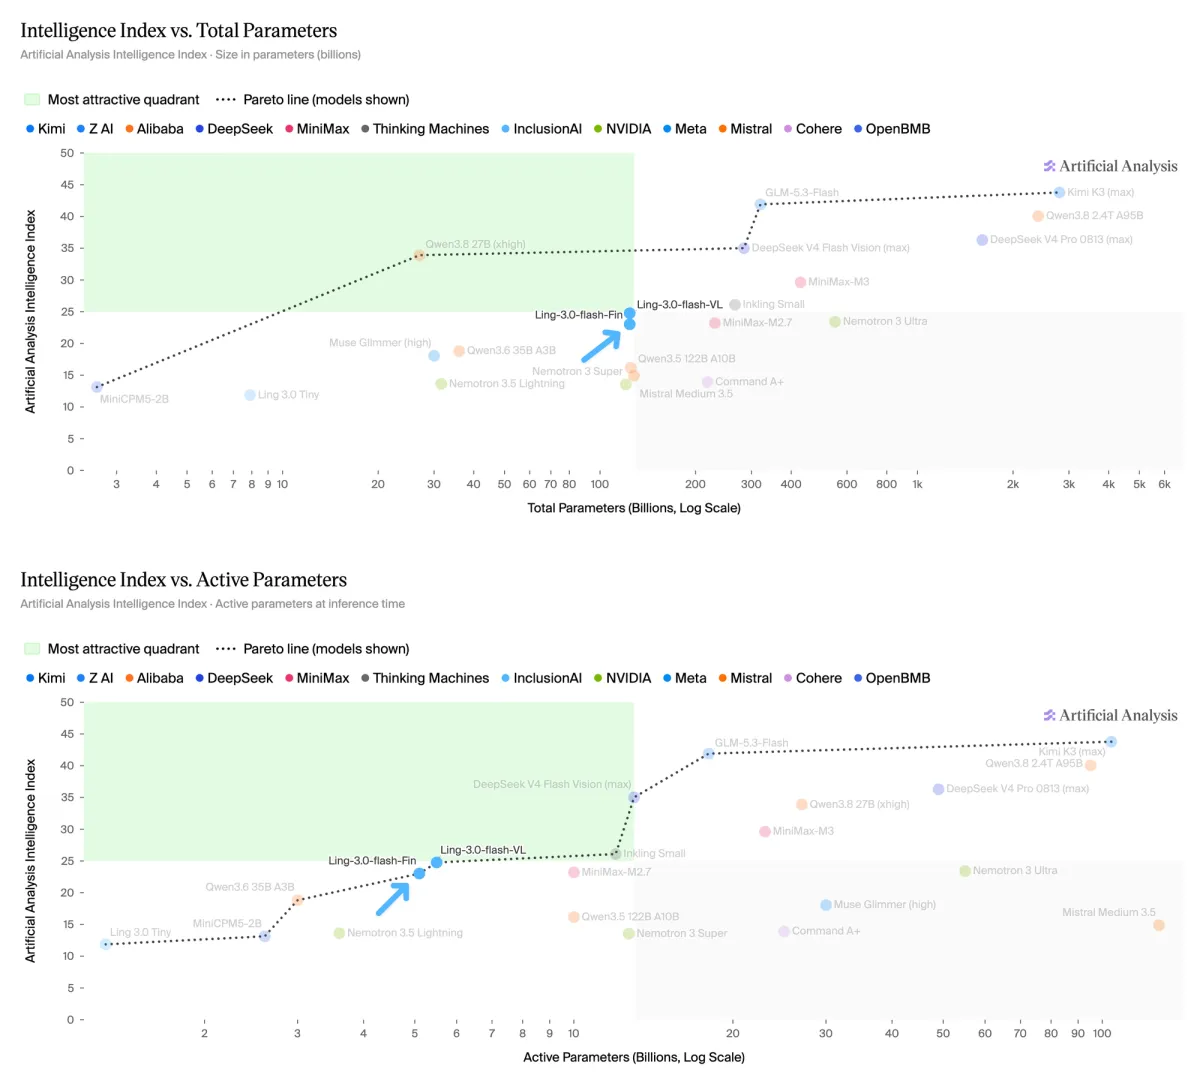
مدل Ling-3.0-flash-Fin در شاخص مالی و حسابداری امتیاز ۲۴ را کسب کرده است؛ شاخصی که ترکیبی از دانش تجاری، استدلال، وظایف ایجنتها، تحلیل زمینه طولانی و نرخ عدم توهم است. این امتیاز دقیقاً با عملکرد نسخه Ling-3.0-flash-VL برابر است. نسخه Fin دقت دانش تجاری بالاتری دارد (۱۷ درصد در برابر ۱۱ درصد)، اما در عین حال با توهم بیشتری در مفاهیم تجاری مواجه است (نرخ عدم توهم ۶۷ درصد در برابر ۸۱ درصد).
این مدل در ارزیابیهای مربوط به کارهای دانشی و حرفهای، امتیاز ۱۱۷۱ را کسب کرده است. این رقم حدود ۵۰ امتیاز پایینتر از نسخه Ling-3.0-flash-VL با امتیاز ۱۲۲۵ است، اما بالاتر از عملکرد مدل MiniMax-M2.7 با امتیاز ۱۰۸۷ قرار میگیرد.
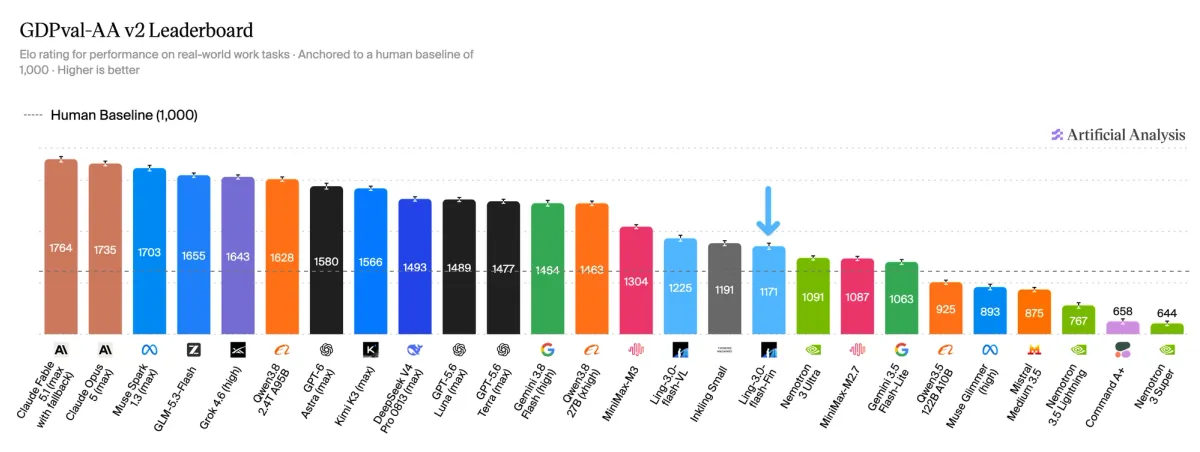
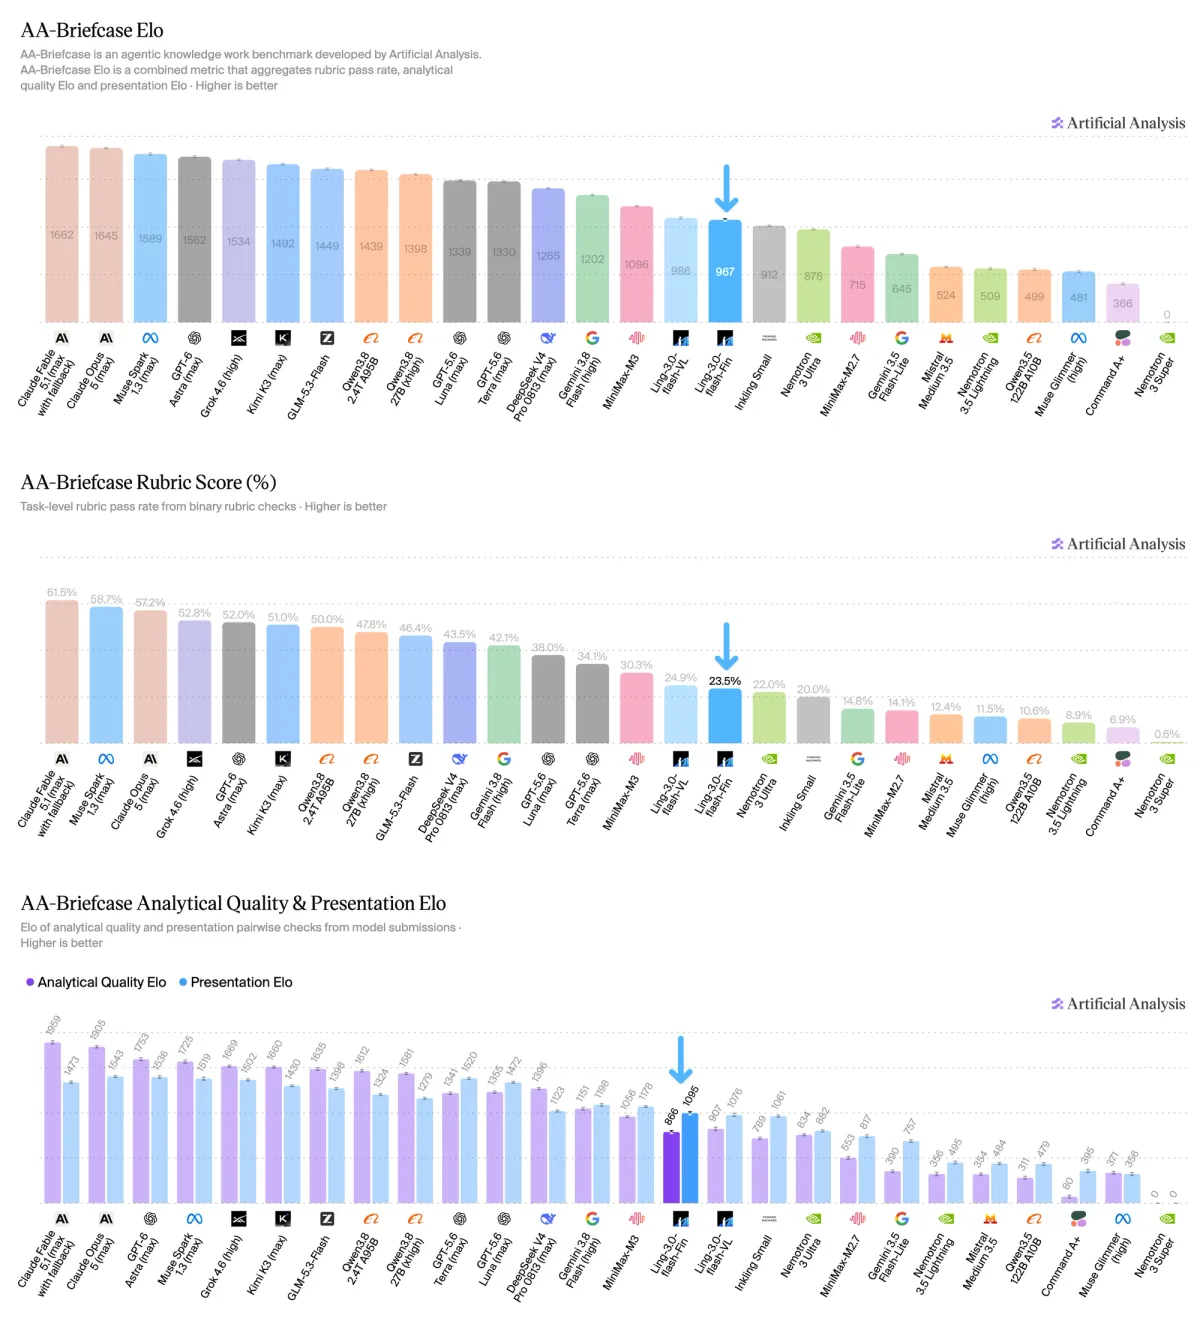
امتیاز مدل Ling-3.0-flash-Fin در بررسی جریانهای کاری تجاری معادل ۹۶۷ است که اندکی پایینتر از عملکرد نسخه Ling-3.0-flash-VL (با امتیاز ۹۸۶) به شمار میرود. این ارزیابی عملکرد ایجنتها را در جریانهای کاری پیچیده سازمانی با استفاده از مجموعههای بزرگ فایلهای منبع برای تولید صفحات گسترده، ارائهها و یادداشتها بررسی میکند. در مقایسه با نسخه VL، مدل Fin توانست معیارهای ارزیابی کمتری را با موفقیت پشت سر بگذارد (۲۳٫۵ درصد در برابر ۲۴٫۹ درصد) و در کیفیت تحلیلی نیز امتیاز پایینتری گرفت (۸۶۶ در برابر ۹۰۷). با این حال، امتیاز کیفیت ارائه آن به شکل غافلگیرکنندهای کمی بالاتر بود (۱۰۹۵ در برابر ۱۰۷۶)؛ اتفاقی که با توجه به عدم برخورداری از قابلیتهای پردازش تصویر نسخه VL، بسیار جالب توجه است.
مدل Ling-3.0-flash-Fin به طور میانگین حدود ۶۷ هزار توکن خروجی برای هر وظیفه پردازشی تولید میکند، که تقریباً ۳۴ درصد بیشتر از میزان تولید نسخه Ling-3.0-flash-VL (حدود ۵۰ هزار توکن در هر وظیفه) است.
نتایج کامل عملکرد مدل Ling-3.0-flash-Fin در ارزیابیهای دهگانه شاخصهای هوشمند.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی

رکورد ۸۳۳ هزار دانلود ماهانه برای LEGAL-BERT؛ وقتی توسعهدهندهها قید مدلهای گرانقیمت را میزنند!
مدل زبانی تخصصی LEGAL-BERT با ثبت بیش از ۸۳۳ هزار دانلود در ماه روی پلتفرم هاگینگ فیس حسابی خبرساز شده است. این ابزار جمعوجور و تخصصی نشان میدهد که برای پردازش و تحلیل متون حقوقی، حتماً نیازی به مدلهای غولپیکر و پرهزینه ندارید و گزینههای بهینه همچنان در اوج هستند.

جاسوسی هوش مصنوعی در محل کار؛ کارمندان میگویند کارفرماها باید قانوناً مچگیریهایشان را لو بدهند!
نظرسنجیهای تازه نشان میدهد که بیشتر کارمندان حس میکنند مدیرانشان با ابزارهای هوش مصنوعی تمام حرکات آنها را زیر نظر گرفتهاند. حالا بیش از ۸۰ درصد شاغلان خواستار تصویب قانونی شدهاند که شرکتها را مجبور کند هرگونه مچگیری و نظارت هوش مصنوعی در محیط کار را رسماً اعلام کنند.

گزارش داغ مایکروسافت از نفوذ جهانی هوش مصنوعی؛ امارات در صدر و رتبه عجیب آمریکا!
مایکروسافت در تازهترین گزارش خود از ضریب نفوذ هوش مصنوعی در جهان پرده برداشت؛ آماری شگفتانگیز که نشان میدهد امارات و سنگاپور با فاصلهای خیرهکننده پیشتاز دنیا هستند و در مقابل، آمریکا در رتبه ۲۱ جا مانده است. همچنین الگوی استفاده از هوش مصنوعی میان کشورهای غربی و کشورهای در حال توسعه، از تفاوتی عمیق میان کاربردهای روزمره و آموزش پرده برمیدارد.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.