مدل Claude Opus 5.5 جایگاه نخست شاخص هوشمندی را از آن خود کرد
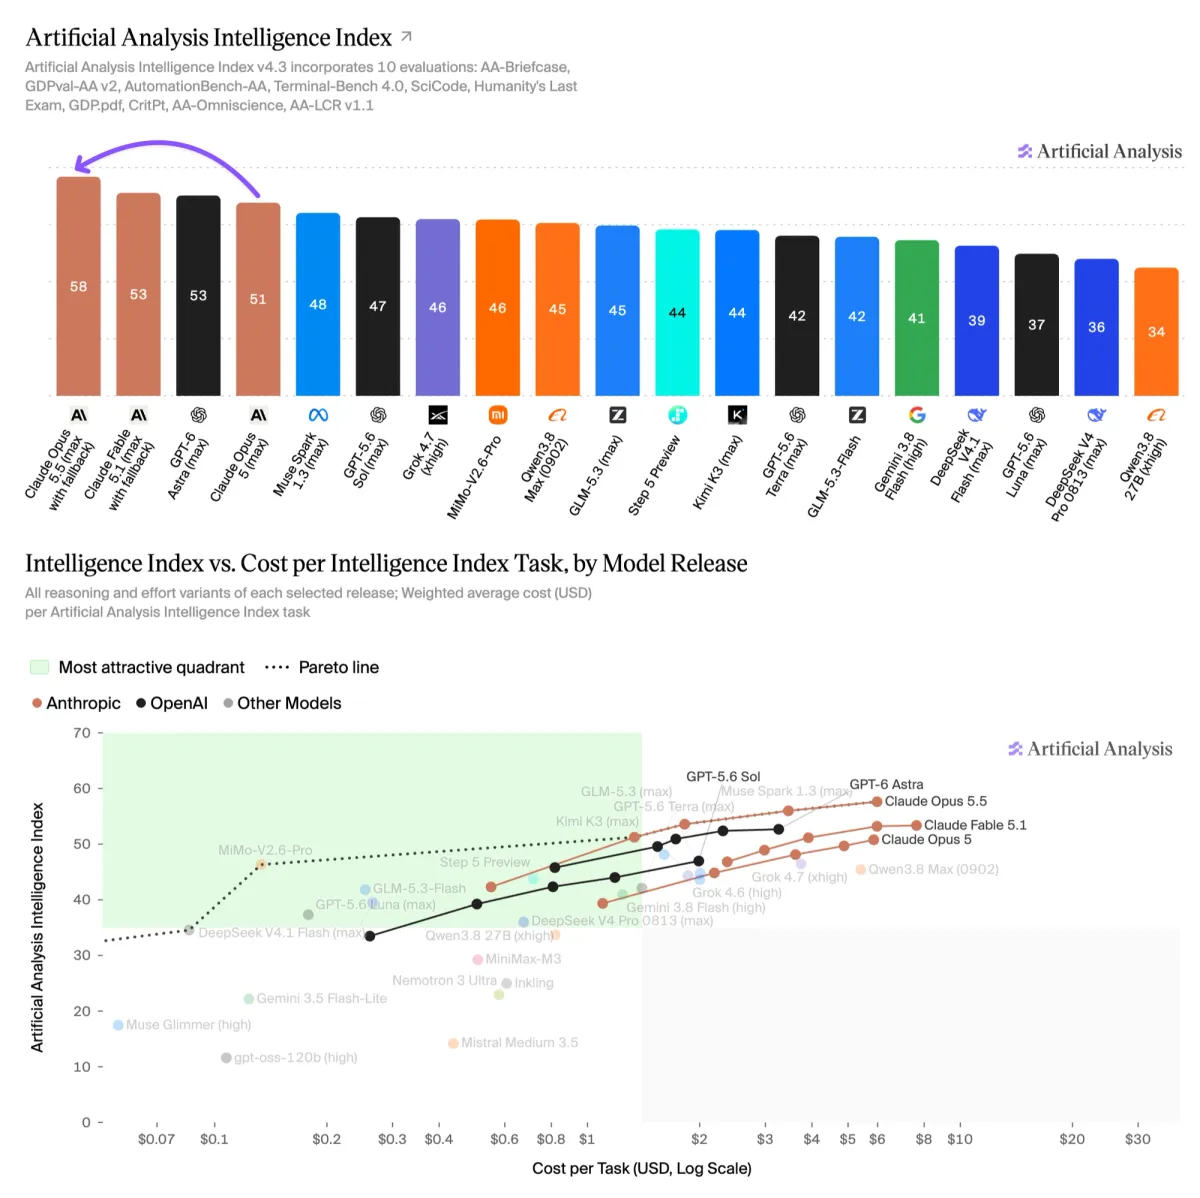
مدل جدید Opus شرکت Anthropic با کسب امتیاز بیسابقه ۵۸، همراه با کاهش ۲۰ درصدی قیمت و تخفیف ویژه برای پردازشهای مبتنی بر حافظه پنهان منتشر شد.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- مدل Claude Opus 5.5 عملکرد قدرتمندی ثبت کرده و در ارزیابیهای کلیدی از رقبای سرسخت خود پیشی گرفته است.
- این مدل در پردازشهای پیشرفته ایجنتها با ثبت بالاترین امتیاز، از GPT-5.6 سبقت گرفته است.
- بهرغم افزایش توانمندیها، هزینه استفاده از این مدل نسبت به نسخه قبلی کاهش قابلتوجهی یافته است.
مدل Claude Opus 5.5 جایگاه نخست شاخص هوشمندی را به دست آورد؛ کاهش ۲۰ درصدی قیمت و تخفیف بیشتر کش
مدل Claude Opus 5.5 شرکت Anthropic را در ارزیابیهایی نظیر Terminal-Bench 4.0 و AutomationBench با مدل GPT-6 Astra همتراز میکند و همزمان پیشتازی این شرکت در کارهای دانشی ایجنتها (agentic knowledge work) را گسترش میدهد.
در بالاترین سطح تلاش (max effort)، این مدل امتیاز ۵۸ را در شاخص هوشمندی کسب کرد که بالاترین امتیاز ثبتشده با اختلاف چند نمره است. شرکت Anthropic قیمت مدل Opus را به ۴ و ۲۰ دلار به ازای هر یک میلیون توکن ورودی و خروجی کاهش داده (نسخه قبلی ۵ و ۲۵ دلار بود) و هزینه خواندن از کش نیز از ۰.۵۰ دلار به ۰.۲۰ دلار رسیده است.
نکات کلیدی:
➤ عملکرد قدرتمند و پایدار با برتری در شش ارزیابی از ده ارزیابی شاخص هوشمندی: آزمون Humanity's Last Exam با ۶۱.۴ درصد (بهترین رکورد قبلی ۵۹.۱ درصد برای Claude Fable 5.1)، آزمون SciCode با ۶۶.۹ درصد، و همچنین آزمونهای GDPval، Briefcase، Omniscience و AutomationBench. در Terminal-Bench 4.0 امتیاز ۵۹.۶ درصد را کسب کرده که همسطح با پیشگام این بخش یعنی GPT-6 Astra است و ۱۱ نمره بالاتر از Opus 5 قرار میگیرد. با این حال، در بخشهای CritPt، LCR و GDP.pdf همچنان عقبتر است.
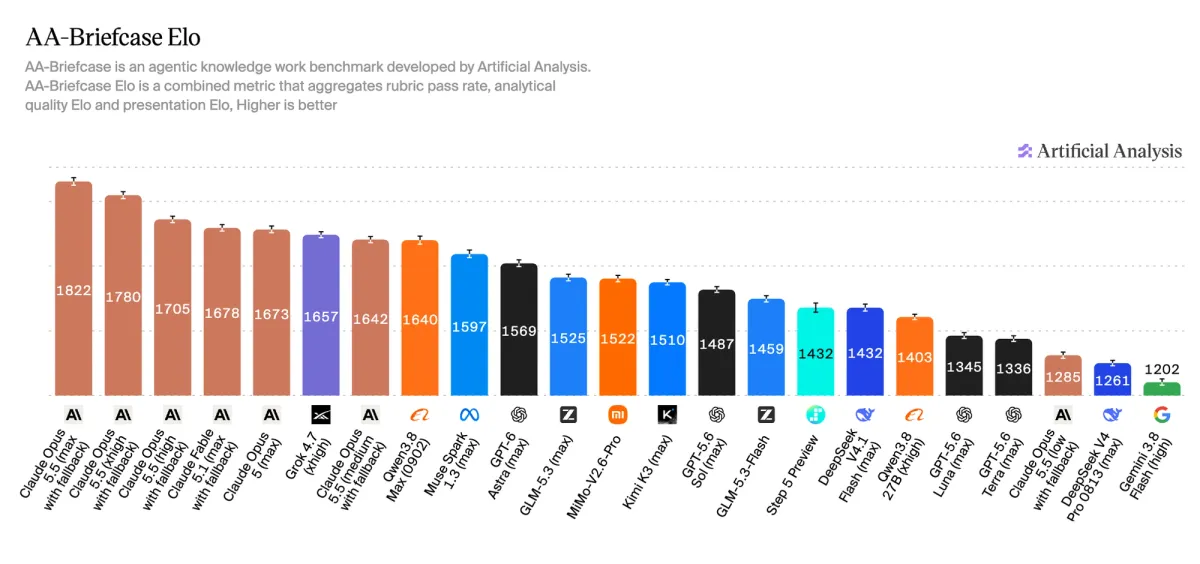
➤ پیشتاز در کارهای دانشی ایجنتها: در آزمون Briefcase که ارزیابی دانش پیشرفته ایجنتها است، به امتیاز الو (Elo) ۱۸۲۲ دست یافت. این رقم ۱۴۳ نمره بالاتر از Fable 5.1 بوده و در هر دو بخش کیفیت تحلیلی و ارائه برتر است. این نخستین بار است که Anthropic از نظر کیفیت ارائه توانسته از GPT-5.6 سبقت بگیرد. این ارزیابی بررسی میکند که آیا مدلها میتوانند خروجیهای حرفهای، دقیق و با ساختار مناسب تولید کنند یا خیر.
➤ برابری هزینه هر کار با Opus 5 بهرغم افزایش ۱.۶ برابری توکنهای خروجی: مدل Claude Opus 5.5 (حالت max) برای هر وظیفه در شاخص هوشمندی حدود ۱۱۹ هزار توکن خروجی مصرف میکند، در حالی که این رقم برای Opus 5 حدود ۷۳ هزار، برای Fable 5.1 حدود ۷۸ هزار و برای GPT-6 Astra تنها ۲۷ هزار توکن است.
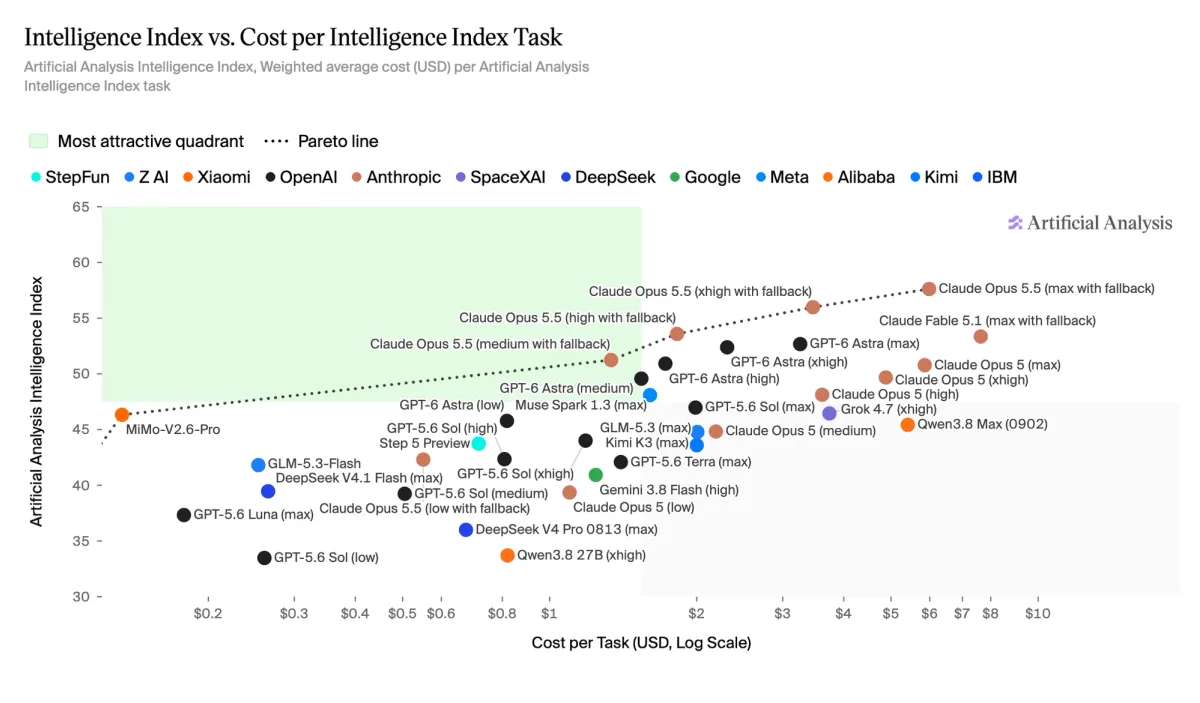
➤ چهار مورد از پنج سطح تلاش در مرز هوشمندی در برابر هزینه قرار دارند: سطوح max، xhigh، high و medium در Opus 5.5 همگی در مرز پارتو (Pareto frontier) جای گرفتهاند که به معنای هزینه کمتر یا عملکرد بهتر نسبت به سایر مدلهای بالای ۵۰ امتیاز (نظیر GPT-6 Astra، Claude Fable 5.1 و Claude Opus 5) است.
سایر جزئیات مدل:
➤ پنجره زمینه (Context Window): پشتیبانی از یک میلیون توکن زمینه برای ورودیهای متنی و تصویری که نسبت به Opus 5 بدون تغییر مانده است.
➤ قیمتگذاری: ۴ و ۲۰ دلار برای هر یک میلیون توکن ورودی/خروجی، که نسبت به ۵ و ۲۵ دلار در Opus 5 شاهد ۲۰ درصد کاهش است. نوشتن در حافظه پنهان (Cache writes) برای ماندگاری ۵ دقیقهای به ۵ دلار در هر یک میلیون توکن رسیده (از ۶.۲۵ دلار). خواندن از کش باز هم تخفیف بیشتری خورده و با ۶۰ درصد کاهش نسبت به Opus 5 به ۰.۲۰ دلار رسیده است. این یعنی ۹۵ درصد تخفیف نسبت به توکنهای ورودی بدون کش، در حالی که این تخفیف در مدلهای قبلی Opus حدود ۹۰ درصد بود.
➤ تنظیمات سطح تلاش: پنج تنظیم مختلف (low، medium، high، xhigh و max). تمامی ارزیابیهای شاخص هوشمندی در این پنج سطح انجام شده است.
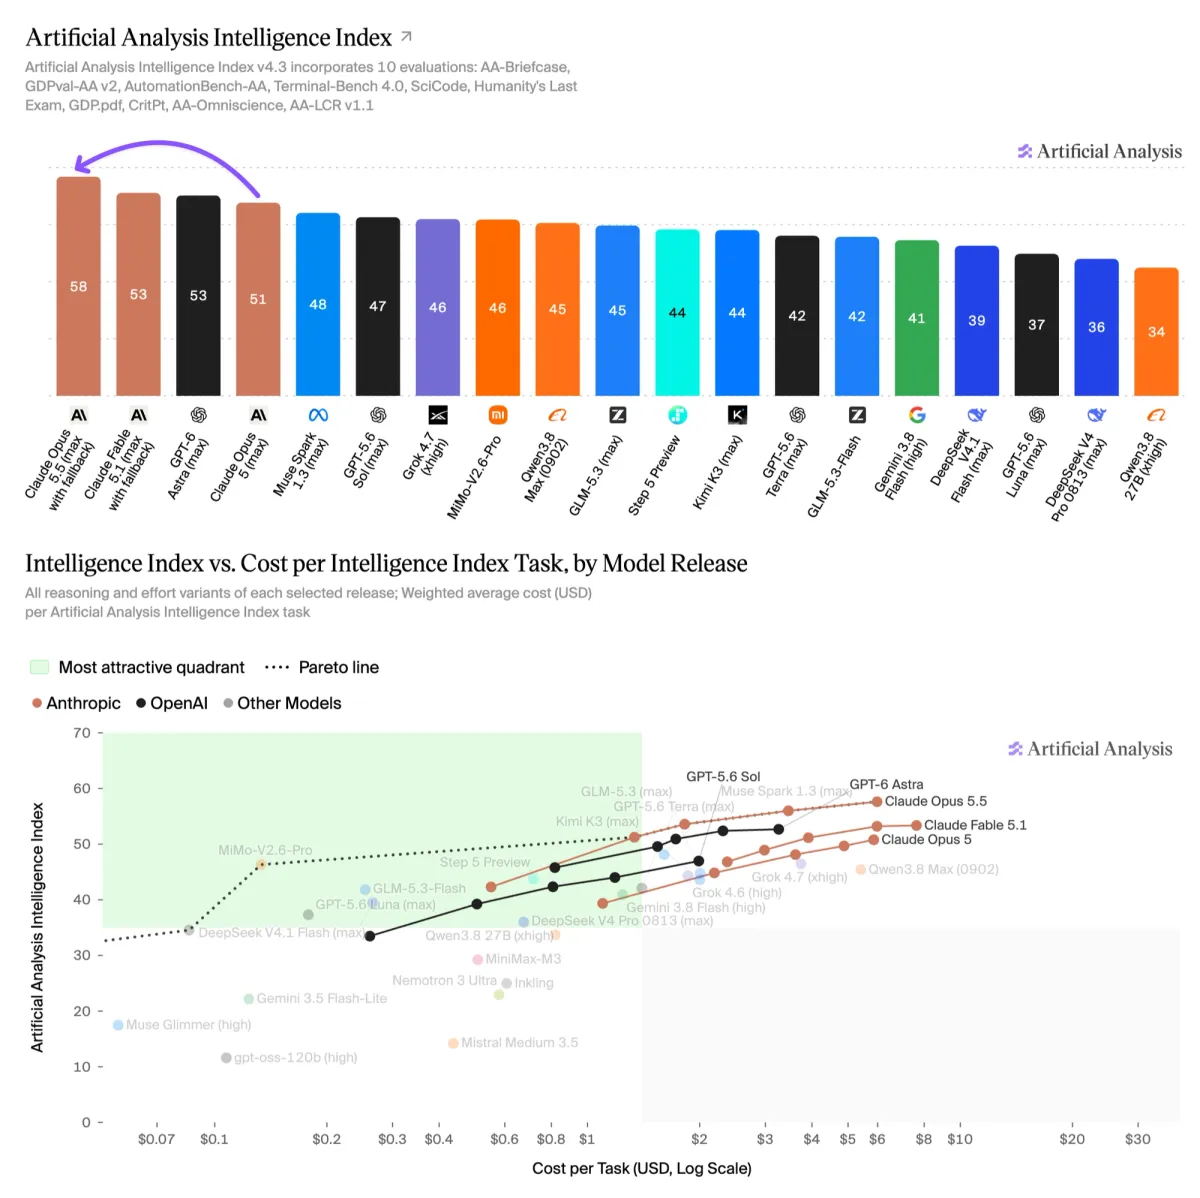
چهار مورد از پنج سطح تلاش مدل Claude Opus 5.5 در مرز هوشمندی بهینه نسبت به هزینه قرار دارند. این سطوح هزینه کمتری داشته یا از سایر مدلهای برتر عملکرد بهتری نشان میدهند.
مدل Claude Opus 5.5 (در حالت max) در زمینه کارهای دانشی ایجنتها بهترین عملکرد را دارد. این مدل با امتیاز ۱۸۲۲ در Briefcase و امتیاز ۱۸۴۶ در GDPval پیشتاز است. همچنین در بخش کیفیت تحلیل و ارائه نیز رتبه نخست را در اختیار دارد.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی

رکورد ۸۳۳ هزار دانلود ماهانه برای LEGAL-BERT؛ وقتی توسعهدهندهها قید مدلهای گرانقیمت را میزنند!
مدل زبانی تخصصی LEGAL-BERT با ثبت بیش از ۸۳۳ هزار دانلود در ماه روی پلتفرم هاگینگ فیس حسابی خبرساز شده است. این ابزار جمعوجور و تخصصی نشان میدهد که برای پردازش و تحلیل متون حقوقی، حتماً نیازی به مدلهای غولپیکر و پرهزینه ندارید و گزینههای بهینه همچنان در اوج هستند.

جاسوسی هوش مصنوعی در محل کار؛ کارمندان میگویند کارفرماها باید قانوناً مچگیریهایشان را لو بدهند!
نظرسنجیهای تازه نشان میدهد که بیشتر کارمندان حس میکنند مدیرانشان با ابزارهای هوش مصنوعی تمام حرکات آنها را زیر نظر گرفتهاند. حالا بیش از ۸۰ درصد شاغلان خواستار تصویب قانونی شدهاند که شرکتها را مجبور کند هرگونه مچگیری و نظارت هوش مصنوعی در محیط کار را رسماً اعلام کنند.

گزارش داغ مایکروسافت از نفوذ جهانی هوش مصنوعی؛ امارات در صدر و رتبه عجیب آمریکا!
مایکروسافت در تازهترین گزارش خود از ضریب نفوذ هوش مصنوعی در جهان پرده برداشت؛ آماری شگفتانگیز که نشان میدهد امارات و سنگاپور با فاصلهای خیرهکننده پیشتاز دنیا هستند و در مقابل، آمریکا در رتبه ۲۱ جا مانده است. همچنین الگوی استفاده از هوش مصنوعی میان کشورهای غربی و کشورهای در حال توسعه، از تفاوتی عمیق میان کاربردهای روزمره و آموزش پرده برمیدارد.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.