قابلیت جدید Anthropic، حجم درخواست ایجنتهای هوش مصنوعی را از ۸۰۰ به ۱٫۸ کیلوبایت کاهش داد
شرکت Anthropic از قابلیت آزمایشی ترد پیامها در رابط برنامهنویسی خود رونمایی کرد که وضعیت مکالمه را در سمت سرور ذخیره میکند. این نوآوری با حذف لزوم ارسال مکرر تاریخچه گفتگو، حجم درخواست ایجنتهای هوش مصنوعی را بهشدت کاهش میدهد و سرعت آغاز پردازش مدل را بهطور چشمگیری بالا میبرد.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- شرکت Anthropic با معرفی قابلیت ترد پیامها در API خود، تاریخچه گفتگو را روی سرور نگه میدارد تا نیازی به ارسال مکرر کل مکالمات در هر درخواست نباشد.
- این قابلیت در ابزار Claude Code توانسته است حجم درخواستهای طولانی را از حدود ۸۰۰ کیلوبایت به ۱٫۸ کیلوبایت برساند و زمان شروع پاسخدهی را تا ۳۵ درصد سریعتر کند.
- هزینه توکنها و سقف پنجره متنی مدل تغییری نمیکند و هدف اصلی این راهکار، بهینهسازی پهنای باند و کاهش تأخیر شبکه در بارهای کاری سنگین است.
شرکت Anthropic نسخه بتای عمومی قابلیت ترد پیامها (Message Threads) را برای Messages API منتشر کرده است. این قابلیت وضعیت فعال گفتگو را در فاصله بین نوبتها روی سرورهای Anthropic ذخیره میکند و به کلاینتها اجازه میدهد بهجای آپلود کل تاریخچه گفتگو در هر درخواست، تنها پیامهای جدید را ارسال کنند.
کاهش حجم بار ارسالی باعث صرفهجویی در زمان سریالسازی دادهها و کاهش مدتزمان آپلود پیش از آغاز تولید پاسخ توسط Claude میشود. این بهبود بهویژه در ایجنتهای کدنویسی، حلقههای تعامل مستقیم با رایانه و سایر کاربردهایی که طی رفتوبرگشتهای متعدد صدها هزار توکن در زمینه خود ذخیره میکنند، بهوضوح ملموس و قابل اندازهگیری است.
چرا درخواستهای سنگین در ایجنتها با کندی مواجه میشوند؟
کاربران و برنامههای متصل به Messages API معمولاً در هر نوبت تمام پیامهای قبلی و نتایج ابزارها را دوباره به سرور ارسال میکنند. یک ایجنت کدنویسی در طول فعالیت طولانی خود ممکن است صدها درخواست بفرستد و همزمان محتوای فایلها، تغییرات کد، خروجی دستورها و پاسخهای مدل را در زمینه خود انباشته کند. در مقیاسهای بزرگ متنی، هر درخواست میتواند شامل چندین مگابایت داده در قالب JSON باشد که باید سریالسازی شده و از طریق پروتکل HTTPS آپلود شود.
قابلیت ترد پیامها این چرخه ارسال را دگرگون میکند. در این شیوه، نخستین درخواست کل گفتگو را در بر میگیرد و یک ترد جدید باز میکند؛ اما درخواستهای بعدی تنها حامل پیامهای جدید و شناسه یکتایی هستند که پاسخ قبلی دریافت کرده است. بدین ترتیب Anthropic وضعیت قبلی را در سرور نگه میدارد و زمینه کامل گفتگو را برای Claude بازسازی میکند.
نتایج ملموس در ابزار Claude Code
شرکت Anthropic این قابلیت را در ابزار Claude Code ارزیابی کرده و میانگین نتایج را به شرح زیر گزارش داده است:
شاخص | نتیجه |
|---|---|
زمان تا دریافت نخستین توکن برای درخواستهای ۵۰۰ هزار تا ۱ میلیون توکن | حدود ۳۵ درصد کمتر |
حجم درخواست در گفتگوهای طولانی Claude Code | کاهش از حدود ۸۰۰ کیلوبایت به ۱٫۸ کیلوبایت |
میزان مصرف توکن | بدون تغییر |
مدل Claude همچنان در هر نوبت کل گفتگو را پردازش میکند؛ بنابراین هزینه توکنهای ورودی تغییری نمیکند. این صرفهجویی و کاهش زمان صرفاً ناشی از انتقال دادههای بسیار کمتر میان کلاینت و سرورهای Anthropic پیش از شروع استنتاج مدل است.
تنها یکبار ارسال تاریخچه گفتگو
برای فعالسازی این قابلیت، افزودن پارامتر thread و هدر اختصاصی نسخه بتا در درخواستها ضروری است. در مستندات API شرکت Anthropic ساختار و شمای دقیق این درخواستها تشریح شده است.
- ارسال کل گفتگو در نخستین درخواست Messages API.
- ذخیره شناسه پاسخ بازگرداندهشده توسط سرورهای Anthropic.
- ارسال صرفاً پیامهای جدید در نوبت بعدی بههمراه ارجاع به شناسه پاسخ قبلی.
- تکرار این الگو تا زمانی که ترد همچنان فعال و معتبر است.
- ارسال مجدد کل تاریخچه گفتگو در صورت انقضای ترد.
طول عمر پنج دقیقهای و سازوکار مدیریت پایداری
تردها وضعیتی کوتاهمدت را در سمت سرور نگهداری میکنند؛ از این رو کلاینتها در محیطهای عملیاتی همچنان باید نسخه مرجع تاریخچه گفتگو را برای مواقع بازیابی نزد خود حفظ کنند.
جزئیات عملیاتی | رفتار سیستم |
|---|---|
ذخیرهسازی | وضعیت ترد رمزنگاری شده و فقط در حافظه رم نگهداری میشود و روی دیسک ذخیره نمیگردد. |
زمان انقضا | یک ترد پنج دقیقه پس از ثبت آخرین درخواست منقضی میشود. |
بازیابی | کلاینت با ارسال دوباره کل مکالمه، یک ترد تازه ایجاد میکند. |
دسترسیپذیری | قابلیت ترد پیامها در پلتفرم بومی Claude، پلتفرم Claude روی AWS، سرویس Microsoft Foundry و مدلهای Claude در گوگل کلود فعال است. |
قیمتگذاری | تعرفه استاندارد توکنها طبق روال معمول اعمال میشود. |
بیشترین بهره برای پردازشهای سنگین و طولانی
بارهایی که رفتوبرگشت پیاپی و دادههای ارسالی سنگینی دارند، بیشترین کاهش تأخیر را تجربه میکنند:
- ایجنتهای کدنویسی طولانیمدت: خواندن مداوم فایلها، تغییرات کد، خروجی دستورات و بازخورد ابزارها بهمرور حجم گفتگو را بهشدت گسترش میدهند.
- ایجنتهای تعامل با رایانه (Computer-Use): اسکرینشاتها در طول ترد ذخیره میمانند و نیازی نیست در هر نوبت دوباره آپلود شوند.
- فرایندهای مبتنی بر اسناد و تصاویر حجیم: فایلهای پیوست بزرگ در ترد فعال حفظ میشوند، در حالی که کاربر صرفاً درخواستهای متنی کوتاه بعدی را ارسال میکند.
مکالمات کوتاه با چند هزار توکن تغییر محسوسی احساس نخواهند کرد؛ اما حلقههای تعاملی ایجنتها که طی دهها گام پیوسته باری بالغ بر ۵۰۰ هزار توکن را حمل میکنند، از حجم چشمگیری از آپلودهای تکراری بینیاز میشوند.
مدل همچنان تمامی توکنها را پردازش میکند
قابلیت ترد پیامها فرایند انتقال درخواست و مدیریت نشستهای کوتاهمدت را بهینه میکند، اما سایر بخشهای کلیدی رفتار API بدون تغییر باقی میمانند:
- محاسبه هزینه توکنها همچنان بر پایه کل زمینه پردازششده توسط Claude انجام میپذیرد.
- سقف پنجره متنی مدل افزایش نیافته است.
- سازوکار ذخیرهسازی موقت پرامپت (Prompt Caching) دستنخورده باقی میماند.
- برنامهها باید همچنان طول گفتگو را مدیریت و کنترل کنند.
- کلاینتها موظفند وضعیت کافی برای بازیابی پس از انقضای ترد را نزد خود نگه دارند.
تیمهایی که از ایجنتهای Claude با زمینههای متنی بزرگ استفاده میکنند، میتوانند تنها با تغییری جزئی در ساختار درخواستها و پیشبینی سازوکار انقضا، این امکان را به کار بگیرند. سنجش زمان تا دریافت اولین توکن و حجم درخواستها مشخص خواهد کرد که آیا حجم دادههای یک سرویس برای بهرهگیری از این ویژگی به حد نصاب میرسد یا خیر.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
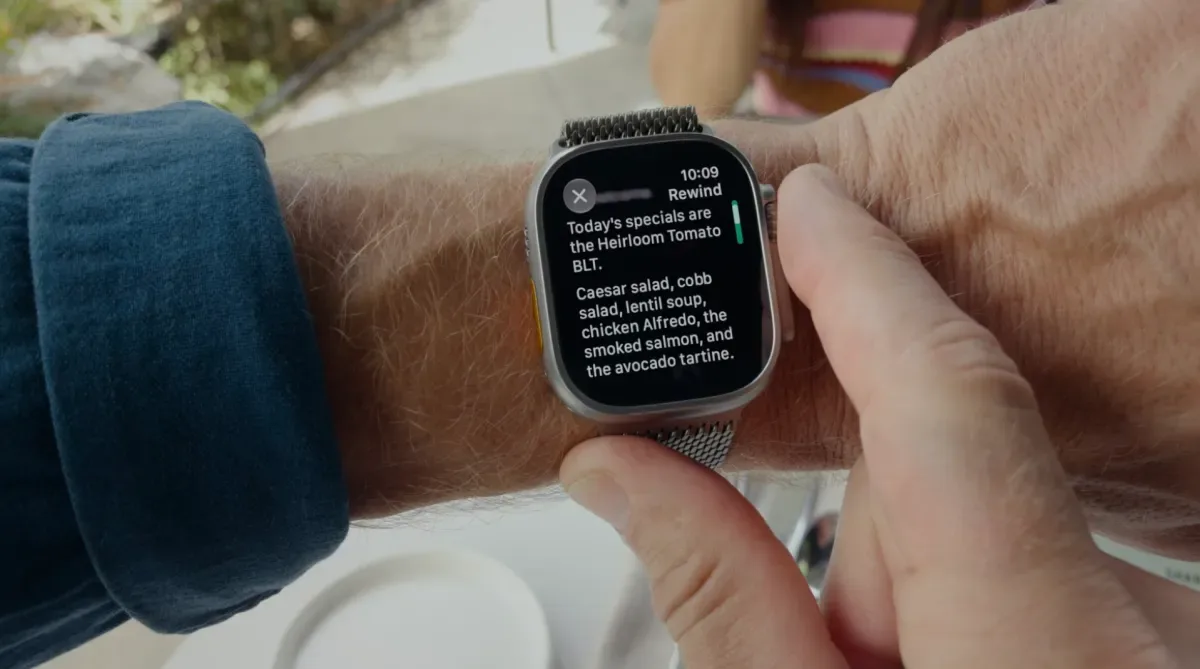
آغاز آزمایش قابلیتهای هوش مصنوعی Apple Watch برای مرور و خلاصهسازی مکالمات
اپل فاز آزمایشی فناوری جدید Audio Intelligence را برای ساعتهای هوشمند خود کلید زده است. این قابلیتهای مجهز به هوش مصنوعی به کاربران امکان میدهند بخشهای نشنیده از گفتگوها را بازخوانی کنند و خلاصهای ساختاریافته از مکالمات روزمره تحویل بگیرند.
افزایش ۷۲ برابری سرعت پردازش هوش مصنوعی؛ راهکار جدید دانشگاه ETH Zurich برای متنهای ۱۰ میلیون توکنی
پژوهشگران دانشگاه ETH Zurich و استارتاپ Prefrontal AI با معرفی معماری جدید LSA، گلوگاه پردازش متنهای فوقطولانی در مدلهای هوش مصنوعی را برطرف کردند. این روش با سازماندهی معنایی دادهها، سرعت پردازش را در پنجرههای متنی ۱۰ میلیون توکنی تا ۷۲ برابر افزایش میدهد و کارایی مدلها را بهشدت ارتقا میبخشد.
هشدار رئیس Blackstone درباره ریسک بدهیها؛ توسعه زیرساخت هوش مصنوعی نیازمند سرمایهگذاری مستقیم است
رئیس شرکت Blackstone هشدار داد که موج عظیم سرمایهگذاری در زیرساخت هوش مصنوعی، خطرات بزرگی برای وامدهندگان ایجاد کرده است. بهگفته او، هزینههای هنگفت مراکز داده و توان پردازشی فراتر از ظرفیت بازار بدهی است و این حوزه به سرمایهگذاری مستقیم و سهامداری بیشتری نیاز دارد.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.