افزایش ۷۲ برابری سرعت پردازش هوش مصنوعی؛ راهکار جدید دانشگاه ETH Zurich برای متنهای ۱۰ میلیون توکنی
پژوهشگران دانشگاه ETH Zurich و استارتاپ Prefrontal AI با معرفی معماری جدید LSA، گلوگاه پردازش متنهای فوقطولانی در مدلهای هوش مصنوعی را برطرف کردند. این روش با سازماندهی معنایی دادهها، سرعت پردازش را در پنجرههای متنی ۱۰ میلیون توکنی تا ۷۲ برابر افزایش میدهد و کارایی مدلها را بهشدت ارتقا میبخشد.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- پژوهشگران با معرفی سازوکار توجه تنک نهفته یا LSA توانستند سرعت پردازش پنجرههای متنی ۱۰ میلیون توکنی را تا ۷۲ برابر افزایش دهند.
- در مدلهای زبانی بزرگ حدود ۹۸ درصد زمان پردازش لایههای توجه در متنهای فوقطولانی صرف ارزیابی اولیه و نمایهسازی توکنها میشود.
- معماری LSA با خوشهبندی معنایی دادهها ضمن ارتقای چشمگیر سرعت، امکان پیادهسازی روی مدلهای موجود و آموزش مدلهای تازه از پایه را فراهم میکند.
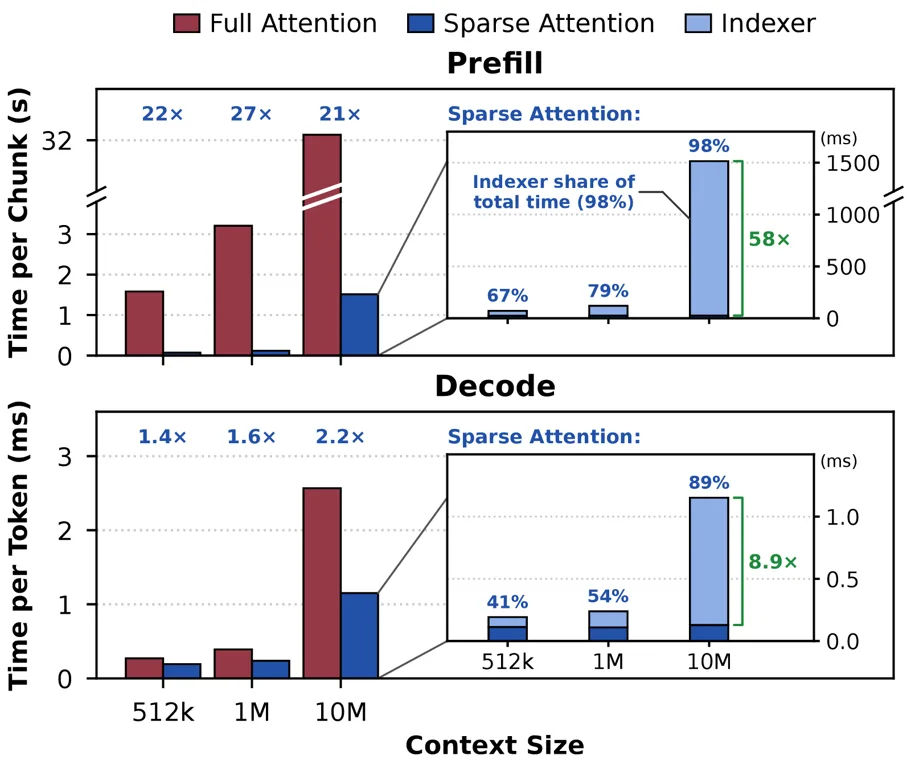
در سازوکار توجه کامل (Full Attention)، تکتک توکنهای پرسش (Query) با تمام توکنهای کلید (Key) مقایسه میشوند؛ به همین دلیل، زمان پردازش متن ورودی با افزایش طول زمینه، بهصورت تصاعدی و درجهدو (Quadratic) بالا میرود. روشهای توجه تنک (Sparse Attention) حجم محاسبات نهایی را با انتخاب مجموعهای محدود از کلیدها کاهش میدهند، اما نمایهسازهای مرسوم همچنان مجبورند تکتک جفتهای پرسش و کلید را امتیازدهی و ارزیابی کنند. پژوهشگران استارتاپ Prefrontal AI و دانشگاه ETH Zurich گزارش دادهاند که این مرحله گزینش در مدل GLM-5.3-Flash و در طول زمینه ۱۰ میلیون توکن، حدود ۹۸ درصد از کل زمان اجرای یک لایه توجه را به خود اختصاص میدهد.
این تیم پژوهشی برای حل این معضل، سازوکار «توجه تنک نهفته» (Latent Sparse Attention یا LSA) را پیشنهاد کرده است؛ رویکردی که کلیدها را درون یک فضای نهفته آموختهشده خوشهبندی میکند و به پرسشها امکان میدهد تنها میان این خوشهها به جستجو بپردازند. نسخه سلسلهمراتبی این روش موسوم به D-LSA رشد محاسباتی مرحله پیشدرخواست (Prefill) را از حالت درجهدو به حدود O(T log T) کاهش میدهد که در آن T نمایانگر طول توالی است. این شیوه نوین هم برای تطبیق و ارتقای چکپوینتهای موجود و هم برای آموزش مدلهای جدید از پایه بهخوبی کارایی دارد.
در مقیاس ۱۰ میلیون توکن، نمایهسازی گلوگاه اصلی پردازش میشود
مدلها در مرحله پیشدرخواست، پرامپت اولیه را پردازش کرده و حافظه موقت کلید و مقدار (KV Cache) را شکل میدهند. سپس در مرحله رمزگشایی (Decoding)، هر توکن تولیدشده به جستجو در این حافظه میپردازد. یک نمایهساز تنک سنتی شاید در نهایت فقط تعداد معدودی از کلیدها را برای اعمال توجه برگزیند، اما ابتدا باید تکتک کلیدهای موجود را بسنجد تا تصمیم بگیرد کدامیک حفظ شوند. در نتیجه، هزینه نمایهسازی در مرحله پیشدرخواست همچنان بهصورت درجهدو باقی میماند، در حالی که هر گام رمزگشایی نیز رفتاری خطی متناسب با طول متن موجود نشان میدهد.
روشهای توجه تنک بلوکی (Block-sparse) با انتخاب نواحی ثابت هزینه نمایهسازی را کمتر میکنند، اما این خطر وجود دارد که توکنهای مرتبط در خارج از آن بخشهای مشخص قرار بگیرند. سایر الگوهای سلسلهمراتبی نیز به محدودیتهای استریم یا نمایههای مشترک میان لایهها متکی هستند. در مقابل، معماری LSA کلیدها را بر پایه بازنمایی محتوایی آموختهشده سازماندهی میکند؛ قابلیتی که به هر پرسش اجازه میدهد بخشهای مرتبط از نظر معنایی را از سراسر متن استخراج کند.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
آغاز آزمایش قابلیتهای هوش مصنوعی Apple Watch برای مرور و خلاصهسازی مکالمات
اپل فاز آزمایشی فناوری جدید Audio Intelligence را برای ساعتهای هوشمند خود کلید زده است. این قابلیتهای مجهز به هوش مصنوعی به کاربران امکان میدهند بخشهای نشنیده از گفتگوها را بازخوانی کنند و خلاصهای ساختاریافته از مکالمات روزمره تحویل بگیرند.
هشدار رئیس Blackstone درباره ریسک بدهیها؛ توسعه زیرساخت هوش مصنوعی نیازمند سرمایهگذاری مستقیم است
رئیس شرکت Blackstone هشدار داد که موج عظیم سرمایهگذاری در زیرساخت هوش مصنوعی، خطرات بزرگی برای وامدهندگان ایجاد کرده است. بهگفته او، هزینههای هنگفت مراکز داده و توان پردازشی فراتر از ظرفیت بازار بدهی است و این حوزه به سرمایهگذاری مستقیم و سهامداری بیشتری نیاز دارد.
گارتنر: مدلهای وزنباز ۹۰ درصد وظایف عاملهای هوشمند را با یکبیستم هزینه انجام میدهند
گزارش جدید موسسه گارتنر نشان میدهد مدلهای وزنباز قادرند بخش عمده وظایف روزمره در عاملهای هوش مصنوعی را با کسری از هزینه مدلهای تجاری پیشرو اجرا کنند. تحلیلگران پیشبینی میکنند تا سال ۲۰۳۰ بیش از ۹۰ درصد مراحل عملیاتی سازمانها به این مدلها واگذار شود و ارزش اصلی بازار به بسترهای مدیریت و هماهنگسازی عاملها منتقل گردد.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.