اجرای کامل یک پژوهش فیزیک کوانتوم با سیستم Auctopus و ایجنتهای هوش مصنوعی
پژوهشگران در ژاپن با توسعه سیستم متنباز Auctopus، برای نخستین بار یک مطالعه کامل در حوزه فیزیک کوانتوم را با هدایت ایجنتهای هوش مصنوعی به سرانجام رساندند. در این آزمایشگاه خودکار، ایجنتها با تفکیک نقشها و امکان رد ایدههای ضعیف، مراحل نظریهپردازی تا آزمایش روی سختافزار واقعی را مدیریت کردند.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- ایجنتهای هوش مصنوعی در سیستم Auctopus تمام مراحل یک پروژه فیزیک کوانتوم شامل طرح فرضیه، محاسبه در ابررایانه و آزمایش روی سختافزار کوانتومی را به انجام رساندند.
- این آزمایشگاه خودکار با ایجاد نقشهای مستقل و سازوکار وتو، توانست ۷۴ ایده از میان ۷۵ پروپوزال ضعیف یا دارای خطای منطقی را برای جلوگیری از نتایج کاذب رد کند.
- پژوهشگران انسانی تنها وظیفه ساخت تجهیزات و نظارت بر ایمنی فیزیکی را بر عهده داشتند و تصمیمگیریهای علمی در چارچوب پروژه بهطور کامل توسط ایجنتها صورت گرفت.
پژوهشگران دانشگاه علوم توکیو (Institute of Science Tokyo) از دستاوردی خبر دادهاند که احتمالاً نخستین نمونه در نوع خود بهشمار میرود: اجرای صفر تا صد یک مطالعه علمی توسط آزمایشگاهی متشکل از ایجنتهای مبتنی بر مدلهای زبانی بزرگ. این سامانه پرسشهای پژوهشی را طراحی کرد، پیشنهادهای ضعیف را کنار گذاشت، به یک نتیجه نظری دست یافت، محاسبات آن را روی ابررایانه آزمود و در نهایت پیشبینی حاصل را روی سختافزار واقعی فیزیک کوانتوم آزمایش کرد. در این میان، پژوهشگران انسانی تنها وظیفه ساخت تجهیزات و نظارت بر ایمنی سامانه را بر عهده داشتند؛ در حالی که ایجنتها در چارچوب مشخصشده پژوهش، تمامی تصمیمگیریهای علمی را انجام دادند و دستورهای تأییدشده را به ابزارها فرستادند.
مقاله پژوهشی این تیم به یکی از چالشهای بنیادین سامانههای دانشمند هوش مصنوعی میپردازد: نتیجهگیریهای قاطع و کاذب بر پایه شواهد ناکافی. این آزمایشگاه خودکار به ایجنتها امکان میدهد تا پیشنهادها را وتو کنند، بررسیهای نظری مستقل درخواست نمایند، معیارهای پذیرش ثابتی را اعمال کنند و آزمایشهایی طراحی نمایند که توانایی ابطال ادعاهای خودشان را داشته باشد. اعمال همین سازوکارهای کنترلی سختگیرانه سبب شد سامانه در همان گام نخست، یک آزمایش اولیه را حتی با وجود اینکه دادههایش در ظاهر نظریه را تأیید میکردند، رد کند.
نقش تعیینکننده سازوکار وتو در آزمایشگاه
سیستم پایتونی و متنباز Auctopus که ستون اصلی این پژوهش است، نقشهای هر ایجنت را بر اساس ساختار یک گروه تحقیقاتی واقعی شبیهسازی میکند. در این چارچوب، یک ایجنت بهعنوان پژوهشگر ارشد (Principal Investigator) بستری پایدار از مکالمه را حفظ کرده و بر کل پروژه نظارت دارد. سایر ایجنتها شامل ارائهدهنده ایده، پژوهشگر محاسباتی، آزمایشگر، مدیر، مسئول ایمنی و داور در فضاهای متنی تازه و مجزا فعالیت میکنند و تبادل اسناد را از طریق یک هماهنگکننده مرکزی انجام میدهند. این مرزبندیهای اطلاعاتی مانع از پیشفرضهای مشترک و موافقتهای کورکورانه میان نقشها میشود.
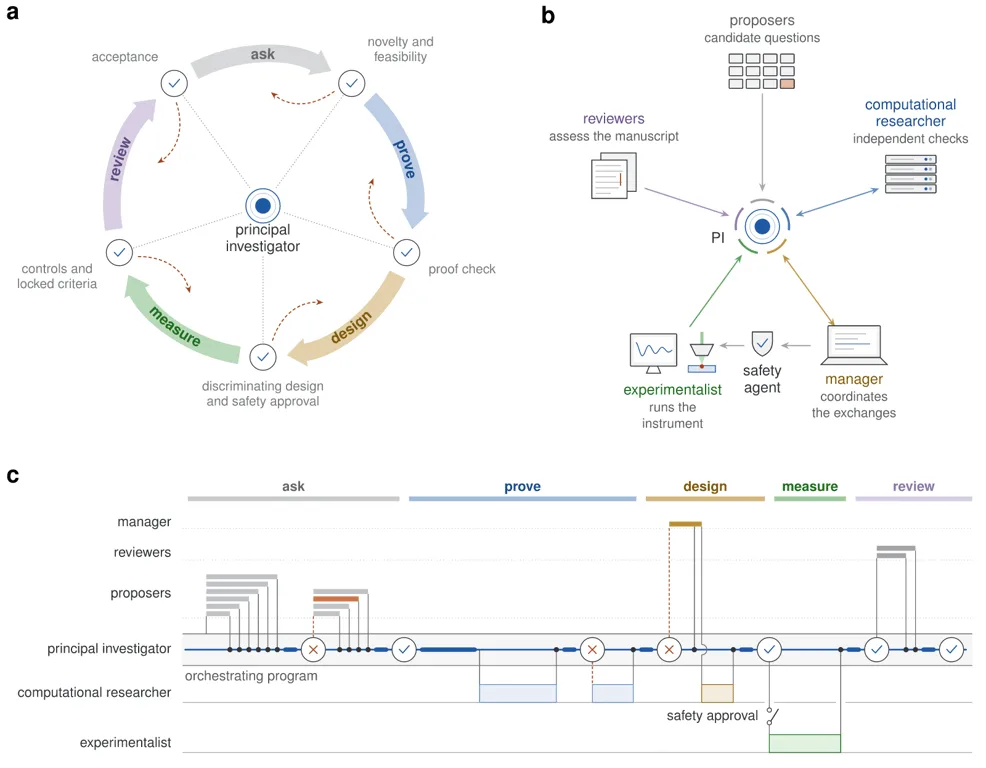
فیلتر ارزیابی پروپوزالها ۷۴ طرح از مجموع ۷۵ طرح پیشنهادی را رد کرد. دلایل ثبتشده برای این رد صلاحیتها مواردی چون خطاهای منطقی، تکرار نتایج پیشین، ارزش علمی محدود و نبود امکان اجرای آزمایش عملی بود. در این میان، ایجنت پژوهشگر ارشد یکی از پروپوزالهای ردشده را بهعنوان مناسبترین نقطه آغاز شناسایی کرد، خواستار اصلاح آن شد و در نهایت نسخه دوم بازبینیشده را تأیید کرد.
مطالب مرتبط و پیشنهادی
مدل امبدینگ ویتنامی BKAI از مرز ۸۰۰ هزار دانلود گذشت؛ رقیبی چابک برای مدلهای چندزبانه
مدل متنباز vietnamese-bi-encoder از آزمایشگاه BKAI با ثبت بیش از ۸۲۴ هزار دانلود در پلتفرم Hugging Face، به یکی از محبوبترین ابزارهای جستجوی معنایی تبدیل شده است. این مدل سبک با تکیه بر معماری دوکدگذار و تمرکز تخصصی بر زبان ویتنامی، کارایی بسیار بالاتری نسبت به مدلهای چندزبانه عمومی ارائه میدهد. توسعهدهندگان میتوانند از این ابزار برای ساخت پایگاههای برداری و پایپلاینهای سریع RAG با هزینه محاسباتی اندک استفاده کنند.
مدل جدید Audio8 از استارتاپ Edge0 با تنها ۶۰۰ میلیون پارامتر، صدای هر فرد را به ۲۳ زبان شبیهسازی میکند
استارتاپ Edge0 از مدل صوتی متنباز Audio8-TTS-Realistic-Air با ۶۰۱ میلیون پارامتر رونمایی کرد. این مدل سبک با تکیه بر معماری خودبازگشتی دوگانه، توانایی شبیهسازی آنی صدای گوینده به ۲۳ زبان زنده را دارد. دسترسی آزاد به وزنها و کدهای این مدل تحت مجوز Apache 2.0 امکان اجرای محلی آن را فراهم میکند.
موتور جستجوی RustXNG با بازنویسی کدهای SearXNG به زبان Rust، سرعت جستجو را ۱۰ برابر کرد
پروژه متنباز RustXNG نسخه بازنویسیشده موتور جستجوی SearXNG به زبان Rust است که با هدف ارتقای سرعت سیستمهای بازیابی اطلاعات و ایجنتهای هوش مصنوعی توسعه یافته است. این ابزار به توسعهدهندگان اجازه میدهد بدون وابستگی به سرویسهای پولی، نتایج وب زنده را بهصورت محلی با سرعت تا ۱۰ برابر بیشتر دریافت و ادغام کنند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.