مدل جدید Audio8 از استارتاپ Edge0 با تنها ۶۰۰ میلیون پارامتر، صدای هر فرد را به ۲۳ زبان شبیهسازی میکند
استارتاپ Edge0 از مدل صوتی متنباز Audio8-TTS-Realistic-Air با ۶۰۱ میلیون پارامتر رونمایی کرد. این مدل سبک با تکیه بر معماری خودبازگشتی دوگانه، توانایی شبیهسازی آنی صدای گوینده به ۲۳ زبان زنده را دارد. دسترسی آزاد به وزنها و کدهای این مدل تحت مجوز Apache 2.0 امکان اجرای محلی آن را فراهم میکند.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- مدل صوتی سبک Audio8 با ۶۰۱ میلیون پارامتر میتواند صدای هر فرد را بدون نیاز به آموزش مجدد و به ۲۳ زبان مختلف با دقت بالا شبیهسازی کند.
- این مدل با تفکیک برنامهریزی معنایی از بازتولید جزئیات صوتی، در ابعادی بسیار جمعوجور خروجی باکیفیت ۴۴.۱ کیلوهرتز تولید میکند.
- کدهای اجرایی و وزنهای این مدل تحت مجوز متنباز Apache 2.0 منتشر شدهاند و روی پردازنده گرافیکی NVIDIA H20 ارزیابی شدهاند.
استارتاپ Edge0 از مدل تبدیل متن به گفتار جدیدی به نام Audio8-TTS-Realistic-Air با ۶۰۱ میلیون پارامتر رونمایی کرد که از شبیهسازی بلادرنگ و بدون نیاز به آموزش مقدماتی (Zero-shot) صدا به ۲۳ زبان مختلف پشتیبانی میکند. این قابلیت به مدل اجازه میدهد تنها با دریافت یک فایل صوتی مرجع کوتاه و متن آن، لحن و ویژگیهای صدای گوینده را بدون نیاز به هیچگونه فرایند آموزش مجدد یا تنظیم دقیق بازآفرینی کند.
نسخه Realistic Air در واقع یک مدل بهینهسازی و بازتنظیمشده از نسخه قبلی Audio8-TTS-Preview-0.6B بهشمار میرود که به گفته توسعهدهندگان در Edge0، ضمن حفظ همان ابعاد فشرده و سبک، وضوح و طبیعی بودن گفتار را بهشکل محسوسی ارتقا داده است. این انتشار تحت مجوز متنباز Apache 2.0 ارائه شده و شامل وزنهای مدل، توکنایزر، کدهای اختصاصی سازگار با کتابخانه Transformers و یک کدک عصبی صوتی است که صدایی شفاف با نرخ نمونهبرداری ۴۴.۱ کیلوهرتز تولید میکند.
معماری خودبازگشتی دوگانه؛ رمز حفظ ابعاد جمعوجور مدل
مدل Audio8 بر پایه معماری خودبازگشتی دوگانه (DualAR) طراحی شده است؛ همان رویکرد موفقی که پیشتر در مدل Fish Audio S2 Pro نیز به کار رفته بود. در این ساختار، یک ترنسفورمر خودبازگشتی ۲۴ لایه وظیفه دارد برای هر فریم صوتی یک توکن معنایی را پیشبینی کند و جریان محتوا، کلمات و زمانبندی گفتار را زیر نظر بگیرد. سپس یک ترنسفورمر بهمراتب کوچکتر با ۴ لایه، کتابچههای کد (Codebooks) کدک را پیشبینی میکند که حاوی جزئیات ظریف آکوستیک، رنگ صدا و لحن بیان هستند.
در مرحله بعد، کدک صوتی این مقادیر و کدهای آکوستیک را دریافت کرده و آنها را مستقیماً بهشکل موج صوتی بازسازی میکند. تفکیک فرایند برنامهریزی توالی کلمات از بازتولید جزئیات لحظهای فریمها، برگ برنده این طراحی است؛ زیرا به مدل اصلی اجازه میدهد در ابعادی بسیار جمعوجور و سبک باقی بماند و در عین حال، خروجی صوتی با بالاترین کیفیت ممکن خلق کند.
مشخصات معماری و جزئیات فنی اجرا
- مدل اصلی: ۶۰۱ میلیون پارامتر (بدون محاسبه کدک صوتی)
- ترنسفورمر کند (برنامهریز معنایی): ۲۴ لایه با اندازه لایه پنهان ۸۹۶ واحد
- ترنسفورمر سریع (تولید جزئیات): ۴ لایه پردازشی
- کدک عصبی: ۱۰ کتابچه کد، هر کدام شامل ۴٬۰۹۶ مدخل
- کیفیت صدا: خروجی ۴۴.۱ کیلوهرتز با نرخ حدود ۲۱.۵ فریم کدک در ثانیه
- پنجره زمینه (Context Window): تا ۲٬۰۴۸ موقعیت مشترک برای متن و صدا
- دقت محاسباتی: فرمت BF16
- سختافزار تستشده: پردازنده گرافیکی NVIDIA H20
متن ورودی، فایل صوتی مرجع برای شبیهسازی و گفتار نهایی تولیدشده همگی پنجره زمینه مشترک ۲٬۰۴۸ موقعیتی مدل را اشغال میکنند؛ بنابراین هرچه متن راهنما یا صدای مرجع طولانیتر باشد، فضای باقی مانده برای تولید گفتار جدید محدودتر خواهد بود. با توجه به نرخ ۲۱.۵ فریم صوتی در ثانیه، اختصاص تمام این ظرفیت فقط به صدا معادل حدود ۹۵ ثانیه گفتار پیوسته است؛ هرچند با در نظر گرفتن توکنهای متن و دادههای مرجع، طول واقعی هر خروجی در کاربردهای عملی کمتر از این میزان خواهد بود.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
جهش تقاضا برای تجهیزات هوش مصنوعی، کارخانههای آمریکا را تحت فشار گذاشت
رونق بیسابقه تجهیزات مرتبط با هوش مصنوعی و مراکز داده، تولید کارخانههای آمریکا را به بالاترین سطح در سالهای اخیر رسانده است. با این حال، افزایش شدید تقاضا در کنار رشد هزینههای انرژی، زنجیره تأمین را دچار تنگنا کرده و به افزایش قیمتها دامن زده است.
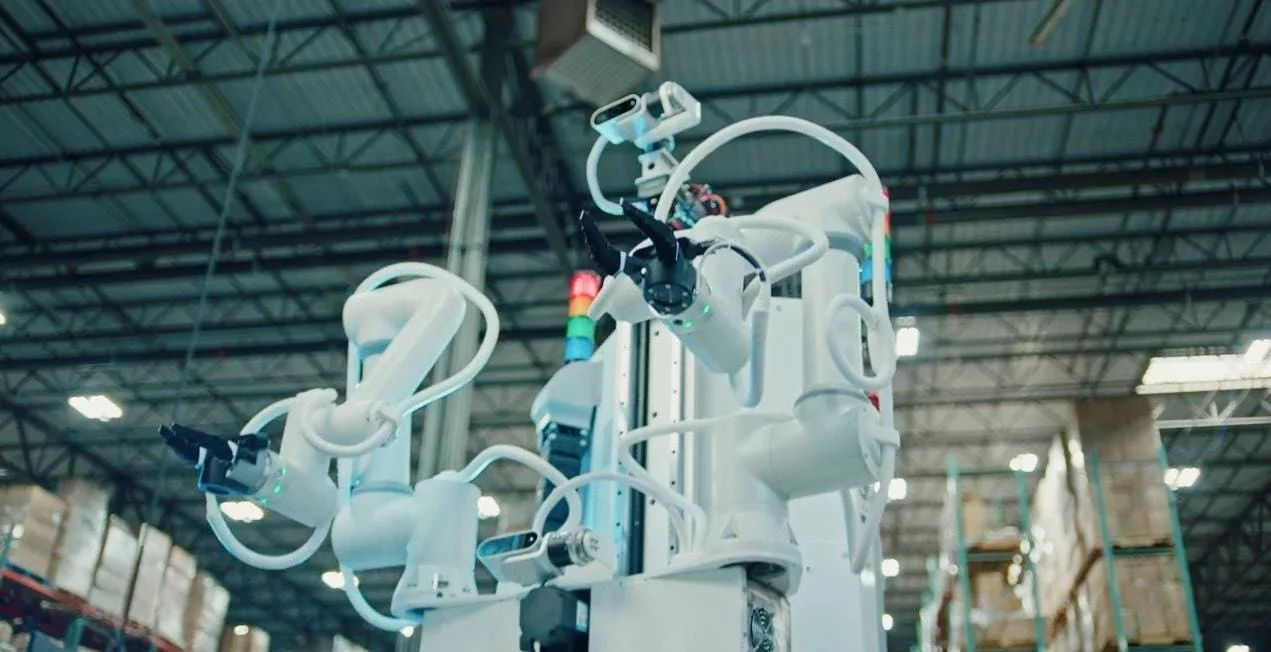
آموزش رباتها حین کار توسط انسان؛ راهکار نوآورانه استارتاپ Tutor برای هوشمندسازی ماشینها
استارتاپ رباتیک Tutor با رویکردی نوآورانه، رباتهای صنعتی را حین انجام کار واقعی و با هدایت مستقیم اپراتورهای انسانی آموزش میدهد. در این روش، مهارتهای جدید هر ربات به دادههای آموزشی تبدیل شده و با بهروزرسانی مدلهای پایه، به تمام ناوگان ماشینها منتقل میشود.
رخنه امنیتی در پلتفرم هوش مصنوعی Trigger.dev؛ کلیدهای محرمانه و متغیرهای محیطی کاربران به سرقت رفت
پلتفرم ابری Trigger.dev که برای ساخت ایجنتها و خودکارسازی فرآیندهای هوش مصنوعی کاربرد دارد، از وقوع یک رخنه امنیتی خبر داد. در جریان این نفوذ، متغیرهای محیطی و کلیدهای دسترسی حساس شماری از سازمانها افشا شده است. کارشناسان به توسعهدهندگان پیشنهاد میکنند برای امنیت بیشتر، از نسخه متنباز و میزبانی شخصی این پلتفرم استفاده کنند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.