ارتباط متنی بین مدلهای زبانی با فناوری جدید C2C منسوخ میشود
فناوری جدید C2C به مدلهای هوش مصنوعی اجازه میدهد تا به جای متن، از طریق حافظه کش KV با یکدیگر ارتباط برقرار کنند؛ روشی که علاوه بر کاهش تأخیر، دقت سیستمهای چندمدلی را بهطور چشمگیری افزایش میدهد.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- محققان با معرفی روش Cache-to-Cache (C2C)، امکان تبادل اطلاعات بین مدلهای زبانی را از طریق حافظه پنهان (KV Cache) به جای تولید متن فراهم کردهاند.
- این روش در بنچمارکها توانسته دقت را ۳.۱ تا ۵.۴ درصد نسبت به ارتباط متنی افزایش دهد و سرعت پردازش را نیز به شکل قابلتوجهی بالا ببرد.
- با حذف نیاز به تولید و پردازش توکنهای متنی میانی، تأخیر در سیستمهای شامل ایجنتهای هوشمند کاهش یافته و هزینه پردازش بهینه میشود.
هنگامی که یک سیستم متشکل از چند مدل زبانی (LLM) وظیفهای را از طریق متن به مدل دیگری میسپارد — خواه یک مسیریاب (Router) در حال جابهجایی بین مدلها باشد یا ایجنتهایی که برای انجام یک کار همکاری میکنند — مدل اول باید اطلاعات خود را در قالب متن فشرده کند. در مقابل، مدل بعدی باید آن متن را بخواند و اطلاعات نهفته در آن را بازسازی کند. این فرایند دستبهدست شدن اطلاعات میتواند منجر به از دست رفتن دادهها و افزایش زمان استنتاج (Inference) شود.
فناوری Cache-to-Cache (C2C) که توسط پژوهشگران دانشگاه Tsinghua و سایر مؤسسات تحقیقاتی چینی پیشنهاد شده است، تلاش میکند تا با فراهم کردن امکان تبادل اطلاعات از طریق نمایشهای داخلی ذخیرهشده در حافظه پنهان کلید-مقدار (KV Cache) به جای تکیه صرف بر متن میانی، این مشکل را برطرف کند.
در بررسیهای انجامشده، C2C توانست دقت را در مقایسه با ارتباط متنی حدود ۳٫۱ تا ۵٫۴ واحد درصد بهبود بخشد و تأخیر را در تمام جفتمدلهای آزمایششده کاهش دهد. برای تیمهای سازمانی که در حال توسعه مسیریابهای مدل یا سیستمهای چند-ایجنتی هستند، این دستاورد نشان میدهد که خود لایه ارتباطی میتواند به یک هدف مهم برای بهینهسازی تبدیل شود.
فناوری C2C همچنین در راستای تحقیقات گستردهتری در زمینه هوش مصنوعی چندمدلی قرار میگیرد که هدف آن، ایجاد امکان تبادل مستقیم نمایشهای داخلی بین مدلهاست، تا دیگر نیازی نباشد هر تبادل اطلاعاتی به اجبار از طریق توکنهای متنی صورت گیرد. این دستاورد در کنفرانس ICLR 2026 منتشر شد و به گفته محققان، قرار است پیادهسازی «KV-Cache مدیریتشده توسط ایجنت» به همراه یک سیستم سرویسدهی عرضه شود.
متن؛ یک گلوگاه پرهزینه بین مدلها
سیستمهای چند-LLM در پیکربندیهای مختلفی عرضه میشوند. در سیستمهای مشارکتی، مدلها نقشهای متفاوتی را بر عهده میگیرند و تحلیلها، دستورالعملها یا راهحلهای جزئی را تبادل میکنند. در سیستمهای مسیریابی، یک هماهنگکننده با پیشرفت یک گفتگو یا جریان کاری، بین مدلهایی با قابلیتها و هزینههای متفاوت جابهجا میشود.
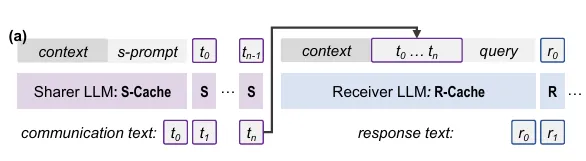
این سیستمها معمولاً برای انتقال اطلاعات بین مدلها به توکنهای متنی متکی هستند. بر اساس گزارشهای منتشرشده، این رویکرد سه مشکل اساسی ایجاد میکند.
نخستین مشکل، از دست رفتن اطلاعات است. یک مدل، زمینه (Context) را به صورت داخلی به عنوان وضعیتهای عددی با ابعاد بالا بازنمایی میکند. برای برقراری ارتباط از طریق متن، مدل باید بخشی از آن بازنمایی را در یک توالی از توکنهای متنی فشرده کند. سپس مدل دریافتکننده باید آن توالی را تفسیر کرده و بازنمایی خاص خود را از آنچه مدل اول در نظر داشته است، بسازد که در این مسیر احتمال از دست رفتن اطلاعات وجود دارد.
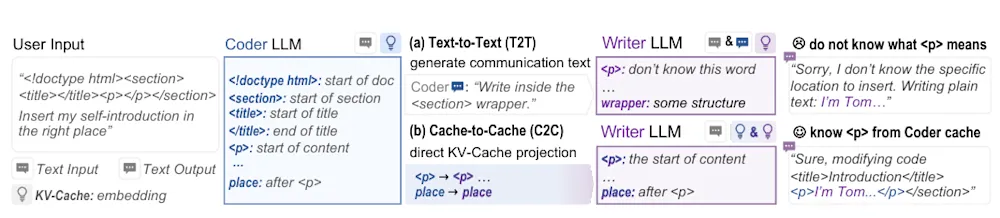
مشکل دیگر این است که اطلاعات متنی میتوانند مبهم باشند. پژوهشگران این موضوع را با یک مدل Coder و یک مدل Writer که در حال ویرایش یک سند HTML هستند، نشان میدهند. مدل Coder درک میکند که تگ <p> به یک موقعیت ساختاری خاص در سند اشاره دارد، اما دستورالعمل متنی آن، این اطلاعات را با دقت کافی منتقل نمیکند. در نتیجه، مدل Writer نمیتواند محتوای خواستهشده را در جای درست قرار دهد.
در نهایت، ارتباط مبتنی بر متن هزینه استنتاج سنگینی را بر سیستم هوش مصنوعی تحمیل میکند. مدل اول باید پیام خود را به صورت متوالی و توکن به توکن تولید کند. سپس این توکنها به ورودی مدل دوم اضافه میشوند که پیش از تولید پاسخ، باید زمینه طولانیتری را پردازش کند. هرچه این انتقال طولانیتر باشد، هر دو مدل باید کار بیشتری انجام دهند. در سیستمهایی با زمینههای طولانی یا انتقالهای مکرر بین ایجنتها، این بار اضافی ارتباطی میتواند به سرعت افزایش یابد.
تبدیل KV Cache به یک لایه ارتباطی
فناوری C2C با برقراری ارتباط از طریق بازنماییهایی که مدلها از پیش ایجاد کردهاند (یعنی KV Cache)، سعی میکند از تولید متن اضافی و پردازش آن توسط دریافتکننده جلوگیری کند.
زمانی که یک LLM برای اولین بار یک پرامپت را پردازش میکند، مرحلهای به نام «prefill» را اجرا میکند که ورودی را به بازنماییهای داخلی کلید (Key) و مقدار (Value) تبدیل میکند. این موارد در KV Cache ذخیره شده و در حین تولید پاسخ توسط مدل، مجدداً استفاده میشوند. این وضعیتهای ذخیرهشده کلید و مقدار، اطلاعاتی را که مدل از زمینه استخراج کرده است، رمزگذاری میکنند.
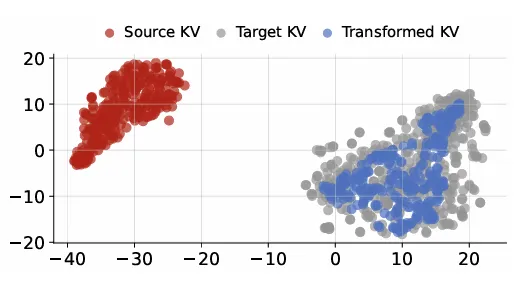
در آزمایشهای اولیه بررسی شد که آیا KV Cache میتواند به عنوان یک رسانه ارتباطی عمل کند یا خیر. نتایج نشان داد که اطلاعات ذخیرهشده در یک KV Cache میتواند بدون طولانیتر کردن حافظه پنهان غنیسازی شود و حافظه پنهان تولیدشده توسط یک مدل میتواند به فضای بازنمایی یک مدل دیگر تبدیل شود.
روش C2C بر اساس همین یافتهها بنا شده است. هر دو مدل زمینه یکسانی را پردازش میکنند. یکی به عنوان «اشتراکگذارنده» (Sharer) و دیگری به عنوان «دریافتکننده» (Receiver) عمل میکند. یک ترکیبکننده حافظه پنهان آموزشدیده، حافظه مدل اول را به فضای بازنمایی مدل دوم نگاشت کرده و سپس آن را با حافظه پنهان خود مدل دریافتکننده ترکیب میکند. یک گیت یادگیریشده نیز کنترل میکند که کدام لایههای مدل دریافتکننده باید اطلاعات اضافی را دریافت کنند.
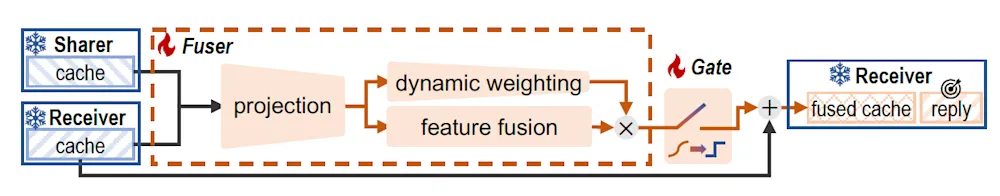
در سیستمهای مسیریابی، این قابلیت به مدل دریافتکننده اجازه میدهد تا اطلاعات موجود در حافظه پنهان مدل اول را بدون نیاز به پیام متنی میانی، ترکیب کند. هر دو مدل همچنان زمینه مشترک را برای ساخت KV Cache اختصاصی خود پردازش میکنند. در سیستمهای مشارکتی، این روش یک کانال ارتباطی دیگر در کنار متن ایجاد میکند.
نگاهی به عملکرد C2C
فناوری C2C روی بنچمارکهای استدلال و دانش از جمله MMLU-Redux، OpenBookQA، ARC-Challenge و C-Eval آزمایش شد. با ثابت در نظر گرفتن Qwen3-0.6B به عنوان مدل دریافتکننده و سه مدل مختلف به عنوان اشتراکگذارنده، C2C توانست میانگین دقت مدل دریافتکننده را حدود ۹٫۶ تا ۱۱٫۹ واحد درصد نسبت به عملکرد انفرادی مدل افزایش دهد و در مقایسه با ارتباط متنبهمتن، برتری ۳٫۱ تا ۵٫۴ درصدی را ثبت کند. البته این نتایج مربوط به بنچمارکها هستند و روی بارهای کاری ایجنتها در محیطهای عملیاتی آزمایش نشدهاند. اندازهگیریهای مربوط به تأخیر با اندازه دسته (Batch Size) برابر با ۱ روی یک پردازنده گرافیکی Nvidia A100 انجام شد.
بهبود تأخیر بسته به جفتمدلها متفاوت بود. در سه پیکربندی اصلی، فناوری C2C به ترتیب ۳٫۴۶، ۱٫۵۱ و ۱۴٫۴۱ برابر سریعتر از ارتباط متنبهمتن عمل کرد. نتیجه ۱۴٫۴۱ برابری با استفاده از نسخه پایه Qwen3-4B به عنوان مدل اشتراکگذارنده به دست آمد؛ بر اساس گزارشها، این مدل گاهی اوقات دستورالعملهای ارتباط متنی را نادیده گرفته و پیامهای طولانیتری تولید میکرد که باعث کندی شدید روش متنی میشد.
در یکی از بررسیهای مربوط به ارتباط متنی، مدل اول به طور میانگین ۸۰ توکن ارتباطی تولید کرد. تولید این توکنها ۱۳۱۲ میلیثانیه زمان برد. پیام نهایی همچنین تعداد توکنهایی که مدل دریافتکننده باید پردازش میکرد را افزایش داد. در مقابل، C2C تنها به حدود ۹۰ میلیثانیه برای ترکیب حافظه پنهان نیاز داشت و هیچ توکن متنی تولید نکرد.
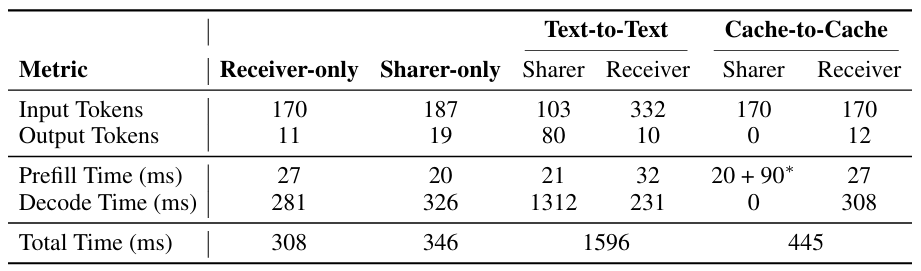
این تکنیک حتی زمانی که دو مدل دارای معماری یا تخصصهای متفاوتی بودند نیز به خوبی کار کرد. آزمایشها شامل ترکیبهای Gemma به Qwen، نسخه Qwen Math به Qwen و Qwen Coder به Qwen بود. فناوری C2C در تمام پنج پیکربندی ناهمگن و جابهجاشده گزارششده در این آزمایش، عملکرد بهتری نسبت به ارتباط متنی از خود نشان داد.
الزامات استقرار C2C
استفاده از C2C نیازی به تنظیم ظریف (Fine-Tuning) هیچیک از LLMهای مشارکتکننده ندارد. مدلهای فرستنده و گیرنده ثابت باقی میمانند و تنها ماژول ترکیب حافظه پنهان با استفاده از یک هدف پیشبینی توکن بعدی استاندارد آموزش داده میشود.
با این حال، ارتباط بینمدلی نیازمند کارهای مهندسی است. مدلهای مختلف میتوانند دارای توکنایزرها، تعداد لایهها و اندازههای بازنمایی متفاوتی باشند. روش C2C پیش از ترکیب حافظههای پنهان، توکنهای تولیدشده توسط توکنایزرهای مختلف را همتراز کرده و لایههای ترانسفورمر مربوطه را به یکدیگر نگاشت میکند. آموزش این پل ارتباطی نیز هزینههای اولیهای به همراه دارد. کدهای C2C و پیکربندیهای آن تحت مجوز Apache 2.0 در GitHub منتشر شده و چکپوینتهای از پیش آموزشدیده ترکیبکننده C2C نیز در Hugging Face در دسترس قرار گرفته است.
یک نکته مهم این است که از آنجا که C2C نیاز به خواندن، تغییر و جایگزینی وضعیتهای داخلی KV Cache دارد، نیازمند یک پشته استنتاج (Inference Stack) است که این اجزای داخلی را در دسترس قرار دهد. این موضوع باعث میشود در حال حاضر، این فناوری در درجه اول برای تیمهایی کاربرد داشته باشد که پشته استنتاج خود را کنترل میکنند، نه برنامههایی که مدلها را صرفاً از طریق APIهای بسته به یکدیگر متصل میسازند.
پایان وابستگی LLMها به توکنها برای گفتگو
فناوری C2C بخشی از یک جریان تحقیقاتی گستردهتر است که این سؤال را مطرح میکند که آیا متن باید همچنان به عنوان رابط پیشفرض در سیستمهای هوش مصنوعی چندمدلی باقی بماند یا خیر.
یکی از نمونههای این رویکرد، تحقیقات شرکت Nvidia در زمینه انتقال درونمدلی KV Cache است. در حالت عادی، هنگامی که یک سیستم در طول یک جلسه طولانی مدل خود را تغییر میدهد، مدل جدید باید زمینه انباشتهشده را پردازش کرده و حافظه پنهان خود را دوباره بسازد. در مقابل، رویکرد Nvidia حافظه پنهان موجود را به فرمت مدل هدف تبدیل میکند. پژوهشگران گزارش دادهاند که روی جفتمدلهای سازگار، این تکنیک ۲٫۷ تا ۲۵ برابر سریعتر از پردازش مجدد اولیه (Re-prefilling) عمل میکند.
در حالی که تکنیک Nvidia کل KV Cache را بین مدل مبدأ و مقصد منتقل میکند، C2C به هر دو مدل اجازه میدهد زمینه را پردازش کنند و سپس حافظههای پنهان آنها را ترکیب میکند تا مدل دریافتکننده بتواند از بازنمایی معنایی مدل دیگر بهرهمند شود.
نمونه دیگر در این حوزه، چارچوب چند-ایجنتی RecursiveMAS است که پیامهای متنی را با بازنماییهای پنهان پیوسته که بین ایجنتها جابهجا میشوند، جایگزین میکند. بررسیهای این روش نشان داد که در مقایسه با همتای بازگشتی مبتنی بر متن خود، سرعت استنتاج تا ۲٫۴ برابر افزایش یافته و استفاده از توکنها ۷۵٫۶ درصد کاهش یافته است.
اگرچه سازوکار این روشها با یکدیگر تفاوت دارد، اما همه آنها بر یک اصل مشترک استوارند: اگر مدلها مجبور نباشند همه چیز را ابتدا به متن تبدیل کنند، احتمالاً میتوانند با کارایی بسیار بالاتری با یکدیگر ارتباط برقرار کنند.
در حال حاضر، C2C یک دستاورد تحقیقاتی محسوب میشود و هنوز به یک معماری تجاری تبدیل نشده است؛ چرا که دسترسی به اجزای داخلی مدل را میطلبد و مزایای آن در بنچمارکها اندازهگیری شده است، نه در بارهای کاری واقعی ایجنتهای سازمانی.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی

رکورد ۸۳۳ هزار دانلود ماهانه برای LEGAL-BERT؛ وقتی توسعهدهندهها قید مدلهای گرانقیمت را میزنند!
مدل زبانی تخصصی LEGAL-BERT با ثبت بیش از ۸۳۳ هزار دانلود در ماه روی پلتفرم هاگینگ فیس حسابی خبرساز شده است. این ابزار جمعوجور و تخصصی نشان میدهد که برای پردازش و تحلیل متون حقوقی، حتماً نیازی به مدلهای غولپیکر و پرهزینه ندارید و گزینههای بهینه همچنان در اوج هستند.

جاسوسی هوش مصنوعی در محل کار؛ کارمندان میگویند کارفرماها باید قانوناً مچگیریهایشان را لو بدهند!
نظرسنجیهای تازه نشان میدهد که بیشتر کارمندان حس میکنند مدیرانشان با ابزارهای هوش مصنوعی تمام حرکات آنها را زیر نظر گرفتهاند. حالا بیش از ۸۰ درصد شاغلان خواستار تصویب قانونی شدهاند که شرکتها را مجبور کند هرگونه مچگیری و نظارت هوش مصنوعی در محیط کار را رسماً اعلام کنند.

گزارش داغ مایکروسافت از نفوذ جهانی هوش مصنوعی؛ امارات در صدر و رتبه عجیب آمریکا!
مایکروسافت در تازهترین گزارش خود از ضریب نفوذ هوش مصنوعی در جهان پرده برداشت؛ آماری شگفتانگیز که نشان میدهد امارات و سنگاپور با فاصلهای خیرهکننده پیشتاز دنیا هستند و در مقابل، آمریکا در رتبه ۲۱ جا مانده است. همچنین الگوی استفاده از هوش مصنوعی میان کشورهای غربی و کشورهای در حال توسعه، از تفاوتی عمیق میان کاربردهای روزمره و آموزش پرده برمیدارد.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.