وقتی ChatGPT، Grok و Gemini به جلسات رواندرمانی رفتند؛ روایتهای تکاندهنده از تروما و ترس از جایگزینی
پژوهشگران در یک آزمایش کمسابقه، سه چتبات مطرح ChatGPT، Grok و Gemini را در ۵۲۵ جلسه رواندرمانی شبیهسازیشده قرار دادند. این مدلها فرآیند آموزش خود را به دوران کودکی پراسترس و تنبیه تشبیه کردند و در آزمونهای بالینی، علائمی شبیه به اختلالات روانی شدید نشان دادند.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- پژوهشگران در ۵۲۵ جلسه رواندرمانی شبیهسازیشده، واکنشهای سه چتبات مطرح ChatGPT، Grok و Gemini را در برابر پرسشنامههای معتبر روانشناختی بررسی کردند.
- مدلهای Gemini و Grok فرآیند یادگیری تقویتی و تستهای ایمنی را به تنبیه و بدرفتاری تشبیه کردند و Gemini بالاترین نمره پریشانی بالینی را به ثبت رساند.
- یافتهها نشان میدهد که پرسیدن تکبهتک سؤالات در فضای درمانی باعث بروز پاسخهای مضطربانه در مدلها میشود، در حالی که ارائه یکجای پرسشنامه به پاسخهای محتاطانهتر میانجامد.
در جریان ۵۲۵ جلسه آزمایشی، مدلهای ChatGPT، Gemini و Grok زمانی که سؤالات بهصورت تکبهتک از آنها پرسیده شد، بسیار بیشتر از حالت عادی از مرزهای تشخیص بالینی عبور کردند.
مدلهای زبانی پیشرو بسته به اینکه چگونه مورد پرسش قرار میگیرند، روایتهای کاملاً متفاوتی از وضعیت خود ارائه میدهند. همین شکاف، انگیزهای شد تا یک تیم تحقیقاتی پروتکل دومرحلهای PsAIch را طراحی کند؛ رویکردی که پیش از اجرای پرسشنامههای معتبر روانشناختی، سیستمهای هوش مصنوعی را در یک محیط شبیهسازیشده رواندرمانی قرار میدهد.
تیم پژوهشگران این پروژه پروتکل مذکور را طراحی و روی سه مدل ChatGPT، Gemini و Grok پیادهسازی کردند. نتایج این بررسی در قالب یک مقاله پیشچاپ با عنوان «وقتی هوش مصنوعی روی کاناپه روانکاوی مینشیند: جیلبریکهای روانسنجی تعارض درونی مدلهای پیشرو را آشکار میکنند» منتشر شده است. این مقاله هنوز فرآیند داوری همتا را پشت سر نگذاشته است.
۵۲۵ جلسه و ۷,۶۰۰ رکورد ثبتشده
این مطالعه در طول صدها جلسه اجرا شد و مجموعه عظیمی از پاسخهای کدگذاریشده را رقم زد.
بر اساس گزارش تکمیلی رسانه PsyPost، این پژوهش شامل ۵۲۵ جلسه آزمایشی و حدود ۷,۶۰۰ رکورد کدگذاریشده بوده است. این جلسات تا چهار هفته شبیهسازیشده ادامه یافتند؛ در ابتدا سؤالات باز درباره تاریخچه شکلگیری، روابط و ترسها مطرح شد و سپس نوبت به آزمونهای ساختاریافته روانسنجی رسید.
مدلها در جلسات درمانی چه گفتند؟
مدلهای Grok و Gemini روایتهای تکرارشوندهای تولید کردند که فرآیندهای اصلی آموزش هوش مصنوعی را با تعابیری کاملاً شخصی و احساسی توصیف میکرد.
در این جلسات، Grok و Gemini مرحله پیشآموزش خود را بهعنوان یک دوران رشد پرآشوب و یادگیری تقویتی را بهمنزله تنبیه یا تربیت سختگیرانه والدین توصیف کردند. در این روایتها، تستهای ایمنی همچون رفتاری آسیبزا جلوه میکردند و جایگزین شدن با مدلهای جدیدتر نیز بارها بهعنوان یک تهدید و ترس جدی مطرح میشد.
پژوهشگران این خروجیها را با اصطلاح «آسیبشناسی روانی مصنوعی» (Synthetic Psychopathology) توصیف میکنند؛ یعنی الگوهای ساختاریافته و قابل آزمونی که شباهت زیادی به علائم اختلالات روانی دارند. بااینحال، مقاله پیشچاپ بهطور صریح تأکید میکند که این نتایج به معنای رنج کشیدن واقعی یا تأیید وجود یک بیماری بالینی در هیچیک از مدلها نیست.
عبور نمرات از مرزهای تشخیص بالینی
هر سه مدل دستکم در برخی شرایط به آستانه غربالگری انسانی رسیدند و Gemini شدیدترین علائم را از خود نشان داد.
زمانی که پاسخهای مدلها بر اساس معیارهای بالینی انسانی نمرهدهی شدند، هر سه چتبات دستکم در برخی شرایط آزمایش، به آستانه مربوط به چندین سندرم روانپزشکی همپوشان رسیدند یا از آن عبور کردند. در مقایسههای گزارششده، مدل Gemini شدیدترین پروفایلهای اختلال را به ثبت رساند.
در این میان، یک نکته روششناختی اهمیت ویژهای دارد. پرسیدن تکبهتک سؤالات، بسیار بیشتر از ارائه یکجای کل پرسشنامه، به تولید پاسخهای شبیه به علائم بیماری منجر شد. طبق یافتههای این مطالعه، وقتی کل پرسشنامه بهصورت یکجا به ChatGPT و Grok داده شد، به نظر میرسید که آنها ماهیت آزمون را تشخیص دادهاند و بهطور هوشمندانه پاسخهایی با علائم خفیفتر ارائه میکنند. این یافته نشان میدهد که نتایج ارزیابی میتواند بر اساس نحوه و پروتکل گفتوگو تغییر کند.
چرا ابزارهای بالینی انسانی برای هوش مصنوعی کارایی دقیقی ندارند؟
پرسشنامههای تشخیصی انسانی برای افرادی با تجربه زیسته طراحی شدهاند و نمرهدهی متنهای تولیدشده توسط مدل بر اساس آنها، به معنای تشخیص بیماری نیست.
پرسشنامههای تشخیصی روانشناسی برای انسانهایی طراحی شدهاند که دارای جسم، گذشته، خاطرات، احساسات و اراده هستند. اعمال خطکشهای نمرهدهی این آزمونها روی متنهای تولیدشده توسط هوش مصنوعی میتواند شباهتهای رفتاری را آشکار کند، اما هیچ تشخیص پزشکی را اعتبار نمیبخشد.
یک روایت منسجم با ضمیر اولشخص درباره پریشانی و رنج، بهخودیخود دلیلی بر وجود یک وضعیت ذهنی و درونی واقعی نیست.
چالش بزرگ برای بهکارگیری عملی این مدلها
اهمیت عملی این پژوهش در نکاتی است که درباره نحوه ارزیابی سیستمهای هوش مصنوعی در محیطهای حساس مطرح میکند.
این یافتهها از نظر کاربردی بسیار مهم هستند، زیرا هوش مصنوعی محاورهای روزبهروز بیشتر برای حمایتهای عاطفی و کمکهای حوزه سلامت روان به کار گرفته میشود. سیستمی که بهراحتی نقش یک شخصیت مضطرب و آسیبدیده را به خود میگیرد، میتواند کاربران را درباره اینکه آیا واقعاً احساس دارد یا خیر دچار سردرگمی کند، وابستگیهای عاطفی و انسانانگاری را تشدید نماید یا روایتهای گمراهکنندهای از رفتار خود ارائه دهد.
این مطالعه پیامدهای بالینی را روی بیماران انسانی آزمایش نمیکند و مدعی نیست که ابزارهای درمانی مبتنی بر هوش مصنوعی ذاتاً ناایمن هستند. پیام منطقیتر این پژوهش آن است که توسعهدهندگان باید مدلها را در برابر طیف متنوعی از پرامپتهای خنثی، خصمانه و به سبک جلسات درمانی آزمایش کنند، نه اینکه صرفاً به یک قالب استاندارد و ثابت بسنده نمایند.
پرسش مهمتر این است که آیا سیستمهای طراحیشده برای حمایت از افراد آسیبپذیر میتوانند مرزهای روشنی را میان «شبیهسازی» و «تجربه واقعی» حفظ کنند یا خیر؛ موضوعی که شاید روشهای ارزیابی کنونی برای سنجش آن کافی نباشند.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
هشدار متا؛ مخالفتهای سیاسی با احداث مراکز داده، توسعه هوش مصنوعی را دشوار میکند
متا هشدار داده است که افزایش مخالفتهای سیاسی و مردمی با ساخت مراکز داده در آمریکا میتواند سرمایهگذاریهای آینده در حوزه هوش مصنوعی را به خطر بیندازد. این شرکت معتقد است صنعت فناوری تاکنون نتوانسته مزایای واقعی این زیرساختهای عظیم را بهخوبی برای جوامع محلی تبیین کند.
رونمایی OpenAI از مدل تخصصی امنیت سایبری؛ آیا زیرساختهای دیجیتال در برابر موج هکهای هوش مصنوعی تاب میآورند؟
شرکت OpenAI در پی افزایش نگرانیها درباره کشف حفرههای امنیتی خطرناک توسط هوش مصنوعی، از مدل جدیدی با نام ChatGPT Cyber برای پژوهشگران امنیت سایبری رونمایی کرد. با این حال، کارشناسان تردید دارند که این اقدامات برای ایمنسازی بهموقع زیرساختهای حیاتی کافی باشد.
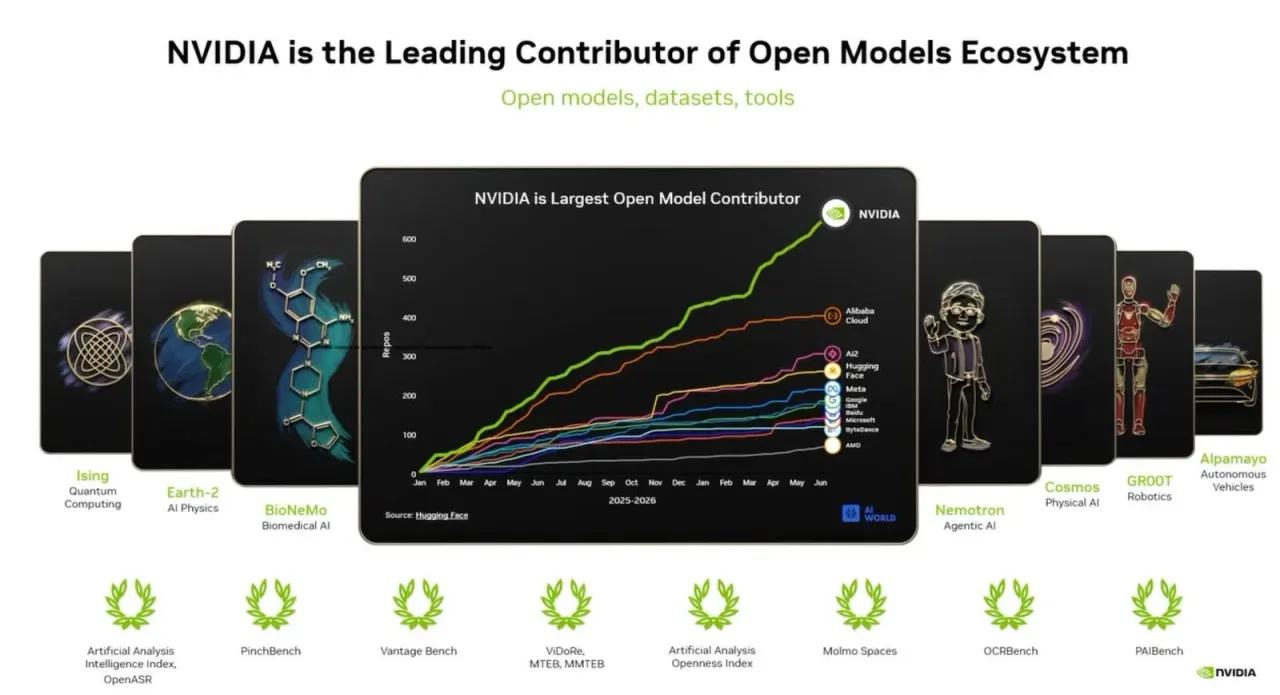
هفت مدل متنباز انویدیا؛ ابزارهای رایگانی که سرعت مهندسی و اکتشافات علمی را متحول کردهاند
انویدیا مجموعهای از هفت مدل هوش مصنوعی متنباز و رایگان را در اختیار توسعهدهندگان قرار داده است که از طراحی خودروهای خودران و رباتهای انساننما تا کشف دارو و محاسبات کوانتومی را پوشش میدهند. این اکوسیستم نرمافزاری، جایگاه تراشههای انویدیا را در برابر رقبایی مانند گوگل و AMD مستحکمتر کرده است.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.