هوش مصنوعی Claude آنتروپیک مصونیت ۲۳۹ کتابخانه متنباز در برابر کرش را با ریاضیات اثبات کرد
تیم ارزیابی امنیتی آنتروپیک با همکاری استارتاپ Theorem موفق شد با استفاده از مدل Claude، مصونیت ۲۳۹ نقطه ورود در ۱۲۳ کتابخانه متنباز را از طریق اثبات صوری ریاضیاتی تضمین کند. این روش نوآورانه نه تنها باگهای امنیتی عمیقی را کشف کرده که تریلیونها تست فازینگ موفق به یافتن آنها نشده بودند، بلکه هزینه و زمان وارسی صوری نرمافزارها را به شکلی چشمگیر کاهش داده است.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- مدل Claude با تولید ۱۸۰ میلیون خط کد اثبات صوری، مصونیت ۲۳۹ بخش کلیدی در ۱۲۳ کتابخانه متنباز را در سطح کدهای اسمبلی با ریاضیات به اثبات رساند.
- این سیستم موفق شد آسیبپذیریهای امنیتی خطرناکی را کشف کند که حتی پس از تریلیونها بار اجرای تستهای خودکار فازینگ همچنان پنهان مانده بودند.
- با بهرهگیری از مدلهای جدیدتر مانند Opus 5.5 و استفاده از فضاهای کاری اشتراکی، مصرف توکن و هزینههای محاسباتی این فرآیند تا ۴۰ درصد کاهش یافته است.
«تیم قرمز فرانتیر» آنتروپیک با همکاری استارتاپ Theorem با استفاده از هوش مصنوعی Claude موفق شد برای کدهای کامپایلشدهی ۱۲۳ کتابخانه متنباز، اثباتهای صوری با قابلیت بررسی ماشینی تولید کند. پژوهشگران در گزارش رسمی خود اعلام کردند این سیستم توانسته است نقصها و حفرههای امنیتی پنهانی را شناسایی و برطرف کند که حتی پس از تریلیونها بار اجرای تستهای فازینگ (Fuzzing) در این کتابخانهها هرگز آشکار نشده بودند. این دستاورد نشان میدهد تولید خودکار اثباتهای ریاضیاتی میتواند روش «وارسی صوری» (Formal Verification) را برای مؤلفههای نرمافزاری پرکاربرد در دنیای واقعی کاملاً کاربردی و مقرونبهصرفه کند.
معیار تاریخی: پروژهای با هزینه ۲۰ نفر-سال کار تخصصی
روش وارسی صوری از اثباتهای ریاضیاتی برای تضمین این موضوع استفاده میکند که یک نرمافزار تحت فرضیات مشخص، رفتاری کاملاً دقیق و بینقص دارد. آزمونهای متداول و ابزارهای فازینگ تنها خطاهایی را نشان میدهند که در میان ورودیهای تستشده رخ داده باشند؛ در حالی که یک اثبات صوری ریاضیاتی، تمام ورودیهای ممکن را در چارچوب قضیه و مدل اجرایی تعریفشده پوشش میدهد.
میکروکرنل مشهور seL4 نمونهای بارز از هزینههای سنگین تاریخی در این حوزه است. توسعه اولیه این میکروکرنل حدود ۲ نفر-سال زمان برد، در حالی که اثبات صوری آن به حدود ۲۰ نفر-سال کار تخصصی نیاز داشت. این افزایش دهبرابری در هزینهها و زمان باعث شد وارسی صوری کامل سیستمها تاکنون به صنایع حساسی مانند هوانوردی، هسته سیستمعاملها، کدهای رمزنگاری و پروژههای عظیمی محدود شود که توانایی استخدام تیمهای متخصصی از ریاضیدانان و مهندسان را دارند.
فرآیند مشترک آنتروپیک و Theorem طی چند هفته به نتایج چشمگیر زیر دست یافت:
معیار | نتیجه گزارششده |
|---|---|
کتابخانههای متنباز | ۱۲۳ پروژه از مخزن OSS-Fuzz |
نقاط ورود بررسیشده | ۲۳۹ نقطه ورود |
محدوده مجاز ورودی | تا سقف ۶۴ مگابایت برای هر ورودی |
هدف ارزیابی | کدهای باینری آمادهشده برای معماری RISC-V |
اسکریپتهای اثبات تولیدشده | حدود ۱۸۰ میلیون خط کد به زبان Rocq |
حجم معمول هر اثبات | حدود ۶۰۰ هزار خط کد |
میانه اندازه کدهای هدف | حدود ۱۸ هزار دستورالعمل RISC-V |
بنابراین، برای هر دستورالعمل در کد هدف، حدود ۳۳ خط اسکریپت اثبات صوری تولید شده است. البته این آمار حجم کدهای تولیدشده توسط هوش مصنوعی را برای پردازشگر نشان میدهد، نه کدهایی که توسط انسان نوشته شده باشند. این فرآیند تمام اثباتها را بدون نیاز به مهندسی دستی و مستقیم انسان خلق کرد؛ در حالی که متخصصان انسانی صرفاً مدلها، ابزارها، بسترهای آزمون و طراحی کلی فرآیند ارزیابی را آماده کرده بودند.
تبدیل بسترهای آزمون فازینگ بهصورت قضایای ریاضی
یک بستر آزمون (Harness) در پروژههای OSS-Fuzz، یک نقطه ورود قابل فراخوانی در اختیار فازر قرار میدهد، بایتهای دلخواه را به ورودیهای برنامه تبدیل میکند و شرایط منجر به خطا را مشخص میسازد. پژوهشگران بهجای ورود به مسیر پیچیده، مبهم و دشوارِ اثبات درستیِ مطلق یک کتابخانه، هوشمندانه از همین بسترهای آزمون موجود بهعنوان مشخصات فنی دقیق استفاده کردند.
- این چرخه پردازش، هر کتابخانه و بستر آزمون آن را به یک فایل باینری استاتیک تحت معماری RISC-V و متصل به کتابخانه musl libc کامپایل کرد.
- ابزار AddressSanitizer خطاهای مربوط به مدیریت حافظه را به کرشهای قابلمشاهده و آشکار تبدیل نمود.
- قضیه ریاضی تعریفشده بیان میکرد که در محیط شبیهسازیشده، هیچ ورودی خاصی تا سقف ۶۴ مگابایت نباید بتواند باعث کرش یا خطای مرگبار در نقطه ورود شود.
- مدل Claude اسکریپتهای اثبات به زبان Rocq را تولید کرد، دلایل بنبست در اثباتها را واکاوی نمود، باگهای کشفشده را رفع کرد و فرآیند را دوباره به جریان انداخت.
- در نهایت، هسته اختصاصی Rocq تمام مراحل اثبات را بهصورت خودکار و دقیق بررسی کرد.
زبان و ابزار Rocq (که پیشتر با نام Coq شناخته میشد)، یک سیستم اثبات تعاملی قضایای ریاضی با یک هسته اعتبارسنجی کوچک و فوقالعاده سختگیر است. اسکریپتهای تولیدشده توسط Claude حتی اگر بسیار طولانی باشند یا خواندن آنها برای انسان دشوار به نظر برسد، هیچ ضعفی در اعتبار نتیجه نهایی ایجاد نمیکنند؛ چراکه هسته Rocq یک قضیه را تنها زمانی میپذیرد که تکتک استدلالها کاملاً منطبق بر قوانین منطقی و صوری ریاضی باشند.
پژوهشگران برای اعتبارسنجی قضایا، سه رکن اساسی را در «پایگاه محاسباتی مورد اعتماد» (TCB) مشخص کردند:
- مدلهای صوری مربوط به دستورالعملهای معماری RISC-V و فرآیندهای سیستمعامل لینوکس
- صورت دقیق قضایای ریاضی تعریفشده
- ابزار اعتبارسنجی اثباتهای Rocq
به این ترتیب، نظارت انسانی میتواند صرفاً بر این نکته متمرکز شود که آیا مدلها و صورت قضیه تضمینهای مدنظر را به درستی منعکس میکنند یا خیر؛ در حالی که ارزیابی صحت تمام ۱۸۰ میلیون خط اسکریپت تولیدشده کاملاً به سیستم خودکار سپرده میشود.
ورودیهای نادر؛ افشای نقاط کور در تستهای فازینگ
تلاش برای اثبات ریاضیاتی، مدل Claude را ناگزیر کرد تمام مسیرهای اجرایی را بررسی کند؛ حتی مسیرهایی که تولید تصادفی دادهها یا آزمونهای مبتنی بر پوشش کد هرگز به آنها دسترسی پیدا نکرده بودند. در یکی از کتابخانهها، این سیستم یک خطای سرریز منفی شمارنده (Counter Underflow) در بخش فشردهساز پیدا کرد که میتوانست به نوشتن داده در خارج از محدوده مجاز حافظه منجر شود. فعال شدن این آسیبپذیری به ورودی خاصی به حجم حدود ۲۰ مگابایت با ساختاری بسیار نادر نیاز داشت؛ در حالی که طبق گزارش، بیشتر تستهای فازینگ معمولاً حجم ورودیها را به حدود ۱ مگابایت محدود میکنند.
پژوهشگران به یافتههای مهم دیگری نیز اشاره کردند:
- خطای خواندن خارج از محدوده در یک رمزگشای تصویر که فعالسازی آن نیازمند ورودی ۶۴ مگابایتی و بیش از ۲ گیگابایت حافظه بود
- کشف دوباره آسیبپذیری امنیتی CVE-2026-56132 در کتابخانه پرکاربرد libexpat
- عدم اعمال محدودیتهای دسترسی به فایل در برخی از مسیرهای خاص اجرای برنامه
- شناسایی تعداد باگهای امنیتی در یک نرمافزار پرطرفدار نمایش PDF ظرف یک هفته، معادل کل باگهایی که این پروژه معمولاً در طول یک سال کامل ثبت میکند
نیاز به ورودیهای حجیم، مصرف بالای حافظه و محدودیتهای ساختاری پیچیده، کشف چنین باگهایی را برای ابزارهای فازینگ بسیار پرهزینه و عملاً ناممکن میسازد؛ اما اثبات نمادین ریاضی موظف است تا زمانی که این احتمالات در چارچوب قضیه وجود دارند، تکتک آنها را پوشش دهد.
اثبات مصونیت از کرش؛ فراتر از پایداری ظاهری و ورود به منطق برنامه
بسترهای آزمون فازینگ میتوانند ویژگیهای منطقی برنامه را کدگذاری کنند؛ به این شکل که در صورت نقض یک شرط بنیادین و پایدار، برنامه عمداً متوقف شود و کرش کند. بنابراین، وقتی اثبات میشود که یک برنامه به هیچ وجه کرش نمیکند، پایداری آن شرط و رفتار صحیح منطقی برنامه برای تمام ورودیهای مجاز به اثبات میرسد.
برای نمونه، بستر آزمون در الگوریتم فشردهسازی LZO طوری طراحی شده است که اگر دادهها پس از فشردهسازی و سپس بازگشایی با فایل اولیه یکسان نباشند، بلافاصله برنامه را متوقف کند. اثبات عدم وقوع کرش در این بستر به معنای تضمین ریاضیاتی این واقعیت است که فرآیند رفتوبرگشت فشردهسازی دادهها برای تمامی ورودیهای تعریفشده بدون کوچکترین نقصی عمل میکند.
اثبات پایداری در کتابخانه cpp-httplib نیازمند بررسی شرایط عمیقتری در سطح کدهای ماشین بود. مدل Claude برای جلوگیری از خطای سرریز پشته (Stack Overflow) در فرآیند بازگشتی مخرب برای std::set، مجبور شد با محاسبات ریاضی نشان دهد ساختار درخت قرمز-سیاه (Red-Black Tree) در کتابخانه libc++ همواره تعادل لگاریتمی خود را حفظ میکند. به این ترتیب، اثبات نهایی حتی پایداری ساختار دادههای داخلی برنامه را برای تضمین محدود ماندن عمق بازگشت پوشش داد.
کاهش چشمگیر هزینههای پردازش و مصرف توکن
اثباتهای بزرگ نرمافزاری همچنان صدها میلیون توکن مصرف میکنند؛ موضوعی که هزینه پردازش در لحظه استنتاج و کارایی مدلها را به چالشهای اصلی تبدیل کرده است. آنتروپیک عملکرد چندین مدل مختلف را در ۳۶ وظیفه اعتبارسنجی کوچکتر مقایسه کرد و میزان موفقیت آنها را متناسب با سهمیه توکن تخصیصدادهشده سنجید.
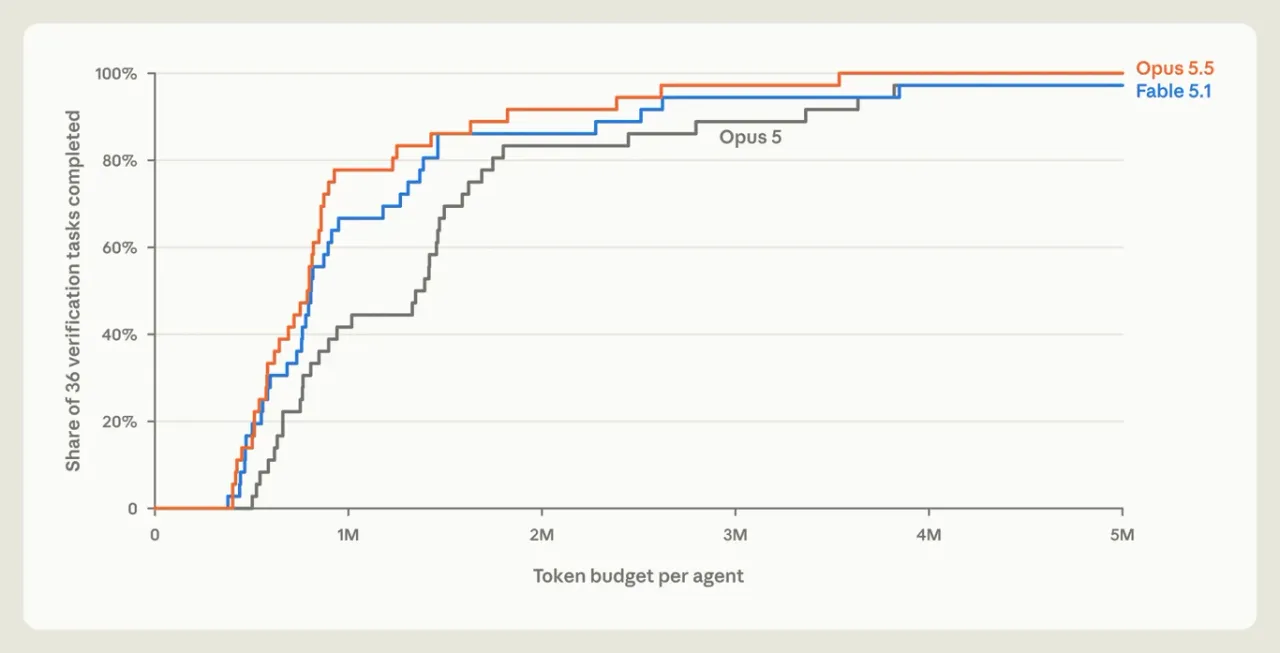
مدل Opus 5.5 نیمی از وظایف این بنچمارک را با حدود ۴۰ درصد توکن کمتر در مقایسه با Opus 5 حل کرد. علاوه بر این، استفاده از فضاهای کاری اشتراکی میان ایجنتها باعث کاهش ۱۷ درصدی مصرف توکن در مقایسه با ایجنتهای مجزا شد. در این روش، ایجنتها بخشهای اثباتشده قبلی را برای مراحل تکراری (مانند راهاندازی اولیه زمان اجرای زبان C و پیکربندی AddressSanitizer) مجدداً استفاده کردند و حتی توانستند وظایفی را به پایان برسانند که پیشتر بهتنهایی در حل آنها شکست خورده بودند.
مرزها و محدودیتهای تضمین ارائهشده
نتایج به دست آمده توسط آنتروپیک، محدوده تضمین مشخصتری را نسبت به ادعای کلی «عاری بودن کامل از باگ» تعریف میکند. قلمرو این تضمین مستقیماً وابسته بهصورت قضیه، تنظیمات بیلد، ابزارهای نظارتی و مدل ماشین شبیهسازیشده است.
بعد ارزیابی | محدوده اثباتشده | شکافهای باقیمانده |
|---|---|---|
مدل اجرایی | کدهای باینری استاتیک و تکتردی معماری RISC-V متصل به musl | نسخههای عملیاتی ممکن است از چندتردی، پیوند پویا، کتابخانه glibc یا معماریهای x86-64 و Arm استفاده کنند |
ویژگی تاییدشده | عدم بروز کرش در بستر آزمون برای ورودیهای تا سقف ۶۴ مگابایت | رفتارهایی که در بستر آزمون تعریف نشده باشند، خارج از پوشش قضیه باقی میمانند |
امنیت حافظه | خطاهایی که توسط ابزار AddressSanitizer به کرش تبدیل میشوند | ایرادات حافظه که خارج از محدوده پوشش AddressSanitizer باشند ممکن است باقی بمانند |
استفاده از API | رفتار درونی هر نقطه ورود بررسیشده | سوءاستفاده از توابع توسط فراخواننده و ترتیب فراخوانیهای پشتیبانینشده اثباتنشده باقی میماند |
خروجی کامپایل | فایل باینری کامپایلشده و مجهز به ابزارهای نظارتی | هرگونه تغییر در سورسکد، فلگهای کامپایلر، پیشنیازها یا اهداف اجرایی به اثبات مجدد نیاز دارد |
همچنین ادعاهای امنیتی در سطح کد منبع وابسته به آن است که کامپایلر و ابزار AddressSanitizer بتوانند نقصهای مربوطه را به رفتارهای تعریفشده در قضیه نگاشت کنند. یک اثبات صوری معتبر میتواند یک صورتمسئله ناقص را به شکلی بینقص اثبات کند؛ بنابراین، بررسی دقیق قضیه و مشخصات اولیه همچنان مسئولیتی مهم بر دوش متخصصان انسانی خواهد بود.
تیم تحقیقاتی آرشیو کامل اثباتها، معناشناسی ماشینی و یک اسکیل اختصاصی Claude را برای افزودن پروژههای جدید به این چرخه منتشر کرده است. علاوه بر این، استارتاپ Theorem اعلام کرده آماده است این سیستم را برای پروژههای متنباز بر اساس درخواست اجرا کند.
بخش عمدهای از نرمافزارهای تجاری و عملیاتی به وابستگیهای مشترکی مانند glibc، OpenSSL، cURL و zlib متکی هستند. بنابراین، تولید یک اثبات صوری برای نسخه و پیکربندی دقیقی که توسط هزاران پروژه مورد استفاده قرار میگیرد، میتواند هزینههای سنگین اثبات را بین جامعه عظیمی از کاربران و توسعهدهندگان سرشکن کند.
کاربردی شدن گسترده این شیوه در دنیای واقعی نیازمند پشتیبانی از معماریهای رایج سختافزاری و پیادهسازیهای مختلف libc، بیلدهای تکرارپذیر، بازبینی دقیق قضایا و ارزیابی پیوسته با تغییر وابستگیها است. با این حال، دستاورد اخیر گواهی روشن بر این واقعیت است که مدلهای زبانی میتوانند بخش اعظم فرآیند نگارش اثباتهای ریاضیاتی را خودکارسازی کنند؛ بخشی که از نظر تاریخی، پرزحمتترین و زمانبرترین مانع در مسیر پیادهسازی روشهای صوری در کدهای دنیای واقعی بوده است.
مطالب مرتبط و پیشنهادی
سناریوهای آخرالزمانی هوش مصنوعی قبلاً بدون هوش مصنوعی تا پای فاجعه رفتهاند؛ خطر واقعی کجاست؟
بررسی تاریخ نشان میدهد سناریوهای آخرالزمانی هوش مصنوعی نظیر ساخت سلاحهای بیولوژیکی یا پرتاب اشتباه موشک هستهای، پیشتر بدون حضور این فناوری تا یکقدمی فاجعه پیش رفتهاند. در تمامی این بحرانها ماشینها خطا کردند و انسانها مانع فاجعه شدند؛ در نتیجه تهدید واقعی نه رباتهای خودمختار، بلکه اعتماد به گزارشهای نادرست هوش مصنوعی در دقایق بحرانی است.
شبکه برق چگونه در برابر حملات هوش مصنوعی مقاومت میکند؟ پاشنه آشیل تأسیسات کوچک شهری
در حالی که غولهای انرژی با سرمایهگذاری سنگین سامانههای خود را در برابر نفوذ هکرها نفوذناپذیر کردهاند، تأسیسات محلی و کوچک خدمات شهری به هدفی آسان برای مهاجمان تبدیل شدهاند. با ظهور ابزارهای هوش مصنوعی که حملات سایبری را ارزانتر و سریعتر میکنند، شکاف امنیتی این شبکهها تهدیدی جدی برای زندگی شهروندان است.
معافیت یکساله اینتل از قانون ممنوعیت رباتهای خارجی؛ خطوط تولید تراشه آمریکا در امان ماندند
شرکت اینتل موفق شد برای ادامه فعالیت ناوگان خودروهای رباتیک خارجی در کارخانههای تراشهسازی خود در آمریکا، معافیتی یکساله از کمیسیون ارتباطات فدرال دریافت کند. این تصمیم پس از آن اتخاذ شد که مقررات مبهم دولت ایالات متحده علیه رباتهای ساخت خارج، نگرانیهایی جدی درباره توقف خطوط تولید نیمهرسانا ایجاد کرده بود.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.